TGViewer
Channel Public Channel
Аналитика в HR | HR-tech

Аналитика в HR | HR-tech

@analytics_hr

HR-аналитика | HR-tech
Авторский образовательный канал, посвящённый HR-аналитике, исследованиям рынка труда, HR Tech-решениям и AI.
Subscribers
660
Photos
250
Videos
0
Links
90
Recent Posts 20 shown
Post #376 78
#визуализация #ONA

Хочу вас познакомить с относительно новым для меня и, возможно, для кого-то из вас подходом к анализу организационных связей в компаниях - ONA

⚡️ Анализа рабочих связей или Organizational Network Analysis (ONA) - это представление силы и глубины связи между сотрудниками за пределами формальных организационных структур. Ключевая идея - представить организацию в виде сети, где каждый сотрудник - это узел, а взаимодействие между сотрудниками -связь.
Если соединить линиями сотрудников, которые взаимодействуют между собой, мы получим не формальную организационную структуру, а граф реальных рабочих взаимодействий.
Причём такую связь можно не просто зафиксировать, но и измерить. Например, учитывать количество взаимодействий, их продолжительность или интенсивность.

Довольно интересный подход, который содержит в себе массу инсайтов. Сам я относительно недавно им заинтересовался и вижу тут большой потенциал для анализа. Потихоньку буду рассказывать как с ним работать.
  • ❤ 2
Post #375 119
#метрики #замещение

⚡️Коэффициент замещения показывает, насколько компании удаётся компенсировать выбытие сотрудников за счет новых работников.

рассчитывается как: Количество принятых сотрудников / (Количество выбывших сотрудников — ставки, выбывшие из штатного расписания) * 100%

🔹Для чего он нужен? Если из компании ушло 100 человек, это вовсе не означает, что необходимо нанять новых 100.
Часть позиций может быть сознательно исключена из штатного расписания, автоматизирована или перераспределена между другими сотрудниками.
Поэтому на практике из уволившихся сотрудников убирают тех, чьи ставки были выведены из ШР. В некоторых случаях из базы расчета убирают также вакансии, которые бизнес не планирует к замещению.

🔹При этом коэффициент замещения лучше анализировать не изолированно, а вместе с укомплектованностью, динамикой штатной численности и количеством открытых вакансий. Например, коэф. 70% может быть совершенно нормальным, если компания одновременно сокращает штат и выводит часть позиций из ШР.
  • ❤ 1
  • 👍 1
Post #374 165
#визуализация

🔹Заголовок:
Заголовок должен объяснять, что показывает график: не Дашборд по подбору, а "Ключевые метрики и показатели функции Подбор".

🔹Оформление графиков:
Все графики должны иметь название и единицы измерения: "Текучесть персонала за 12 месяцев, %" (даже если вам кажется, что это супер очевидно).
Все графики должны иметь легенду и подписи данных. Их отсутствие создает огромное пространство для искажения сути графиков и домысливания

🔹Справочная информация:
Хорошим решением будем разместить где-то справа или слева внизу или почту сотрудника, который отвечает за формирование дашборда, или ответственного менеджера, на случай ,если у бизнеса возникнут вопросы, которые он захочет задать.
  • ❤ 6
Post #373 197
#визуализация

🔹Наполнение структуры:
В верхней части логично размещать 4–6 ключевых KPI, которые дают ответ на вопрос: что происходит. Ниже динамику показателей, сравнения, разбивку и пр. которые помогают понять почему это происходит. Каждый график при этом должен отвечать на конкретный вопрос.
Стараемся на перегружать макет, 4-6 элементов максимум. Оставьте только самое важное.

🔹Графические элементы:
динамика - линейный график,
сравнение - столбцы,
этапы процесса - воронка,
распределение - гистограмма,
взаимосвязи - scatter plot,
составные части целого - круговая диаграмма,
большое количество категорий - тепловая карта.
лучше отказаться от объемных фигур, их сложно сделать красиво и функционально.

🔹Фон и цвета:
лучше выбирать спокойный нейтральный фон: белый, светло-серый или светлый оттенок вашего корп. цвета.
Яркий или тёмный фон быстро утомляет глаза. Хотя многие любят делать черный фон, все же - это не самое лучший выбор.
  • ❤ 4
Post #372 194

Forwarded from Эйчарня | вакансии для HR

📊 Вакансии в HR-аналитике и C&B

В этот раз — коротко про вакансии, потому что ниже будет ещё комментарий HR-аналитика о том, какие навыки сейчас реально важны в профессии 👇

1️⃣ Аналитик HR-метрик | СДЭК
People Analytics: HR-метрики, отчётность, визуализация и связь показателей с бизнесом.
📎 Нужно: от 3 лет в HR-аналитике, сильный Excel
📍 Москва / удалённо #москва #удалёнка

2️⃣ Руководитель направления C&B | Arenadata
Senior C&B: стратегия вознаграждения, бюджетирование, грейды, KPI, LTI и управление командой.
📎 Нужно: от 5 лет в C&B / HR-аналитике + управленческий опыт
📍 Москва, гибрид #москва

3️⃣ HR/C&B аналитик | Делимобиль
Роль на стыке HR-аналитики и компенсаций: ФОТ, план-факт, метрики и Power BI.
📎 Нужно: опыт в HR-аналитике / C&B, Excel и Power BI
📍 Москва #москва

4️⃣ Методолог-эксперт C&B (IT направление) | Ростелеком
C&B-трансформация: системы оплаты, грейды, KPI и единая методология для IT-направления.
📎 Нужно: 3–5+ лет в C&B и опыт работы с IT
📍 Москва #москва

5️⃣ Менеджер по компенсациям и льготам | Кибертех
Классический C&B с фокусом на ФОТ, мотивационные схемы и автоматизацию процессов.
📎 Нужно: 2–3+ года в C&B, Excel и 1С:ЗУП
📍 Москва / удалённо #москва #удалёнка

💬 Комментарий эксперта
Евгений Кириёк, автор канала Аналитика в HR | HR-tech:
Как видно из вакансий, C&B остаётся главным заказчиком HR-аналитики. Чаще всего такие позиции появляются в крупных федеральных компаниях с большим штатом и большим объёмом данных.

Самые типичные задачи здесь — моделирование бюджета, план-факт анализ, сценарный анализ и расчёт HR-метрик.

Среди наиболее востребованных навыков: Excel — 87% упоминаний, знание методологии расчёта HR-метрик — 64%, BI-системы — 44%.

В Москве начинающий специалист может рассчитывать на 80–110 тыс. ₽, Middle — на 120–180 тыс. ₽, а опытный специалист — от 180 тыс. ₽ в месяц.

#аналитика
  • ❤ 5
Post #371 169
#визуализация

⚡️ Дашборд - это интерактивная панель, которая собирает данные из разных источников и показывает их в виде доступных граф.эллементов: схем, графиков, гистограмм и пр. Основные задачи две: информировать и служить источником данных для принятий управленческих решений.
Основных источника создания подобны решений в HR-аналитике два: традиционный Excel и BI-платформы.

🔹Инструменты:
Основных инструмента в HR-аналитике два
Excel: привычный инструмент, не очень сложно создать интерактивную панель данных со средним уровнем эксель.
BI: есть бесплатные решения, но понадобится освоить инструмент.

🔹Структура:
Начинаем с макета в ppt.
В идеале одна панель должна содержать информацию по одному процессу или направлению.
Лучше сделать 3-4 небольшие панели, между которыми можно переключаться, чем 1 панель на 20 метрик и показателей.
  • 👍 3
Post #370 210
#AI

🔹 Часто на вебинарах, которые я веду, поднимается вопрос защиты персональных данных при использовании ИИ в соответствии с требованиями 152-ФЗ.
Одно из возможных решений - использование небольших языковых моделей, которые разворачиваются непосредственно на компьютере пользователя. В этом случае данные могут обрабатываться локально, без передачи во внешние облачные сервисы.

В апреле 2026 года OpenAI представила SLM Privacy Filter, предназначенную для автоматического обнаружения и удаления персональных данных из данных.

Модель умеет обнаруживать восемь основных типов информации (на скрине) и способна учитывать контекст, в котором используется информация, что отличает её от простого поиска персональных данных с помощью регулярных выражений.

Код и инструменты для запуска Privacy Filter доступны на GitHub.
В одном из следующих постов поделаюсь инструкцией как это делать, дам бенчмарки тестов и результаты.
  • 👍 1
Post #369 234
#метрики #текучесть #turnover #fifo_turnover

⚡️ FIFO текучесть (FIFO turnover rate) — это довольно необычный, но интересный в своей логике способ расчета текучести персонала. Он фокусируется на уходе сотрудников из первоначального состава команды. В отличие от стандартного подхода, FIFO исключает из расчета новых сотрудников, что позволяет посмотреть на структуру текучести.
При этом FIFO текучесть не стоит интерпретировать как правильную текучесть, которая заменяет стандартную. Этот показатель отвечает на вопрос:
«Какую долю первоначального состава мы потеряли?»

🔹 Особенности применения:
1. Уместно применять в тех случаях, когда текучесть в компании высокая и нужно понять ее структуру
2. Важно для компаний в области R&D, IT, консалтинга и тех компаний, где высокая стоимость экспертизы и "стоимости" отдельного сотрудника
3. Хорошо считать в паре с классической текучестью или с анализом текучести по когортам
  • 👍 8
Post #368 233
#основы #индекс

Мы привыкли использовать проценты, если хотим сравнить между собой какие-то показатели. Но в некоторых случаях лучше использовать не процент, а индекс.

🔹Простой индекс выражает изменение во времени одного показателя. Например, индекс изменения зп или индекс производственной эффективности.

🔹Составной индекс объединяет информацию о нескольких разных показателях. Например, у нас есть несколько команд (сотрудников) или товаров, с помощью составного индекса мы можем посчитать их общую производительность в динамике.

🔹Составной взвешенный индекс позволяет выполнить ту же работу, но уже с учетом значимости (веса) каждого показателя. Например товар 1 более значим чем товар 2, т.к. доля выручки у него больше, поэтому и его вес будет больше. Сделать сравнение через % уже будет невозможно, только через индекс.

🔹 Когда индекс уместен:
1. сравнивать показатели разного масштаба;
2. объединять несколько показателей;
3. учитывать их вес;
4. строить агрегированные показатели.
  • ❤ 6
Post #367 228
На ЛитРес вышла статья с моими комментариями о том, как бизнесу сохранить устойчивость в 2026 году.
Постарался обойтись без лишнего алармизма, но при этом показать реальное положение дел, которое сегодня наблюдается во многих компаниях сегмента малого и среднего предпринимательства.

Я поделился своими комментариями и рекомендациями о том, что можно сделать со стороны HR-функции, для сохранения этого самого бизнеса и какой-то устойчивости компании.
Понимаю, что некоторые из рекомендаций могут показаться довольно пессимистичными и не очень гуманными, но я старался давать реальные советы, которые, возможно, кому-то смогут помочь в это не самое простое время.

Надеюсь, материал будет полезен руководителям, собственникам бизнеса и HR-специалистам.
Ознакомиться со статьёй можно по ссылке: статья на ЛитРес
Литрес Сохранить капитал и бизнес в 2026: что делать предпринимателю Узнайте, какие изменения ждут предпринимателей в 2026 году. Пошаговая стратегия, как сохранить бизнес, оптимизировать расходы и найти новые точки роста.
  • 👍 4
Post #366 223
#методы #нормализация #z_score

⚡️ Нормализация — это приведение показателей к одной базе, чтобы можно было корректно сравнивать подразделения, периоды и пр. разного размера. Метод используется в ситуациях, когда вы сравниваете большое количество разных по размерам групп и пытаетесь определить какие из них лучше/хуже или для того, чтобы проранжировать их.

Например, вы сравниваете текучесть по подразделениям. Сравнивать в лоб не всегда верно, в таких случаях используют нормализую.
Инструментов нормализации много, мы рассмотрим два:

🔹1. Нормализация на фиксированную базу. Мы берем общую для всех подразделений базу (например 10 или 100 сотрудников) и перемножаем все показатели тек. на эту базу. Теперь подразделения разного размера находятся в одной шкале.

🔹 2. Z-нормализация чуть более сложная. Рассчитывается по формуле Z = (X − среднее) / стандартное отклонение.
Если Z-score тек. подразделения +1,6, это означает, что тек. в этом подразделении находится на 1,6 ст. отклон. выше среднего уровня по компании
  • ❤ 2
Post #365 235
#методы #Джини

потихоньку выхожу из летнего застоя.

⚡️ Индекс Джини в HR -
показатель, который позволяет оценить, насколько равномерно какое-то значение распределено среди всей совокупности. Например, как производительность распределена между сотрудниками или продажи между менеджерами. Очень классно работает на производствах, где много небольших коллективов с разным уровнем производительности

🔹 Алгоритм расчета:
0: собираем данные и ранжируем по возрастанию;
1: считаем долю каждого сотр. в общем объеме;
2: считаем накопленную долю производительности - последовательно складываем доли сотрудников;
3: считаем долю сотрудников в общем количестве;
4: строим кривую Лоренца через точечную диаграмму: X - накопленная доля сотрудников; Y - накопленная доля производительности;
5: рассчитываем индекс Джини по формуле на скрине.

🔹 Интерпретация:
Чем ближе индекс к 0, тем равномернее распределена производительность между сотрудниками, чем ближе к 1, тем сильнее результат концентрируется у небольшой группы сотрудников.
  • ❤ 5
Post #364 348
#метрики #IMR

⚡️ Интернальная мобильность (Internal Promotion and Transfer, IMR) — это показатель, который отражает, насколько активно сотрудники перемещаются внутри компании (переходят на новые должности, меняют отделы, получают повышения и пр.).

Рассчитывается как частное между кол-во внутренних переводов за период и (количеством сотрудников на начало и конец отчетного периода)/2.

🔹 Пример расчета:
Допустим, за год 50 сотрудников сменили должности внутри компании.
В начале года было 500 сотрудников, в конце — 550.
IMR = 50/((500+550)/2) = 0,095 или 9,5%

🔹 Как интерпретировать?
✔️ <5% — низкая мобильность. Возможно в компании существуют ограничения на развитие и горизонтальные и вертикальные перемещения.
✔️ 5-15% — здоровая мобильность, сотрудники имеют возможности для развития.
✔️ >15% — высокая мобильность.
  • 👍 6
Post #363 349
#AI #Cursor

Если Codex-а было мало, то вот еще одно десктопное решение с разными моделями AI.

⚡️ Cursor - редактор кода с встроенным AI, который выглядит как привычный веб-интерфейс нейронки, но вашем компьютере. Есть бесплатный тариф и платные версии с расширенными возможностями.

🔹 Как работать: скачиваете дистрибутив с оф.сайта, устанавливаете программу у себя и запускаете. Нужно будет создать папку проекта (по аналогии с Codex), к которой у нейронки будет доступ и с которой она будет работать. В чате пишите запросы, в соседнем окне получаете код и готовые решения.

🔹 Особенности: Не нужно копировать код в чат. Cursor индексирует проект и понимает связи между файлами, если код находится в папке, к которой у него есть доступ. Можно создавать AI агентов, которые будут выполнять задачи автономно по заранее настроенным правилам.
Post #362 346
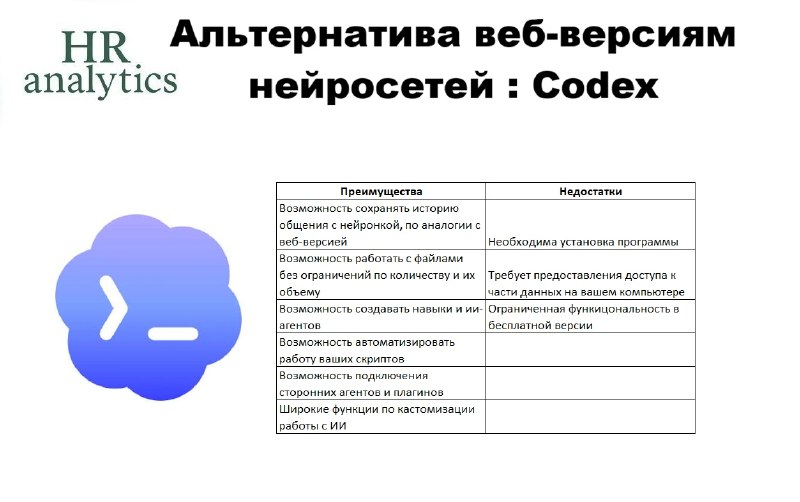
#AI #Codex

Большинство из нас использует нейронки (будь то chatGPT, deepseek или какие-то другие) в формате веб-версий. Посмотрим на альтернативный способ - через десктопное приложение, которое устанавливается на ваш компьютер.

⚡️ Codex — это инструмент (AI-агент) внутри экосистемы ChatGPT/OpenAI для разработки ПО и агентов. Доступен для скачивания всем пользователям (по крайней мере сейчас) вне зависимости от тарифа или через интерфейс веб-приложения или на оф.сайте.

🔹 Как это выглядит: Вы создаете промт, сохраняете его как навык (то есть готовый скрипт для воспроизведения), а затем автоматизируете работу это скрипта, то есть создаете правила, по которым этот скрипт будет работать уже без вашего участия.

⚠️ Важно: для работы Codex необходимо предоставить доступ к папке, над которым он работает. В этом случае нейросеть получает доступ к файлам и папкам, входящим в рабочую область проекта. Поэтому не рекомендуется размещать в рабочей директории конфиденциальные данные.
  • 👍 3
Post #361 314
#основы #исследования

⚡️Шкала Лайкерта (Likert scale) – это шкала используемая в количественных исследованиях для измерения степени согласия или несогласия респондентов с различными утверждениями. Является «базой» для любого исследователя и используемся повсеместно при составлении большинства опросников.
Классическая версия 5-балльная, однако, возможно использовать и 7-балльный вариант, если нужен больший разброс значений (на скрине).
В HR-аналитика шкала используется в большинстве методологий определения вовлеченности персонала, лояльности, при проведении исследований EVP, SCAR, для исследования мотивации и пр.

🔹 Важные нюансы:
1. Шкала является симметричной относительно своего «центра».
2. В опросах в идеале стоит использовать одинаковые ответы. То есть все вопросы формулировать так, чтобы они закрывались одним набором.
3. Все варианты в шкалах, в рамках одного опроса, должны иметь одну логику в ответах. Если вы начинаете ответы от несогласен к согласен, то такой порядок ответов должен сохранятся и далее.
  • ❤ 4
Post #360 329
#методы #регрессия

Продолжим тему линейных уравнений и поговорим о том, как построить уравнение, описывающее одну переменную через другую в Excel.

На входе у нас есть набор данных, описывающий сотрудников компании через две переменные: стаж и оклад.
Мы сделали предположение, что оклад связан со стажем, проверили это с помощью корреляции и теперь хотим количественно её оценить.

🔹Как построить:
Переходим на вкладку Данные → Анализ данных → Регрессия.
В окне выбираем следующие параметры:

Входной интервал Y — переменная, которую мы хотим описать. Оклады.
Входной интервал X — переменная, через которую мы будем описывать Y. Стаж.
Ставим галочку в разделе «Метки», если в наших данных есть заголовки.
Выходной интервал — ячейка, в которую будет выведен результат анализа.

Из всего многообразия показателей нас интересуют:
Y-пересечение — это базовый коэффициент уравнения;
Коэффициент при переменной стаж — он также войдёт в уравнение.
подставляем их в уравнение и получаем формулу расчета зависимости.
  • ❤ 2
Post #359 330
#методы #регрессия

Говоря о регрессии, нельзя не упомянуть мультиколлинеарность. Это ситуация, при которой несколько признаков в модели сильно коррелируют между собой. То есть модель получает дублирующую информацию от разных переменных.

В классических линейных моделях в такой ситуации коэффициенты становятся нестабильными, что приводит к искажению результатов и усложняет интерпретацию модели.

🔹Что с этим делать:
После анализа корреляции между признаками следующим шагом является снижение мультиколлинеарности в модели.
Существует несколько подходов:
1. Удаление признаков
Оставляем один фактор из группы сильно коррелирующих, отказываясь от остальных. Доступно в любом формате работы.
2. Регуляризация
Использование методов регуляризации, таких как Lasso и Ridge-регрессия.
Они позволяют снизить влияние избыточных признаков за счёт «штрафа» на коэффициенты. Только python или R

Модель без мультикол. становится лучше и устойчивее и без ущерба точности (пример на скрине).
  • ❤ 1
Post #358 324
#метрики #укомплектованность

⚡️Укомплектованность - одна из базовых метрик показывающая, насколько заполнено штатное расписание компании. Однако, на нее можно взглянуть и под другим углом. Ниже несколько вариантов расчета метрики с разным акцентом.

🔹Классический вариант показывает, какая доля утверждённых ставок занята сотрудниками на конкретную дату. Используется для общего мониторинга кадровой ситуации и быстрой оценки дефицита персонала.
Ограничение метода — не учитывает частичную занятость и длительные отсутствия.

🔹Через расчет FTE
Более точный метод расчёта, учитывающий долю занятости сотрудников. Позволяет корректно учитывать частичную занятость, совместителей, парт-таймеров и пр. Лучше использовать для операционного управления и бюджетирования.

🔹Операционный или активный укомплект. Метод показывает фактическую рабочую мощность подразделения на дату. Подходит для: планирования смен и графиков, оценки производственной нагрузки, расчёта KPI.

Все расчеты производятся на дату
  • ❤ 3
Post #357 287
#методы #регрессия

Переходим к прикладным методам анализа данных - линейным уравнениям и регрессиям.

⚡️Линейное уравнение - это самый простой способ попробовать определить зависимость одного фактора от другого и ответить на вопрос: «насколько именно один фактор влияет на другой?». Если корреляции говорят о связи, то здесь речь уже идёт о зависимости (взаимосвязи).

🔹Линейное уравнение имеет вид:
y = ax+b
, где:
y — зависимая величина
a — коэффициент при независимой переменной x
x — значение показателя
b — свободный член

Самый простой способ понять как это работает на практике - посмотреть на значения стажа и оклада или стажа и производительности сотрудника. Собираем такие пары и строим по ним график (в Excel: Диаграммы - Точечная/график). График, который вы увидите на выходе и будет описывать такую связь.
Прямая (как на графике) будет описываться линейный уравнением. Это самый просто вид зависимости, но на практике, конечно, он встречается не так часто.

Как с ней работать поговорим чуть дальше.
  • ❤ 4
Older posts →

About this channel

How can I read @analytics_hr without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Аналитика в HR | HR-tech: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Аналитика в HR | HR-tech have?
Аналитика в HR | HR-tech (@analytics_hr) has 660 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Аналитика в HR | HR-tech know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →