
💻📚🗣 Мастер-класс по #корпусная_лингвистика
❗️ К нам обратились украинские гуманитарии из проекта "🇩🇪Prisma Ukraїna🇺🇦" с просьбой о проведении мастер-класса по корпусной лингвистике на основании программы AntConc.
😉 Радостно, что отечественные ученые проявляют интерес к корпусной лингвистике.
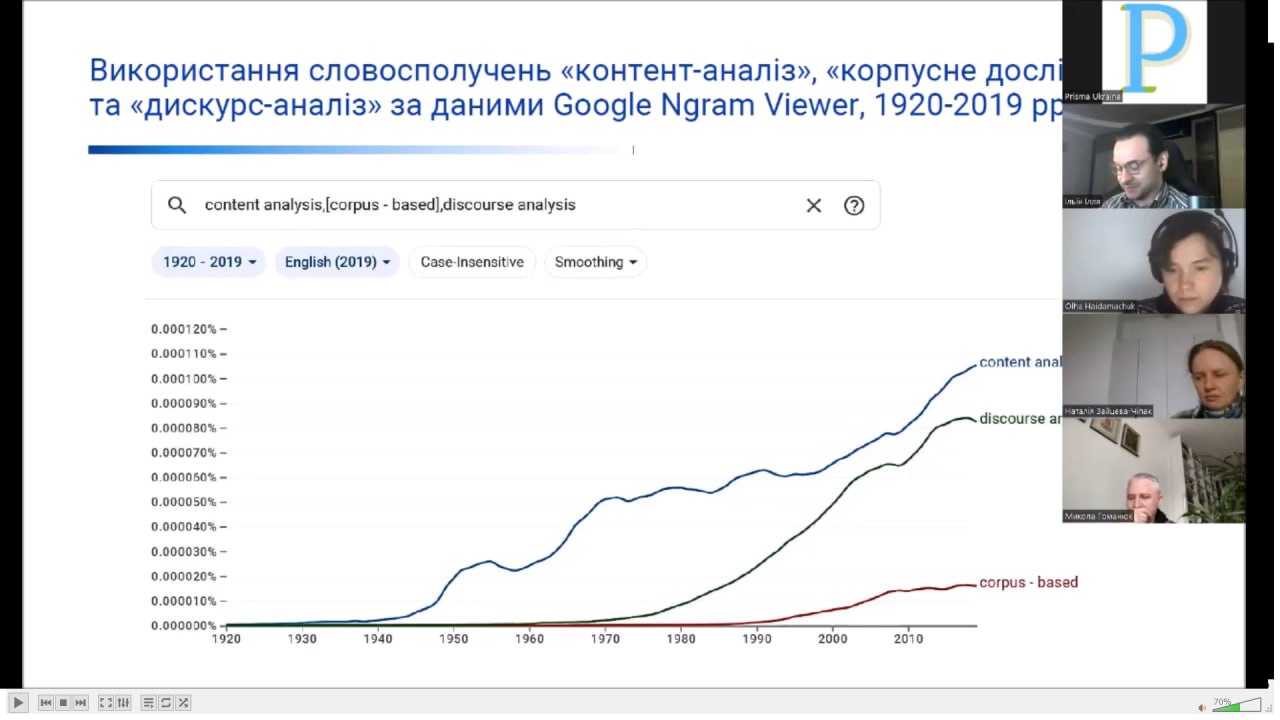
😎 21 марта 2024 года мы впервые провели мастер-класс по AntConc'у через Zoom, показав, какие инструменты и для чего необходимы (см. скриншот внизу).
😌 Обсуждение было насыщенным. Много вопросов получили:
❓ Чем отличается понимание значения в контент-анализе и в корпусной лингвистике?
🗣 Лингвистическим пониманием значения в корпусной лингвистике и теоретическим определением значения в контент-анализе, то есть, в первом случае, значение определяется из контекста самого текста, а во втором — исходя из теории ученого о значении соответствующих слов (при этом даже необязательно смотреть в текст, поскольку программы контент-анализа осуществляют автоматическую классификацию слов) См. подробнее тут.
❓ Ограничен ли объем текстов, который можно загружать в AntConc?
🗣 Ограничений нет. Хотя при большом объеме файлов рекомендуется их дробить на маленькие части (например, посредством программы TextFileSplitter), чтобы их обработка осуществлялась быстрее (наш стандарт — 100 килобайт).
❓ Откуда можно взять стоп-слова (список слов, которые (не) будет учитывать программа в своей деятельности; как правило, это функциональные слова - союзы, местоимения и т.д.)?
🗣 Можно найти уже готовые файлы со стоп-словами для различных языков в Интернете в свободном доступе, а затем изменить их состав в соответствии с собственными потребностями, характеристиками корпуса.
❓ Являются ли репрезентативными корпусы текстов?
🗣 Официально созданные корпусы национальных языков, курируемые университетами и академиями наук, являются репрезентативным, как по объему, так и по жанрам текстов. В контексте создания собственных текстов, общее правило репрезентативности звучит так: "чем больше корпус, тем лучше".
❓ Можно ли автоматически удалять тексты модераторов в опросниках?
🗣 Нет, все такие операции делаются вручную. Очистка текстов от лишней информации (редакционные примечания, список литературы, колонтитулы и пр.), которая будет мешать при генерировании количественной информации, является важнейшей операции при подготовке работы с корпусом
❓ Как извлекать данные из X (бывш. Twitter)?
🗣 Мы знаем о проблеме "приватизации" API ("спасибо" Илону Маску🤮). Некоторые ученые используют другие социальные сети (например, Reddit), но о новых решениях в контексте X мы ничего сказать не можем.
❓ На чем основывается методология корпусной лингвистики (обращаться к данным без гипотез, формировать гипотезы на основании данных)?
🗣 Во-первых, корпусная лингвистика работает эффективно только при эффективно выстроенной гипотезе, вопроса, который позволяет выбрать корпус, инструменты и способы обобщения полученных результатов. Во-вторых, открытость корпусной лингвистики к эмпирическим данным, значениям, зафиксированным в самих текстах, ближе всего методологически к этнометодологии (предшественницы акторно-сетевой теории). Важно понимать, что первый пункт не противоречит второму, поскольку изучаемый текст может и должен удивить исследователя, расширить его понимание мира, усилить необходимость в раздвижении пределов существующих теорий, сопротивляться захвату с точки зрения теории.
❓ Нужно ли использовать словарь при работе со словами в контексте корпусной лингвистики?
🗣 Скорее, отношение корпусной лингвистики со словарями обратное. Как пишут здесь, с 1987 года словари английского языка создаются с использованием больших корпусов. Если же отвечать конкретно на вопрос, то следует отметить, что каждый текст, по существу, обладает своим словарем, своими значениями, которые фиксируются благодаря изучению конкордансов и коллокаций в программе AntConc.
@raumanalysis_ih
Post #675
66
- 👍 4
- ❤ 2
- 🔥 1