
🔢 Чем больше, тем лучше? #корпусная_лингвистика
😇 Потрясающе! Математика языка-текста! Зная, сколько раз встречается в тексте одно слово и другое слово, можно просчитать, сколько они могут встретиться в целом! Нужно умножить эти показатели! Затем поделить на объем текста! И вот - у нас есть показатель того, сколько раз эти слова могут встретиться в тексте (ожидаемая частотность коллокаций!)! Однако это еще не значит, что эта встреча будет судьбоносной, значимой!
😉 Чтобы определить значимость этих встреч, нужно математизировать дальше!
❗️ Мы говорили о сложной частотности, нормализованной частотности, ожидаемой частотности (Log-Likelihood) (1, 2) и метрике "взаимная информация" (1, 2).
❓ Если "взаимная информация" фокусирует внимание на редких коллокациях, то какая метрика все-таки дает более адекватные результаты?
✅ T-Score! (Опять же, программа AntConc делает все вычисления автоматически, но мы должны знать, что под ними кроется).
💻📚 Поискали в нашем корпусе англоязычных книг по корпусной лингвистике (378 наименований; 35,2 млн слов) высказывания авторов о "t-score" в контексте слова "collocat*", которое является значимой коллокацией. См. материалы тут. Для прояснения механизма "t-score" обратимся к ChatGPT 4o.
✅ Результаты
💭 Основная цель t-score заключается в том, чтобы оценить степень уверенности в том, что данная коллокация является неслучайной. Эта мера учитывает количество наблюдаемых коллокаций, размер корпуса и стандартное отклонение, что делает ее более надежной по сравнению с простой частотностью слов и коллокаций.
💭 Если два слова встречаются вместе значительно чаще, чем можно было бы ожидать на основании общей частотности их употребления, то t-score будет высоким, что будет указывать на значимую коллокацию.
💡 Формула t-score берет количество фактических случаев, когда эти два слова встречаются вместе, вычитает из этого ожидаемое количество (если бы они были независимы друг от друга), а затем делит результат на показатель, который учитывает разброс этих данных (стандартное отклонение - корень от наблюдаемого количества коллокаций).
🔢 t = (1️⃣ наблюдаемая частотность — 2️⃣ ожидаемая частотность) / 3️⃣ стандартное отклонение
2️⃣ Ожидаемая частотность = (частота_слова1 * частота_слова2) / общее_количество_слов.
3️⃣ Стандартное отклонение = √наблюдаемой частотности коллокаций.
Когда мы берем корень из наблюдаемого количества коллокаций, мы рассчитываем, насколько ожидаемое количество коллокаций может варьироваться. Это позволяет нам оценить, насколько значимо отклонение наблюдаемого значения от ожидаемого. Использование корня помогает нормализовать значение.
Допустим:
1️⃣ В тексте слово "чай" встречается 100 раз.
Слово "сахар" встречается 50 раз.
Текст состоит из 10 000 слов.
"Чай" и "сахар" вместе появляются 15 раз (это наблюдаемая, простая коллокация).
2️⃣ Ожидаемая частотность = 100 * 50 / 10000 = 0,5 (то есть, столько раз эта коллокация встречается случайно в корпусе; если будет больше этого показателя, то это будет указывать на неслучайность встречи).
3️⃣ Стандартное отклонение = √15 = 3.87
🔢 t = (15 — 0,5) / 3.87 = 14,5 / 3.87 = 3,75.
✅ Таким образом, t-score в этом примере составляет 3.75, что больше, чем 0,5, то есть, ожидаемой частотности. Это значит, что встреча слов "чай" и "сахар" вместе является значимой и явно не случайной. Показатель больше 2-х или в двухзначных числах считается релевантным.
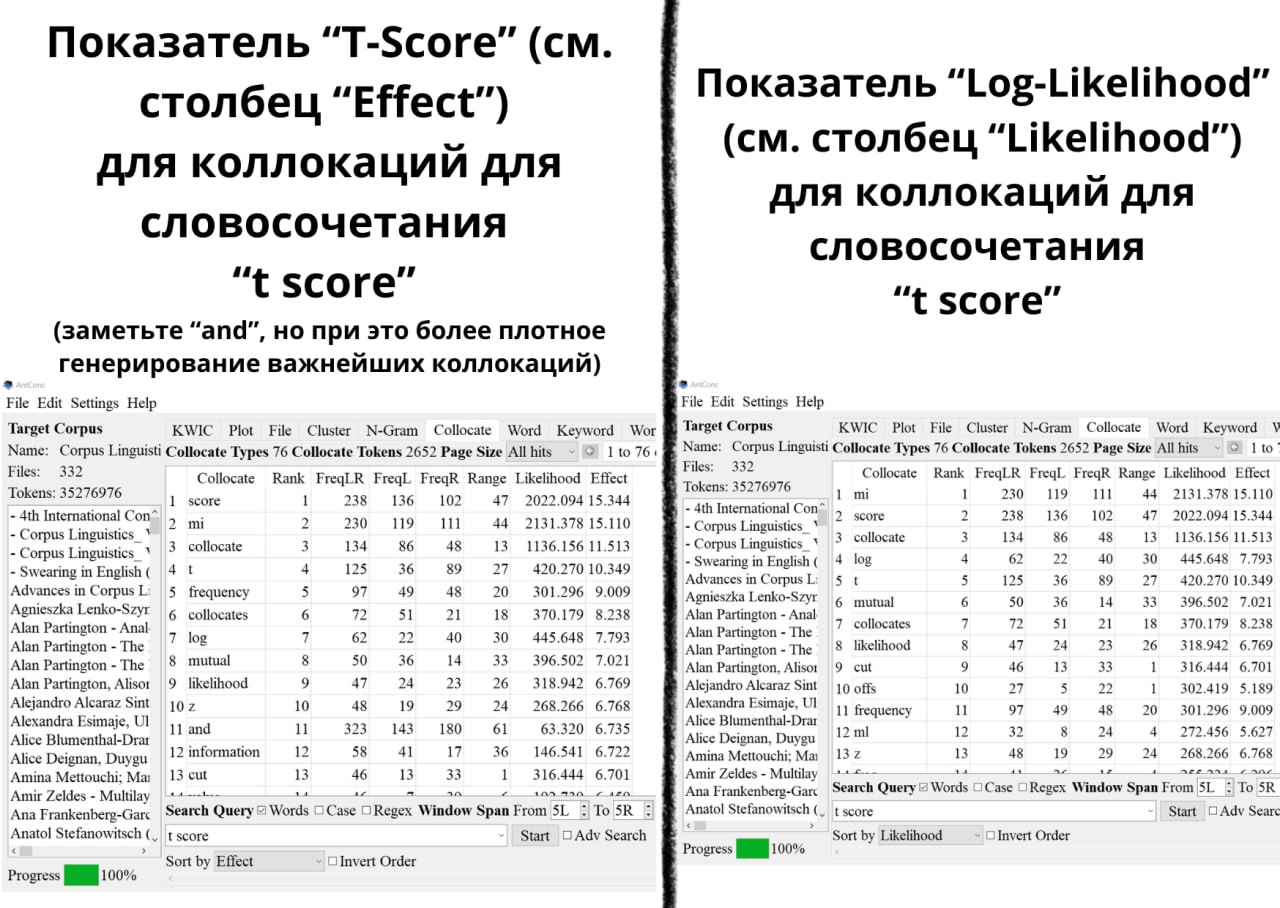
🤷 Однако проблема с t-score заключается, в том, что она больше уделяет вниманию частотным коллокациям: если "взаимная информация" абсолютизировала редкие коллокации, то "t-score" - слишком частотные коллокации, поэтому обращает внимание на функциональные слова, например, "and" (чего, нет, например, в log-likelihood (см. 🖼), и, скорее всего, не было бы у "взаимной информации" при постановке порога на минимум коллокаций).
❗️ В целом, t-score более всего приближен к простой частотности. Однако принцип t-score - "чем больше, тем лучше" - может привести к появлению "шума" в виде функциональных слов (союзов, например).
😎 Будем искать дальше!
@raumanalysis_ih
Post #863
59
- 🔥 3
- 👍 2
- ❤ 1
- 👏 1