
🔢 Важность порогов #корпусная_лингвистика
❗️ Работа с корпусом предполагает работу с такими данными, которые не видны при человеческом чтении, а именно, речь идет о паттернах, то есть, закономерностях, повторяемых сочетаний между словами, формирующих их семантику, и которые можно обнаружить только количественно-статистически.
💭 Продолжаем выяснять статистические меры частотности в языке. Поговорим о том, почему и как может быть полезна метрика "mutual information" (взаимная информация).
❓ Что такое "взаимная информация" (еще раз проясним) и как избежать ее главного недостатка — выделения низкочастотных слов в качестве коллокаций?
💻📚 Поискали в нашем корпусе англоязычных книг по корпусной лингвистике (378 наименований; 35,2 млн слов) высказывания авторов о "mutual information" и его аббревиатуре ("MI") в контексте слова "collocation*". См. конспект значимых случаев. Для прояснения механизма "MI" обратимся к ChatGPT 4o.
✅ Результаты
📝 Здесь определение: Взаимная информация "определяет силу коллокации, сравнивая наблюдаемую частоту каждой коллокативной пары с ожидаемой, исходя из относительной частотности каждого слова и общего объема корпуса. Разница между наблюдаемой и ожидаемой частотностью затем преобразуется в показатель (MI score), который указывает на силу коллокации, причем более высокие показатели присваиваются более сильным коллокациям".
🤷 Однако показатель MI score обращает внимание на низкочастотные слова, считая их релевантными, поскольку когда слова встречаются очень редко (например, каждое по одному разу в тексте), вероятности их появления очень маленькие. Но если они все-таки появляются вместе хоть один раз, это сильно выделяется на фоне того, что они вообще редко появляются. Даже если это было случайное совпадение, эта метрика может посчитать это значимой связью, потому что вероятность того, что они встретятся вроде как "неожиданно" высокая по сравнению с их редкостью.
🦕🚀 Если два слова, такие как "динозавр" и "ракета", появляются в тексте всего по одному разу и случайно стоят рядом друг с другом, "MI" может "подумать", что это важно, потому что вероятность их совместного появления выше, чем вероятность их появления по отдельности (так как они редки). Однако, это всего лишь случайное совпадение, а не реальная связь между словами.
💭 При этом Log-Likelihood (см. комментарии к текущему сообщению) учитывает не только, как часто каждое слово встречается по отдельности, но и как часто они вообще не встречаются вместе.
🦕🚀 Допустим, у нас есть текст из 1000 предложений, и слова "динозавр" и "ракета":
"Динозавр" встречается 10 раз.
"Ракета" встречается 5 раз.
Они встретились вместе только 1 раз.
Log-Likelihood посмотрит на:
Сколько раз они встретились вместе (1 раз).
Сколько раз "динозавр" появился без "ракеты" (9 раз).
Сколько раз "ракета" появилась без "динозавра" (4 раза).
Сколько раз ни одно из этих слов не появлялось (986 раз).
Log-Likelihood учитывает, что в большинстве случаев эти слова не встречаются вместе, и cделает вывод, что их одно совместное появление, скорее всего, случайно.
👍 Для преодоления недостатка авторы используют кубическую версию взаимной информации (MI3), то есть, показатели наблюдаемой и ожидаемой частотности умножаются на 3, что увеличивает показатель простой частотности коллокаций. Это помогает усилить влияние частотных коллокаций и ослабить влияние редких.
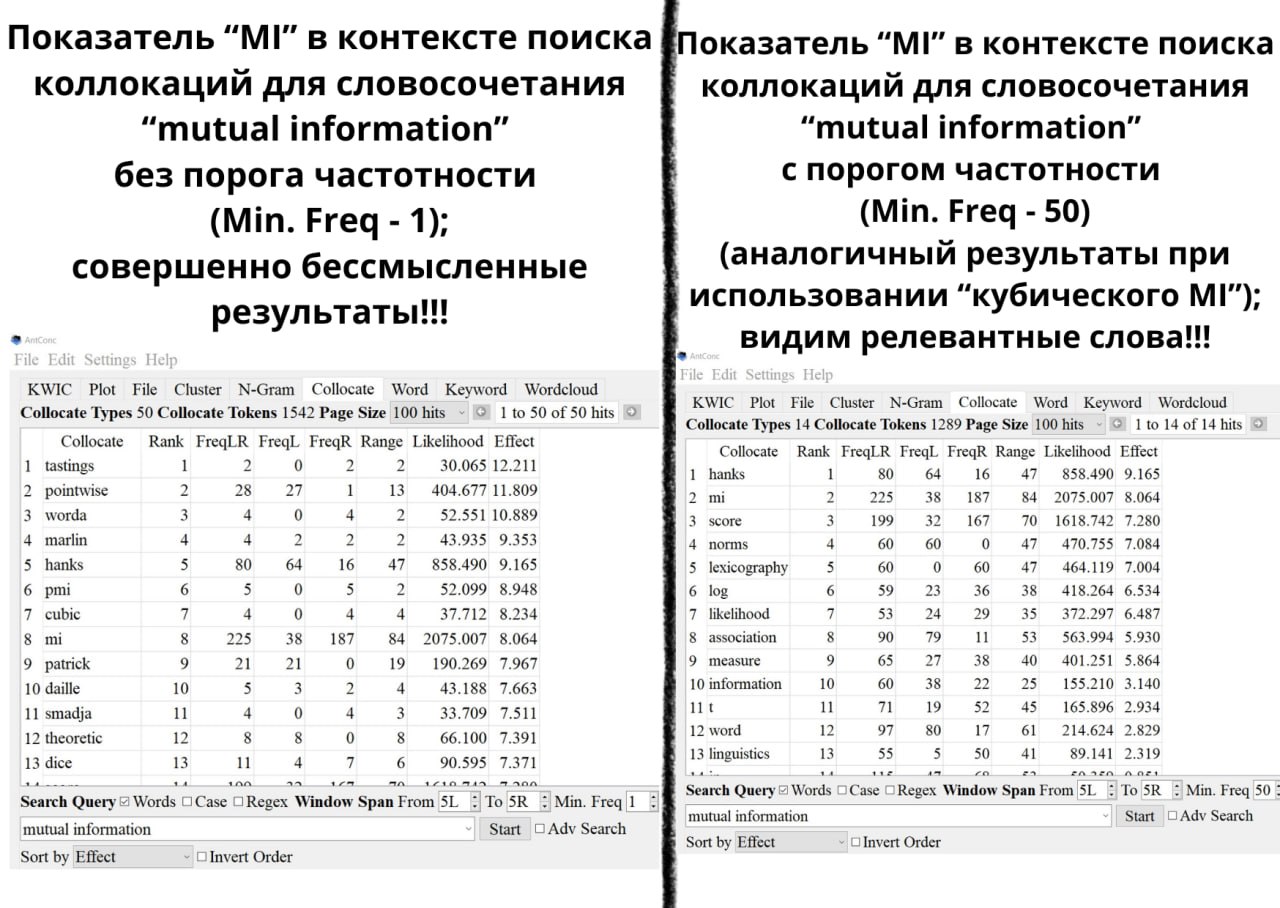
📝 Здесь говорится, что для упразднения проблемы с "MI" нужно ставить, в том числе, порог частотности слов (см. 🖼; MI score там в столбце "Effect"), а тут указывается, что нужно учитывать показатель "MI" не менее 3,5, а тут - не менее 5.
📝 Пол Бейкер: несмотря на использование "MI" в британском национальном корпусе и других исследованиях, лучше использовать другие метрики.
💭 Итак, несмотря на использование частотности обеих слов, их простой частотной коллокации, объема корпуса, метрика "MI" является проблемной, хотя и отчасти эффективной, если использовать ее с порогом. Это несколько усложняет работу с ней и все равно дает не совсем точные результаты. Будем исследовать другие метрики!
@raumanalysis_ih
Post #856
74
- 👍 3
- 🔥 1
- 👏 1