💭 Продолжаем выяснять статистические меры частотности в языке.
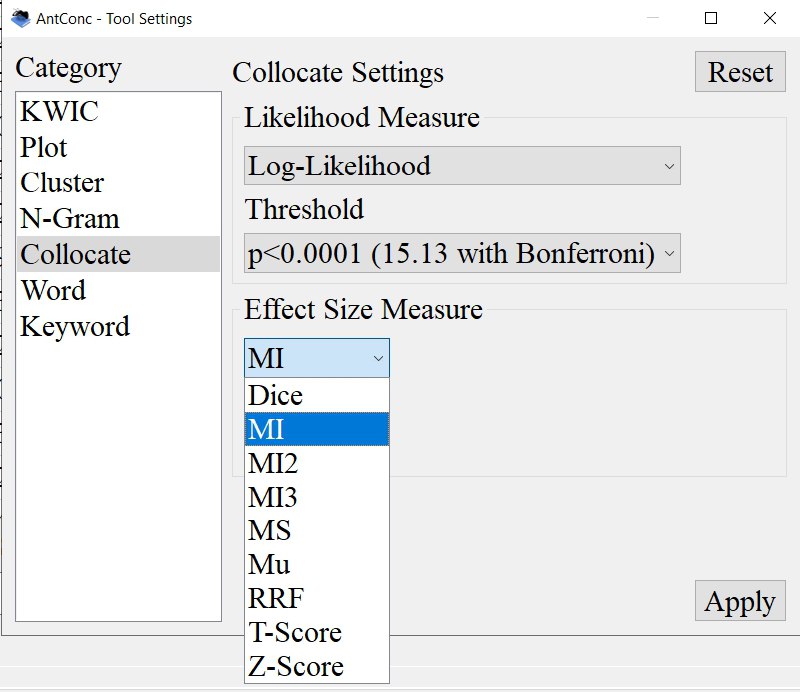
💻 В программе AntConc, кроме логарифма вероятности (Log-Likelihood), используется множество других статистических мер, которые берут за основу различные количественные показатели текста (наблюдаемую и ожидаемую частотность и т.д.) (см. 🖼).
❗️ Все эти метрики позволяют определить, какие слова являются ключевыми для корпуса, какие слова являются ключевыми для определения тех или иных слов.
💻📚 Поискали в нашем корпусе англоязычных книг по корпусной лингвистике (378 наименований; 35,2 млн слов) высказывания авторов о "mutual information" и его аббревиатуре ("MI") сначала в контексте определяющих слов (defin*, term*, concept*). См. конспект значимых случаев (мы прочитали все, но выделили фрагменты, где авторы пытались объяснить, о чем идет речь). Подключим ChatGPT 4o для помощи в разъяснении этих сложных статистических материй.
💭 Все эти метрики рассчитываются автоматически программой, но все-таки интересно понять, как они функционируют.
✅ Результаты
❗️ Взаимная информация (MI) — это способ измерить, насколько часто два слова встречаются вместе в тексте по сравнению с тем, как часто они могли бы встречаться случайно.
Формула MI выглядит так:
MI(X, Y) = log2(P(X,Y) / (P(X) * P(Y)))
Здесь:
P(X,Y) — это вероятность того, что два слова (X и Y) появляются вместе в тексте.
P(Х) и P(Y) — это вероятность появления каждого из слов по отдельности.
Формула сравнивает фактическую частоту совместного появления слов с тем, как часто они могли бы встретиться случайно.
Вероятность совместного появления двух слов P(X,Y) рассчитывается как отношение числа случаев, когда эти два слова появляются вместе, к общему числу словосочетаний в тексте.
💭 Процесс расчета: сначала необходимо подсчитать, сколько раз два слова X и Y встречаются вместе в тексте. Далее нужно определить общее количество всех возможных пар слов в тексте. Если в тексте есть N слов, то возможных пар слов будет примерно (N−1), если учитывать порядок следования слов. Вероятность совместного появления двух слов P(X,Y) вычисляется как отношение числа случаев совместного появления этих слов к общему числу словосочетаний.
🤷 Основной недостаток MI заключается в том, что она придает слишком большое значение редким событиям, что может приводить к завышению их значимости в анализе.
❓ Что делает "взаимная информация"?
❗️ Измеряет, насколько два слова связаны друг с другом, то есть как часто они встречаются вместе по сравнению с тем, как часто они могли бы встречаться случайно.
📝 Простой пример: Если слова "молоко" и "кофе" часто встречаются вместе (например, "кофе с молоком"), MI будет высокой, потому что эти слова явно связаны.
🚫 Проблема: MI может "переоценить" редкие слова. Например, если слова "редкое" и "слово" встретились вместе только один раз в огромном тексте, MI всё равно может дать высокое значение, даже если это совпадение.
❓ Как работает "Log-Likelihood"?
❗️ Log-Likelihood проверяет, насколько факт, что два слова встречаются вместе, отличается от того, что мы ожидали бы, если бы эти слова были совершенно независимы.
📝 Простой пример: Если "молоко" и "кофе" часто встречаются вместе больше, чем это должно происходить по случайности, Log-Likelihood скажет нам, что эта связь важна. Но если они встречаются редко, Log-Likelihood всё равно может показать, что это значимо, потому что учтет, как часто слова появляются по отдельности.
✅ Преимущество: Log-Likelihood лучше справляется с редкими словами, потому что учитывает не только их совместные появления, но и то, как часто они вообще встречаются в тексте.
❓ Почему же тогда "взаимную информацию" используют в корпусной лингвистике? Судя по частотным коллокациям, это связано с изучением "коллокаций" (см. конспект). Следовательно, эта метрика может быть относительно полезной?
@raumanalysis_ih