
🔢 Ожидаемая частотность: ключевые слова #корпусная_лингвистика
💭 Продолжаем выяснять статистическую сторону частотности.
😔 До сих пор мы использовали сугубо простую, "сырую" частотность для определения релевантности слов и коллокаций, необходимой для понимания семантики текста и слов.
💡 Однако в случае с ключевыми словами, — то есть, инструментом, позволяющим сравнивать корпусы и определять, какие слова встречаются крайне часто в одном корпусе по сравнению с другим, — мы, того не осознавая, пользовались статистической мерой под названием Log-Likelihood, которая является стандартной в программе "AntConc". Эта мера строится на основании ожидаемой частотности.
💻📚 Поискали в нашем корпусе англоязычных книг по корпусной лингвистике (378 наименований; 35,2 млн слов) высказывания авторов о "Log-Likelihood" в контексте ключевых слов. См. конспект.
🤖 Используем ChatGPT 4o для объяснений и расчетов.
💭 Итак, есть простая частотность — сколько раз слово употребляется в тексте.
💭 Есть нормализованная частотность — сколько раз слово употребляется относительно размера самого текста, если привести измерение к стандарту, например, к 1000 или 1 млн слов. Она показывает, как часто слово встречается в тексте, независимо от его размера.
❗️ Однако есть и ожидаемая частотность — сколько раз слово должно появляться в тексте на основе его простой частотности в нескольких текстах.
📝 Допустим, мы анализируем два текста:
1️⃣ В первом тексте 1000 слов, и слово "этика" встречается 5 раз (простая частотность).
2️⃣ Во втором тексте 2000 слов, и слово "этика" встречается 15 раз (простая частотность).
Нормализованная частотность для первого текста равна 0.5%, а для второго — 0.75%.
Если ожидаемая частотность слова "этика" на основе других текстов (например, корпуса всего языка) составляет, например, 0.4%, то оба текста показывают, что слово "этика" используется чаще, чем ожидалось, но во втором тексте оно используется особенно часто.
❗️ Впрочем, ожидаемую частотность можно выделить и на основании только двух текстов:
1️⃣ Сначала находим общую простую частотность слова в обоих текстах. Например, если слово "истина" встречается 30 раз в первом тексте и 10 раз во втором, то его общая простая частотность — 40 раз.
2️⃣ Затем учитываем размер каждого текста. Допустим, первый текст содержит 1000 слов, а второй — 2000 слов.
3️⃣ Ожидаемая частотность рассчитывается на основе простой частотности слова и соотношения с размером текста:
🔢 Ожидаемая частотность слова в первом тексте определяется так: (Общая простая частотность слова) × (Размер первого текста / Общий размер обоих текстов).
🔢 Ожидаемая частотность слова во втором тексте рассчитывается аналогично.
❗️ Ожидаемая частотность показывает то, сколько раз слово должно было бы появиться в тексте на основе данных из нескольких текстов и их размеров. Она основана на предположении, что слово распределяется поровну между текстами.
❗️ Ожидаемая частотность важна для сравнения того, насколько простая частотность слова отличается от того, какая частотность должна была бы быть. Если оно встречается намного чаще, чем ожидалось, то это указывает на то, что слово важно или характерно для этого текста.
❗️ Ожидаемая частотность играет ключевую роль в метрике Log-Likelihood, поскольку она служит базовой точкой для сравнения, помогающей оценить, насколько слово является ключевым для текста.
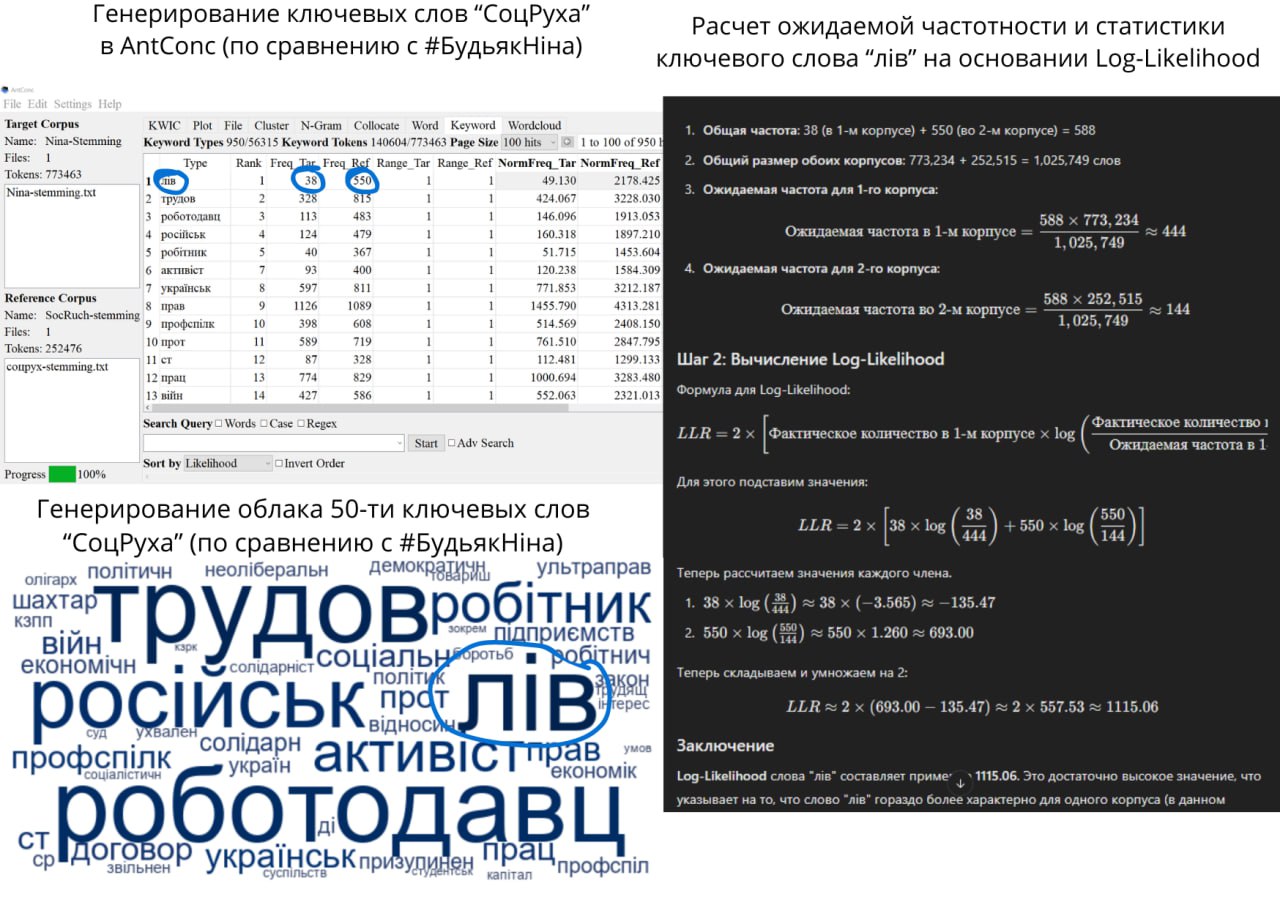
💭 Так и было выяснено за одну секунду в AntConc'e, что "лів" (левые) является самым ключевым (статистически значимым) словом для корпуса "СоцРуха" по сравнению с корпусом #БудьякМи (см. 🖼).
❗️ Следовательно, ожидаемая частотность и метрика Log-Likelihood позволяют более точно показать семантический фокус текста при сравнении с другим текстом. Впрочем, это не отрицает важности и простой частотности, тем более, что репрезентативных корпусов целых языков для сравнения у нас, например, нет (есть только подобные тексты по тематике).
💡 Интересно, что ожидаемая частотность и метрика Log-Likelihood работают также и для определения релевантных коллокаций в одном тексте, но об этом мы поговорим позднее.
@raumanalysis_ih
Post #817
80
- 👍 4
- 🔥 1
- 👏 1