
🔑🆒 Ключевые слова #корпусная_лингвистика
💻📚 Продолжаем рассказывать о важнейших понятиях-инструментах корпусной лингвистики. В предыдущих сериях у нас были частотности, коллокации, конкордансы и n-gram'ы. Все эти понятия-инструменты позволяют выяснить содержание текста и значение слов в нем.
💭 Ключевые слова (инструмент "Keyword" в AntConc'e) позволяет работать с несколькими корпусами, что полезно, если нужно провести диахроническое исследование (как мы сделали тут и тут), а также выяснить разные перспективы рассмотрения одного и того же предмета (что мы сделали вчера).
🔎 Посмотрели материалы по инструменту "Keyword" в нашем корпусе англоязычных книг по корпусной лингвистике (378 наименований), чтобы прояснить это понятие.
✅ Анна Марчи пишет, ссылаясь на создателя понятия-инструмента Майка Скотта, что ключевым словом является слово с необычной частотностью (высокой или низкой) в одном корпусе (Reference Corpus) по сравнению с другим корпусом (Target Corpus). Эта частотность определяется статистически (стандартная метрика в AntConc - LogLikelihood), а также в связи с частотностью слова относительно объема всего корпуса (т. наз. нормализированная частотность) при сравнении аналогичной метрики у другого корпуса; "эта "необычная частотность" определяется вероятностью появления слова в целевом тексте на основе перекрестного анализа", как пишет Эрик Фриджинал. Использование этого инструмента полезно, например, для сравнения с общим корпусом языка при изучении корпуса газеты, что может дать понимание политической позиции, жанровой специфики и аудитории у газеты. Однако дальше нужно проводить качественные исследования текста на основании конкордансов.
✅ Хейзел Прайс пишет, что "анализ ключевых слов дает представление о содержании корпуса или о том, что в нем является особенным. Анализ ключевых слов может быть полезным инструментом для понимания и описания современных или исторических культурных тенденций, стереотипов в тексте или подборке текстов. Это, безусловно, ценный метод для анализа потенциальных изменений в обществе в диахронических специализированных корпусах".
✅ Лоренцо Мастропьерро пишет, что генерирование ключевых слов — "это эффективный способ начать исследование, поскольку он существенно сужает круг данных для анализа и облегчает выбор меньшего количества объектов для детального изучения. В то же время эта процедура позволяет избежать предвзятости исследователя, поскольку ключевые слова генерируются компьютером автоматически, "вслепую", без учета смысловых связей между ними".
✅ Майкл Стаббс пишет, что "эта техника позволяет получить эмпирические данные о том, как одна и та же тема может быть представлена с разных точек зрения. Неудивительно, что деловое издание видит тему с абстрактной финансовой точки зрения, а таблоид - с более конкретной личной точки зрения...".
💭 Итак, ключевые слова показывают отличия между текстами по содержанию, что полезно для исторических, социологических и т.д. исследований, когда нужно сравнить лексиконы разных авторов, эпох, теорий и т.д. Безусловно, опираться только на ключевые слова не стоит. Необходимо использовать несколько инструментов корпусной лингвистики для детального, эмпирического изучения текстов.
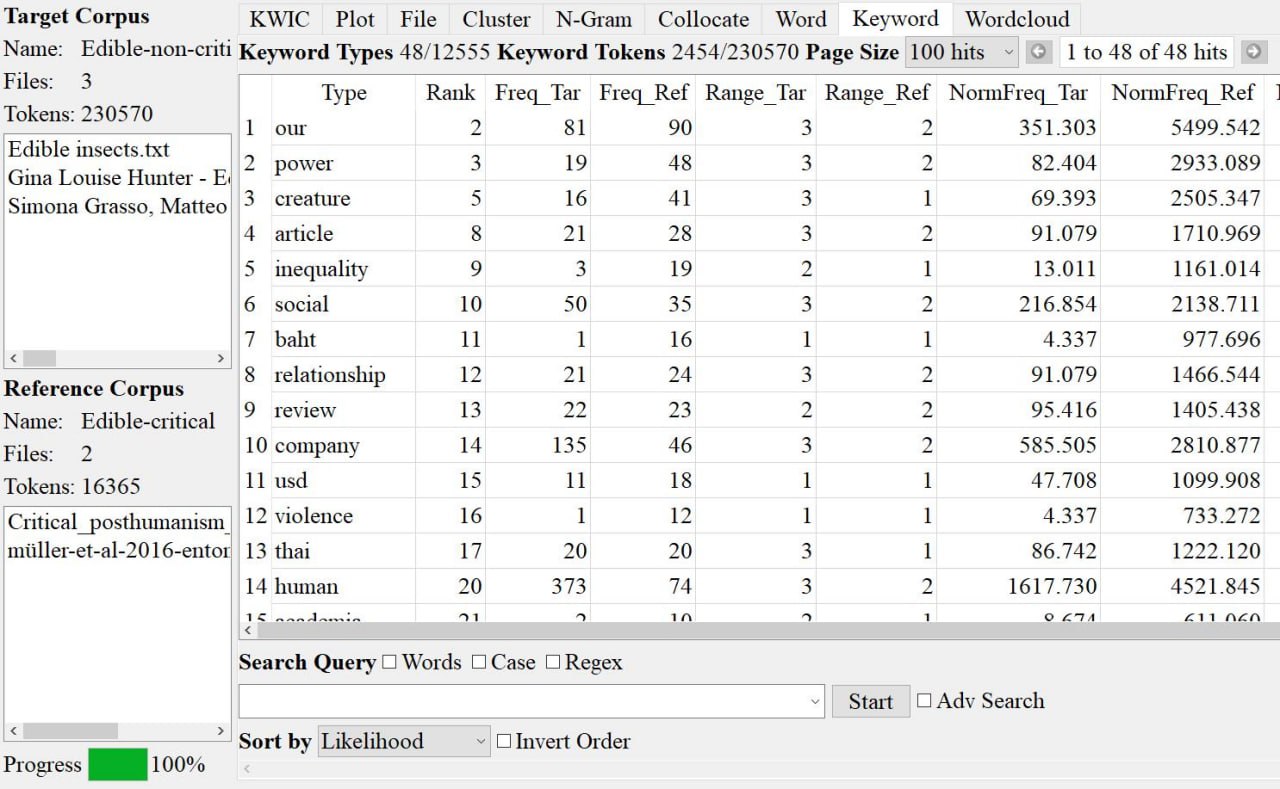
🖼 На картинке можно увидеть ключевые слова, сгенерированные на основе сравнения двух корпусов по вопросу об энтомофагии. В роли Reference Corpus (тот корпус, который будет сравниваться с корпусом-основой) для сравнения выступают две статьи, в которых расширяется перспектива рассмотрения проблемы энтомофагии с учетом неравенства и видоцентризма. Этот корпус сравнивается с корпусом (Target Corpus, то есть, основа для сравнения) из трех книг, в которых защищается энтомофагия. Как видим, при сравнении мы можем увидеть фокус Reference Corpus'a - власть, неравенство, насилие и т.д.
@raumanalysis_ih
Post #642
58
- 👍 4