
🔢 Ожидаемая частотность: коллокации #корпусная_лингвистика
💭 Продолжаем выяснять статистическую сторону частотности. Ранее речь шла об ожидаемой частотности в рамках ключевых слов.
💭 Контекст всей этой сложности: 1) ранее мы делали упор на простую частотность — если слова часто употребляются в тексте, то значит, они определяют его тематику; если одни слова употребляются рядом с другими часто (коллокация), то это определяет семантику исходных слов; 2) теперь же мы дополняем понимание частотности посредством статистического измерения, то есть, берем частотность из меры, которая сравнивает частотность слов и словосочетаний с а) общим количеством слов в тексте (нормализованная частотность), б) соотношением количества слов в одном тексте по сравнению с другим текстом (нормой, национальным корпусом и т.д.) (ожидаемая частотность).
❗️ Это позволит, во-первых, более точно определять релевантные слова и коллокации посредством статистической меры (автоматически просчитываемой в программе AntConc), и, во-вторых, создает порог для статистически релевантных слов и словосочетаний (например, с Bonferroni❓, но об этом мы сделаем отдельную публикацию), а не довольствоваться произвольным выбором из сотен и тысяч слов и коллокаций, как было раньше (теперь их может быть всего 40).
😁❓ Причем здесь философия?
Мера Log-likelihood важна для философии, потому что она позволяет выявлять статистически значимые связи между словами, раскрывая неявные концептуальные структуры и незаметные на первый взгляд взаимосвязи в текстах. Это помогает философам точнее анализировать идеи, аргументы и концепты, обнаруживая неявные смысловые связи, которые могут быть ключевыми для интерпретации философских текстов и понимания логики дискурса.
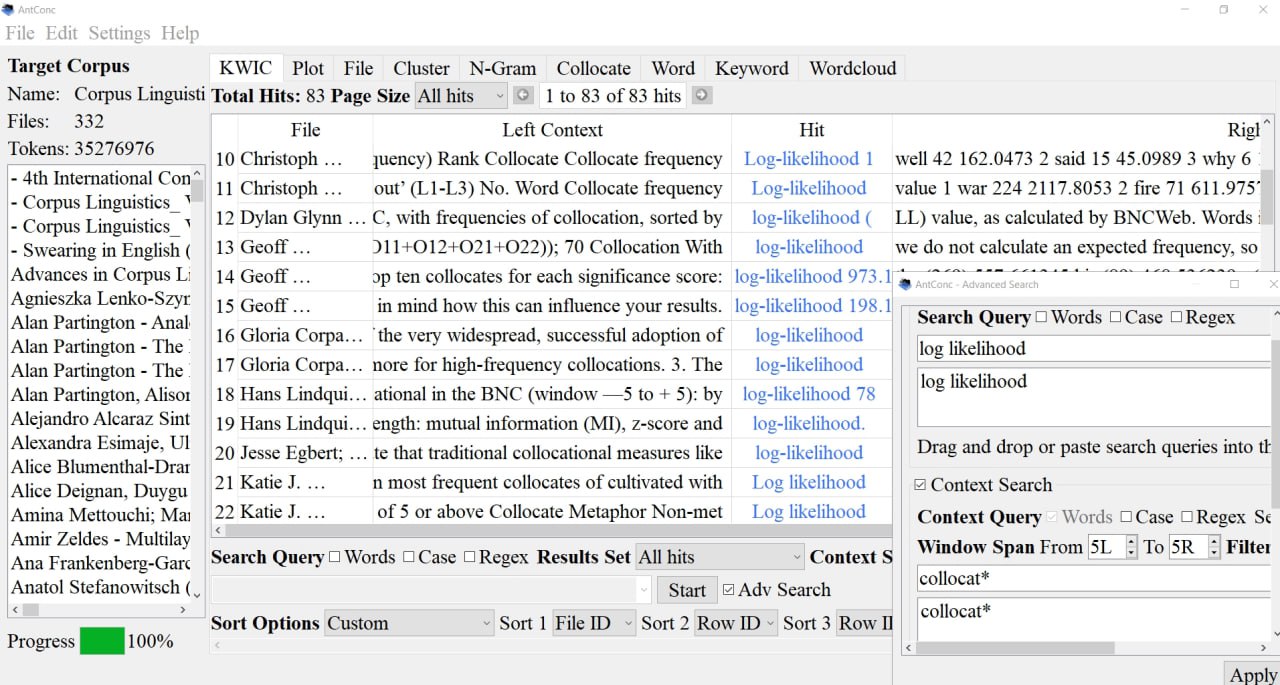
💻📚 Поискали в нашем корпусе англоязычных книг по корпусной лингвистике (378 наименований; 35,2 млн слов) высказывания авторов о "Log-Likelihood" в контексте коллокаций. См. конспект.
✅ Результаты
💭 Log-Likelihood является распространенной мерой для измерения коллокаций, которая делает акцент на частотности, принимая в расчет фактическую и ожидаемую частотности слов. Есть и критика Log-Likelihood, но она крайне неубедительна. Бейкер объяснил формулу Log-Likelihood для коллокаций, которую мы попросили, в свою очередь, объяснить ChatGPT 4о.
❗️ В log-likelihood сравниваются наблюдаемые частотности (то, как часто два слова встречаются вместе в тексте) с ожидаемыми частотностями (то, как часто они должны были бы встречаться вместе, если бы распределялись случайным образом).
☝️ Наблюдаемая частота — это то, как часто два конкретных слова (например, "green" и "energy") фактически встречаются вместе в тексте. Если они встречаются вместе 10 раз в тексте, то наблюдаемая частотность совместного появления равна 10.
☝️Ожидаемая частота — это теоретическое значение, которое показывает, как часто эти два слова должны были бы встречаться вместе, если бы их появление было случайным и зависело только от их индивидуальной частотности в тексте, а не от каких-либо связей между ними.
🔢 Вот так это выглядит в виде формул:
Ожидаемая частота:
m = (f1 * f2) / N
Допустим, в тексте из 1000 слов, слово "green" встречается 50 раз, а слово "energy" — 30 раз.
Подставляем значения:
m = (50 * 30) / 1000 = 1.5 (то есть, полтора раза эти слова могут встретиться в тексте случайно; если log-likelihood будет больше 1.5, то значит, сочетание этих слов не является случайным!)
Здесь:
f1 = 50 (частотность слова "green"),
f2 = 30 (частотность слова "energy"),
N = 1000 (общее количество слов в тексте).
Log-likelihood (G²):
G² = 2 * Σ (O * (log(O) - log(E)))
Если, например, O = 10 (наблюдаемая частотность совместного появления "green" и "energy") (это та самая простая частотность коллокаций, с которой мы работали до сих пор), и E = 1.5 (ожидаемая частотность), то формула будет:
G² = 2 * (10 * (log(10) - log(1.5))) = 37.94.
💻📚 Этот расчет делает AntConc за 1 сек.
😎 Следовательно, встреча "green" и "energy" в гипотетическом тексте является статистически значимой, закономерной, неслучайной, то есть, это коллокация (см. пример)!
@raumanalysis_ih
Post #826
78
- 👍 4
- 🔥 1
- 👏 1