TGViewer
Channel Public Channel
Information Retriever

Information Retriever

@inforetriever

Author: @kkhrylchenko

Рекламу не размещаю.
Subscribers
4.13K
Photos
326
Videos
2
Links
168

Showing posts older than #428 · Back to latest

Older Posts 17 shown
Post #424 2.62K
KDD’26, день первый.

На конференции собралась индустриальная тусовка — приехали ключевые рекомендательные команды из вообще ВСЕХ больших компаний.

1. Сходил на первую половину Tutorial on Generative Recommendation: Foundations and Frontiers от Kuaishou и City University of Hong Kong. Выделили два (будущих?) тренда:
* если изначально все использовали encoder-decoder модели для генеративного ретривала, потому что в них было удобно впихивать богатый контекст; то сейчас двигаются в сторону decoder-only моделей, которые лучше скейлятся
* диффузионные подходы, при которых мы предсказываем сразу все семантические токены целевого айтема — очень перспективное направление, которое позволяет избавиться от аккумуляции ошибок при авторегрессивной генерации токенов

После кофе-брейка я на туториал не вернулся, потому что:
* были супер энциклопедические слайды, на которых перечислялось много статей по паре минуток каждая, очень поверхностно, без инсайтов, с неточностями
* при этом не было живого рассказа — весь текст зачитывался. Надеюсь, потом выпустят с этим текстом техрепорт)) Ну а если серьезно, то проще слайды полистать

2. Пообщались с Федором Борисюком. Когда возле него осталась только наша русская компашка, Федор сам первый перешел на русский язык :) Что рассказывал:
* если я все правильно понял, он сейчас руководит тремя командами. Что-то возле поиска и рекомендаций
* статьи пишут по выходным. К процессу привлекается большое количество коллег. Федору просто нравится писать статьи и прокачивать репутацию, а у коллег есть мотивация участвовать как минимум чтобы получить грин-карту))
* сам Федор сторонник того, чтобы на работе со всеми уважительно и дружелюбно обращаться, налаживать хорошие отношения. И максимально коллаборироваться, делать совместные проекты. Но говорит, что это иногда приводит к плохим последствиям, во время политических игрищ
* у него всегда часть проектов долгосрочные, а часть краткосрочные. Долгосрочными как правило занимается небольшая команда из 2-3 человек. Если проект планируется на год-полтора (больше бизнес вряд ли вытерпит), то расставляются майлстоуны на каждые полгода с оффлайн-метриками
* если попался плохой руководитель, то надо просто ротироваться и не мучаться :)
* через полтора месяца должен быть дроп крутой новой статьи от Линкедина

3. Воркшоп Two-sided Marketplace Optimization: Search, Discovery, Matching, Pricing & Growth. Было выступление от Director of Research @ Spotify, Paul Bennett — From User Needs to Ecosystem Design: How AI Is Reshaping Discovery. Рассказывал про кейсы, в которых применяют LLM:
* Steerable recommendations — тюнят модель с помощью контрольных токенов выдавать familiar (пользователь уже взаимодействовал с подкастом >10 минут за последний месяц) и unfamiliar контент в рекомендациях. Похоже на мою идею с обуславливанием, про которую рассказывал на Turbo ML Conf 2025
* Intent-aware search — в поиске есть разные сценарии; иногда нужно просто включить рекомендации с какими-то настройками, иногда запустить реальный поиск, иногда просто найти артиста, иногда что-то еще. LLM можно использовать как router, который определяет в какой api (recs/search/etc) нужно отправлять запрос
* Conversational discovery — часто пользователи сначала сами не знают какие им нужны рекомендации; и только в процессе взаимодействия с рекомендательной системой начинают понимать чего все-таки хотят. И для этого как раз нужен multi-turn диалог, в котором они могут и промежуточные рекомендации получить, и пообщаться с рексистемой

4. Что еще:
* на конференции 70+ русскоговорящих участников, это очень много. Много людей со статьями, а еще есть студенты с ИИ360 программы. Жутко им завидую, меня бы кто на первом-втором курсе на конференцию отправил! Говорят, что ничего непонятно, но все очень вдохновляет)
* все офигевают от джетлага
* даже в Линкедине (!) разработчики слушают наш DeepRecsys курс :)
  • 🔥 34
  • ❤ 14
  • ❤‍🔥 5
Post #423 2.26K
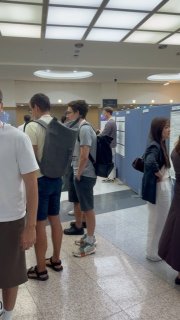
Предлагаем вам окунуться в атмосферу постерной сессии
  • ❤ 32
  • 🔥 15
  • 🤩 8
  • 🥴 4
Post #422 2.31K

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • 🔥 42
  • 🥰 13
  • 🤝 1
Post #421 2.47K
В преддверии KDD’2026 на Чеджу была обнаружена весьма солидная делегация
  • ❤ 55
  • 🔥 18
  • ❤‍🔥 13
Post #420 3.83K
Готовлюсь к KDD
  • ❤ 52
  • 🔥 9
  • 🤣 8
  • 😍 2
  • 🤩 1
Post #417 4.89K
  • 🔥 41
  • 😁 23
  • 🤪 8
  • ❤ 2
  • 👍 2
  • 👌 1
  • 🫡 1
Post #416 3.97K
ACM SIGIR 2026.

В этом году Артём Матвеев, Владимир Байкалов и Серёжа Макеев (ребята из моей бывшей команды, соавторы по Аргусу и другим статьям, а также помощники по Deep RecSys курсу) съездили в Австралию на SIGIR со своими работами, которые я уже упоминал пару постов назад.

Почитать про конфу можно на канале Владимира @ducks_recs и Артёма @nxt_item.

Первый пост на канале Артёма — инсайдерская инфа из личного общения с инженером из команды OneRec: тык. Лично мое мнение про OneRec от этой инфы не поменялось (узнать его можно из лекции про генеративные модели), но для кого-то она может стать неожиданностью :)

Подписывайтесь!

P.S: картинку украл из @MLunderhood))
  • ❤ 21
  • 👍 5
  • 😍 3
Post #415 3.44K

Forwarded from Рекомендации, Поиск и Путешествия (Sasha Petrov)

USRW 2026: Call for Papers — дедлайн продлён до 27 июля 🔎

Это тот самый Unified Search and Recommendation Workshop, который я недавно упоминал в посте про мои воркшопы на RecSys. Теперь можно наконец рассказать подробнее: мы опубликовали программу и открыли приём статей.

Для меня это первый опыт организации отдельного воркшопа — и особенно приятно, что он посвящён теме, вокруг которой, собственно, и строится этот канал.

Главная идея USRW проста: поиск и рекомендации слишком долго развивались как разные дисциплины, хотя обе решают одну и ту же задачу — помогают человеку найти нужный контент. С появлением LLM, generative retrieval и агентных систем граница между query-driven search и feed-driven recommendation становится всё менее естественной.

Но «объединить» не значит просто объявить поиск и рекомендации одной и той же задачей. Мы хотим разобраться, что действительно можно сделать общим — данные, представления, генерацию кандидатов, ранжирование, интерфейсы и протоколы оценки, — а где различия в сигналах, UX, задержке, стоимости и управляемости остаются принципиальными.

В программе:

🎤 Mounia Lalmas (Senior Director of Research, Spotify) — «Building AI-Driven Experiences at Scale: When Search and Recommendation Become One Conversation»

🎤 Harrie Oosterhuis (Associate Professor, University of Amsterdam / Amazon Scholar Amazon Music) — «Learning to Rank Everything, Everywhere and All at Once»

🧭 Dive Deep tutorial, который мы проведём вместе с Gustavo Penha. Поговорим об общих корнях поиска и рекомендаций, слоях их возможного объединения, semantic IDs, generative retrieval, языковых интерфейсах, агентах и реальных production-компромиссах.

В Call for Papers ждём работы про:

• единые модели поиска и рекомендаций;
• общие представления пользователей и объектов;
• моделирование поведения между search- и feed-сценариями;
• LLM для понимания запросов и намерений;
• generative retrieval, semantic IDs, RAG и agentic discovery;
• смешанные поисково-рекомендательные интерфейсы;
• общую инфраструктуру и методы оценки;
• эффективность, устойчивость и безопасность;
• индустриальные кейсы, датасеты и benchmarks.

Формат: 4–9 страниц без списка литературы, ACM SIGCONF, двойное слепое рецензирование.

Воркшоп неархивный: принятая статья будет размещена на сайте USRW, но авторы сохраняют право впоследствии отправить её расширенную версию в конференцию или журнал. Также выберем лучшую работу для Best Paper Award.

⏰ Дедлайн подачи: 27 июля 2026 года, 23:59 AoE
📍 Воркшоп: 2 октября 2026 года, Миннеаполис, ACM RecSys 2026
🔗 Сайт, полный CFP и подача статьи: https://usrw-workshop.github.io/2026/

Организуем USRW вместе с Sean MacAvaney (University of Glasgow), Gustavo Penha (Spotify), Léa Briand (Deezer) и Clémence Vast (Deezer).

Если у вас есть работа на стыке поиска и рекомендаций — от новой модели до индустриального кейса или benchmark, — буду очень рад увидеть её на USRW.

И буду благодарен, если перешлёте этот анонс коллегам, которым тема может быть близка 🙌
usrw-workshop.github.io USRW 2026 — Unified Search and Recommendation Workshop First Unified Search and Recommendation Workshop at ACM RecSys 2026, Minneapolis, MN, USA.
  • ❤ 7
Post #414 3.86K
Где-то два с половиной года назад на конференции по рексистемам в Вышке, куда я пришел слушателем (так появилась секция кулуары, которой, кстати, давно не было), мне задали вопрос — почему у нас нет научных публикаций. Я ответил, что у ребят в Яндексе, занимающихся рексистемами, нет KPI на статьи — только KPI на внедрения.

При этом я, конечно, не воспринимал вопрос лично, но сам уже долгое время горел идеей писать статьи, публиковаться на конференциях, участвовать в жизни научного сообщества.

Через год я съездил на свою первую большую конференцию ACM RecSys’24. Про эту поездку есть целая серия постов; нетрудно понять, что мне очень понравилось)) Был даже маленький забавный моментик, когда я во время выступления Эда Чи что-то спросил, а он ответил “А может, вы про это статью и напишете” :)

KPI не то чтобы после этого поменялся, но как будто подвернулся хороший момент, чтобы попробовать. Мы разработали и внедрили в Яндекс Музыку большую рекомендательную трансформерную модель (тот самый Аргус); и казалось логичным превратить это внедрение в статью. Затем, при подготовке лекции для ШАДа про LogQ коррекцию для двухбашенных моделей, я обнаружил ошибку в широко используемой формуле. Когда принес своим ребятам выкладки, далеко не все сразу поверили, что такое вообще возможно))

Было крайне нетривиально одновременно работать фуллтайм, преподавать новый курс в ШАДе и при этом еще и писать сразу две статьи. Но каким-то образом все получилось, и примерно год назад у нас сначала приняли на ACM RecSys’25 статью про LogQ коррекцию, а затем спустя еще полгода приняли на ACM KDD'26 статью про Аргуса. И вот я радостный стою уже 7 часов возле постера на рексисе и рассказываю всем окружающим про LogQ коррекцию)) А потом ночью в караоке пою Radiohead Creep в толпе рексисоидов

И самое крутое, что мы на этом не остановились:
* на тот же ACM RecSys’25 была принята работа про датасет Yambda, в которой я лично не участвовал, но поучаствовали ребята из нашей команды — Влад Тыцкий и Владимир Байкалов
* также мы заняли в том году четвертое место на RecSys Challenge и написали про это статью, которую приняли на RecSys Challenge Workshop
* на ACM SIGIR приняли статью Владимира Байкалова и его студентов из ИТМО про дообучение семантических айдишников
* туда же на ACM SIGIR приняли статью от ребят из нашей (бывшей) команды — Артёма Матвеева, Влада Тыцкого, Сережи Макеева и Сережи Лямаева, про улучшение архитектуры энкодер-декодера для generative retrieval

Ну и вот сейчас у нас приняли статью на воркшоп ACM KDD’26, продолжающую линию ресерча из статьи Top-K Off-policy Correction for a REINFORCE (я периодически шучу, что надо было её назвать "Correcting the Off-Policy Correction" в духе нашей LogQ статьи). Про нее я написал в прошлом посте.

Кроме того, на архиве появились препринты, про которые смею надеяться, что они дойдут до публикации:
* мой Variable-Length Semantic IDs
* Gryphon от ребят из Яндекса, в котором поучаствовали Олег Сорокин и Влад Додонов из нашей бывшей команды (читайте подробности про статью на канале Даши @redrecsys)

И все это произошло только за последний год! Хочется верить, что мы только в начале пути и нас всех ждет еще миллиард параметров приключений и публикаций :)

P.S: KPI с тех пор у многих поменялся и теперь содержит публикации статей))

P.P.S: близится KDD’26 — ждите серию постов, а может даже и мини-влог!
  • ❤ 51
  • 🔥 27
  • ❤‍🔥 8
  • 👍 3
  • 👏 3
  • 💯 3
  • 😁 1
Post #413 3.69K
А у нас тут приняли статью на ACM KDD’26 5th Workshop on End-to-End Customer Journey Optimization!

Подробности читайте в LinkedIn посте первого автора, Артема Матвеева: https://lnkd.in/p/eqdJ3zdG

И ссылка на саму статью: https://arxiv.org/abs/2607.02818
  • 🔥 44
  • ❤ 13
  • 🏆 10
  • 😁 3
  • 👍 2
  • ❤‍🔥 1
Post #412 3.43K
You and Your Research.

Я уже упоминал "An Opinionated Guide to ML Research" Джона Шульмана (тык), а сегодня хочу рассказать про другое эссе, на которое ссылается сам Шульман. А именно — про "You and Your Research" Ричарда Хэмминга (того самого, который hamming distance).

Оказалось, он на протяжении своей карьеры целенаправленно изучал, что делает других ресерчеров успешными. Почти инфоцыганством занимался =)

Собственно, в рамках эссе делится своими выводами по теме. Например:
* если не стараться работать именно над важными задачами, то и крутых результатов не достигнешь. Очень легко скатиться в более простые и понятные задачи, которыми заниматься комфортно, но к каким-то значимым результатам они не приведут
* по вечерам пятницы он выделял себе время, чтобы размышлять над тем, что вообще в его области сейчас происходит важного, какие есть самые важные вопросы, проблемы, задачи. Буквально 10% своего времени на такое философствование
* когда получаешь новую информацию, нужно стараться связать её со всем, что уже знаешь; чтобы её потом было проще найти и использовать (это уже почти принцип построения zettelkasten)

Прямо пересказывать эссе не хочется, когда оно у вас есть в прямой доступности. Там еще много разных мыслей, а воды почти нет. Прочитайте / посмотрите сами!

Есть транскрибация исходного выступления 1986 года — https://www.cs.virginia.edu/~robins/YouAndYourResearch.pdf, как раз на неё ссылается Шульман.

Есть запись выступления 1995-го года на YouTube — https://www.youtube.com/watch?v=a1zDuOPkMSw.
  • ❤‍🔥 22
  • 🔥 9
  • ❤ 6
  • 👍 3
Post #411 4.81K
Research Is Not Engineering at a Slower Speed.

https://voiceinthemachine.com/2026/06/10/research-is-not-engineering-at-a-slower-speed/

Я когда-то уже писал пост про то, чем занималась моя R&D команда, а тут вышел довольно интересный write up про различия между ресерчем, R&D и продуктовой разработкой от очень опытного чувака (сам Ян Лекун его рекомендует). Tldr такой, что в ресерче и продуктовой разработке все просто и понятно (с точки зрения ролей, системы оценивания и тд), а в R&D — наоборот. И что компании часто смешивают внутри R&D кучу всякой деятельности.

У меня ровно так и было — команда одновременно делала:
* и ресерч — копание в статьях, создание новых моделей и архитектур; была наша собственная амбиция догнать и перегнать дипмайнд по части рекомендашек
* и довольно большой объем продуктовой разработки — копание в конкретных продуктовых доменах, активное участие в доведении моделей до прода, много внедрений каждое полугодие
* и строила инфру — инструменты для работы с данными, обучения и внедрения моделей

В статье также много места посвящено тому, где компании часто спотыкаются:
1. Оценивают ресерчеров по инженерным метрикам
2. Называют инженерную деятельность прорывным ресерчем
3. Теряют тот ресерч, который зародился сам по себе и не вписывается в рамки существующих процессов

Со всеми пунктами тоже согласен, видел похожее на практике. Чтобы был сильный ресерч, нужны соответствующие люди, с нужными навыками и опытом. Все эти три пункта мешают найму/росту таких людей; скорее их отталкивают.

До сих пор довольно много про это думаю в контексте рексистем — как правильно организовать такую команду, как её правильно оценивать, как найти/взрастить нужных людей, органично интегрироваться в структуру большой организации. Мыслей и идей за последний год накопилось много, надеюсь, доведется их как-нибудь реализовать.
  • ❤ 40
  • 👍 13
Post #410 4.8K
Следующая аватарка канала
  • 😁 82
  • 🥴 4
  • 🔥 2
  • 🙉 2
  • 👎 1
  • 🤬 1
  • 🐳 1
Post #409 4.83K
Команда ванрека выпустила новый тех репорт, про ризонинг, на 108 страниц. Скоро начнут выпускать пятитомники))

https://arxiv.org/abs/2606.06260
  • 😁 35
  • 🙉 6
  • 🤣 4
  • 🔥 2
  • 👍 1
  • 🐳 1
Post #408 10.5K
Deep RecSys Course — В С Ё!

Вот и все! Неплохой получился курс: интересный, весёлый, порой немного грустный, а главное поучительный...

Получилось 13 лекций:
1. Введение в рекомендательные системы
2. ML дизайн рекомендательных систем
3. Двухбашенные нейросети I: обучение
4. Двухбашенные нейросети II: архитектура
5. Нейросетевое ранжирование I: обработка признаков
6. Нейросетевое ранжирование II: слои
7. Рекомендации на последовательностях
8. Графовые нейросети
9. Ранжирование в рекламной сети Яндекса
10. Обучение с подкреплением I: exploration и бандитные алгоритмы
11. Обучение с подкреплением II: REINFORCE
12. Генеративные рекомендации
13. Исследования Sber AI Lab в области рексистем

Большая часть семинаров — это разборы основных статей по теме; по сути, мы провели небольшой научный семинар в рамках курса.

А ещё у нас были домашние задания, подготовленные специально для курса:
1. Бейзлайны: item-to-item CF, ALS, эвристики
2. Двухбашенные нейросети, где нужно было пощупать разные лоссы, включая logQ коррекцию
3. Нейросетевое ранжирование: PLE, unified embeddings, DCN-v2, многоголовость, ResNet/DenseNet
4. Авторегрессивные трансформеры для next-item prediction

И, наконец, есть финальный проект, который ребята еще сдают; в рамках него нужно на основе статьи сделать свое собственное мини-исследование.

Все материалы можно найти на Github, а записи — на YouTube. Для ленивых есть отдельный плейлист.

Я очень рад, что получилось сделать такой большой курс, и даже записать его и выложить целиком. На это, конечно, потребовалось просто гигантское количество времени)) Раньше ребята, которые выходили работать ко мне в команду, получали эти знания по крупицам целыми ГОДАМИ. А здесь можно получить те же знания, посмотрев 30+ часов концентрированного контента.

Хочу сказать спасибо:
1. Артёму Матвееву и Владимиру Байкалову, которые выделили свое драгоценное свободное время, чтобы подготовить и провести целых 10 семинаров, а также помогли подготовить и проверить кучу домашних заданий
2. Нашим гостям Сергею Макееву, Александру Андрееву, Маргарите Мишустиной и Алексею Васильеву, которые сделали в рамках курса отличные гостевые доклады
3. ФКН НИУ ВШЭ и в частности Евгению Соколову за то, что фактически спонсировали всю эту мою активность. И еще и разрешили сделать её открытой. Без ВШЭ и Евгения никакого открытого курса бы не было! Да и в принципе такого большого курса бы не было.
4. Нашей замечательной команде курса в ШАД, с которой началась эта эпопея по созданию рексис курса. И в частности Дане Ткаченко, который изначально позвал меня вместе делать курс в ШАДе

А вам, дорогие мои читатели, спасибо, что читали, слушали и поддерживали. Fin. :)
  • ❤ 161
  • 🔥 54
  • 🎉 38
  • ❤‍🔥 7
  • 👏 4
  • 👍 1
Post #407 3.91K
Deep RecSys Course XIII.

Сегодня было финальное занятие курса — гостевая лекция от Лёши Васильева, руководителя команды рекомендательных систем Sber AI Lab. Лёша в подробностях рассказывал про статьи, в написании которых участвовала его команда; некоторые из них мы уже упоминали в рамках курса.

Был блок статей про оценку качества:
1. Quality Metrics in Recommender Systems: Do We Calculate Metrics Consistently?
2. An Analysis of Sequential Patterns in Datasets for Evaluation of Sequential Recommendations
3. Time to Split: Exploring Data Splitting Strategies for Offline Evaluation of Sequential Recommenders

И про алгоритмы:
1. Turning Dross Into Gold Loss: is BERT4Rec really better than SASRec?
2. Autoregressive Generation Strategies for Top-K Sequential Recommendations
3. Let It Go? Not Quite: Addressing Item Cold Start in Sequential Recommendations with Content-Based Initialization

У Лёши есть тг-канал — @recsys_themes. Подписывайтесь!

YouTube
  • ❤ 24
  • 👍 13
Post #406 4.64K
Wake up, honey, a new Google DeepMind RecSys paper just dropped.

Вышла статья ORBIT: Preserving Foundational Language Capabilities in GenRetrieval via Origin-Regulated Merging от авторов TIGER и PLUM.

Если натюнить LLM на рекомендательную задачу, она теряет способность "разговаривать", если не тюнить — качество рекомендаций плохое. Как получить модель, которая одновременно и разговаривает, и хорошо рекомендует?

Про PLUM. В PLUM они файнтюнили Gemini на задачу рекомендаций в два этапа:
1) Сначала учили модель понимать каталог через две задачи — предсказание следующего айтема и восстановление метаданных айтема по semantic ID
2) Затем дообучали на generative retrieval

В статье были черри-пикнутые примеры на тему того, что после первой стадии модель все еще понимает естественный язык. Но про вторую стадию таких примеров не было, что наводило на мысль, что после generative retrieval fine-tuning разговорные способности теряются. Собственно, в новой статье они про это явно сказали.

Что делают в новой статье. Используют model merging — простое усреднение параметров нескольких чекпойнтов модели. Берут исходный "разговорный" чекпойнт LLM (здесь это 1B версия Gemma3) и усредняют его с дообученной на рекомендации версией. Если усреднять уже в самом конце дообучения, то работает плохо, а вот если по мере дообучения раз в какое-то количество шагов — работает хорошо.

Origin-Regulated Merging. Метод Soup-to-go, который раз в K шагов обновления параметров делает слияние моделей, уже довольно неплохо работает. Но авторы смогли относительно него еще улучшиться — заметили, что чем "дальше" модель от исходного разговорного чекпойнта, тем больше падают способности, связанные с текстом. Они ввели метрику близости между чекпойнтами модели (рассматривают два варианта — евклидово расстояние и доля несовпадающих по знаку параметров) и задали пороговое значение метрики, после которого должно срабатывать слияние текущего чекпойнта с исходной LLM. Сначала слияние происходит часто (e.g., каждые 500 шагов), затем реже (каждые 3к шагов).

Мое мнение.
* Как всегда, пользуются надежным рецептом успеха — адаптируют к рексистемам общие deep learning техники. Кажется, в DL такой трюк используют с 2022-го года — начиная со статьи Model Soups
* Для замера рекомендательного качества используют очень нереалистичный сетап из TIGER — Amazon reviews с leave-one-out сплитом, еще и всего 20 событий в истории пользователя
* И важный момент — усредненная модель всё еще существенно хуже на рекомендательных задачах, чем просто зафайнтюненная модель; и хуже на разговорных, чем исходный LLM чекпойнт
  • 🔥 33
  • 😁 6
  • ❤ 4
  • 👍 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →