TGViewer
Channel Public Channel
Duck's on Recs

Duck's on Recs

@ducks_recs

Subscribers
619
Photos
33
Videos
1
Links
20
Recent Posts 10 shown
Post #51 664
Вот такое сегодня прилетело, даже интересно чем там люди занимаются :)
  • 🔥 25
  • 💅 10
  • 😁 3
  • ❤ 2
  • 🐳 1
  • 💯 1
  • 👻 1
  • 👾 1
Post #50 553

Forwarded from AI VK Hub

Репортаж с KDD 2026 ⬆️

На прошлой неделе команда AI VK Research участвовала в KDD 2026 — одной из ключевых мировых ML-конференций. Наши ребята представили результаты двух своих исследований, посвящённых развитию рекомендательных систем.

Что обсуждали на KDD, какие тренды появились и как прошла презентация работ команды, рассказывает старший исследователь AI VK Research Артём Матвеев 🎬


Подробнее об исследованиях

➡️ Session-Level Optimization for Large-Scale Retrieval using REINFORCE with Multi-Step Off-Policy Correction
🟣Обзор статьи

➡️ Planning over Matrix-Factorization MDPs for Candidate Generation
🟣 Обзор статьи

#aivkhub #конференция #kdd #recsys #репортаж
  • ⚡ 7
  • 🔥 5
  • 👀 4
  • 👨‍💻 1
Post #49 577
Папарацци поймали за рассказом постера на KDD и начали задавать всякие вопросы :)
  • 💅 6
  • 😁 3
  • 😎 2
  • 👾 1
Post #48 645

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • 🔥 10
  • ❤ 3
  • ✍ 1
  • ⚡ 1
  • 🤝 1
Post #47 973
Это Артем, тот самый мой коллега, про которого я писал выше. Очень советую подписаться. Тёма очень сильный во всех смыслах :) , опытный и интересный человек. На его канале точно будет много чего интересного
Telegram next item Автор: @matfu21
  • ❤ 10
Post #46 783

Forwarded from next item

Поговорил с Jiangxia Cao из Kuaishou OneRec Team на SIGIR’26

Признаю, я давний фанат Kuaishou. Это люди, которые внедряют много всего в прод и с невероятной скоростью. При этом еще и успевают писать про это статьи.

На конференции SIGIR’26 мне удалось пообщаться с Jiangxia Cao, одним из ключевых разработчиков в OneRec Team из Kuaishou. У него более 1800 цитирований, он является соавтором таких работ, как OneReason, Kwai Summary Attention, QARM, OpenOneRec и еще многих других. Отдельно хочу отметить его отзывчивость и позитивность.

У меня к нему было много вопросов, но задал я лишь маленькую часть. Несколькими решил с вами поделиться.

* Сейчас происходит активное интегрирование LLM в рекомендательные системы. Какие вы с командой видите наиболее перспективные направления?

Они верят в три способа, как можно внедрять LLM в платформу с рекомендациями коротких видео:
1. Как generative retrieval на semantic ids, то есть как дополнительный источник кандидатов. Понятный способ, активно внедряют к себе многие крупные ребята. Здесь как раз примерами служат такие работы, как OneReason от Kuaishou или PLUM от DeepMind.
2. Как “агента”, который может замешивать разные кандидатогенераторы (кандгены). Будто вызов каждого источника кандидатов — это свой tool call. Необычный способ, раньше про такой не слышал. Jiangxia сказал, что у них может быть до 200 кандгенов. И нужно как-то адаптивно под запрос пользователя выбирать подмножество из них. После этого выходы именно этих выбранных кандгенов и будут ранжироваться последующими моделями в стеке. То есть LLM в некотором смысле выполняет роль Mixigen.
3. Как инструмент, через который можно управлять бесконечной лентой рекомендаций через текст. Мы открыли ВК Клипы, и он на их примере показал, как это выглядит. Если человек, например, 5 раз подряд быстро пролистал клипы, то появляется текстовое окно. В него ты можешь вписать, какой контент ты хочешь видеть в ленте. И лента подстраивается под тебя. Если ты ставишь дизлайк на клип, то вылезает еще одно окно, в которое ты вписываешь, что тебе не понравилось. Такая фича в Kuaishou появляется уже через месяц! Большой шаг в сторону controllable и unbiased рекомендаций.

* В вашем текущем OneRec Technical Report после генерации кандидатов генеративной моделью есть еще доотбор Reward-моделью. А вы не думали о том, чтобы от этой стадии доотбора избавиться?

Здесь он сказал, что через месяц как раз выходит статья про это. Но отдельно подчеркнул, что в коротких видео их основная рекомендательная система состоит из четырех стадий, в которой OneRec заменяет только первые две.

* Как вам удается писать так много статей? У вас на это есть специальные KPI, и вас хвалят за статьи на ревью?

Сказал, что они работают с понедельника по пятницу в обычном режиме. Их KPI — это растить продуктовые метрики. А по выходным уже пишут статьи в свое удовольствие. Получается, 9-9-6 — это обман, у ребят пятидневка.

Дальше мы много говорили про OneReason. Это большой техрепорт от ребят на 110 страниц. Сделаю про него отдельный разбор на канале, уж очень масштабная работа. И уже там расскажу подробности.

И еще несколько интересных фактов:
* Послушали вместе мою волну в Яндекс Музыке. У меня пошел русский рэп. Он попросил включить погромче, и ему прям зашло.
* Он знает про работу ребят из Яндекса — Gryphon: A Unified Architecture for Semantic-ID Generation and Item-Level Scoring in Industrial Recommendations. Сказал, что они ее там все вместе читали.
  • ❤ 4
Post #45 655
SIGIR'26 (часть 3): последний пост этой серии

На четвертый день конференции был Industry Day, на котором удалось поговорить с исследователями из KuaiShou (OneRec Team), JD.com (OxygenRec) и ByteDance (Staff Senior который занимается GenRec).

Закину несколько основных тейков, которые я узнал:
1) Пока что ни у кого не удалось внедрить у себя полноценные end-to-end рекомендательные системы. Модели, про которые пишутся в статьях пока внедряются не как замена всего пайплайна, а определенного числа других моделей (обычно кандидатогенераторов)
2) У всех в разном виде есть re-ranking стадия после применения OneRec-like моделей
3) Сделать полностью end-to-end систему у KuaiShou удалось только в сервисе где внедряли OneLoc. Моя гипотеза — из-за изначально слабого бейзлайна
4) Так как сами по себе OneRec-like модели не дают дискаверийность, убрать кандидатогенератор, который отвечает за exploration, никому из тех с кем общался не удалось
5) KuaiShou и ByteDance приходят к тому, что хоть в будущем все еще остается re-ranking стадия, есть смысл инвестировать в попытку обучить модель, которая выдают адекватное качество и без нее. Привел им аналогию, которую уже много с кем обсуждал про парето-оптимальность семейства моделей по осям вычислений и качества, в один голос согласились, что скорее всего придут к чему-то подобному в ближайшем будущем
6) Обе эти компании видят, что и OneRec-like, и re-ranking будут в каком-то виде шарить параметры моделей между собой, но наборы фичей будут различными (с более выразительными у второго)
7) Отдельно спросил ByteDance про HyFormer и подобные подходы. Изначально было интересно, зачем они инвестируют в такие модели, но после п.1, п.2 и п.5 понятно почему они это делают, говорят, что тут с KuaiShou немного разошлись разными путями: одни больше инвестируют одну стадии, а другие во вторую

Важный момент: все вышеописанное это лишь вершина айсберга, всего лишь затравка!
Более подробные результаты "допроса" одного из главных авторов OneRec v1, OneRec v2 и OneReason скоро будут, но не от меня. С ним очень детально пообщался мой коллега.

В этот же день была церемония закрытия.
Одновременно хорошая и плохая новость: узнал где будут проходить SIGIR'27. Так как в следующем году конференции исполняется 50 лет, то её юбилей будут отмечать не в абы каком месте, а в мировом центре IT. Плохую часть новости читателю предлагается додумать самостоятельно...

В пятый заключительный день были воркшопы, про который я ничего сказать не могу, так как их я пропустил :)

Как итог, конференцией я остался очень доволен: пообщался с кем хотел, узнал самое волнующее и необходимое, распланировал будущие направления работы, увидел Австралию наконец (albeit no kangaroo has been spotted).

P.S. Надеюсь мой недельный спам раздражал вас не особо сильно, ухожу на небольшой перерыв, ведь скоро будет еще и KDD'27!
  • 🔥 16
  • 🤓 2
  • 🦄 2
  • ☃ 1
  • 😁 1
Post #40 620
SIGIR'26 (часть 2): день со статьей

Сегодня был еще один день с постерами, на котором я больше четырех часов простоял у своего. Под вечер уже кажется сорвал голос и так себе говорил из-за этого.

С локацией постера мне очень повезло, он был на проходном месте, из-за чего суммарно у постера за это время остановились и пообщались более 50 человек (просто вчиталось суммарно больше). В какой-то момент к постеру, подошел инженер из ByteDance (TikTok) и начал говорить, что они у них такая же боль есть как у меня в статье. Будут пробовать схожую идею в A/B тесте в будущем.

Закину еще люминальное пространство, которое я нашел, когда заблудился в здании конференции уже поздно вечером :)
  • ❤ 21
  • 🔥 10
  • 🦄 2
  • 🌚 1
  • 💋 1
Post #31 659
SIGIR'26 (часть 1): дни 1–2

Уже прошли 2 из 5 дней SIGIR'26. Поскольку официальное открытие было только во второй день, решил объединить первые два дня в один пост. SIGIR устроен примерно как и многие другие конференции: в первый день проходят туториалы и Doctoral Consortium, затем три основных дня с докладами и постерными сессиями, а в последний день воркшопы.

В первый день я сходил на два туториала: LLM Personalization и IR & Reasoning.

Про LLM Personalization рассказывала большая команда из нескольких азиатских университетов, включая NUS. С частью ребят я был знаком ещё с одной из конференций в 2024 году. Главная мысль туториала заключалась в том, что персонализация это не просто добавить историю пользователя в промпт. Авторы предложили рассматривать её как полноценный стек из нескольких частей: память, архитектура модели, alignment, test-time scaling и deployment. Больше всего мне запомнилась их предложение отойти от one-size-fits-all парадигмы и использовать для разных сценариев отдельные адаптеры, которые и отвечают за персонализацию. Похожую мысль буквально неделю назад видел в рилсах про работу Meta, связанную с моделированием человеческого мозга :)

На втором туториале про IR & Reasoning выступала команда Мартина из UvA. По моему субъективному мнению, его лаборатория одна из немногих в Европе по Information Retrieval, которая занимается действительно интересными вещами. Больше всего запомнился анализ того, что именно RL даёт моделям для reasoning. Рассказывали, что RLVR не сильно меняет top-k ответы модели, а лишь немного поднимает вероятность уже хороших результатов. Были и отсылки к философии и 12 типам рассуждений. На мой вопрос о том, достигнет ли модель AGI, если в совершенстве сможет освоить все эти типы, Мартин ответил, что тогда другие модели нам уже просто не понадобятся. Ждём и надеемся! Ещё поговорили про Implicit Reasoning. Он сказал, что лично верит в это направление и его команда уже им занимается. Пока основная проблема в том, как заставить модель действительно рассуждать с помощью латентных токенов, а не просто использовать их как ещё одно скрытое представление.

Был еще забавный момент был, когда на вопрос: “Can Bayesian methods enhance the reasoning capabilities of LLMs?” ответили: “Probably” :)

Оставшуюся часть первого дня провёл за нетворкингом: старался ловить людей из индустрии и узнавать, чем сейчас занимаются их команды. Многие активно инвестируют в Generative RecSys, что довольно ожидаемо. Самыми скрытными и труднодоступными оказались ребята из OneRec Team в Kuaishou. Для них буквально было специальное время, когда инженер из из команды посетит конференцию.

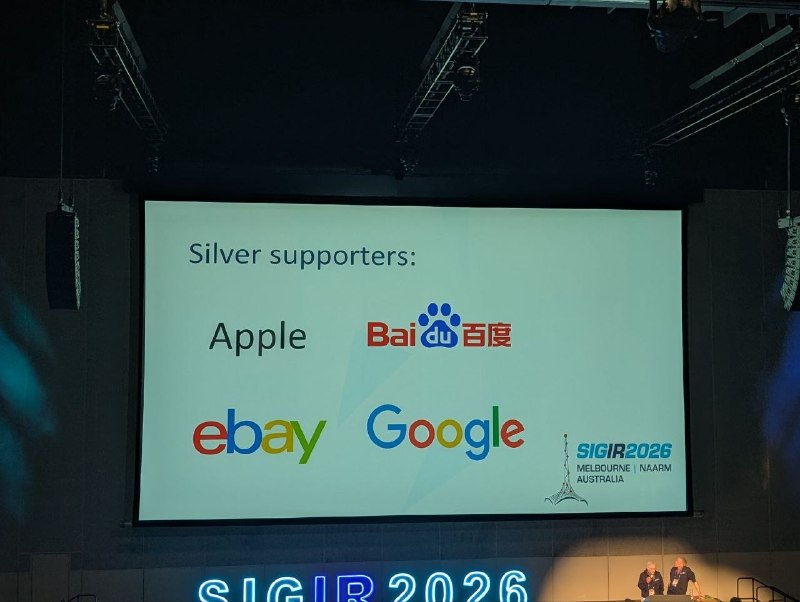
Во второй день прошло официальное открытие. Его можно увидеть на фото в посте.

Был keynote от бывшего Principal Engineer с примерно 20-летним опытом работы в Microsoft на тему "Towards Critical IR Theories and Practices". Там обсуждали технофеодализм, связанные с ним проблемы и то, как с этим можно жить. В качестве одного из решений предлагалось создавать независимые, unbiased и trustworthy рекомендательные системы. Идея оказалась очень похожа на то, что мы с ребятами придумали почти год назад на RecSys Summer School. Но открытый вопрос остался тем же: как сделать такую систему массовой и реально донести её до пользователей?

Оставшееся время я провёл в зале с постерами, где были работы из research, reproducibility и resource tracks. Больше всего запомнился постер инженера из Booking/Aampe про Off-Policy Evaluation. Работа оказалась довольно похожа на нашу, про которую я писал пару постов назад. По постеру показалось, что их метод можно рассматривать как частный случай нашего подхода. Ещё увидел постер с идеей проекта, которую больше полугода назад давал своим студентам на практике про использование LLM для улучшения контентного эмбеда в сценарии с предсказаниями semantic IDs. Надо было самим довести её до ума, и сейчас была бы ещё одна публикация на конфе :)

P.S. Места в посте не хватает, в комментариях допишу и добавлю статистику
  • ❤ 16
  • 🔥 10
  • ⚡ 4
  • ☃ 1
  • 👾 1
Older posts →

About this channel

How can I read @ducks_recs without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Duck's on Recs: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Duck's on Recs have?
Duck's on Recs (@ducks_recs) has 619 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Duck's on Recs know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →