TGViewer
Channel Public Channel
Аналитика в HR | HR-tech

Аналитика в HR | HR-tech

@analytics_hr

HR-аналитика | HR-tech
Авторский образовательный канал, посвящённый HR-аналитике, исследованиям рынка труда, HR Tech-решениям и AI.
Subscribers
659
Photos
250
Videos
0
Links
90

Showing posts older than #269 · Back to latest

Older Posts 20 shown
Post #268 362
#методы #согласованность

Вот очень простой (проще чем расчет Альфа Кронбаха) метод проверки согласованности ответов в опросах.

⚡️ Inter-Item Correlation — простой способ оценки согласованности опроса без сложных формул.
Суть метода доовльно проста, мы расчитываем корреляцию между всеми вопросами и смотрим на среднее значение этой коррелчции.
Логика метода простая: если вопросы измеряют одно и то же — они должны быть связаны, но не идентичны.

🔹 Как считать:

1. Рассчитываем корреляцию (обычно Пирсона или Спирмена) между всеми парами вопросов.
2. Находим среднее значение этих корреляций.
3. Интерпретируем значение:
0.7–1 — оптимально: шкала согласована.
<0.7 — слабая связь между вопросами.

Пример на скрине выше.
  • 👍 2
Post #267 353
⚡️Индекс Симпсона (Simpson’s Diversity Index, D) — показатель измеряет вероятность того, что два случайно выбранных сотрудника из коллектива будут принадлежать к разным категориям (по полу, возрасту, опыту и т.д.).

🔹 Формула: D = 1 - Σ(pᵢ²),
где pᵢ — доля категории i (например, женщин, мужчин).
Интерпретация:
D → 0 — одна доминирующая группа
0,4-0,6 — среднее значение (бенчмарк M&S)
D → 1 — равномерное распределение.

🔹 Пример:
Структура персонала в компании: 50% линейный персонал, 30% специалисты, 20% руководители.
D = 1 - [(0.5² + 0.3² + 0.2²)] = 1 - (0.25 + 0.09 + 0.04) = 0.62
Значение в норме, дополнительных действий не требуется.

🔹 Отличие от индекса Шеннона:
— Шеннон чувствительнее к редким категориям и логарифмически "штрафует" доминирование.
— Симпсон проще: он даёт «шанс» различий, и значение легче интерпретировать.

Если нужно быстро и наглядно сравнить отделы по разнообразию — Симпсон удобнее. Если интересны тонкие различия в структуре — выбирайте Шеннона.
  • 👍 2
Post #266 373
#метрики #надежность #альфа_кронбаха

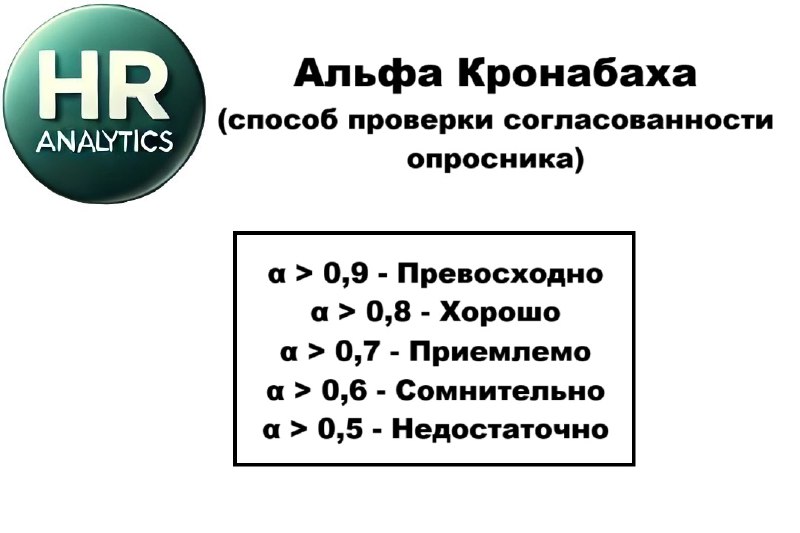
⚡️ Альфа Кронбаха (Cronbach’s alpha) — метрика, которая показывает, насколько надёжно работает ваш опрос или шкала. Используется для оценки внутренней согласованности набора вопросов.

🔹 Формула (упрощённая):
α = (N / (N - 1)) * (1 - (∑σ²_i / σ²_total)), где:
N — число вопросов,
σ²_i — дисперсия по каждому вопросу,
σ²_total — дисперсия по сумме баллов по всем вопросам.

🔹 Интерпретация на скрине.
Показатель сравнивается с пороговыми значениями. Опросник считается согласованным при α > 0.7

🔹Пример:
12 вопросов по вовлеченности, ответы по шкале от 1 до 5. Если α = 0.85 — отлично.
Если α < 0.7 — шкала ненадёжна, вопросы не «работают вместе».

Часто используется в психометрических опросниках, опросниках по вовлеченности и удовлетворенности. Выводится как дополнительное значение.
Альтернативный способ - воспользоваться калькулятором. Например, таким
  • 👍 3
Post #265 337
#исследования

🔍 Внутренняя согласованность — это характеристика шкалы или опроса, показывающая, насколько все вопросы действительно измеряют одно и то же.
В HR-аналитике согласованность особенно важна при расчёте сложных индексов — вовлечённости, удовлетворённости, выгорания. Чем этот показатель выше, тем лучше.

🔹 Где нужна согласованность:
— При расчёте итоговых баллов (например, средний по шкале)
— В шкалах Ликерта (1–5, 1–7), где ответы агрегируются
— В опросах, где строится индекс или интегральный показатель
— В оценках компетенций с несколькими индикаторами в одном блоке

🔹 Где согласованность не требуется:
— В анкетах с независимыми блоками (офис, команда, задачи)
— В ситуациях, где важна каждая тема по отдельности

🔹 Пример:
Если вы используете 6 вопросов для оценки командного взаимодействия, но только 3 из них реально про команду, а остальные — про ИТ-системы и график работы, индекс теряет достоверность. Альфа Кронбаха (об этом в следующем посте) в этом случае покажет низкое значение.
  • ❤ 2
  • 👍 2
Post #264 435
#личное #Садовое

Сегодня в Москве прошёл интересный беговой ивент — забег по Садовому кольцу на 15 км.
Традиционно, результаты подвезли очень быстро, так что у нас есть возможность проанализировать их. Это никак не относится к HR-анализу, но автор, пользуясь своим положением, рассказывает ))

На графике гауссовое распределение результатов участников.
По оси Х - результаты в минутах, по оси Y - доля участников с этим результатом. Колонки - это отображение кол-ва участников с такими результатами.

Общие агрегированные данные на скрине, а вот самые "быстрые" города (от 5 участников, среднее время) по агрегированным данным:
Смоленск — 72.3 мин
Фрязино — 74.6 мин
Щёлково — 75.3 мин

В абсолютных же числах, как всегда, Казань — самый быстрый город России. Теперь живите с этим :)
  • ❤ 4
  • 👍 2
Post #263 412
#метрики #Shannon #diversity

⚡️Индекс Шеннона (Shannon Index, H) — простая и удобная метрика для оценки разнообразия в компании.
Чем равномернее представлены разные категории (пол, возраст, опыт), тем выше H.

🔹 H = -Σ(pᵢ * ln(pᵢ)),
где pᵢ — доля каждой категории (например, женщин, мужчин).
Максимальное значение H зависит от количества категорий (n). Если все категории равны по численности, то H = ln(n). Чем ближе фактический H к этому максимуму, тем выше разнообразие.

🔹 Пример:
в команде 6 мужчин и 4 женщины.
p₁ = 0.6, p₂ = 0.4
H = -[(0.6 * ln(0.6)) + (0.4 * ln(0.4))] ≈ 0.673

🔹 Интерпретация:
в нашем примере 2 группы м/ж. Их Ln(2) = 0,69. Это значение будет показывать максимальное разнообразие.
Мы получили 0,67. Уровень разнообразие в нашем примере высокий.

🔹 Использование:
—для сравнения подразделений и выявления “однородных” команд;
—для мониторинга diversity and inclusion, если компания их измеряет.

если вам лень считать руками, можно воспользоваться калькулятором. Например, таким или таким
  • 👍 4
Post #262 386
#метрики #CandB #CR #MR

⚡️Compa-ratio и Market-ratio (CR, MR) — группа ключевых C&B-метрик в арсенале HR-аналитика. Они помогают определить, насколько уровень оклада сотрудника соответствует рыночным ориентирам (MR) и уровню в рамках компании (CR).
CR показывает отношение фактической зарплаты к среднерыночной для аналогичной должности.

🔹 Market-Ratio = (Фактическая зарплата / Рыночный ориентир) × 100%
> 100% — зарплата выше рынка
= 100% — зарплата соответствует рынку
< 100% — зарплата ниже рынка
🔹 Сompa-Ratio = (Фактическая зарплата / Средняя зп в компании) × 100%

🔹Для чего использовать:
—Принятие решений о пересмотре оклада;
—Проектирование ФОТ при запуске новых подразделений;
—Настройка политики по управлению компенсациями;
—Инструмент карьерного планирования.

🔹Пример:
Средняя рыночная зарплата логиста — 120 000 ₽. В компании сотрудник получает 100 000 ₽. Тогда:
MR = 100000 / 120000 = 0.83 (или 83%)
Вывод: зарплата сотрудника ниже рыночной.
  • ❤ 3
  • 👍 2
Post #261 425
#визуализация

⚡️ Граф анализа стажа — простой и доступный инструмент для экспресс диагностики жизненного цикла сотрудников в компании. Он показывает, как изменяется численность персонала по мере увеличения стажа работы.

🔹Построение:
Разбиваем сотрудников на группы по стажу (например: 0–6 мес, 6–12 мес, 1–2 года, 2–3 и т.д.)
Считаем количество сотрудников в каждой группе
Строим гистограмму или line chart — ось X: стаж, ось Y: кол-во сотрудников
Альтернатива — кумулятивная кривая оттока (cumulative attrition curve):
Ось X — месяцы с даты выхода
Ось Y — % сотрудников, покинувших компанию

🔹Пример:
на скрине выше построенный график с резким падением "выживаемости" на периоде 4 и более лет. Это может говорить о проблемах с построением долгосрочной карьеры к компании

Граф помогает выявлять уязвимые фазы (например, стаж <1 года) и принимать точечные меры: усиление онбординга, менторство, корректировка нагрузки.
  • 👍 5
Post #260 419
#метод #переработки

⚡️ Метод анализа общей рабочей загруженности помогает выявить систематически перегруженных сотрудников до выгорания. Особенно важно в командах с гибким графиком или удалёнкой.

🔹 Как считать:
1. Собираем данные из систем учета времени (таймтрекеры, календарь, вход-выход)
2. Рассчитываем среднюю продолжительность дня (AvgHours):
Σ(рабочих часов) / кол-во рабочих дней
3. Сравниваем с нормативом (обычно 8 ч/день, обед.час не считаем).
4. Определим % превышения (Overload):
((AvgHours - 8) / 8)
5. Рассчитываем общую загруженность(TotalOvr):
(кол-во дней с переработками/всего рабочмз дней)

🔹Интерпретация:
Если Overload% > 0,15 или TоtalOvr> 0,25 — это красный флаг и повод для разговора.

Также важно учитывать дни с аномальной нагрузкой (например, >10 часов) и их частоту:
OverloadDaysRatio = (дней с >10 ч) / (всего дней). Это еще один показатель, который можно "зашить" в систему контроля загруженности сотрудников
  • 👍 4
  • ❤ 3
Post #259 374
#метрики #CandB #SRP

⚡️Индекс вхождения в ЗП-диапазон (Salary Range Penetration, SRP) — это метрика, которая показывает, где находится оклад сотрудника относительно всего диапазона грейда (или зарплатной вилки).

🔹Формула:
SRP = (Оклад — нижняя граница диапазона) / (верхняя граница диапазона — нижняя граница диапазона)

🔹Как использовать (одна из стратегий применения SRP):
❕Отрицательное значение SRP означает, что оклад сотрудника не попадает в диапазон грейда для его должности. Обычно это зарплаты сотрудников, которые только приступили к работе, недавно перевелись на новую должность и пока не в полной мере соответствуют требованиям.
❕0,3–0,6 — вторая треть диапазона, соответствующая сотрудникам, которые в полном объёме выполняют свои задачи.
❕0,6–1 — верхняя треть, обычно включает высокоэффективных сотрудников или тех, кто готовится к повышению.
❕>1 — оклад превышает верхнюю границу диапазона. Такие должности считаются "переплаченными".

Классический подход — избегать значений SRP меньше 0 и больше 1.
  • 👍 4
Post #254 389
#Excel #массивы

Формулы массивов всегда стояли обособлено от остальных функций Excel из-за своей замороченности.
Но, начиная с 2019 года, в Excel появились динамические массивы, мир заиграл новыми красками и проклятье Ctrl+Shift+Enter кануло в вечность ))

⚡️ Динамические массивы — это формулы, которые возвращают сразу несколько значений и автоматически "разливаются" по ячейкам.
Работают это просто. В любой пустой ячейке можно вставить ссылку на часть таблицы или целую таблицу, при этом будет транспонирована или часть или вся таблица (как на скрине).

🔹 Особенности динамических массивов
— Если входной диапазон меняется (добавили строки), результат обновляется автоматически — никакой ручной корректировки формул.
— Если что-то поменяется в исходной таблице, то изменится и таблица по ссылке.
— Проводить манипуляции с данными в динамическом массиве нельзя. Это приводит к ошибке ПЕРЕНОС.
  • ❤ 3
  • 👍 2
Post #253 362
#Excel #умные_таблицы

⚡️ Умные таблицы (Excel Tables) — интересный инструмент в Excel, который многие просто игнорируют. И напрасно. У таких таблиц есть несколько очень полезных функций, которые упрощают работу по анализу больших таблиц.

🔹 Как создать:
Выбрать любую ячейку в таблице и нажать Ctrl+T или «Форматировать как таблицу» на вкладке Главная.

🔹 Преимущества:
— Автоматическое распространение формул и форматов данных на новые строки по всей таблице, если вы заволлите новую строку. Супер удобно.
— Удобно работать с динамическими массивами и формулами массивов
— Автооформление новых строк к единому формату
— Повышенная читаемость и чистота модели.

🔹 Недостатки:
— Не всегда совместимы со старыми макросами и внешними подключениями.
— В больших таблицах могут замедлять работу Excel.

🔹 Когда использовать:
Использовать стоит, когда это обновляемая и дополняемая БД, которая служит источником для других таблиц.
  • 👍 3
  • ❤ 1
Post #251 398
#методы #Excel #дисперсия #ANOVA

Продолжаем искать связи и закономерности )

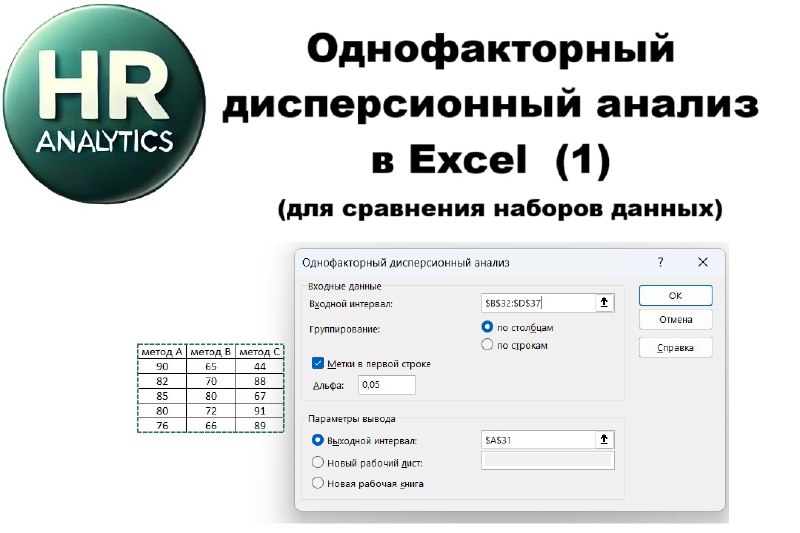
Для того, чтобы реализовать ANOVA в Excel нам потребуется раздел анализ данных.

Раздел Данные > Анализ данных > Однофакторный дисперсионный анализ.

Входной интервал - массив данных
Метки в первой строке - если выбрали названия заголовков
Альфа - оставляем 0,05
Выходной интервал - место где будет размещен анализ.

🔹 Интерпретация:
1. Если P-value <0,05. Все хорошо, исходная гипотеза корректна.
2. Если F > F критического - модель значима.

🔹 Пример:
в нашем примере 3 набора данных с результатами производительности сотрудников после обучения. Наша гипотеза - разное обучение влияет на производительность по разному. Нулевая - обучение на результат не влияет (то есть средние значения одинаковы во всех группах).

После проведения анализа получили результат:
P-value = 0,35. То есть вероятность ошибки первого рода 35%. Гипотеза неверна.
F = 1,1 при F-крит= 3,8 (табл). То есть модель не объясняет различия между гр.

Гипотеза отклонена
  • 👍 3
Post #250 393
#методы #Excel #дисперсия #ANOVA

⚡️ Однофакторный дисперсионный анализ (ANOVA, от англ. Analysis of Variance) — это статистический метод, который позволяет сравнивать группы данных и определить, есть ли между ними статистически значимые различия по их признаку.

🔹 Используется:
Проверить, влияет ли один категориальный фактор на непрерывную переменную.
Например: у нас есть результаты сотрудников, которые проходили разное обучение. Наша задача понять связанны ли результаты обучения с типом обучения.
Исходная гипотеза - да, связаны. Нулевая - нет, не связаны.

🔹 Рассчитывается:
Классический путь: рассчитываем Межгрупповую дисперсию (BG.) и Внутригрупповую дисперсию (WG.), Потом F-критерий Фишера = BG/WG.
если F = 1, то нулевая гипотеза верна
если F > 1, то нулевая гипотеза неверна
...но это довольно сложно. Мы будем делать через Excel (след.пост).

🔹 Требования к данным:
1. Данные количественные
2. 3 и более групп данных
3. Выборки независимы
4. Данные подчиняются норм. распр.
  • 👍 3
Post #245 421
#метрики #адаптация #Time_To_Productivity #TTP

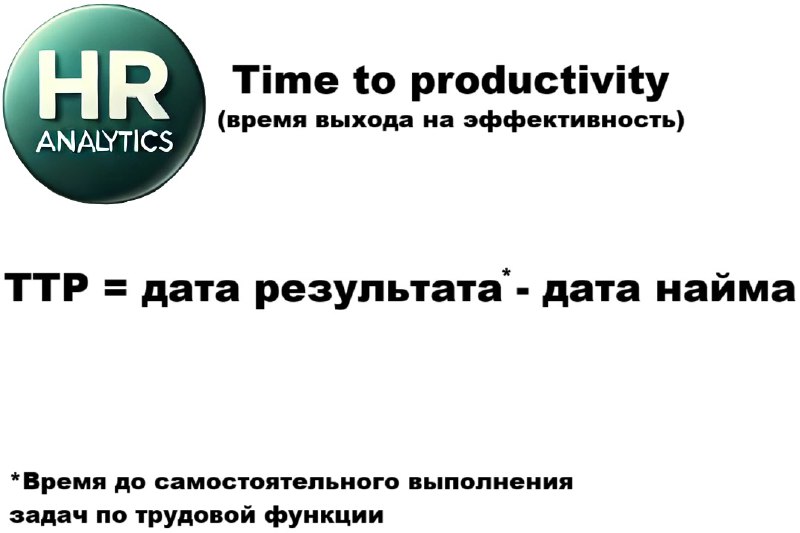
⚡️ Время выхода на продуктивность (Time to Productivity, TTP) — довольно хитрая, но эффективная метрика, которая показывает, сколько времени требуется новому сотруднику, чтобы начать работать с ожидаемой эффективностью.

Логика у метрики простая - показать сколько нужно времени сотруднику для того, что бы начать выполнять свои основные обязанности, а вот с расчетом часто возникают сложности.
Главная хитрость тут в том, что в качестве результата нужно закладывать обычные задачи сотрудника. Это должна быть операционная цель сотрудника по его трудовой функции. Задачи по KPI или OKR (квартальные, годовые не важно) здесь не подойдут.

🔹Пример:
Финансовый менеджер с трудовой функцией: подготовка управленческой отчетности, начал работать 1.02,
20.03 он самостоятельно подготовил управленку за месяц.
TTP составил 47 дней.
  • 👍 4
  • ❤ 2
Post #239 444
#визуализация #boxplot

⚡️ Boxplot (ящик с усами) — инструмент для анализа разброса значений в ряду данных. Он помогает наглядно увидеть медиану, разброс значений и выявить аномалии на одном графике.

🔹 Как строится Boxplot?
Для построения ящика с усами потребуется ряд значений, которые относятся к одному объекту. Например, зп в отделе или стаж. На вкладке вставка выбираем тип диаграммы "Ящик с усами" и выделяем нужный диапазон значений.

Крестик в центре - это среднее арифметическое значение (65 833).
Медиана (линия внутри ящика) – линяя внутри (65 000), центральное значение зарплат.
Первый и третий квартили (границы ящика) – это 25% и 75% перцентиль (75,000 и 55,000)
"Усы" – это весь ряд данных. Его границы: мин и макс
Точки за гранью усов - выбросы. В нашем примере таких значений нет.

🔹 Для чего использовать:
Чтобы наглядно увидеть распределение значений в ряду данных. Например, зп, производительность, стаж и пр.
  • 👍 3
  • ❤ 1
Post #238 453
#визуализация

Пост навеян общением с коллегами-преподавателями дисциплины "дизайн презентаций" ))
Что НЕ рекомендуют делать в презентациях по визуализации данных, особенно в дашбордах:

❌ 1. Использование 3D-графиков
Объемные диаграммы искажают восприятие и не очень хорошо читаются. Лучше использовать 2D-графики.

❌ 2. Слишком много цветов
Слишком пестрая визуализация перегружает восприятие и утомляет глаза. Используйте 2-3 основных цвета.

❌ 3. Ось, начинающаяся не с нуля
Это довольно популярный метод манипуляции данными (об этом стоит рассказать отдельно). Оси начинаются только с нуля

❌ 4. Использование круговых диаграмм для сравнения
Глаз плохо различает углы, поэтому сравнивать доли лучше с помощью столбцов - гистограммы.

❌ 5. Отсутствие подписей и шкал (легенды)
График без подписей – как карта без названий улиц. Добавьте единицы измерения и объясняйте значения.

❌ 6. Перегруженные графики
Классика жанра. Старайтесь акцентироваться на ключевых эл-тах. Нет, линии тренда нужны не везде )
  • ❤ 2
Post #237 453
#Excel #VBA #onerror

Код VBA может "падать" из-за ошибок: деление на ноль, отсутствие файла, выход за границы массива и т. д. Если не обработать их, макрос прервётся. В лучшем случае исполнение кода будет прервано, а в худшем Excel может вылететь с критической ошибкой.
Для того, чтобы этого не происходило, для расчетых скриптов лучше всего добавлять блоки обработки ошибок.

🔹 Базовый способ обработки - использование On Error
On Error Resume Next — инструкция VBA, которая игнорирует ошибки и позволяет коду выполняться дальше, даже если произошёл сбой.
On Error GoTo 0 — отключает игнорирование ошибок и возвращает стандартное поведение, когда код останавливается при ошибке.

🔹Пример:
On Error Resume Next  
a = 10 / 0 ' Ошибка, но код не остановится
On Error GoTo 0 ' Возвращаем стандартное поведение


В этом коде появляется ошибка, но применение On Error Resume Next позволяет ее пропустить и исполнять код дальше

Документация on error
  • 👍 5
Post #236 463
#прочее

Исследование рынка труда HR-аналитиков за 2024 год. Рекомендую ознакомиться, если тема работы в роли HR-аналитика актуальна.

Из интересного:
1. перечень технических компетенций HR-аналитиков на основе парсинга вакансий. Тут 100% попаданий на мой взгляд, полностью бьется с исследованием ирландец, о котором я писал и моими собственными наблюдениями;

2. основные работодатели для HR-аналитиков. Тут спорно, на мой взгляд такой концентрации вакансий просто нет;

3. средние сроки закрытия вакансий HR-аналитиков. Здесь комментариев нет, просто любопытно было посмотреть.
  • 👍 3
  • ❤ 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →