TGViewer
Channel Public Channel
Сказки технического менеджера

Сказки технического менеджера

@tech_managers_tales

Пишу про свои наблюдения из области технического менеджмента и разработки ИТ-продуктов.


Автор @fearisachoice
Технический менеджер в Яндексе
Subscribers
446
Photos
12
Videos
1
Links
47
Recent Posts 17 shown
Post #114 302
Готовлюсь сейчас к выступлению на Yandex Scale с провокационной темой доклада - "Мониторинг ИИ‑агентов: как мы делали это первыми в РФ". И вот снова, прогоняя выступление и правя презентацию, захотел поделиться с вами парой наблюдений на тему докладов и вокруг них. Я это, кстати, уже делал когда-то, захотелось снова.

1. Вступление - это ключевая часть всего выступления
Потому что оно влияет на весь остальной ход доклада. В эту минуту слушатель принимает решение: оставаться и слушать или нет. Если вступление скучное и не цепляет — часть людей отключится, а кто оффлайн, тот просто уйдёт на соседний доклад. Досадно, неприятно, но даже глубокий по содержанию доклад сильно теряет, если его вступление не оч. В моем понимании основная задача вступления - разжечь интерес слушателя к теме и выступлению. И в классном выступлении эту миссию нельзя провалить, поэтому обычно я много времени трачу на продумывание вступления - не всегда получается хорошо, но я пытаюсь.

2. Постепенное раскрытие слайдов с пунктами интереснее, чем показать сразу все
Я тут говорю про слайды, в которых есть N пунктов, которые спикер рассказывает один за другим. Частая ошибка спикеров (по моему авторитетному мнению, конечно) — вывести на слайд сразу все буллеты, которые они собираются проговорить. Почему это плохо?

- Первое: слушатель видит один и тот же слайд, пока спикер пару минут идет от пункта к пункту. Картинка не меняется — внимание утекает, даже если ты говоришь хорошо.
- Второе — хуже. Список целиком == спойлер дальнейшей речи. Слушатель за десять секунд читает все пункты и уже знает, о чём ты будешь говорить. Все карты раскрыты сразу, дальше слушать уже не так интересно.

Поэтому в своих докладах я раскладываю пункты на отдельные слайды в соответствии с тем как будут говорить о них. Говорю про п.1, будет слайд с ним, перехожу к п.2, будет слайд уже с двумя пунктами и т.д.

3. Доклад на конференцию - это добровольное страдание
Не знаю, у кого как, но когда я готовлюсь к выступлению, я воспринимаю это как вторую работу. Днём — основная работа: проекты, созвоны, дела. Выделить рабочее время на подготовку почти невозможно — разве что за счёт того, чтобы делать меньше в рабочих проектах, но это так себе обмен. Поэтому остаются вечера и кусочки ночей. И выходные. Из этого времени, когда ты уже не супер ресурсный, надо «выжать» из себя весь материал, причесать, проговорить, свести в презентацию и т.д. И это реально выматывает.

Хотя когда потом оглядываешься на положительные последствия этих выступления (о них может расскажу как-нибудь отдельно), кажется, что оно того все таки стоит.
  • 🔥 8
  • ❤ 2
Post #112 254
Про личный опыт с Hermes

Когда я прогуливаюсь вечерами и не только, у меня частенько возникают разной степени гениальности бизнес- и продуктовые идеи. Какие-то из них касаются личных проектов, какие-то рабочих. Некоторые из них обречены умереть через минуту, а некоторые хочется как-то поразгонять, прям сейчас обсудить с кем-нибудь пока горяченькие. Для этой цели я давно присматривался к голосовым GPT alike ассистентам, с которым можно обсуждать такое на ходу.

Первый заход был в обычные чаты типа ChatGPT, Perplexity. Но во время прогулки неудобно идти с телефоном в руках, каждый раз печатать и читать. Да и не хотелось прилипать к экрану еще и во время променада.

Второй заход был в OpenClaw. Кто не знает, OpenClaw это хайповый open source автономный AI-агент, с которым можно работать через мессенджеры. Пробовал настроить его под свою задачу, но оказалось, что настройка сама по себе не супер простая: без серьёзного углубления я не мог получить хороший результат в роли голосового ассистента (и не только голосового). Как ни крутил - норм не выходило, а вкладывать много времени в это я не был готов.

А потом я попробовал Hermes — и получил нужный мне результат за заметно меньшее время. Наконец-то получилось без страданий собрать голосового агента с нужными скиллами, который еще и подстраивается под меня по ходу нашего взаимодействия.

По умолчанию, как и у любого агента, ответы у него довольно общие, но он умеет докручивать на ходу свои настройки и скиллы - навыки под конкретную задачу. Я попросил его найти и установить признанные в community скиллы по продуктовому анализу, анализу рынка, поиску в интернете и т.д. и в общении стало намного меньше воды. Из базового нейрослопа появилось то, что действительно можно использовать.

Пару примеров, которые сработали лично у меня:
- Помог прибить слабую идею. У меня возникла ✨новая идея бизнеса✨. Рассказал свою идею, ответил на уточняющие вопросы и попросил посмотреть на аналогичные решения на рынке РФ. Hermes пыхтел и показал мне, что рынок в РФ свободен для моей идеи. Но не потому, что я придумал что-то инновационное, а потому что такое нафиг никому не нужно, компании уже закрывают такую задачу немного другими продуктами, про которые я в моменте не подумал.
- Подкинул релиз конкурента, который я пропустил. Пока думал над одной новой фичей для своего рабочего продукта, попросил поискать существующие примеры в СНГ. Делал это скорее на всякий случай т.к. был уверен, что такого еще никто не делал. Каково же было мое удивление, когда среди прочего он прислал мне пресс-релиз конкурирующего продукта, который очень точно попадал в мою идею и этот релиз у них вышел буквально в августе этого года.

И это все буквально в рамках одной прогулки, в общении голосовыми сообщениями.

Понятное дело, что Hermes это не сереберянная пуля - это AI-обвязка со всеми его ограничениями и недостатками всей этой схемы. НО мою задачу быстрого собеседника он решает на достаточном уровне и это оказалось выше моих базовых ожиданий. Поэтому делюсь с вами, вдруг тоже сгодится для чего-нибудь:)

Скачать его можно с GitHub - https://github.com/nousresearch/hermes-agent. Как и любого агента его нужно будет где-то развернуть, настроить интеграции с LLM, tg и т.д.
  • 🔥 8
  • ❤ 1
Post #111 314
Про еще один важный запуск

Ой, совсем забыл поделиться, что с месяц назад был важный для меня запуск - в Yandex AI Studio появились трейсы AI-агентов.

Yandex AI Studio - это платформа для разработки с AI для бизнеса, ей пользуются тысячи компаний в РФ, и мы встроили трейсинг агентов от Monium в эту платформу. Почему агент ответил так или иначе? А точно ли правильные тулы с правильными параметрами он вызвал? Теперь клиенты могут не гадать т.к. прямо в UI видно весь путь агента: системные промпты, вызовы модели, инструменты, промежуточные шаги и то, как он пришёл к финальному ответу. Без изменений в коде и прямо в платформе.

⚠️Но я задумывал этот канал не как площадку для PR'а фичей от Яндекса, поэтому хочу поделиться немного личной рефлексией по этому запуску.

1. Хорошему запуску нужен режиссер
Публичный запуск большой фичи - это режиссура разных занятых команд - разработки своей, разработки смежников, маркетинга, технических писателей и т.д. И если ты хочешь, чтобы запуск получился классным, ничего важного не просыпалось и в прод не поехали "некритичные" баги, то за всем этим оркестром нужно присматривать как режиссер.
Поскольку это был запуск не в "моем" продукте, то некоторое время я ощущал себя неловко, указывая коллегам куда обратить больше внимания - это быстро закончилось, когда аналогия с режиссером дошла до меня в полной мере (и когда сроки стали поджимать). Дальше я уже лез режиссировать туда, куда меня и не звали, и с этим связан второй момент.

2. Если хочешь результата, придется немного задолбать людей
«Руководить - это значит не мешать хорошим людям работать» говорил Пётр Капица. Мне нравится эта цитата и нравится не мешать людям работать, но, блин, сколько же раз я оказывался в жопе из-за этого подхода. Ты хочешь не мешать людям работать, а они забывают что-то важное; ты лишний раз хочешь не капать на мозг, а в обещанный срок ничего нет; ну вы поняли.
В этом запуске, конечно, было далеко не так, но в какой-то момент я отбросил естественное желание для меня "не мешать" и стал более настойчиво требовать нужных результатов. Да, кто-то почувствует себя задолбанным; да, кому-то придется корректировать свои планы - но если это двигает нас к нужному результату, то таков наш путь.
  • ❤ 6
  • 👍 1
Post #109 343
Саммари доклада с Infraconf 2026. Часть 2 про практику

Продолжаю саммари доклада — теперь про практические шаги. Вот у вас появились агенты в продакшене. А что именно можно сделать прямо уже хоть завтра, чтобы начать их мониторить?

В докладе я предлагал смотреть на подход к этой теме как на некую пирамиду зрелости - начинаем с простого и движемся к комплексному. Итак, снизу вверх:

1. Экологически чистые материалы (aka говно и палки)

Если у вас уже есть какие-то AI-агенты, мой первый совет банален до неприличия: разберитесь, куда они вообще пишут логи, если пишут. А если не пишут — пусть начинают, включите их в SDK этих агентов.
Да, логи могут быть слишком verbose. Да, они могут быть кривые, косые, улетать в stdout или в какой-нибудь файлик, НО лучше хоть какие-то логи, чем вообще никакие. Потому что в момент сбоя такие логи хотя бы дают шанс понять, что вообще пошло не так. А если даже таких логов нет, то на что надеяться?

Плюсы: легко реализовать, появляется хоть какая-то телеметрия
Минусы: очень тяжело дебажать, не получите алерты и метрики

2. Автоинструментация через OpenTelemetry + привычные инструменты мониторинга

Следующий уровень - подключить ваших агентов к привычным инструментам вроде Grafana или Jaeger и включить автоинструментацию OpenTelemetry, чтобы агент начал сам отдавать базовые сигналы из коробки. Автоинструментация - это когда вы подключаете SDK, например, от OpenTelemetry и включаете автоматический сбор телеметрии. Дальше SDK само под капотом собирает метрики, логи и трейсы без изменений в коде. На то оно и АВТОинструментация.

Из практики тут есть важный нюанс: в свежих OTel-инструментациях трекинг больших текстов (промтов, ответов модели т.д.) отключен по умолчанию, и если его не включить руками, то самые ценные данные для дебага вы просто не увидите. За это поведение отвечает переменная среды OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT

Плюсы: используете знакомые инструменты мониторинга, появляются все базовые сигналы (метрики, логи и трейсы)
Минусы: привычные инструменты не адаптированы под AI-контекст - тяжело дебажить, автоматическая инструментация не покроет бизнес-логику.

3. Специализированные инструменты
Следующий уровень - использовать специальные штуки для мониторинга AI-агентов. В докладе я приводил в пример Langfuse: это open source-платформа, в которой есть трейсы, evals, версионирование промптов и прочие полезные штуки для agentic-сценариев. Облачная версия нам сейчас недоступна, но self-hosted вариант у них вполне живой и отлично работает. Подключаете SDK к своему агенту, поднимаете Langfuse на своей инфре - и вот у вас отличный инструмент для базового мониторинга агентов.

Плюсы: open source, специализированный продуманный инструмент
Минусы: vendor-lock на SDK и формат Langfuse.

Итак, вершина пирамиды.

4. Monium от Яндекса
Да, это тот самый продукт, менеджером которого я являюсь. И, да, в утверждении про вершину пирамиды есть доля иронии:)

Но если говорить серьзно, то в Monium сейчас два главный плюса для задачи мониторинга агентов:
- отсутсвие vendor-lock, полностью OpenTelemetry-native формат. Это значит, что нет зависимости от вендора, как в случае в Langfuse - данные текут стандартном формате, а значит на решение легко заехать, и также легко съехать, если не зашло.
- хорошая адаптация UI для просмотра трейсов с большими текстами (промпты, ответы модели). Можно ломать глаза, рассматривая json-ы в спанах, а можно в адаптированном UI сразу смотреть на историю сообщений, входные и выходные параметры тулов и детали в более человеческом виде.

Больше я о нем не говорил в докладе, и тут тоже не оч хочу. Кому интересно, вот тут можно посмотреть лендос.

Штош, вот такое саммари доклада.
  • 👍 7
Post #108 301
Саммари доклада с Infraconf 2026

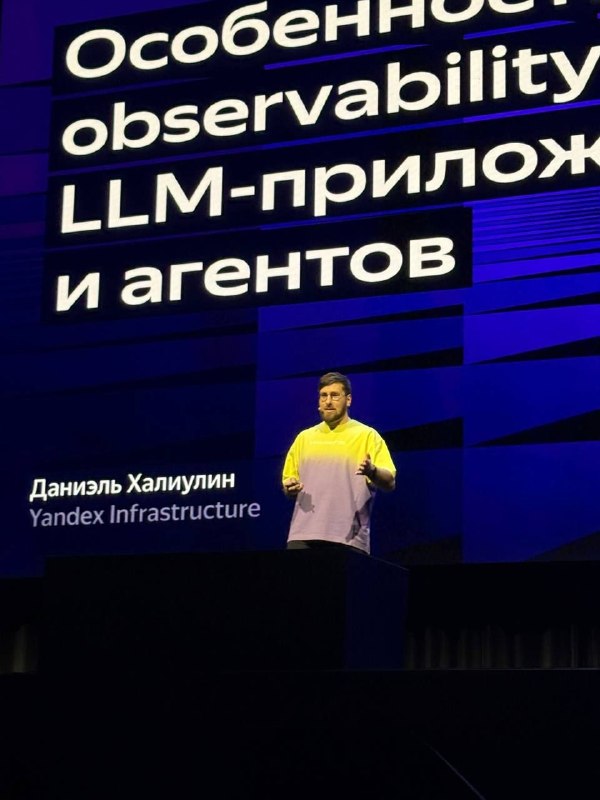
Как обещал, публикую краткое содержание своего доклада "Особенности observability LLM-приложений и агентов" с конференции Infraconf 2026.

Для начала я провел черту - что вообще мы называем AI-агентом? Этот термин сейчас сильно перегружен. Лично для себя я определяю это так: true agent - это приложение, в котором LLM отдана главная управляющая роль. В агенте именно модель решает: что делать дальше, как это делать и когда пора закончить.

Отсюда легко вывести то, что агентом не является:
• One-prompt приложения. Если LLM дергается для утилитарной задачи вроде суммаризации текста или определения интента — это просто интеграция, а не агент.
• Жёсткие workflow. Когда разработчик заранее продумал и захардкодил весь граф выполнения процесса — это, возможно, самая стабильная автоматизация на рынке, но в строгом смысле тоже не агент.

Полноценному агенту помимо "мозга" (самой модели) нужны "руки" (tools вроде сторонних API или CLI), релевантные данные (типа RAG) и оркестратор, который управляет контекстом. И как только мы начинаем строить и мониторить такие системы (а как без мониторинга в продакеше то?), классические подходы к мониторингу получают неожиданные особенности.

1. Большие тексты стали главным источником правды
В классических приложениях поведение объясняется кодом: открыл метод и шаг за шагом читаешь логику. В агентах код не детерминирован, им управляет модель на основе данных в контексте. Системные промпты, история диалога, сырые ответы tools - это большие тексты, которые влияют на его работу сильнее всего. И если ты не видишь их, то восстановить логику и понять, почему агент свернул не туда, невозможно.

2. Трейсы вместо логов
На первых порах кажется, что тут нужно знаписать все в логи и будет норм. Но если дампить туда все промпты и ответы модели, логи превращаются в нечитаемое месиво из JSON-ов, размазанное по разным бэкендам. Трейсы сейчас де-факто стали основным сигналом для дебага агентов: они круто визуализируются, держат весь контекст в атрибутах спанов и не теряют смысл при распределенной архитектуре.

3. Метрики стали сложнее
Базовые вещи вроде Time to First Token, tokens per second или количества ошибок никуда не делись. Но проблема в том, что агент ломается тихо и уверенно: по инфраструктурным метрикам все может быть идеально зеленым, а агент будет без тени сомнения генерировать полнейшую дичь. Ошибки стали семантическими. Ну и еще нюанс: метрики обязательно нужно дробить по типам задач (корзинкам), иначе "среднее по больнице" просто потеряет смысл - для одних задач агент делает 5 шагов, а я для других 25. Смешивать метрики таких задач нельзя.

4. Evals для оценки качества
Пожелаем удачи тем, что пишет детерминированные тесты для недетерминированной логики. Чтобы понимать, насколько адекватные решения принимает агент, нужны evaluations (evals). По сути, это автоматизированная оценка контента и качества работы по заранее заготовленным датасетам. Тут же в полный рост встает подход LLM-as-a-judge, когда логику и ответы одного агента проверяет другая модель по специальным промптам.

В следующей посте напишу про практические рекомендации, которые я предлагал в докладе
  • 👍 8
Post #107 296
Post #106 335
Про дизайн и UX

Когда я в следующий раз буду переживать за UX своих фичей, оценивать их лакончичность и понятность для пользователей, я буду вспоминать белого леопарда, которого ВТБ добавил прямо на главный экран своего приложения.

Анимированный белый гепард или леопард лежит на плашке платежей и помахивает хвостом.

Какую продуктовую задачу он решает? Какую джобу закрывает? Верю, что какую-то очень важную)
  • 🤔 3
  • 👍 2
Post #102 411
Про Infraconf 2026

Вот и прошла конфа infra.conf'26 от Яндекс Инфраструктуры, о которой я писал ранее. И прошла, надо сказать, очень круто!

Во-первых, у меня был доклад на тему "Особенности observability LLM-приложений и агентов". В этом докладе я раскрыл проблематику мониторинга AI-агентов, накинул ряд особенностей, которые важно учитывать. А в конце дал набор рекомендаций по использованию инструментов для этой задачи. Еще хотелось рассказать про хитрости разных стандартов и как большие западные игроки с помощью открытых стандартов защищают свой бизнес и не только про это - но все это пришлось выкинуть, чтобы уложиться в тайминг:)
Получил, кстати, много положительного фидбека по докладу - мне это очень приятно!

Во-вторых, на этой конфе был стенд нашего продукта Мониум. Любой желающий мог подойти, потыкать систему и задать любые вопросы команде. А еще мы придумали Root Cause Challenge - набор заданий по теме наблюдаемости, которые нужно решить в нашей системе (за призы, конечно). Для меня эта движуха была особенно волнительной т.к. мы устраиваем такую игру в первый раз - нужно было придумать и обкатать задания, подготовить для них данные, убедиться, что все безопасно и еще огромное кол-во важных мелочей. Но все прошло отлично, народу было много, было интересно, будем еще качать эту механику для других мероприятий.
К слову, из-за своего выступления, я был на стенде набегами - мне было важно сохранить голос и энергию для доклада.

В-третьих, удалось познакомился с несколькими очень интересными людьми. С кем-то мы уже пересекались в чатах, а теперь "развиртуализировались". С кем-то впервые встретился на конфе и очень содержательно и приятно пообщался. Вообще, общение - новые знакомства, разговоры с уже знакомыми людьми - это одна из самых ценных штук для меня на конфах.

А, ну и еще прикольно было, что в какой-то мере это было командо образующее мероприятие. Готовиться и работать на стенде вместе, решать всякие текущие проблемки, поддерживать друг друга под давлением - это то, что сплачивает команду.

Крч, хорошая конференция получилась!
  • 🔥 18
  • 👍 5
  • 💯 2
Post #101 408
Кто не успел, тот опоздал

Чтобы упростить сбор и отправку трейсов из вашей системы в систему трассировки существует подход автоматической инструментации. Это когда ты подключаешь библиотеку, инициируешь ее, и дальше она сама при запуске выполняет все необходимые настройки, сама в нужных местах внедряется в ваш код так, как это нужно по всем правилам для сбора и отправки телеметрии. Все такие самые распространенные библиотеки принадлежат некоммерческой команде OpenTelemetry - они делают и популяризируют в мире одноименный стандарт телеметрии, который стал уже стандартом де факто в этой теме.

Так вот, fun-fact.

🙈 Вот такая библиотека opentelemetry-instrumentation-openai для автоинструментации одного из самых популярных в мире SDK для работы с AI на Python, имея в своем названии слово "opentelemetry", на самом деле НЕ ПРИНАДЛЕЖИТ организации OpenTelemetry. Более того, ее обслуживает и развивает КОММЕРЧЕСКАЯ компания Traceloop, которая делает и продает собственную систему мониторинга - обратите внимание на раздел Project details на странице библиотеки.

Огромное кол-во разработчиков в мире, подключая эту библиотеку, думают, что подключают что-то от OpenTelemetry, а на самом деле внедряют к себе код коммерческой компании, у которой конечно-же альтруистические мотивы. Я чуть иронизирую, но к чести Traceloop надо отметить, что обслуживают они эту библиотеку отлично.

А почему так вообще получилось?

А все очень просто. Когда началась движуха вокруг тему мониторинга AI-агентов, OpenTelemetry ее немного прощелкали, поэтому красивое имя opentelemetry-instrumentation-openai заняли ребята из Traceloop. Позже OpenTelemetry зарегистрируют уже свою официальную либу с префиксом V2 - opentelemetry-instrumentation-openai-v2

Штош, вот так бывает.
  • 👍 3
  • 🔥 2
Post #100 578
Про наблюдаемость AI-агентов и infra.conf 2026

Итак, у вас в компании появились AI-агенты. В один прекрасный летний вечер вам звонит руководитель и говорит, что в продакшене взбесился один важный агент и делает не пойми что. Ваши действия?

Не, серьезно, как вы будете дебажить работу этого AI-агента?

- Ок, наверно посмотрите на его логи. А в логах треш и угар: все промпты, ответы модели, вызовы и ответы тулов в километровых json-ах. Причем часть логов от тулов вообще лежит в другой системе мониторинга (их же делала другая команда). Удачи разобраться.

- Хотя почему сразу логи? Кто-то сначала пойдет смотреть метрики. И даже увидит там немало интересных данных - расход токенов, кол-во ошибок, тайминги. Вот только метрики оказались очень шумные, показатели сильно прыгают. Оно и понятно, ведь для одних задач агенту нужно сделать 5 шагов, а для других 25 - а метрики замеряются одни и те же. Да и конкретный кейс дебажить по агрегированным метрикам не получится.

- Ладно, у вас же есть трейсы (есть же?). И вот по трейсам что-то начинает проясняться. Вы видите, что было в контексте у агента, что ему ответили тулы, и вам даже не надо парсить глазами полотно json'ов. По трейсам вы видите, что один из тулов ответил ошибкой, а системный промпт вашего агента не подразумевал, что данных от этого тула может не быть, они слишком нужные. Вот все и поехало. Дело раскрыто.

На самом деле тема наблюдаемости и мониторинга AI-агентов намного шире и сложнее этого кейса. И ее роль растет с ростом внедрения AI в компаниях. И в последний год я неплохо закопался в нее, а 4 июня и вовсе буду рассказывать доклад на тему "Особенности observability LLM-приложений и агентов" на infra.conf'26. На большой инфраструктурной конференции от Яндекса. Участие бесплатное, но надо зарегистрироваться.

Приходите или подключайтесь послушать (не только меня, конечно)!

P.S. Для канала сделаю пару постов с саммари и полезной выжимкой.
  • 🔥 10
  • ❤ 3
  • 👍 3
Post #99 442
Про лицемерие и манипуляцию в менеджменте

По ходу своей менеджерской работы я давно заметил, что в общении с каждым человеком нужен свой уникальный "ключик", особые слова или поведение, которое позволяет выстроить эффективную коммуникацию именно с этим человеком. Для кого-то это будет общение только по делу, четкие инструкции и постановка задачи. Другому ни в коем случае нельзя говорить ЧТО делать, а достаточно принести проблему и поддержать в том, что человек в силах сам найти лучшее решение. Третьим важно поговорить о чем-то более личном - как родила кошка или как здоровье у его пожилых родителей.

И это нормально, ведь все люди разные, у всех разный бекграунд, грейд, опыт и т.д. И да, это отдельное мастерство менеджера - находить разные подходы к разным людям, будь то подчиненные, коллеги, менеджмент выше или клиенты.

Но во всем этом меня всегда смущал один момент. Все эти движения выглядят как некая форма манипуляции и лицемерия. Мое внутреннее состояние порой может НЕ соответствовать тому, что я демонстрирую снаружи. Я изучаю человека и ищу "кнопки", на которые нужно нажимать, чтобы добиться результата. Нужно сказать правильные слова и зацепить правильные струны его личности ради своих целей? Сделаем. Нужно особым образом расставить акценты в обсуждаемой задаче, чтобы человек почувствовал мотивацию ее сделать? Нет проблем.

Насколько это этично? Не обманываю ли я людей тем, что подталкиваю делать то, что нужно мне? Где граница между манипуляцией и здоровой способностью договориться? - эти вопросы действительно крутились в голове в такие моменты.

Ключом к решению этого противоречия для меня стало понимание двух критериев, по которым можно провести границу "плохой" и "хорошей" манипуляции:
1. Ведет ли целевое действие к пользе человека, с которым я говорю?
Если я побуждаю человека к тому, от чего ему самому будет польза - это хорошо. Например, я подталкиваю его выполнить свои прямые рабочие обязанности или проработать глубже задачу, от которой зависит его премия. С другой стороны, надо задуматься, если я пушу его в сторону того, что не принесет ему пользы. Например, раскрыть мне какую-то секретную информацию или отвечать в чате в течение 15 минут)

2. Не скрываю ли от человека какие-то плохие последствия или детали целевого действия?
Если я говорю открыто о сайд-эффектах и рисках того, к чему призываю - это норм. Например, открыто говорю дизайнеру, что фича еще на раннем этапе анализа и есть большой риск, что в итоге его дизайн не попадет в работу. Если же чувствую, что надо скрыть часть информации, чтобы было принято нужное мне решение - это маркер, что происходит что-то странное. Например, если я побуждаю разработчика скорее взять в работу задачу, которую вообще никак не обсуждал с его тимлидом, или когда я договариваюсь со смежниками о доступе к API, на основании которого сделаю фичу-конкурента для них.

Ключ оказался простой: польза и прозрачность для другого человека. Если это есть, значит, все гуд, манипуляция уже не прям манипуляция, а договор и убеждение. А вот если этого нет, это сигнал. Правда, некоторые сигналы иногда можно и игнорировать... Но об этом как-нибудь в другой раз😈
  • 👍 9
  • 🤔 3
  • ❤ 2
  • 🔥 2
Post #98 466
Про первый месяц после запуска

Предыдущий мой пост был почти месяц назад - там я поделился новостью о публичном запуске продукта, над которым работаю. Такая пауза непосредственно связана с темой того поста - меня и команду буквально накрыло активностями по продвижению продукта на рынке: вебинары, конфренции, исследования, продажи и т.д. Несмотря на то, что мы запустились под брендом большой компании и у нас есть некоторые возможности от ее огромной PR-машины, все это не отменяет старой доброй присказки про маркетинг - какой-бы не был прекрасным ваш продукт, без продвижения, никто о нем не узнает и не начнет им пользоваться.

Поскольку мы только разгоняемся, у нас есть место для экспериментов по многим фронтам - например, в форматах демо, которые мы проводим для клиентов. Или в вариантах креативов - подкасты или статьи на Хабр, короткие видео или большие вебинары. Во многих таких активностях я наблюдаю кое-что общее - мы делаем то, что на текущем этапе плохо масштабируется в будущем. Например, мы проводим демо показы, используя одних из самых дорогих людей команды (с т.з. оплаты труда). Или мы в ручном режиме связываемся с некоторыми первыми клиентами, чтобы проактивно предложить бесплатно свою поддержку на первых порах.

Для кого-то это может выглядеть контринтуитивно, но на самом деле это обязательный шаг. Чтобы в будущем масштабировать поддержку или продажи, супер важно на первых порах много и глубоко вручную поработать с первыми клиентами. Понять их задачи, барьеры, возражения, сложности и все такое. Нет, конечно, мы не первый день в этом бизнесе, у нас есть понимание задач и решений для клиентов, но весь прикол в том, что наше понимание должно пройти проверку рынком. До тех пор есть большой риск, что наше понимание не соответствует реальности рынка. И первый шаг на этом пути - это вручную поработать с первыми клиентами, отработать первые инсайты, пересобраться под новые открытия.

К слову, все это не новая мысль. В 2013 году Пол Грэм, основатель Y Combinator, бахнул эссе "Do Things that Don't Scale" - https://www.paulgraham.com/ds.html, в котором ровно об этом и говорит, призывая основателей стартапов на первых порах не думать о масштабировании, а вкладываться в поиск и достижение успеха первых клиентов, с помощью своего продукта.
  • 🔥 11
  • 👍 3
  • ❤ 1
  • 💯 1
Post #97 638
Выходим из тени: запуск продукта, над которым я работаю

Сегодня состоялось долгожданное событие, на которое мы с командой работали последние месяцы - публичный запуск платформы мониторинга Мониум в Яндекс Облаке. В этом продукте я являюсь одним из технических менеджеров и отвечаю в основном за направление Трейсов и мониторинга AI-агентов. О запуске уже написал Форбс, Ведомости и еще куча разных СМИ и тг-каналов. Сам продукт - платформа, в которой есть все, что нужно для быстрого обнаружения сбоев в ИТ-системах, их глубокого анализа и устранения - логи, метрики, трейсы, алерты, notebook-и (кто знает, тот знает) и все такое. Все прямо в Яндекс Облаке, все отказоустойчивое и выстраданное изнутри Яндекса - только пользуйся и плоти)

Для меня этот запуск примечателен такими вещами:

1. Выпускать внутренний продукт на внешний рынок особенно волнительно
Изначально платформа родилась и развивалась внутри Яндекса и только для его сотрудников, а в компаниях, как вы понимаете, обычно нет выбора - пользуйся теми системами, что уже есть. В таких условиях, как правило, у продукта мало мотивации развиваться в ногу с рынком - внутренние клиенты все равно никуда не денутся. Но в случае с Мониумом такой подход не работал - внутренние пользователи очень требовательные, они в курсе того, как работают лидеры рынка и ожидают какого-то паритета. Но они все-таки внутренние сотрудники, с ними можно договориться.

А когда выходишь на внешний рынок, то сразу попадаешь в довольно жесткую среду, которая тебя не жалеет. Колкие комменты в СМИ, сравнения с мировыми лидерами рынка у которых x100 по инвестициям, новые запросы, которых мы не слышали от сотрудников - все это стрессово, но интересно. Реальность такова и больше никакова.

2. В запуске от большой компании ОЧЕНЬ много скрытой работы
Посчитать и согласовать с финансистами тарифы так, чтобы быть в рынке и зарабатывать, согласовать все-все тонкости работы сервиса с юристами, интегрироваться со всеми ключевыми сервисами Облака (биллинг, например)- все это даже не 10% той работы, которую нужно проделать для согласованного запуска в такой большой компании. Со стороны все может казаться проще, но кто запускал что-то в больших компаниях, тот знает, как глубок этот айсберг. Получив когда-то опыт запуска продукта в соло, я больше стал ценить помогающие отделы:)

3. Внимание к мониторингу AI-агентов, который я создавал лично
Направление LLM Observability это что-то новое, причем не только для нас, но и для индустрии в целом. Хороших инструментов мало, лучших практик еще меньше. В составе платформы вышла фича мониторинга AI-агентов, которую я курировал лично с этапа идеи и развиваю до сего момента. С помощью нее можно смотреть трейсы AI-агентов в удобном интерфейсе, который адаптирован под большие тексты - промпты, системные инструкции и ответы LLM. Пока эта фича является чем-то уникальным на рынке РФ, ею интересуются потенциальные клиенты, есть повышенное внимание со стороны СМИ.
Мне это приятно и любопытно, есть ощущение, что тут можно сделать что-то полезное в масштабе всего рынка РФ. Будем работать.

Обычно стараюсь писать с практической пользой, но сегодня захотелось просто поделиться радостью)
  • 🔥 31
  • 👍 11
  • ❤ 9
Post #96 553
WHERE 1=1

SELECT customer_id, segment
FROM customers
WHERE 1=1
AND segment = "Enterprise"


А вы знаете, зачем люди вставляют в SQL запросы условие "1=1"? "Это же бессмысленное условие!?" - так думал я, пока когда-то не пришлось всерьез и надолго поработать с SQL. Оказалось, это очень удобно.

1. Упрощение кодовой генерации запросов
Когда ты делаешь SQL-запросы из кода, то дефолтная вставка "WHERE 1=1" позволяет все дополнительные условия выборки вставлять через AND. Ты просто добавляешь "AND segment = "Enterprise" и не паришься, есть ли там хотя бы одно условие. Так проще и меньше возможности набаговать.

2. Удобство изменения запроса
Когда я анализирую какие-то данные в БД (а мне это частенько приходится делать для разных продуктовых задач), то за счет "WHERE 1=1" я могу очень быстро включать/выключать какие-то условия выборки без изменения структуры запроса. Захотел убрать условие с полем - просто закомментировал всю строчку и все. Это очень ускоряет, когда ты только подбираешь подходящий запрос.
SELECT * FROM customers
WHERE 1=1
-- AND status = "active"
AND country = "RU";


А вы знали про эту штуку?
  • 💯 11
  • 👍 8
  • 🔥 6
Post #95 526
Про пару паттернов рабочего использования AI

"Неопределенность" - частый спутник работы технического менеджера. Мы встречаемся с ней значительно чаще, чем хотелось бы:
- Решит ли новая фича пользовательскую задачу? А точно будет достаточный adoption или ею будут пользоваться полтора землекопа?
- Есть проблема X и она имеет несколько решений - какое подходит лучше с учетом нашей специфики? А может есть еще один более подходящий вариант?
- Возникла возможность Z. Стоит за нее схватиться и переделать планы или двигаться по намеченному ранее пути?

Прикол подобных вопросов в том, что в них может вообще не быть правильного ответа - никакого черного и белого, правильного или неправильного, только серый градиент. Для таких вопросов я приметил пару полезных паттернов использования LLM. Они помогают мне разогнать такие вопросы, ускорить собственный анализ и в итоге принять более взвешенное решение. Захотелось поделиться ими с вами.

1. Просить LLM задать мне важные вопросы по моему запросу ПЕРЕД ТЕМ как отвечать по делу

Хочу решить задачу X. Контекст вопроса Y. Задай мне 5-7 наиболее важных вопросов, которые помогут тебе лучше понять мою ситуацию и дать лучший ответ. Не отвечай по существу вопроса пока я не попрошу явно.


У такого подхода есть одновременно две пользы. Во-первых, вопросы от LLM частенько помогают задуматься о том, чего не было изначально "на столе". Т.е. я и не думал о том, что такие вопросы могут возникнуть при размышлении над своим делом. Такие вопросы заставляют задуматься и посмотреть на дело немного под другим углом. А если они совпадают с тем, о чем я и так думал, то немного укрепиться, что вопросы действительно make sense. Кроме того, я могу углубляться в какие-то вопросы от LLM, которые показались мне важными или непонятными ("Не знаю, что ответить на этот вопрос. Давай порассуждаем вместе над вариантами"). Это приводит к тому, что мы работаем уже не в формате запрос-решение, а скорее в коллаборации или диалоге - модель обучает меня в том, что я не понимаю, а я обогащаю ее специфичным контекстом. И мы вместе нацелены на выбор лучшего решения моей задачи.

Во-вторых, ответы на такие вопросы обогащают диалог контекстом, который специфичен именно для моей ситуации. Это помогает модели сделать предложение, которое лучше всего подходит именно в моей истории.
Ну и, конечно, для таких случаев лучше использовать мощные размышляющие модели типа Gemini 3 Pro или Opus 4.5. С слабыми моделями такой подход не так эффективен.

2. Использовать голос в качестве способа ввода
Сначала я противился голосовому вводу - мне казалось, что печатание текста выпрямляет мысль и даже само формулирование вопросов уже приближает к решению (и так реально бывало!). Однако когда я наслушался более опытных в AI-деле ребят и попробовал голосовой ввод, то очень удивился тому, насколько это ускоряет взаимодействие и привносит в диалог детали, которые я бы не приметил в письме. Поэтому частенько я теперь включаю голосовой ввод на ноуте и спрашиваю модель голосом, также наговариваю и ответы на вопросы.

3. Использовать Cursor не только для кода
В Cursor очень удобно писать и отлаживать код, но оказалось, что удобно и обсуждать продуктовые вопросики. Используя паттерны выше накидываю в Cursor свою задачу, отвечаю на вопросы, задаю новые, углубляюсь в непонятные. На выходе прошу написать md-документ по моей задаче, в диалоге довожу его до нужного мне состояния. Но ценность, конечно, не в документе, а в том знании по своему вопросу, которое я приобретаю в процессе.

В такой коллабе недавно создал сложный excel-документ - сначала мы обсудили в Cursor задачу, потом он ушел с помощью каких-то либ в Python делать сам Excel-файл. Потом мы прошли N итераций ревью - я давал замечания, он делал правки, я открывал Excel и проверял. В результате получился очень неплохой и непростой Excel, это реально сэкономило мне часы работы.
  • 🔥 12
  • 👍 5
  • ❤ 1
Post #94 539
Заканчивая повествовательный перерыв от постов про технический и продуктовый менеджмент, расскажу еще 2 истории про карьерные неудачи. В предыдущей серии.

"Мы не можем тебя взять, в тебе недостаточно жесткости"
Это было в середине 2010-х годов, я работал старшим инженером в МегаФоне, отвечал за основную систему, в которой работают операторы всех контактных центров по России. В компании проходила очередная реструктуризация и в нашем направлении возник отдел т.н. "экспертов". Предполагалось, что по каждому техническому направлению будет "главный инженер", который будет лидить техническое развитие и принимать важные решения. На позиции этих экспертов был конкурс, в заявке помимо прочего должно быть видение развития направления, на которое ты подаешься. Я подал такую заявку и прошел на собеседование. Собеседование прошло отлично, я не завалил ни одного вопроса, да и в целом все было позитивно. Я был уверен в хорошем результате т.к. действительно был техническим экспертом в этом направлении.

Какого же было мое удивление и огорчение, когда я узнал, что меня НЕ берут на эту позицию. Вместо меня взяли коллегу из моей команды - к слову, он и правда был хорошим инженером. Следом за объявлением результатов, у меня была встреча с собеседующими, где они открыто дали обратную связь по моей заявке. Это был классический shit sandwich (кто понял, тот понял) - ключевой тезис был в том, что я слишком мягкий человек, у меня недостаточно жесткости, а поэтому я не смогу продавливать технические решения и подрядчиков. В работе этого эксперта действительно предполагалось много общения с подрядчиками, в которых действительно нужно было уметь выдерживать жесткую позицию. Прекинь, я проиграл.

Эта история подсветила для меня важную черту своего характера, на которую я не обращал внимания, но которая была заметна другим. С тех пор я помню об этой особенности своего поведения, замечаю его и корректирую, когда веду себя неадекватно ситуации. Кроме того это было для меня живым примером, как можно уступить в поле soft skills, и что наличие определенных софтов оказывается не данью культуре, а действительно рабочей необходимостью.

Одного лишь сильного желания недостаточно
Немногим позже этой истории я загорелся желанием стать системным/бизнес-аналитиком. Я видел в деле крутых ребят этой профессии, понимал их работу (на каком-то уровне). И мне было очень интересно.
В процессе поиска "новых путей развития", я подался на позицию системного аналитика (СА) в компанию Peter Service (ныне Nexign). Ранее какое-то время я работал плечом к плечу с СА + я уже имел какой-то опыт построения отказоустойчивых систем в МегаФоне + я программировал для себя на php и C#. Мне казалось, что это весомые аргументы в пользу моей компетентности.

Собеседование было в офисе компании и длилось чуть больше полутора часов. Для меня это было тяжеловато физически, но намного больше морально. Меня спрашивали про eTOM и TAM (это модели инфры и процессов телеком операторов), мне давали задачки по моделированию бизнес-процессов, мне давали задачки по системному дизайну - ничего из этого я не смог решить уверенно, плавал и отвечал с подсказками. На какие-то теоретические и практические вопросы я, конечно, ответил, и это внушило мне ложную надежду, что меня могут взять, а там я быстро все изучу.

Звонок рекрутера разрушил эту надежду - они ищут более сильного аналитика. Я помню как шел на обед по зимней улице и нес тяжелый ком в горле - мне так хотелось, а меня снова не взяли.

Эта история запечатлела в моей голове то, что одного лишь сильного желания чего-то получить недостаточно. Даже если есть аргументы в пользу желаемого - нужны действительно уверенные шаги в этом направлении. Возможно, именно этот урок придавал мне потом силы, что бы вечерами учиться программировать и глубже изучать "матчасть".

К слову, потом в этой компании я все таки поработал системным аналитиком, но это совсем другая история...
  • 🔥 7
  • ❤ 6
  • 👍 4
Post #93 385
"Моменты неудач не менее важны, чем моменты успеха. То, как мы поступаем и думаем в моменты, когда что-то не получается или мы провалились - во многом определяет, кто мы есть" (с) придумал это прямо, пока писал пост.

Захотелось поделиться с вами парой историй своих карьерных неудач. Вдруг опыт их прохождения подбодрит кого-то.

"Как мне посмеялись в лицо о моей мечте стать программистом, а потом предлагали бонус за работу у них"

Первая история случилась в начале 2010-x годов. Я, будучи студентом первых курсов, собеседовался в компанию Haulmont на позицию саппорт инженера поддерживать какую-то систему электронного документооборота. Стоит сказать, никакого профильного опыта у меня не было, да и теоретическая подготовка была не супер. Однако на удивление меня не выгнали с позором с собеседования, а даже позвали на второй этап. На втором этапе со мной общалась какая-то особо важная рекрутер (я до сих пор помню как ее зовут, это пригодилось, дальше расскажу как). Я понял, что она важная потому, как она уверенно себя вела и какие вопросы мне задавала. А вопросы ее были про то, как я вижу свое будущее - ведь на первом этапе собеседования, оказывается, я показал себя весьма средне. С ее слов, они могли бы меня взять "на вырост", а поэтому она хочет узнать мои мысли о будущем развитии. Тогда я мечтал когда-нибудь стать настоящим программистом, о чем и сообщил. Ее реакция меня сильно озадачила. Она в голос посмеялась, сидя в кресле передом мной. А потом серьезно посмотрела на меня и сказала, что шансов у меня нет. Мол, настоящие программисты с детства или подросткового возраста пишут код, участвуют в олимпиадах и вообще горят технологиями - а я уже не подросток, а даже программировать еще не умею. Не помню о чем мы говорили дальше, но в итоге я так и не стал там работать, вроде обещали перезвонить, а не перезвонили - в общем, не помню.

Однако история получила продолжение где-то через 5-7 лет.

Я уже давно забыл об этой истории, и работал себе разработчиком в другой компании (писал на Java). Т.к. Java и .Net имеют немало сходств, то по фану для себя изучал еще и .Net, писал на C#, даже с успехом сделал несколько тестовых заданий. В процессе поиска "новых путей развития", я пошел на собеседование в компаню Haulmont на позицию .Net разработчика. Дела давно минувших дней я не вспоминал, за это время и я стал другой, и компания. Собеседование прошло отлично, я уверенно чувствовал себя на теоретических вопросах, мы отлично пообщались с тимлидом. В общем, я получил оффер, но по совокупности факторов решил остаться в своей тогдашней компании. Через пару дней после отказа от оффера, я получил письмо от их другого рекрутера с предложением созвониться и обсудить варианты сотрудничества. И вы не поверите от кого было это письмо. Да, от того самого важного рекрутера, которая 5-7 лет назад смеялась мне в лицо и говорила, что я упустил время, чтобы стать программистом! Мы созвонились. Я не напоминал о прошлой истории, она предложила хороший для меня welcome бонус, если я соглашусь перейти к ним. Через пару часов письмо с условиями бонуса было у меня на почте, где я и сообщил ей о том, что отказываюсь от него.

Это не было моей вендеттой, я не разыграл эту карту полностью. Однако с тех пор эта история служит для меня живой иллюстрацией того, насколько недопустимо вести себя высокомерно с теми, кто ниже по квалификации или опыту. Уважение это базовый уровень отношения к человеку, даже если он еще зеленый новичок. Отношение к тем, кто в чем-то "ниже" - с тех пор для меня маркер культуры, который много говорит о человеке или команде.

Что-то получилось длинно и не совсем про неудачу. Остальные истории сделаю другим постом, там уже неудачи будут без триумфа.
  • 🔥 14
  • ❤ 9
  • 💯 6
  • 👍 2
Older posts →

About this channel

How can I read @tech_managers_tales without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Сказки технического менеджера: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Сказки технического менеджера have?
Сказки технического менеджера (@tech_managers_tales) has 446 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Сказки технического менеджера know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →