TGViewer
Channel Public Channel
Александр Рыжов - SEO IT, бизнес, сервера

Александр Рыжов - SEO IT, бизнес, сервера

@ryzhovan

Александр Рыжов

Рассказываю про SEO, Digital бизнес, IT и сервера.

🛠 Строил и развивал Inhouse SEO отдел в WildBerries.

💰 Заработал сотни миллиардов рублей с SEO для WB!

❓По вопросам пишите https://t.me/AleksandrRyzhov
Subscribers
321
Photos
10
Videos
0
Links
21
Recent Posts 20 shown
Post #31 27
🔤 Ответы на вопросы: какую PIM выбрать под SEO в e-com? 🔤

Получил интересный вопрос через форму обратной связи:

"Какую PIM систему рекомендуете для эффективного SEO в Ecom?"

Вопрос отличный — в нём спрятано частое заблуждение, которое стоит разобрать.


🔹 PIM сам по себе на SEO влияет мало
PIM — это внутренняя система управления товарными данными: атрибуты, описания, медиа, связи, версии, каналы дистрибуции. Поисковый робот её не видит. Он видит то, что фронтенд вывел в HTML.

Поэтому вопрос "какая PIM лучше для SEO" на практике превращается в другой: насколько гибко система отдаёт наружу произвольные поля и насколько грамотно фронт их рендерит.

Исключения есть. У Pimcore, например, помимо самой PIM есть собственная реализация сайта — и она SEO-френдли из коробки.


🔹 Про подходы в RWB рассказать не могу
Внутренние решения закрыты NDA. Зато могу поделиться опытом работы с открытыми системами в зарубежном e-com.


🔹 Pimcore
Мощная система, с которой я работал на зарубежных проектах.

Open core и self-hosted — разворачиваете систему у себя, товарные данные остаются в вашем контуре.
Хороший API.
Кастомные данные для объектов: любое SEO-поле для страницы заводится без костылей.
Интеграции с популярными CMS: WordPress (WooCommerce), Magento и другие.

❗️ Важно про лицензии. С версии 2025.1 Community Edition ушла с GPLv3 на Pimcore Open Core License: обязательная регистрация Product Key, а бесплатное использование в продакшене завязано на порог выручки компании. В 2026.x модель внедрена полностью. Прежде чем закладывать Pimcore в проект, считайте TCO — вот подробный разбор изменений.


Как это выглядело на практике. Делали связку "бэкенд на Pimcore + фронтенд на ReactJS": кастомные поля на беке, SSR на фронте. Закрыли всё, что нужно для SEO.

Ещё кейс: Pimcore плюс микс CMS (WordPress, Grav и другие) под генерацию небольшой сетки сайтов-магазинов. Типа PBN, но из шопов =)


🔹 Что на российском рынке
ENSI — набирает популярность. Тоже позволяет заводить любые кастомные SEO-поля, но интеграцию с фронтом придётся делать самим. Стек PHP и PostgreSQL, сейчас активно переписывают бэкенд на Go — обещает стать заметно быстрее.

Odyssey PIM — российский форк Pimcore с более простым лицензированием.


🔹 На что смотреть при выборе
Если задача звучит как "нужна PIM, и чтобы SEO не пострадало" — смотреть стоит на четыре вещи:

Произвольные поля. Можно ли завести любой атрибут на объект и отдать его наружу, не дорабатывая ядро системы.
API. Насколько удобно фронт забирает данные и держит ли это нагрузку на каталоге в сотни тысяч позиций.
Массовые операции. Как система переживает пакетное обновление больших объёмов товаров. Это ваша будущая генерация посадочных страниц.
Рендеринг на фронте. SSR или пререндер. Без него любые поля из PIM останутся для роботов невидимыми.

Первые три пункта — про PIM. Четвёртый к PIM отношения не имеет вообще, и чаще всего именно он всё и решает.

Если нужен обзор рынка целиком — есть свежее сравнение PIM-систем: Pimcore, Akeneo, Brandquad, Compo, OpenPIM, Ensi и другие, с таблицами по лицензиям и интеграциям.


🔹 Вывод
Связка "Pimcore, ENSI или Odyssey + грамотный фронт + Senior-разработчик + Claude Code" сегодня закрывает задачу без особых проблем: получаете SEO-френдли сайт с любыми товарными данными, какие нужны бизнесу.

Но держите в голове главное. PIM отвечает за качество и структуру данных. За SEO отвечает то, как эти данные оказались в HTML.


---


📝 Оставить заявку на сотрудничество или задать вопрос:
https://docs.google.com/forms/d/1wEnhkS3djoHrSRVi69KEg-b9PTiSOb3UyscQ0LFelIs/

#️⃣ #SEO #IT
  • 🔥 3
Post #30 160
🔤 Продал память дороже, чем зимой готов был отдать сервер целиком 🔤

Летом разобрал несколько своих серваков на запчасти. Конфигурация каждой — 2× AMD EPYC 7742, 1 ТБ DDR4, NVMe на 1 и 6.4 ТБ. Зимой я готов был отдать такой сервак в сборе. Летом продал с них одну только память — и выручил больше, чем просил за весь сервак полгода назад.

Теперь несколько мощных туш стоят без памяти и ждут вменяемых цен 😄

Это не удачная сделка, это рынок. Давайте по цифрам.


🔹 Серверные SSD: рост в 6,5 раза за год

По свежим данным TLC-накопитель на 30 ТБ стоил $3 460 в третьем квартале 2025 года. В июле 2026-го — $22 600. Только за один июль — плюс 5 %.

HDD той же ёмкости вырос всего в 2,5 раза, с $495 до $1 216. Разрыв между флешем и механикой достиг 18,6 раза.


🔹 Память: тянет вверх даже старая DDR4

Я писал об этом в марте, когда планка 96 ГБ DDR5 улетела с 90–100 тысяч рублей до 410 тысяч. С тех пор стало только хуже, и самое неприятное — вверх пошла DDR4, которую все давно списали в утиль.

Быстрее всего дорожают планки от 64 ГБ: их перестали выпускать в прежних объёмах, а спрос никуда не делся — старый парк серверов живёт и требует апгрейда.

Отсюда и мой кейс: память в серваке стала стоить дороже самого сервака.

Вчера прилетело сообщение на Авито (скрин выше). Человеку нужны 96 одинаковых модулей DDR4 2400 ECC по 64 ГБ — это 6 ТБ памяти и больше 2,2 млн рублей по цене объявления.

Похоже, отпуск начнётся с поездки в ЦОД: дербанить серваки на запчасти 😄


🔹 GPU: карта дороже, чем компьютер с этой картой

RTX PRO 6000 Blackwell подорожала с $13 250 в июне до $16 000 в августе — плюс 20,8 % за два месяца. Такая карта у меня в парке стоит, брал заметно дешевле.

Но абсурднее история с игровой линейкой: полный ПК HP Omen Max 45L с RTX 5090 внутри стоит $4 710, а та же карта отдельно — $4 830. Целый компьютер с процессором, памятью, диском и Windows дешевле одной своей детали. Стартовала карта по MSRP $1 999.

Механизм тот же, что с памятью: когда дефицитный компонент дорожает быстрее готового изделия, часть стоит дороже целого.


🔹 За памятью уже охотятся боты

По данным DataDome, на страницах интернет-магазинов с DDR5 боты дают 91 % трафика: около 50 000 обращений в час, 551 запрос на страницу, проверка остатков каждые 6,5 секунды. В марте ботов к людям было 6 к 1.

Я пятнадцать лет в промышленном парсинге и понимаю если за товаром гоняются с такой частотой, розничная цена на него — уже не про розницу.


🔹 Почему это происходит

Причина одна на все сегменты: бум ИИ выгреб производство. NAND уходит в дата-центры под обучение моделей, DRAM туда же, GPU тем более.

Все хотят флеш. Флеш кончился. Дальше по учебнику экономики.


🔹 Что с этим делать прямо сейчас

Не выбрасывайте старое железо. DDR4 сегодня — актив. Сервер, который год назад выглядел хламом, в разборе может стоить дороже, чем в сборе.

Не гонитесь за All-Flash. Не всё должно лежать на NVMe: горячее — на флеш, архивы и бэкапы — на HDD, он дорожает намного медленнее. Мой storage-узел так и собран: 216 ТБ HDD плюс 15 ТБ NVMe под кэш.

Фиксируйте цену аренды. Тарифы хостеров держатся на железе, закупленном по старым ценам. Как только пойдёт замена вышедших из строя компонентов, они поедут вверх. Разбирал это в марте — с тех пор стало только дороже.

Дешевле не будет. Считайте это базовым сценарием на ближайший год.

---

📝 Оставить заявку на сотрудничество или задать вопрос:
https://docs.google.com/forms/d/1wEnhkS3djoHrSRVi69KEg-b9PTiSOb3UyscQ0LFelIs/


#️⃣ #Сервера #IT
  • 🔥 7
  • ❤ 1
  • 👍 1
  • 👏 1
  • 🏆 1
Post #29 234
🔤 Автоматизация SEO в WB: что внутри и почему мы не пишем всё сами 🔤

В моём докладе "SEO в Big проектах" есть слайд, который в кулуарах вызывает вопросы: упрощённая C4-диаграмма сервиса. Разбираю схему и главное — почему часть системы SEO автоматизации пишем сами, а часть покупаем.


🔹 Внутренний контур
Микросервисы на Python. PostgreSQL — управление задачами. ClickHouse — хранилище Big Data. Распределённые агенты A-Parser через Redis как брокер. Фронтенд — Quasar Framework (VueJS).

На этом стеке живёт всё: SEO сканер по 100+ млн страниц (Screaming Frog виснет уже на 6 млн), классификация 15 млн маркерных запросов по 2к категорий, генерация посадочных (Programmatic SEO) и др.


🔹 Внешний контур
10+ интеграций с внешними источниками. Это и платные сервисы рынка — Keys.so, Ahrefs, Semrush и др., — и бесплатные панели вебмастеров поисковых систем.


🔹 Корпоративная инфраструктура
Всё развёрнуто в корпоративном Kubernetes с жёстким CI/CD, авторизация через Keycloak, плюс интеграция с корпоративными сервисами и системами.

Интеграция и даёт скорость: SEO-контур узнаёт об изменениях в каталоге, остатках и поставщиках сразу, а не ждёт ночных выгрузок из БД.

Минус внутри корпоративной инфраструктуры — согласования и долгие релизы. Плюс — прозрачность и безопасность данных. Плюс перевешивает.


🔹 Где заканчивается самопис
Частый вопрос: зачем в Enterprise-контуре покупной A-Parser, если есть свои программисты?

A-Parser у нас с 2012 года. Ядро на NodeJS/V8: из коробки многопоточность, обход капч, ротация прокси, 100+ готовых парсеров, нативный Redis, API и Headless Chrome.

Минусы реальные: капризный API на сверхнагрузках, логи 30 копий пухнут до 400 ГБ за дни, бывают краши в многопотоке.

Но вот арифметика для бизнеса. Зависший API и логи закрываются парой Python-обвязок за неделю работы одного инженера. Написать с нуля стабильное асинхронное парсинг-ядро — годы (ну или месяцы) работы отдела дорогих разработчиков. И потом бесконечно поддерживать его в войне с защитами, которые меняются по нескольку раз в неделю.

Плюс кадры: A-Parser — отраслевой стандарт, его требуют в вакансиях Яндекса и Т-Банка. Нанять инженера со стандартом дешевле, чем полгода погружать его в самопис.


🔹 А Claude Code не отменяет это правило?
Конечно, активно используем ИИ: OpenRouter, Claude Code, Cursor и другие.

И всё равно — не отменяет.

ИИ ускоряет реализацию R&D задач, написанных "на коленке", но выхлоп от поддержки ИИ продакшн парсинга гораздо ниже ожиданий. Судите сами: обход новых защит, стабильность на тысячах потоков, dead локи, лимиты дескрипторов Linux, прокси, капчи. Это сотни мелких граблей, которые вендор собрал за годы. По цене лицензии вы получаете уже вычищенный результат вместо месяцев, а то и лет своей разработки.

И второе, о чём забывают: в Enterprise разработка подчиняется требованиям ИБ. Код и коммерческие данные не уходят в произвольные внешние сервисы — чувствительное гоняем через внутренние RWB LLM, а сгенерированный ИИ код проходит то же ревью и CI/CD, что и написанный руками.

Claude Code даёт максимальный эффект там, где ему и место на схеме: обвязки, скрипты стабилизации, кастомная логика поверх готового ядра, интеграции. Не в переписывании фундамента.


🔹 Формула
Своя архитектура и интеграция с внутренними системами плюс рыночное ПО на грязной массовой работе. Сами пишем там, где данных нет ни у кого другого или где не пускает комплаенс. Остальное покупаем.


---


📝 Оставить заявку на сотрудничество или задать вопрос:
https://docs.google.com/forms/d/1wEnhkS3djoHrSRVi69KEg-b9PTiSOb3UyscQ0LFelIs/


#️⃣ #SEO #BigData #IT
  • 🔥 12
  • ❤ 2
  • 👍 2
  • 💯 1
Post #28 369
🔤 АнтиКонференция в палаточном лагере на Волге Summer Merge 🔤

Совместил мини отпуск с выступлением на IT конференции в палаточном лагере на берегу Волги ⛺️!

*️⃣Предыстория. После выступления на IT конференции "Стачка" в апреле получил приглашение повторно посетить Ульяновскую область и выступить на Summer Merge в палаточном лагере. Давно хотел расчехлить свою палатку - приглашение моментально принял.

*️⃣Summer Merge. Очень необычная организация конференции! Концерты и тусовка до 2х ночи, заплывы на Волге утром, днем игры и доклады в шатрах и конечно Networking. После таких активностей отрубился в палатке без задних ног, даже при играющей где-то рядом гитаре =)

Респект организаторам Summer Merge за такую организацию конференции и приглашение выступить! Всем ITшникам рекомендую посетить данное мероприятие!

На конференции тестировалась доставка дронами продуктов, еды, лекарств из Ульяновска прям на пляж "Русский берег"!


*️⃣Доклад. Выступал с модифицированной версией своего  доклада "SEO в Big проектах: оргструктура, профили компетенций, инструментарий". Время идёт и все меняется. Даже за полгода некоторые подходы и инструментарий могут меняться. В 2026 один из трендов SEO - Claude Code, мы не обошли его стороной.

*️⃣Приключения. Автотрип в Ульяновскую область снова удался! Хотя и не без приключений - бензином нормально получалось заправиться только на платке М12! Повезло в моей BMW конский бак и заправка в Ульяновске не понадобилась.
Уверен в будущем этот вопрос решится.

---

📝 Оставить заявку на сотрудничество или задать вопрос:
https://docs.google.com/forms/d/1wEnhkS3djoHrSRVi69KEg-b9PTiSOb3UyscQ0LFelIs/


#️⃣  #SEO #BigData #Конференция #IT #SummerMerge
  • 🔥 7
  • ❤ 2
  • 👍 2
  • 💯 1
Post #27 396
🔤 SEO — это Маркетинг или IT? Частый холивар Big проектов 🔤

После выступлений на IT и SEO-конференциях мне задавали вопрос: почему я так жестко топлю за IT-бэкграунд SEO-специалистов? Ведь исторически считается, что SEO чаще всего входит в отделы маркетинга.

Давайте разбираться.

🔹 Миф о единой корпоративной оргструктуре

Во-первых, нужно понимать, что в менеджменте организаций практически не существует абсолютно одинаковых оргструктур. Даже прямые конкуренты из одной сферы (например, в крупном e-com) выстраивают процессы совершенно по-разному, оставаясь при этом одинаково успешными.

Если глубоко посмотреть на наш рынок, вы увидите, что у одних e-com гигантов поисковое продвижение исторически сидит в Маркетинге, у других — прочно интегрировано в IT-департамент, а у третьих — вообще подчиняется напрямую Коммерции. Привязка к одному отделу — это корпоративная привычка компании, а не жесткое правило.

🔹 Всё решает масштаб и контекст проекта

Во-вторых, место SEO в компании напрямую зависит от технической сложности платформы (сайта).

Попробуйте на проекте с 10+ миллионами страниц перевести сайт на модный JS-фреймворк и "забыть" включить серверный рендеринг (SSR) для поисковых ботов. Или случайно закройте нужные страницы в файле robots.txt. Вы сразу очень четко поймете, к чему ближе SEO — к маркетинговому креативу или к суровому ИТ =)

Спойлер: настоятельно рекомендую проводить данный эксперимент исключительно в уме, а не на практике, во избежание потерь в десятки миллионов рублей.

🔹 Гибридные компетенции и доминация инженерии

SEO безусловно находится на стыке специальностей. Современные специалисты должны обладать гибридными скиллами: понимать базовый маркетинг и поведение пользователей. Но в крупных BigData-проектах IT-скиллы обязаны быть доминирующими.

🔹 Поисковик — это программный код, а не маркетолог

Поисковые системы — это сложнейшие технические системы. Они оценивают "полезность" текстов, "естественность" ссылочного графа и поведение пользователей исключительно по строгим техническим критериям (через код и алгоритмы). Поисковик не "вчитывается" в метафоры автора — он разбирает контент на фактологические триплеты для графа знаний, детально оценивает вложенный в создание контента ресурс через метрики вроде contentEffort и вытаскивает релевантные куски текста из глубины полотна с помощью алгоритмов passage indexing.

А значит, и подстраивать свой продукт под эти критерии (будь то классическое SEO, AEO или трендовое продвижение в нейросетях GEO) нужно в первую очередь именно с технической, инженерной точки зрения.

---

📝
Оставить заявку на сотрудничество или задать вопрос:
https://docs.google.com/forms/d/1wEnhkS3djoHrSRVi69KEg-b9PTiSOb3UyscQ0LFelIs/

#️⃣ #SEO #IT #Менеджмент
  • 🔥 8
  • 💯 3
  • ❤ 2
  • 👍 2
  • 🏆 2
Post #25 464
🔤 Минус 17 лет истории за один день: почему облакам плевать на ваши данные и как строить бэкапы 🔤

Прочитал сегодня пост у известного SEO-специалиста Александра Алаева (Алаича) (https://t.me/alaevseo/573) — и по спине пробежал ИТ-холодок.

История звучит как страшный сон любого владельца бизнеса: хостинг-провайдер словил критический сбой, и данные блогов alaev.info (которому 17 лет) и корпоративного сайта alaev.co были утеряны безвозвратно.

Но самый драматичный момент в другом. Саша — опытный спец, и бэкапы у него БЫЛИ. Вот только диск с бэкапами он перестал оплачивать пару недель назад, так как планировал переезд на новый хостинг. И именно в это «окно уязвимости» основной сервер умер.

Соглашусь, вероятность такого совпадения крайне мала. И по-человечески Саше очень сочувствую (надеюсь, Вебархив поможет вытянуть тексты). Но как человек, который управляет парком из почти 60 физических серверов и десятками терабайт баз данных РВБ, я смотрю на это через призму жесткой архитектуры.

Облака — это не магия. Это просто чужие компьютеры, у которых точно так же горят блоки питания, сыпятся NVMe-диски и падают гипервизоры.

Какие железобетонные уроки нужно из этого вынести?

🔹 Правило изоляции (Никаких общих корзин)
Никогда не храните рабочую платформу и ее бэкапы у одного хостинг-провайдера (и тем более в одном дата-центре). Если сгорит стойка, упадет маршрутизатор или провайдер словит бан от РКН — ваши резервные копии превратятся в тыкву вместе с основным сайтом.

✅ Идеальная связка для бизнеса: Основной проект в облаке провайдера А + Бэкап-сервер у провайдера Б. А еще надежнее — связка «Арендованный хостинг + Свой собственный физический сервер» (или наоборот). Когда железо с бэкапами стоит в вашей зоне физической досягаемости (или в вашем подконтрольном ЦОДе), вы неуязвимы к проблемам хостеров.


🔹 Правило миграции (Не жги мосты)
Никогда не отключайте старую инфраструктуру бэкапов до момента, пока новая не развернута, не протестирована тестовым восстановлением и не проработала хотя бы пару недель. Экономия в пару тысяч рублей за "лишний" месяц аренды старого диска не стоит потери 17-летнего актива.


🔹 Холодное хранение
Для проектов, где важна история (блоги, базы логов, корпоративные порталы), помимо быстрых ежедневных бэкапов, нужно иметь "холодный" архив раз в месяц.

Как я писал в прошлых постах, именно для таких задач на моем "Фронте №1" в ЦОДе стоит отдельный Storage-монстр с 216 ТБ емкости на HDD и 15 ТБ NVMe под кэш. Он физически изолирован от вычислительных узлов, где идет промышленный парсинг. И если какой-то боевой сервер "ляжет", данные останутся в полной безопасности на независимом RAID-массиве.

ИТ-инфраструктура не прощает надежды на «авось». Стройте архитектуру правильно и берегите свои данные! 💪

---

📝 Оставить заявку на сотрудничество или задать вопрос:
https://docs.google.com/forms/d/1wEnhkS3djoHrSRVi69KEg-b9PTiSOb3UyscQ0LFelIs/

#️⃣ #Сервера #BigData #Железо #IT
  • 🔥 8
  • ❤ 1
  • 👍 1
  • 🤯 1
  • 💯 1
Post #23 382
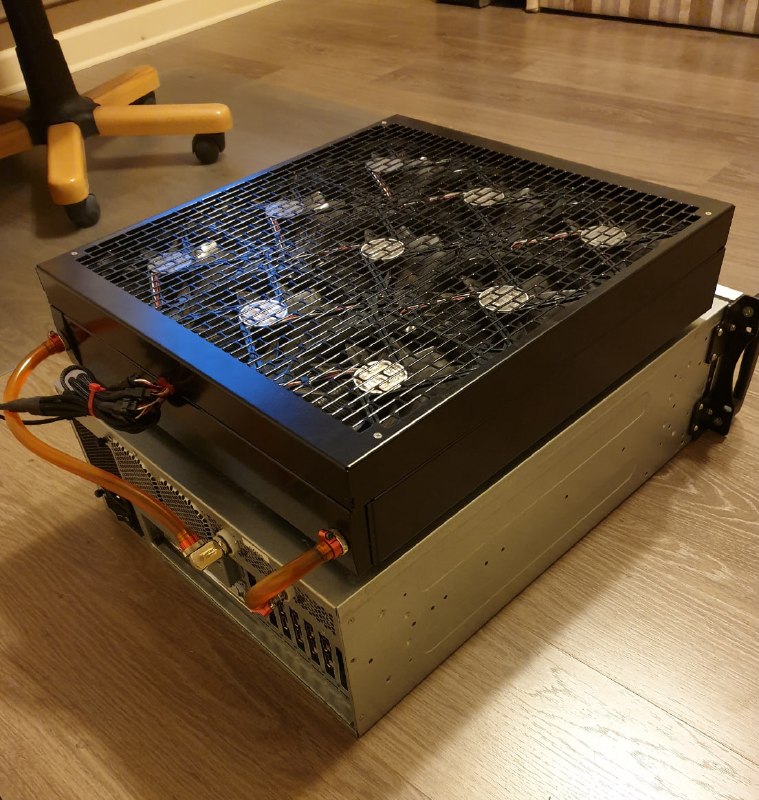
🔤 Кастомный сервер с водянкой + 4 GPU: как я собирал монстра для SEO-автоматизации и ловил приключения 🔤

Нарвался тут на свежую статью на Хабре про сборку сервера с водяным охлаждением и четырьмя видеокартами. Прочитал — и просто свело олдскулы! Не могу пройти мимо и не поделиться своим опытом сборки похожего франкенштейна, потому что это была настоящая ИТ-одиссея.

В свое время мне потребовалась машина, которая одновременно могла бы тащить тяжелую автоматизацию на BAS (браузерная автоматизация для промышленного SEO, жрущая процессор) и параллельно отрабатывать майнинг ETH за счет видеокарт.

Мой билд выглядел так:
🔹 Два серверных проца Xeon 2696 v2
🔹 Четыре топовые на тот момент видеокарты GeForce 1080 Ti
🔹 Кастомное водяное охлаждение всех узлов
🔹 Отвод тепла через мощнейший громоздкий радиатор Watercool Mo-RA3 Pro 420.

На бумаге звучало идеально, но на практике начался хардкор.

Приключение 1: Поиск комплектующих
Собрать 4 флагманские GPU в одну материнскую плату — та еще боль. Только одна конкретная модель GeForce 1080 Ti с предварительно установленными водоблоками подходила под такую плотную посадку, так как занимала ровно 1 слот PCIe. Искал их по всему рынку.

Приключение 2: Домашняя сауна
Первые полгода этот монстр (на фото) работал прямо на полу моей квартиры. Система жрала энергию как не в себя и выделяла столько тепла, что зимой я вообще не закрывал форточку в комнате, даже когда на улице было -30°C.
Летом квартира окончательно превратилась в филиал финской сауны. Жить рядом с таким реактором стало невыносимо, и я принял решение перевозить его в дата-центр.

Приключение 3: Протечка и ДЦ
За время работы дома БП один раз просто не выдержал нагрузки и эффектно сгорел (пришлось менять). А материнская плата от Asus регулярно трепала нервы: ложно срабатывал датчик открытия корпуса ПК, и система отказывалась стартовать. Ловили этот фикс очень долго.

Но самое веселое случилось при транспортировке этого тяжеловеса из одного ДЦ в другой — внутрь сервера разлился хладагент. Итог: минус материнская плата, покупал новую.

Кстати, про сами дата-центры. Когда инженеры ДЦ видели этого монстра на воде, они соглашались ставить его ТОЛЬКО в самый низ стойки. Логика железобетонная: если опять потечет, чтобы не залил чужое железо внизу. Но был нюанс: выдув горячего воздуха у моей сборки был реализован вверх (а не назад, как того требуют стандарты ДЦ). В итоге мой "сосед сверху" всегда был перегрет из-за того, что мой радиатор щедро и стабильно подогревал ему днище 😄

Итог:
Несмотря на все протечки, сгоревшие БП и замену материнки, этот сервер отработал в жирный плюс. Он пахал на SEO-задачах, майнил эфир, а когда пришло время с ним прощаться, финальная перепродажа вышла даже дороже себестоимости сборки (спасибо резко подорожавшим видеокартам).

Позже я уже собирал серверы на CPU AMD Epyc и Ryzen Threadripper с четырьмя GeForce 4090 — там процесс шел уже гладко, как по маслу. Но тот первый водяной монстр на Xeon научил меня соблюдать хардкорный ИТ-регламент.

Работа с нестандартным железом — это всегда боль, пот и залитые платы. Но профит от владения своей независимой и мощной архитектурой несравним с арендой скучных облаков.

---


📝 Оставить заявку на сотрудничество или задать вопрос:
https://docs.google.com/forms/d/1wEnhkS3djoHrSRVi69KEg-b9PTiSOb3UyscQ0LFelIs/

#️⃣ #Сервера #BigData #Железо #IT
  • 🔥 7
  • 👍 4
  • ❤ 2
  • 👏 1
Post #22 1.77K
🔤 Финальный аккорд апреля: закрытый SEO-клуб, ИИ-агенты и трансформация профессии 🔤

Мой апрельский спикерский марш-бросок официально завершен! В начале месяца мы разбирали алгоритмы WB с селлерами, затем обсуждали суровую разработку с инженерами на «Стачке». А 23-24 апреля состоялся, пожалуй, самый кулуарный и стратегический ивент этой весны — закрытый выездной Клуб Optimization.

Организаторам из «Ашманов и Партнеры» удалось сделать почти невозможное: вытащить из операционки топ Head of SEO крупнейших компаний, погрузить их в шикарную загородную локацию (отличный отель, SPA, бассейн) и заставить штурмить будущее нашей отрасли.

В этот раз я читал уже обкатанный технический доклад: «SEO в Big проектах: опыт WB». Разобрали, почему Enterprise-корпорациям критически важно уходить от внешней аналитики, как обосновывать найм SEO IT инженеров и строить закрытые In-house экосистемы на десятки млн страниц.

Круто, что этот подход находит 100% отклик у рынка. Дима Ашуров (Head of SEO ЦИАН, ex-СберМегамаркет) отлично разобрал мой доклад в топовом e-com канале (https://t.me/good_seo_ecom ). Дима точно подметил вектор: в бигтехе не осталось места классическому ручному ремеслу, бал правят SEO-автоматизаторы и Python-программисты. Подписывайтесь, там сильная концентрация экспертизы!


Компанию по выступлениям мне составили крутейшие коллеги:

🔹 Галя Бакушева (https://t.me/bakushevaseo) выступила с предельно откровенным докладом о своем пути. Вытащил отличные тезисы про найм: важно вовремя научиться отличать тех, кто «хочет работать», от тех, кто «хочет казаться» («хорошо говорит» \!= «хорошо работает»). И очень откликнулась мысль про то, что полный выход из операционки — это сказки для бедных. Алгоритмы меняются постоянно: можно делегировать исполнение, но нельзя делегировать понимание.

🔹 Саша Борминцев (https://t.me/bortalks) выдал мощную базу о переходе из SEO в управление продуктом. Главная мысль: SEO — это уже продакт-менеджмент, просто на одном канале. Саша на 100% подтвердил мой тезис, что лучшие сеошники — это люди с техническим бэкграундом. Навык говорить с разработчиками на их языке экономит недели на каждом спринте. И крутой совет: не оправдываться за цифры, а показывать разворот — как SEO-задача стала продуктовой, какие гипотезы проверяли и какие решения отмели.

Вижн 2030 и ИИ-агенты: Отдельный кайф — деловые игры. Нас разбили на команды для проектирования роли Head of SEO к 2030 году. Базовый консенсус: мы идем к управлению автономными ИИ-агентами. Ручной труд вымрет, мы сможем делегировать им всю механику. Но архитектура, стратегия и финальная ответственность за продукт останутся за человеком.

Конечно, весь этот стратегический штурм плавно перетекал в разговоры в сауне, заплывы в бассейне и атмосферные посиделки в большом коттедже под вкуснейший плов и благородные напитки. Тот самый случай, когда с коллегами по рынку обсуждаешь общие боли и находишь решения быстрее, чем на бесконечных зум-коллах.

Огромное спасибо ребятам из «Ашманов и Партнеры» за приглашение, топовую организацию и перезагрузку! Апрель выдался огненным, возвращаюсь к бэклогу платформы РВБ! 🔥

---


📝 Оставить заявку на сотрудничество или задать вопрос:
https://docs.google.com/forms/d/1wEnhkS3djoHrSRVi69KEg-b9PTiSOb3UyscQ0LFelIs/


#️⃣ #SEO #BigData #Optimization #Конференция #Нетворкинг #IT
  • ❤ 6
  • 🔥 6
  • ⚡ 2
  • 👏 1
  • 🍾 1
Post #21 450
🔤 Из автотрипа на сцену: вебинар из отеля и ИТ-хардкор на «Стачке» 🚀 🔤

Как и обещал в прошлом посте, рассказываю про вторую часть своего спикерского марш-броска. Но начать стоит с того, как этот бросок вообще состоялся.

Я решил совместить приятное с полезным и отправился в Ульяновск на машине. Настоящий автотрип с классной остановкой на ночевку в Арзамасе. Смена картинки за окном отлично прочищает голову перед выступлениями.

В итоге, свой большой закрытый вебинар для селлеров РВБ Университета (о котором писал пару дней назад) я вел уже из номера отеля в Ульяновске, за день до старта конфы. А 11 апреля я уже стоял на сцене одной из крупнейших региональных ИТ-площадок — конференции «Стачка».

Если на вебинаре мы фокусировались на факторах ранжирования и конверсионных метриках для продавцов, то здесь аудитория — разработчики, дата-инженеры и архитекторы — требовала совершенно другого уровня погружения. Мы обсуждали изнанку работы In-house SEO команд в Enterprise проектах.

Осенью я уже подробно рассказывал про наш внутренний инструментарий, парсеры и сканеры. Поэтому на «Стачке» я сместил фокус с самих алгоритмов на процессы и людей, которые заставляют эти технологии генерировать миллиарды.

Ключевые тезисы, которые мы обсуждали с залом в Ульяновске:

🔹 Эволюция профессии на объемах Big Data: Наглядно показал, почему классическое SEO окончательно умирает, когда у тебя в индексе сотни миллионов страниц. Линейные SEO специалисты превращаются в гибридов дата-инженеров и аналитиков. Без знания Python и SQL управлять такими массивами просто физически невозможно.

🔹 Отказ от внешних SaaS в пользу In-house: Почему гигантские экосистемы вроде РВБ вынуждены уходить от коммерческих сервисов аналитики в суверенную закрытую разработку. Во-первых, это вопрос комплаенса и информационной безопасности — мы храним уникальные данные о поисковом спросе и аналитике строго внутри своего контура. Во-вторых, большинство внешних SaaS-платформ просто физически не вывозят наши объемы данных, мгновенно упираясь в лимиты и падая под нагрузкой.

🔹 Алгоритмы вместо ручного труда: Как перестать собирать и чистить семантику руками. Разобрали делегирование классификации миллионов поисковых запросов скриптам, NLP-фильтрации и машинному обучению — и почему это единственный путь для масштабирования.

Главный инсайт поездки:
Выступать перед технически подкованным залом, который понимает боль отвалов прокси и лимитов API — это особый кайф. После доклада был отличный кулуарный нетворкинг на площадке. Индустрия устала от теоретического маркетинга, всем интересны реальные кейсы масштабирования, автоматизации и работы с Big Data.

Отдельный респект организаторам за неформальную часть! С дороги отлично зашло препати в аутентичном семейном баре-пивоварне «ЗЕМЛЯ» в традициях Древней Руси — отличный крафт, гусляры и атмосферный отдых для «странников бывалых». А мощное афтепати в Radisson между первым и вторым днем конфы стало идеальной площадкой для того самого кулуарного нетворкинга без галстуков. Огромная благодарность команде «Стачки» за топовый уровень организации и крутой вайб!

Автотрип удался, Ульяновск встретил тепло, а общение с коллегами зарядило новыми идеями. Возвращаюсь к рабочим задачам и развитию нашей платформы. Дальше — больше! 🔥


---

📝 Оставить заявку на сотрудничество или задать вопрос:
https://docs.google.com/forms/d/1wEnhkS3djoHrSRVi69KEg-b9PTiSOb3UyscQ0LFelIs/


#️⃣ #SEO #BigData #Конференция #IT
  • 🔥 4
  • 👍 2
  • 🏆 2
  • ⚡ 1
  • ❤ 1
Post #19 515
🔤 SEO карточек товаров на WildBerries: Попробовал себя в новом амплуа 🎙 🔤

Прошедшие дни прошли в режиме нон-стоп. Я решил выйти за рамки привычного управления In-house SEO, разработкой и выступить сразу на двух крупных площадках. Начну по порядку.

9 апреля провел большой закрытый вебинар для селлеров в рамках образовательного проекта РВБ Университет. Тема максимально горячая: «SEO карточек товаров на маркетплейсе».

В компании я с 2010 года, строил SEO отдел с нуля и непосредственно участвовал в создании внутреннего поиска WB, антифрода и базовых моделей текстового ранжирования. Поэтому мне было важно выступить не просто как теоретику, а как официальному представителю РВБ и дать селлерам информацию «из первых рук». Развеять мифы, которые годами плодят инфоцыгане.


О чем предметно говорили на вебинаре:

Векторная модель Поиска (ML). Разобрали, почему старые методы со слепым вписыванием сотен ключей больше не работают. Алгоритм оценивает единый смысловой вектор карточки (соответствие фото, текста и интента покупателя). Контент нужно делать для людей.

Реальная математика ранжирования. Показал, из чего складывается топ выдачи. Например, скорость доставки и сборки дает 30–40% веса, участие в глобальных акциях — от 15 до 35%, а конверсия из показа в заказ — до 20%.

Антифрод и пессимизация. За что алгоритмы жестко и без предупреждения режут органический трафик. Разобрали критические ошибки: цветовой спам, мимикрия под чужие бренды, перечисление навигационных путей и фиктивные скачки цен.

Встроенный ИИ-генератор и Подписка Джем Продвинутый.
Это был один из важнейших блоков вебинара, где я показал реальные преимущества использования нашей подписки Джем Продвинутый для системной SEO-оптимизации.

*️⃣Только этот раздел выдает глубокую и самую реальную статистику поисковой воронки товара и позиций карточек.
*️⃣Рассказал о преимуществах встроенного ИИ генератора описаний в ЛК продавца.

LLM-магия и Промпт-инжиниринг.
В дополнение к внутреннему алгоритму ВБ Джем, я выделил большой блок под работу с внешними нейросетями (Яндекс Алиса, GigaChat, ChatGPT).

Выдал продавцам готовые промпты для работы с сырыми выгрузками семантики. Учились автоматизировать рутину логически и математически:

*️⃣Сбор и обработка данных для заголовка КТ.
*️⃣Обработка семантического ядра.
*️⃣Генерация безопасных описаний без переспама и нейросетевых галлюцинаций.

Эксперимент с лекционным форматом мне понравился. Видеть, как у продавцов открываются глаза на внутреннюю кухню алгоритмов маркетплейса — дорогого стоит.

Но вебинар был только разминкой! Уже 11 апреля я выступал вживую в Ульяновске на мощнейшей ИТ-конференции «Стачка». Там мы говорили уже не про карточки товаров, а про жесткий технический хардкор и архитектуру In-house SEO на объемах в десятки миллионов страниц.

Подробности и ключевые тезисы со «Стачки» выложу в следующем посте.

---

📝 Оставить заявку на сотрудничество или задать вопрос:
https://docs.google.com/forms/d/1wEnhkS3djoHrSRVi69KEg-b9PTiSOb3UyscQ0LFelIs/

#️⃣ #SEO
  • 🔥 6
  • 👏 4
  • 👍 3
  • ❤ 2
  • 🏆 1
Post #18 543
🔤 Стоит ли арендовать сервера на длительный срок в 2026 с фиксацией цены? 🔤

Часто
получаю вопрос от клиентов: стоит ли сейчас оплачивать аренду выделенных серверов сразу на год вперед, или надежнее платить помесячно, сохраняя гибкость?

Мой ответ в реалиях начала 2026 года однозначный: да, если есть возможность, цену нужно фиксировать. И дело тут уже давно не в стандартной скидке в за долгосрочную оплату.

На рынке серверного железа сейчас происходит настоящая дичь. Из-за глобального бума AI-моделей (когда бизнес массово бросился обучать нейросети и разворачивать локальные LLM) дата-центры столкнулись с жесточайшим дефицитом. Как метко подметили недавно в профильной статье на Хабре, железо физически закончилось раньше, чем электричество.

Все ждали дефицита видеокарт, а узким местом внезапно стала оперативная память и Enterprise SSD диски.

🔹 Немного пугающих цифр:
Серверная планка на 96 Гб DDR5, которая еще летом 2025 года стоила около 90–100 тысяч рублей, сейчас продается у официалов за 410 тысяч рублей! На сером рынке цена плавает как биржевая котировка по три раза на дню. Аналитики из TrendForce недавно пересмотрели прогнозы и ожидают роста цен на память до 90–95% в квартал. По сути, цены удваиваются.

Вслед за RAM предсказуемо полетели вверх тарифы на надежные NVMe накопители. AI-инфраструктуре нужны колоссальные объемы быстрого кэша, и корпоративный сегмент просто выгребает этот тип памяти со складов.

Что это значит для вашего бизнеса?
Себестоимость инфраструктуры для хостеров улетела в космос. Текущие цены на аренду в крупных облаках и дата-центрах держатся исключительно на старых запасах железа. Как только хостеру придется закупать новые партии серверов или менять вышедшие из строя компоненты, тарифы для конечных пользователей неизбежно поползут вверх. Дешевле уже точно не будет — рынок сорвался с цепи.

Поэтому, если у вас есть стабильный, работающий проект (будь то промышленный парсинг, аналитика Big Data, крупный e-com или тяжелая база данных), математически самое выгодное решение сегодня — зафиксировать свои издержки.

💡 Чем я могу помочь?
Я успел собрать, протестировать и ввести в строй свой парк мощных физических серверов (включая машины с огромным объемом RAM и надежными серверными NVMe) до этого безумного ценового шока.

При заключении договора и оплате на длительный срок (от полугода или года) я жестко фиксирую для вас рублевую цену. Вы получаете выделенные мощности в надежном московском ЦОДе Tier-III и спокойный сон, без внезапных писем счастья от хостера об «очередной вынужденной индексации тарифов».

---

📝 Оставить заявку на сотрудничество или задать вопрос:
https://docs.google.com/forms/d/1wEnhkS3djoHrSRVi69KEg-b9PTiSOb3UyscQ0LFelIs/

#️⃣ #Сервера #IT #BigData
  • 👍 3
  • 🔥 2
  • ❤ 1
  • 👏 1
Post #17 544
🔤 Ответы на вопросы: Ищем альтернативу Яндекс Метрике 🔤


Получил интересный вопрос через форму обратной связи:

«Здравствуйте. Нам поставили задачу найти альтернативу сервису Яндекс.Метрики для нашего сайта [скрыто]. Решил обратиться к вам, так как у вас уже есть готовые решения. Нам нужен сервис веб-аналитики...»

Отвечаю: коробочного решения, которое я могу просто вам "отгрузить" и установить, у меня нет. То, что мы используем в Wildberries — это сугубо внутренняя enterprise-система. И история ее создания весьма показательна.

На конференции Optimization 2025 я рассказывал, как мы анализируем эффективность SEO.

🔹 Как и почему появился мощный WB Analytics?

До 2018 года у нас был стандартный подход. Как и большинство на рынке, мы использовали классику: Яндекс.Метрику и Google Analytics. Это надежные решения, которые полностью закрывали наши потребности. Зачем изобретать велосипед?

Но 2018 год стал поворотным моментом. Яндекс запустил маркетплейс «Беру» и из партнера превратился в прямого конкурента. Представьте: мы передаем детальную аналитику трафика и конверсий компании, которая теперь с нами конкурирует!

Решение было болезненным, но единственно правильным — полный отказ от Метрики и старт разработки собственной системы. Так зародился WB Analytics.

Позже мы логично отказались и от Google Analytics. Стало абсолютно ясно: данные должны принадлежать только нам. Зависимость от внешних систем создает критические риски:
• Утечка коммерческой информации
• Зависимость от алгоритмов третьих лиц
• Ограничения в кастомизации под наши потребности
• Невозможность максимально глубоко интегрировать аналитику с внутренними сервисами

🔹 Что представляет из себя аналитика WB сегодня?

Сегодня WB Analytics — это не просто замена счетчиков. Это мощнейшая система, которая хранит и обрабатывает петабайты данных. Внутренний поиск WB — наш крупнейший источник (более 1 млрд запросов с уникальными историческими данными по частотности, транзакциям и доходам).

Сразу уточню: я принимал в разработке WB Analytics скорее консультационное участие (по части архитектуры и интеграции SEO). Сам продукт годами создается большой командой крутых backend-разработчиков и дата-инженеров на стеке Go + ClickHouse. Это стоит десятки и сотни миллионов рублей❗️

🔹 Что делать бизнесу, если строить «космолет» дорого?

Нельзя сказать, что рынок массово отказывается от Метрики. Но для компаний, чьи продукты напрямую конкурируют с экосистемой Яндекса, уход в in-house аналитику — вопрос безопасности. К счастью, есть готовые Open-Source решения:

1. Matomo — один из самых мощных аналогов. По архитектуре и интерфейсу похож на классические сервисы, имеет трекинг в реальном времени и аналог Вебвизора.
2. Plausible CE — легкая система с фокусом на приватность (без сбора Cookie).
3. Open Web Analytics — решение для анализа путей пользователя и создания кастомных воронок.

🔹 Чем я могу помочь вам?

Я не продаю готовый скрипт аналитики, но могу помочь спроектировать архитектуру серверов для развертывания таких систем (с тем же ClickHouse под капотом), проконсультировать вашу in-house команду по выстраиванию SEO-процессов или предоставить мощные физические сервера, которые без тормозов переварят миллионы хитов вашей новой собственной веб-аналитики.

---

📝 Оставить заявку на сотрудничество или задать вопрос:
https://docs.google.com/forms/d/1wEnhkS3djoHrSRVi69KEg-b9PTiSOb3UyscQ0LFelIs/

#️⃣ #Аналитика #SEO #BigData #Сервера #IT
  • ❤ 4
  • ⚡ 1
  • 🔥 1
  • 👏 1
  • 🤝 1
Post #16 390
🔤 Ваш сервер скоро умрет? Скрытая угроза дешевых NVMe дисков на 1.92 ТБ у хостеров 🔤

В прошлом посте я рассказывал про внезапную смерть NVMe диска на сервере. Давайте разберем эту ситуацию технически.

Как понять, что диск в выданном сервере может быть ненадежным, если хостер в конфигураторе пишет просто красивое слово «NVMe» без указания вендора и точной модели? Секрет кроется в заявленном объеме накопителя. Именно по нему я сходу определяю класс устройства и его выносливость.

🚩 Красные флаги: диски на 1.92 ТБ, 3.84 ТБ, 7.68 ТБ

Если вы видите такие объемы, перед вами с высокой долей вероятности накопители класса Read Intensive (RI).
Они предназначены в первую очередь для операций чтения. Их ресурс обычно составляет всего 1 или даже 0.3 DWPD (количества полных перезаписей объема диска в день).

Можно ли их использовать под БД? Да, категоричного запрета нет, и многие так делают ради экономии. Но тут критически важно понимать нюансы: под интенсивной записью базы данных ячейки памяти выгорают намного быстрее. А с учетом того, что хостеры почти всегда ставят Б/У диски с неизвестным остаточным ресурсом, без железобетонно настроенных внешних бэкапов вы буквально играете в русскую рулетку.

📉 Проблема M.2 накопителей в бюджетных серверах

Еще один нюанс дешевых тарифов — использование обычных консьюмерских дисков формата M.2. При легких задачах они летают, но имеют серьезный изъян: жесткая деградация производительности при длительных нагрузках на запись.
Как только у такого диска переполняется быстрый SLC-кэш (например, при дампе большой БД или интенсивном парсинге), его скорость записи падает в разы, иногда опускаясь до уровня старых HDD. Плюс, под непрерывной нагрузкой они сильно греются и уходят в троттлинг (снижают частоты контроллера, чтобы не сгореть).

Надежное решение: серверные диски на 1.6 ТБ, 3.2 ТБ, 6.4 ТБ

Накопители с такими "обрезными" объемами относятся к классу Mixed Use (MU) или Write Intensive (WI).
Куда делось свободное место? Значительная часть чипов памяти скрыта контроллером (технология Over-Provisioning) для оперативной подмены мертвых ячеек памяти и балансировки износа.

Их ресурс легко переваривает от 3 до 5 и более DWPD. Они не просаживаются по скорости после заполнения кэша и выдерживают колоссальные нагрузки годами!

🛠 Короткая тех. справка: расчет ресурса

Чтобы наглядно оценить выживаемость диска, нужно умножить показатель DWPD на его объем. Это даст допустимый объем записи в день. Умножив это на 365 дней и на 5 лет гарантии, получаем общий ресурс.

Давайте посчитаем. Возьмем дешевый диск формата M.2 или просто базовый RI накопитель на 1.92 ТБ с показателем DWPD = 0.3. За 5 лет он официально выдержит запись около 1 050 ТБ.
А теперь берем правильный серверный диск на 1.6 ТБ (где DWPD = 3.0). За те же 5 лет он без проблем переварит более 8 760 ТБ!

При прочих равных условиях ресурс серверного накопителя под нагрузкой базы данных более чем в 8 раз выше!

Как делаю я в своих сборках?

При сборке серверов под серьезные R&D задачи и промышленный парсинг (где базы пишутся непрерывно) я использую только надежные Enterprise диски класса Mixed Use.

В основном в моих серверах стоят NVMe на 1.6 ТБ, 3.2 ТБ и 6.4 ТБ. Более того, у меня есть группа уникальных серверов с дисками емкостью по 12.8 ТБ! У них просто чудовищный ресурс записи.

Моя идеальная формула спокойного сна для продакшена: 1 надежный серверный диск (MU) + регулярный бэкап. А если поставить 2 таких диска (в RAID) + бэкап — вы получаете инфраструктуру, которая переживет практически что угодно.

---

📝 Оставить заявку на сотрудничество или задать вопрос:
https://docs.google.com/forms/d/1wEnhkS3djoHrSRVi69KEg-b9PTiSOb3UyscQ0LFelIs/

#️⃣ #Сервера #BigData #IT
  • 🔥 5
  • ❤ 2
  • 👏 1
  • 👌 1
Post #15 423
🔤 Аутсорс-разработка: «Сеньор на продаже, Джун на коде» 🔤

Наткнулся на интересное обсуждение в канале «Русский ИТ бизнес» о боли заказной разработки.
👉 Ссылка на обсуждение

В комментариях всплыла классическая схема, на которой теряются миллионы и месяцы.

Суть истории одного фаундера:
Заказал разработку сервиса аналитики у аутсорсера ИТ.
На входе: Красивая продажа. Грамотный Project Manager и Senior-разработчик, которые сыпят терминами и продают экспертность.
Реальность: Полгода потерянного времени.

Когда заказчик капнул в код, выяснилось:
1. Архитектура: Аналитические данные лили в PostgreSQL вместо ClickHouse (для BigData это смерть).
2. Качество: «Говнокод», написанный явными джуниорами.
3. Ложь: Агентство приписало себе создание парсера (хотя он был у заказчика свой) и «героическое восстановление данных» при смерти NVMe диска.

В итоге сервис пришлось переписывать с нуля. Юридически не подкопаться — работы формально «выполнены».

Мой опыт: те же грабли
Я никогда не работал с аутстафом, но с аутсорсом и фрилансерами сталкивался. Сценарий частенько один:
На пресейле с тобой общается техлид или даже совладелец студии, которые понимают суть HighLoad.
Как только подписан договор — проект отдают студентам.

У меня так было дважды:
🔹 2014 год: Модуль для антидетект-браузера.
🔹 2015 год: Кластеризатор поисковых запросов.
Мне нужен был производительный C++, а по факту я получал неоптимизированный код, который работал медленнее скриптов на Python. Деньги и время на ветер, а юридически сделать ничего нельзя.

💿 Кстати, про смерть NVMe
Герой истории упоминает, что у него «умер» NVMe диск, и он сам восстанавливал данные из бэкапов (а агентство приписало этот подвиг себе).
Восстановить данные с "мертвого" NVMe практически нереально. Спасает только правильная инфраструктура.

У меня в парке серверов это решено кардинально:
— Полные бэкапы всех виртуальных машин (VM) на внешние NAS.
— Локальная сеть 40 Гбит/с.
Если диск умирает, я поднимаю VM на другом сервере за 20 минут. Это стандарт надежности, который должен быть у «серьезного» хостинга. Если вам нужно такое железо для проектов — обращайтесь.

---
📝 Как не попасть на «джунов по цене сеньоров»?

Автор истории составил полезный чек-лист и полную хронологию, как теряются деньги на таких подрядчиках. Рекомендую почитать, чтобы не наступать на те же грабли:

👉 Хронология потери миллионов и времени
👉 Чек-лист проверки студий

---

📝 Оставить заявку на сотрудничество или задать вопрос:
https://docs.google.com/forms/d/1wEnhkS3djoHrSRVi69KEg-b9PTiSOb3UyscQ0LFelIs/


#️⃣ #Разработка #Аутсорс #Fuckup #Сервера #Бизнес
  • 🔥 5
  • ❤ 2
  • 👏 1
Post #14 498
🔤 Парсинг — это «вечная» тема (Часть 2). ИИ убьет рынок или сделает нас богаче? 🔤

В вопросах к прошлому посту о миллионных выручках на данных часто звучит возражение:
«Зачем сейчас строить бизнес на парсинге? ИИ пишет код скрипта за минуту. Скоро парсеры станут бесплатными, а сервисы — ненужными».

Это популярная иллюзия. Те, кто так думает, видят только одну сторону медали. ☝️
Искусственный интеллект появился не только у программистов-атакующих (создающих парсеры), но и у тех, кто защищает сайты от парсинга.

🛡 Гонка вооружений: почему стало сложнее?

🔹 Google против всех.
Именно бум нейросетей стал триггером для Google кардинально усилить оборону. Корпорация не хочет, чтобы конкуренты (OpenAI, Perplexity) бесплатно собирали их данные для обучения своих моделей. Теперь их защита от ботов — это уровень военной базы.

🔹 Yandex и война с автоматизацией.
В Рунете ситуация также острая. Из-за массового наплыва инструментов автоматизации (BAS, ZennoPoster, мощные комбайны вроде A-Parser) и накрутчиков поведенческих факторов (ПФ), Яндекс вынужден защищаться агрессивно.
Алгоритмы защиты от парсинга могут меняться несколько раз в неделю!

Из-за этой гонки многие старые сервисы SERP-аналитики либо закрылись, не вытянув поддержку, либо сдались и перешли на дорогой официальный Yandex Search API.

🔹 Не только поисковики.
То же самое происходит у лидеров ниш: Wildberries, Ozon, Avito, Auto.ru.
Это уже не просто сайты, а IT-гиганты с огромными бюджетами на кибербезопасность, AntiDDos. Они внедряют динамическую защиту, которая отсекает 99% скриптов, написанных «на коленке» с помощью ИИ.

☢️ Мечта о «Ядерной кнопке» (Super AI)

Конечно, есть гипотеза, что ИИ скоро создаст продукты такого качества, которые дадут бизнесу преимущество уровня «ядерной бомбы».
В это верят инвесторы, заливающие миллиарды долларов в развитие ИИ.

Мечта выглядит так: Супер-программа например для парсинга, которая автоматически:
— Проходит любые защиты и капчи;
— Идеально эмулирует человека;
— Сама находит, собирает и агрегирует любые данные.

Если такой софт появится — он действительно «обнулит» всех конкурентов в сфере сбора данных. Но пока это лишь теории, прогнозы футурологов и красивые презентации для инвесторов.

📉 Реальность сегодня:
Код парсера ИИ напишет легко. А вот заставить его работать стабильно и масштабируемо в условиях постоянной войны алгоритмов — это задача для профи с серьезной инфраструктурой.

Именно поэтому заработок на данных и создание сервисов парсинга — это не уходящая натура, а одна из актуальных тем в Web прямо сейчас.

---

📝 Оставить заявку на сотрудничество или задать вопрос:
https://docs.google.com/forms/d/1wEnhkS3djoHrSRVi69KEg-b9PTiSOb3UyscQ0LFelIs/


#️⃣ #Парсинг #AI #ИИ #BigData #БизнесИдеи #SEO
  • 👍 3
  • 🔥 3
  • ❤ 2
  • 💯 1
Post #13 482
🔤 Парсинг — это «вечная» тема. Сотни миллионов на сборе данных 🔤

В дополнение к прошлому посту о сделке Mpstats (продажа за 2 млрд руб.). Обычно, когда говорят о заработке на данных, сразу вспоминают либо сервисы аналитики маркетплейсов, либо классические SEO-инструменты аналитики на основе парсинга SERP (Keys.so, Megaindex, Ahrefs).

Но это лишь верхушка айсберга. Рынок сбора данных (Data Scraping) гораздо шире.
Данные — это новая нефть, и помимо «хайповых» ниш существуют компании, которые построили крепкий бизнес с выручкой в сотни миллионов на сборе информации из других источников.

Вот некоторые примеры российских компаний (с выручкой за 2024 год) из других сфер:

🏆 Кто зарабатывает на парсинге:

🔹 Brand Analytics
💰 Выручка: > 2.5 млрд руб.
Суть: Мониторинг СМИ и соцсетей. Парсят всё: от ВКонтакте до Telegram-каналов в реальном времени, чтобы бренды знали, что о них говорят.

🔹 Rusprofile
💰 Выручка: ~ 668 млн руб.
Суть: Агрегация данных о компаниях. Спарсили и связали разрозненные данные (ФНС, суды, реестры) в удобный интерфейс. Стали стандартом проверки контрагентов.

🔹 Metacommerce
💰 Выручка: ~ 186 млн руб.
Суть: Сравнение цен. Ежедневно мониторят ритейлеров, чтобы магазины и бренды видели динамику цен конкурентов.

🔹 XMLDataFeed (у владельца классный TG канал Русский ИТ бизнес)
💰 Выручка: ~ 95.7 млн руб.
Суть: Парсинг как услуга. С 2018 года просто качественно собирают данные под заказ для тех, кто не хочет растить свой IT-департамент.

Почему эта ниша никогда не умрет?
Многие думают: «Написал парсер один раз — и он работает вечно».
Это главное заблуждение. Парсинг — это не разовая разработка, а процесс непрерывной поддержки.

Сайты постоянно меняют верстку и усиливают защиту. То, что работало вчера, сегодня отлетает в бан.
Взять тот же Ozon. Сейчас это «цифровая крепость» (TLS-fingerprinting, поведенческий анализ), о которую ломаются 99% простых решений.

Но мой многолетний опыт показывает: непробиваемых сайтов нет. Любую защиту можно обойти, если есть экспертиза и ресурсы на постоянную адаптацию алгоритмов.

И про ресурсы:
Для промышленного сбора данных (особенно с тяжелых сайтов вроде Ozon) одного кода мало. Необходимо мощное железо.
Оно нужно для двух вещей:
1. Качественная эмуляция (браузеры потребляют много CPU/RAM).
2. Распределенный парсинг (масштабирование нагрузки на сотни потоков между серверами).

И здесь Вы уже знаете к кому можно обращаться 👇
https://t.me/RyzhovAN/10

---

📝 Оставить заявку на сотрудничество или задать вопрос:
https://docs.google.com/forms/d/1wEnhkS3djoHrSRVi69KEg-b9PTiSOb3UyscQ0LFelIs/


#️⃣ #Парсинг #BigData #БизнесИдеи #Сервера #Аналитика
  • 🔥 7
  • 👍 3
  • ❤ 2
  • 👌 1
Post #12 477
🔤 Mpstats продан за 2 млрд ₽. Где мои миллиарды? 😄 🔤

Сегодня прошла новость дня: сервис аналитики маркетплейсов Mpstats продан Банку Точка.
Сумма сделки — 2 млрд рублей (при выручке 1.7 млрд и прибыли 741 млн в 2024 г). Цифры мощные, искренне рад за ребят — отличный экзит! 👏

Читаю и думаю: я уже 15 лет занимаюсь парсингом и глубинной аналитикой WildBerries «изнутри». Строю промышленные системы сбора данных для SEO-аудитов и автоматизации.

Чек на 2 миллиарда я пока не получал, но верю, что мое время еще придет 🚀

__________________________________

Чем могу быть полезен:
🔹 Стратегический SEO-консалтинг (аудит, точки роста, процессы уровня Enterprise).
🔹 Построение In-house команд (найм и управление гибридными спецами SEO + Python).
🔹 Аренда мощного железа (мой личный парк из 50+ серверов под парсинг и Big Data).


📝 Оставить заявку на сотрудничество или задать вопрос:
https://docs.google.com/forms/d/1wEnhkS3djoHrSRVi69KEg-b9PTiSOb3UyscQ0LFelIs/
Google Docs Предложение о сотрудничестве Представлюсь — меня зовут Александр Рыжов. За моими плечами ❗️ более 15 лет опыта в маркетинге, SEO и IT в компании WildBerries — крупнейшем маркетплейсе России и СНГ. 💰 Под моим руководством SEO канал принес сотни миллиардов рублей выручки для WB! Мои…
  • 🔥 12
  • 👍 4
Post #10 641
🔤 3500+ ядер, 50+ серверов и 20 Терабайт памяти: как «просто хобби» вышло из-под контроля 🤯🔤

В прошлом посте я рассказывал, как собрал первый сервер, чтобы сэкономить. С тех пор «эксперимент» немного... развился.

Я провел полную инвентаризацию. Сейчас я управляю армадой из 59 физических машин.
Суммарно это 3 524 физических ядра, десятки терабайт RAM и сотни терабайт дискового пространства.

Когда масштаб стал промышленным, я разделил инфраструктуру на два фронта. Такого гибкого подхода вам не предложат обычные хостеры:

🏭 Фронт №1: «Цитадель» (Московский ЦОД Tier-III)
Здесь живут промышленные стоечные монстры 1U/2U. Охлаждение, бесперебойное питание, серьезные каналы.

🔹 Лига «Heavy Metal» (AMD EPYC):
Серверы на EPYC 7002/7003 (Milan/Rome). До 128 ядер на борту! На них стоят Enterprise NVMe диски по 6.4 ТБ. Это надежность и IOPSы, которые переварят любую базу данных.

🔹 Лига «Золотая Классика» (Intel Xeon v3/v4):
Да, Xeon 2696 v4 — это уже не последнее слово техники. Но это «старая гвардия», которая берет своей ценой. 44 честных ядра за 14.000₽? Ни одно современное облако не даст такой производительности на вложенный рубль. Для VPN, парсинга и фоновых задач — бестселлер.

🔹 Лига «Big Data» (Storage Monster):
Особая гордость парка — сервер под хранение данных.
Вдумайтесь: 216 ТБ сырой емкости HDD и 15 ТБ сверхбыстрых NVMe для кэша/горячих данных. Идеальное место для ваших бэкапов, архивов, датасетов или медиа-коллекций. Места хватит на всё.

🔹 Эксклюзив: GPU-монстр на NVIDIA RTX 6000 Blackwell (GDDR7) для тяжелого ML/AI.


🧪 Фронт №2: «Private Lab» (Квартиры и Дача)
Здесь живут Tower-корпуса и мощные малыши Minisforum. Держа их в своем контуре, я снижаю цену аренды для вас (нет переплаты за стойко-место).

🔹 Лига «Форсаж» (Ryzen 9 9950X / 9955HX):
Пока серверные процессоры работают на частотах 2.2–2.5 ГГц, эти машины выдают 4.3 – 5.0+ ГГц.
Идеально для: 1С, тяжелых вычислений, а также кликеров на BAS / ZennoPoster, где важна скорость отрисовки и выполнения скриптов в браузере.

🦕 Лига «R&D Динозавры»
Есть и уникальные машины в ЦОДе, например, 4-процессорный сервер с 1.5 ТБ (!!!) оперативной памяти. Нужно развернуть всю БД прямо в RAM? Легко.


В чем профит по сравнению с облаками?
1️⃣ Честная мощность. Вы получаете не «виртуальный поток», который делите с соседом, а весь выделенный физический ресурс.
2️⃣ Цена/Качество. Мои сборки на Xeon или Ryzen окупают себя быстрее, чем вы оплатите месяц на Selectel или Яндексе за аналогичную производительность.
3️⃣ Гибкость. Windows, Linux, Proxmox — поставлю что нужно.

Я свел всё наличие (59 серверов), технические характеристики и цены в одну таблицу.


📊 Посмотреть список серверов и цены:
👉 https://docs.google.com/spreadsheets/d/18nKAtWGwsZOUithdT6tjgbw5fmGgrKWy7FavwYOPTLQ/edit

📝 Оформить заказ или заявку на подбор:
👉 https://docs.google.com/forms/d/14vN-o5DjKfMKSZWELjO1nrhNJU7146l8q12kw3a-vqs/edit


#️⃣ #Сервера #ИИ #ПФ
  • 🔥 14
  • 👍 3
  • 🤔 3
  • 💯 1
Post #9 610
🔤 SEOшник, который пошёл в серверное железо из‑за бана Hetzner. И не пожалел ❗️ 🔤

В 2014 году я окончательно понял - парсить Яндекс и Google по-дешёвке больше не получится. Совсем прямые запросы без малейшей эмуляции браузера стали неэффективными.

Плюс накрутки ПФ стали выходить в массы. Тогда как раз активно развивался ZennoPoster, позже — BAS. Казалось бы, спасение. Но это ПО жрало CPU так, будто я запускаю не парсер, а майнинг-ферму на стероидах . Мне нужны были настоящие мощности 💪.

И тут — привет от Hetzner 🖐
С 2013 года я снимал у них сервера, всё было спокойно… пока не начал парсить в промышленном масштабе (несколько копий A-parser под парсинг + ZennoPoster "для других задач").

Сначала мне прилетела абуза за "паразитный исходящий трафик" 🚫.
Потом вторая.
Потом третья.

И финал: бан по щелчку, без шансов объяснить, что я вообще делаю. Hetzner считал, что я занимаюсь DDos, хотя никакой серьезной нагрузки ни на какой сайт я не создавал 😱.

👉 А теперь вспомните, какой был ноябрь–декабрь 2014 года.
Евро взлетел как ракета, рубль рухнул, и аренда серверов за границей стала стоить как абонемент на Луну. Даже если бы Hetzner меня не выпилил — платить такой ценник мне стало некомфортно.

Вот тогда я и сказал себе:
"Хватит. Беру железо в свои руки".

1️⃣Мой первый собственный сервер (WorkStation) — легендарный HP Z800.
Два проца Xeon X5660, оператива 24 ГБ DDR3 (позже апгрейднул до 72 ГБ).
Купил на Авито у парня, который занимался рендерингом и выглядел так, будто может собрать Pixar из подручных средств.

Привёз домой — и только тогда понял масштабы 🔤
Z800 не влезал под мой компьютерный стол. Вообще.
Он выглядел как маленький серебряный шкаф, который случайно заехал ко мне жить.
Но мощность для меня тогда была космосом. После виртуалок и арендованных машин — это был как пересесть с велосипеда на танк 🔥.

Я поставил этот сервер у себя дома, слушал, как он ревёт кулерами, и ловил кайф от того, что теперь никто не нажмёт кнопку «бан» и не перекроет мне кислород.

Так началась моя серверная история ▶️.
Не с комфорта.
А с кризиса, запретов и желания работать на своих условиях.


#️⃣ #SEO #ПФ #Парсинг #Сервера
  • 🔥 15
  • 👍 9
  • ❤ 1
  • 👏 1
Post #8 654
🔤 Кто и как сейчас обходит АнтиФрод системы поисковиков (накрутка ПФ)? 🔤


Наткнулся на замечательный пост Олега Шестакова с классификацией накрутчиков ПФ. Поделюсь оригиналом поста и немного дополню.
https://t.me/oshestakovdigital/1135


С классификацией по группам в целом согласен.

1️⃣. Технари на известном ПО BAS или ZennoPoster. Действительно с развитием ZennoPoster, а затем и BAS примерно с 2015 - 2016 г накрутки пошли в массы. Удобный Low-code ZennoPoster и бесплатный BAS забустили масштаб накруток. Нужно сказать, что при хорошем знании работы браузеров, JS и формирования современных антифрод систем с этими инструментами и сейчас можно добиваться хороших результатов. Но нужно постоянно допиливать решения и реально "костылить".


2️⃣. Те, кто не понимает в технической части, но покупает готовый софт на BAS, ZennoPoster и юзают с простыми конфигами - получают скорее рандомный результат. Здесь не буду углубляться в подробности - просто ПС и другие крупные корпорации отслеживают такой софт и сами его тестируют, находят паттерны детекта.


3️⃣. Технари с самописным софтом браузерной автоматизации. Создали свой автоматизированный браузер (обычно на основе Chromium) и свои подмены фингерпринтов. Многие уверен прочитав пост подумают "О, то что мне нужно! Займусь этим, хакну систему и буду рубить бабло" =) Сразу рекомендую не лезть в эту историю.

У меня еще в 2014-2015 был опыт создания своего автоматизированного антидетекта на ОС Gentoo + сборки Firefox с подменами отмечатков и автоматизацией этого дела на Python. Решение было в виде виртуалки и на одном серваке 50+ таких виртуалок. Работало очень нестабильно, приходилось постоянно допиливать код. Слив несколько месячных ЗП на разработку я бросил поддержку этого франкенштейна.


Если у Вас нет сильных технических компетенций и нескольких миллионов рублей (а скорее даже десятков миллионов) - не идите в историю 3 ❗️


О чем не знают многие накрутчики ПФ
В РФ и США уже есть уголовные дела за скликивание контекстной рекламы поисковых систем. Это конечно не совсем накрутка ПФ, но очень очень близко. Многие накрутчики ПФ и сейчас в дополнение к накруткам на SERP скликивают контекст на своих или партнерских сайтах. Не делайте так! Иначе будет как на видео в посте Олега и окажитесь за #️⃣  =)


Связь между SEO и серверным железом
И вот подходим к моменту как же руководитель SEO отдела WB стал заниматься серверами ❓ =) Но об этом в других сериях 🔤

#SEO #ПФ #АнтиФрод #Сервера
Telegram Oleg Shestakov - Digital Business Мои наблюдения по поводу антифрода Яндекса и других корпораций В октябре был на двух конференциях где собрались многие ТОП ребята, которые абузят (пускают ботов / накручивают поведенческие / ставят фейк отзывы и т.д) Яндекс - т.е. всячески нарушают лицензию…
  • 👍 8
  • 🔥 2
  • 💯 2
  • ❤ 1
  • 🤡 1
Older posts →

About this channel

How can I read @ryzhovan without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Александр Рыжов - SEO IT, бизнес, сервера: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Александр Рыжов - SEO IT, бизнес, сервера have?
Александр Рыжов - SEO IT, бизнес, сервера (@ryzhovan) has 321 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Александр Рыжов - SEO IT, бизнес, сервера know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →