TGViewer
Channel Public Channel
RConf AI

RConf AI

@rendallconf

RConf AI - ИИ-платформа для управленческих решений на основе знаний о компании

Платформа анализирует встречи компании, помогая собственникам и руководителям быстрее видеть проблемы, находить точки роста и принимать решения

Сотрудничество: @Eevteeva
Subscribers
215
Photos
51
Videos
1
Links
65
Recent Posts 20 shown
Post #175 61
152-ФЗ и ИИ-оценка: где проходит граница
Один из самых частых вопросов, который мы слышим на первых встречах с клиентами: «А это вообще законно? Мы не нарушим 152-ФЗ?»

Вопрос правильный. Разберём честно.

152-ФЗ требует отдельного согласия сотрудника только в одном случае — когда решение о нём принимается полностью автоматически, без участия человека. Например, если система сама решает: уволить, не взять на работу, не повысить.

RConf устроен иначе. Система анализирует встречи и формирует аналитику: баллы, цитаты, обоснования по заданным компанией критериям. Это и есть ключевое разграничение — ИИ формирует данные, рекрутер или руководитель принимает решение. Финальное слово всегда за человеком.

Это не игра слов — это принципиальная юридическая разница между «автоматизированным принятием решений» и «поддержкой принятия решения человеком». Второе не требует специального согласия по 152-ФЗ сверх стандартной обработки персональных данных.

Плюс сотрудники знают о записи встреч — это обязательное условие работы с платформой. Никакого скрытого наблюдения.
Из нашей практики: споры про 152-ФЗ возникают почти на каждом первом запуске. И почти всегда — снимаются после одного разговора с юристами клиента, когда те видят реальную архитектуру системы.
  • 👍 2
  • 🔥 1
Post #174 114
25 лет без системы оценки — и это работало. До момента, когда компания решила масштабироваться.

В понедельник на Персонал Экспо выступили с совместным кейсом: Дарья Сорокина, HR BP Frontside (25 лет на рынке фасадных систем), и наш Артём Садыков.

"Мы доказываем, что можно» — команда встретила недоверие, а через месяц вся компания показала заметную положительную динамику по компетенциям.


Три мысли, которые остались после выступления:

1️⃣ Когда компания растёт на интуиции основателей — это работает. До тех пор, пока не нужно открывать новое производство и отвечать на вопрос: кто из руководителей готов к следующему уровню, а кто нет. Интуиция не масштабируется.

2️⃣Путь к внедрению редко бывает прямым. 5 месяцев поиска вендора, 20 неудачных попыток, внутренний саботаж, споры про 152-ФЗ — Дарья рассказала про грабли честно. Оценить всех руководителей удалось за 3 недели.

3️⃣ Матрица 9-box работает, когда данные в ней настоящие. Не абстрактные тесты, а реальные встречи руководителей — оценка потенциала и работы «здесь и сейчас» в одной системе. Это применимо не только к производству — к любой компании, где руководителей больше десяти.
  • 🔥 3
  • 👍 2
Post #173 151
Годовой HR-цикл: рынок ускорился, а цикл — нет

Модель компетенций на три года. Ассессмент раз в год. ИПР на следующие 12 месяцев. Это не плохая система — это система, которую строили вдумчиво и всерьёз. Но рынок за последние годы ускорился настолько, что цикл просто не успевает за ним.

Сигнал о поведении руководителя на февральской планёрке приходит к нему в сентябре — в усреднённом виде, без привязки к конкретному разговору. Контекст давно потерян. Обратная связь формально есть, а толку от неё немного. И дело не в качестве инструментов — дело в том, что управленческая работа по природе своей редко даёт быструю и объективную обратную связь. Ассессмент раз в год эту сложность только усиливает.

Исследователи давно это подтверждают. Sackett и соавторы показали: даже лучшие классические методы оценки объясняют не более 18% различий в производительности. Brynjolfsson, Li и Raymond (2025) дали конкретную цифру: когда ИИ даёт обратную связь в процессе работы, а не через полгода — производительность растёт на 15%. Причём эффект неравномерный: менее опытные сотрудники улучшили и скорость, и качество, сильные почти не изменились. Механизм — ИИ распространяет практики лучших и помогает остальным быстрее пройти кривую опыта.

Новая логика не отменяет оценку. Она меняет её ритм: не разовое мероприятие, а наблюдение в реальной работе. Каждая встреча становится точкой данных. Обратная связь приходит, пока контекст ещё жив.

Как это выглядит на практике — разбираем на мастер-классе «Оценка персонала 2.0: как руководитель управляет эффективностью команды» на кейсе компании ТТС.

📅 10 сентября, 16:00 МСК
🫱 Регистрируйтесь!
  • 👍 5
Post #172 166
Корпоративное обучение умерло. Спрос на знания — вырос

Алексей Воронин, основатель RConf — в Коммерсантъ. Карьера.
Кротонвилль. Первый корпоративный университет мира, эталон для всей индустрии на полвека вперёд, бюджет до миллиарда долларов в год. В апреле 2024 года продан по цене квартиры. Он проиграл не онлайн-курсам — он проиграл одному вопросу, на который не смог ответить цифрами: как обучение влияет на результат бизнеса?

Россия идёт той же траекторией. «Слово „обучение" набило оскомину». «С темой обучения к генеральному лучше не заходить» — это говорят люди, которые сами строили корпоративные университеты.
При этом спрос на управленческое знание не упал. Он вырос.

В статье — где именно проходит разрыв, два кейса из практики RConf и один лайфхак к началу делового сезона: как начинать проект корпоративного обучения, чтобы генеральный директор вас поддержал.

Полную статью читать в Коммерсантъ. Карьера - ссылка
  • 🔥 6
  • 👌 1
Post #171 132
9box: почему эта матрица всё ещё лучшее, что есть в кадровом резерве

9box существует уже полвека. За это время HR-индустрия придумала десятки альтернатив. Матрица пережила их все — и не случайно.
Два параметра, девять квадратов — и руководители получают общий язык для разговора о людях. Не «мне кажется, он перспективный», а конкретная позиция в системе координат: где человек сейчас и куда может двигаться. Это ценно. Это работает. Но у инструмента есть одно уязвимое место.

Матрица сильна ровно настолько, насколько точны данные на входе.
Ось результативности — как правило, KPI или оценка руководителя. Здесь всё более-менее измеримо. Ось потенциала — вот где традиционно начинается субъективность. Потенциал оценивает человек. На основании впечатлений, нескольких разговоров, иногда ассессмента. Эффект ореола, усталость к концу дня, симпатия — всё это, как мы уже писали, даёт до 50% погрешности.

Инструмент хороший. Топливо — не всегда.

Что меняет ИИ

ИИ не переизобретает 9box — он даёт ей то, чего раньше не хватало: надёжные данные на ось потенциала. Оценка не по впечатлению после одного разговора, а по паттерну поведения в реальных рабочих ситуациях. Не «мне кажется», а конкретные индикаторы, цитаты, среднее по нескольким прогонам и погрешность.
Матрица остаётся. Язык для разговора о людях остаётся. Но решения, которые на ней основаны, становятся другого качества.

Хороший инструмент заслуживает хороших данных. Теперь они есть.

А вы используете 9box в работе с кадровым резервом?
  • 🔥 2
  • 💯 1
Post #170 106
Кадровый резерв: как не ошибиться в человеке
Кадровый резерв — это всегда ставка на будущее. И главная сложность не в том, чтобы найти сильных. Сильные, как правило, видны. Сложность в другом: человека оценивают в условиях, которые он уже освоил, а назначают в те, которых ещё не было.

Большинство компетенций можно подготовить. Можно выучить, как говорить про стратегию. Можно отрепетировать уверенность. Можно произвести впечатление на ассессменте. Но есть одна компетенция, которую нельзя симулировать: принятие решений в условиях неопределённости.
Не потому что человек скрывает, а потому что это проявляется не в ответах, а в логике. Как он движется от «не знаю» к «вот что делаю». Признаёт ли риски явно или прячет их за оптимизмом. Объясняет ли выбор между альтернативами или просто называет решение. Эту сцепку смыслов сложно подделать — она либо есть, либо её нет.

Именно поэтому один блестящий ответ на ассессменте ничего не доказывает. А несколько рабочих встреч — доказывают многое. Не потому что человек готовился, а потому что он просто работал.
ИИ здесь делает то, на что у ассессора физически не хватает времени: читает не отдельные фразы, а паттерн. Как человек рассуждает под давлением — раз за разом, в разных ситуациях. И даёт не впечатление, а статистику.

Промпт для оценки компетенции «Принятие решений в условиях неопределённости»
Ты — эксперт по оценке управленческих компетенций.
Задача: Оцени компетенцию по транскрипту рабочей встречи.

Компетенция: Принятие решений в условиях неопределённости — способность действовать и выбирать направление в ситуациях, где данных недостаточно, а последствия непредсказуемы.
Поведенческие индикаторы:
— явно признаёт неопределённость, не маскирует её уверенностью;
— называет альтернативы и объясняет логику выбора между ними;
— обозначает риски конкретно, а не абстрактно;
— предлагает действие, а не ждёт полной информации;
— соотносит решение с целями, а не только с текущей ситуацией.
Шкала 1–5:
1–2 — избегает решений, ждёт определённости или действует без анализа;
3 — видит проблему, но логика выбора не прослеживается;
4–5 — явно проходит через альтернативы, называет риски, обосновывает выбор.
Формат ответа: сначала приведи 2–3 цитаты из транскрипта, которые стали основанием. Затем — балл и обоснование. Не делай общих выводов о личности.
  • 👍 3
  • 🔥 2
Post #169 101
Два ассессора. 7200 руководителей в год.
Звучит как ошибка в расчётах. Разберём, за счёт чего это получилось - и что при этом не изменилось.

Задача
«Доброцен» открывает новые магазины: и каждое открытие означает новых руководителей, которых нужно оценить. Потребность в регулярной оценке выросла кратно: 2400+ руководителей в год, по единым стандартам.
Проблема была не в методике. Модель компетенций, ассессоры, работающий процесс — всё это у компании было. Проблема в том, что этот процесс не масштабируется. Цикл ассессмента занимал два дня на человека, и основная часть этого времени уходила не на экспертное суждение, а на наблюдение и ручную подготовку отчётов.
Наймом такое не закрывается: бюджет заморожен, а дефицит кадров в HR и так критичен. Развилка знакомая — либо резать охват, либо резать глубину.

Что изменили
Формат оценки остался прежним: тот же ассессмент-центр, те же кейсовые задания, та же модель компетенций. Единые стандарты никто не переписывал — и это принципиально, результаты остались сопоставимыми с оценками прошлых лет.
Изменилось то, что происходит после сессии. Раньше ассессор наблюдал в реальном времени, фиксировал поведение и затем вручную собирал отчёт. Теперь ИИ анализирует сессии по индикаторам компании и формирует структурированный профиль компетенций — с баллами, обоснованием и цитатами-доказательствами. Ассессор подключается только к спорным профилям.
▪️ Охват: 2400 → 7200 руководителей в год
▪️ Время на один ассессмент: 2 дня → 20 минут
▪️ Нагрузка на команду оценки: −67%
▪️ Экономия: 10 000+ человеко-часов в год

Теперь главный вопрос: а качество?
Он правильный, и мы задаём его первым сами. Отвечаем, что не изменилось.
1️⃣ Критерии остались за компанией. Модель компетенций, поведенческие индикаторы, шкала — это работа экспертов «Доброцена», а не настройка по умолчанию. Без этого ИИ выдаёт красиво упакованную размытость, мы об этом писали.
2️⃣ Каждый балл обоснован цитатой. Не «7 из 10», а конкретный момент сессии, ставший основанием. Такой отчёт можно проверить и с ним можно спорить — в отличие от впечатления.
3️⃣ Пограничные случаи остаются за человеком. Уверенные профили ИИ закрывает сам, спорные валидирует ассессор. Там, где цена ошибки высока, ответственность у людей.
4️⃣ Стандарт стал одинаковым для всех. Раньше на результат влияло, кто именно наблюдал и на какой по счёту сессии за день. Теперь все проходят через одни и те же индикаторы — эффект контраста и усталость оценщика из процесса уходят.

Вывод
Ассессоров не стало меньше, и работы у них не стало меньше — изменился её характер. Они больше не наблюдают и не пишут отчёты вручную. Они настраивают критерии и разбирают сложное.
«Работу, которую возможно было сделать только целым подразделением, теперь делает один специалист вместе с ИИ. В век дефицита кадров это настоящая победа»

Сколько руководителей у вас проходят оценку — и сколько стоило бы оценивать, если бы это ничего не стоило?

И вопрос со звездочкой:
Как доказать собственнику, что эта оценка на самом деле превращается в прибыль?
  • 🔥 1
Post #168 88
Можно ли измерить качество управления — цифрой?

Долгое время экономисты считали, что нельзя: слишком субъективно. Пока Ник Блум и Джон Ван Ринен (LSE, Stanford, McKinsey) не создали World Management Survey (WMS) — сегодня это более 20 000 компаний в 35+ странах.

Как это работает

WMS оценивает 18 базовых управленческих практик по шкале от 1 до 5 — в трёх блоках: как компания отслеживает результаты, ставит цели и работает с людьми,

Исследователи использовали «двойное слепое» интервью: менеджеру задают только открытые вопросы («расскажите, как вы разбираете отклонения от плана») и не показывают шкалу. Так фиксируются реальные практики, а не красивые декларации. А интервьюер не знает финансовых результатов компании — чтобы они не «подкрашивали» оценку.

Главные открытия

▪️ Рост индекса управления на одно стандартное отклонение связан с ростом производительности на десятки процентов

▪️ Управленческие практики объясняют около четверти разрыва в производительности между странами — сопоставимо с вкладом ИТ и новыми технологиями

▪️ Самооценка менеджеров почти не коррелирует с реальным баллом. Слабые компании уверены, что управляют хорошо.

▪️ И самое обнадёживающее: управление — обучаемый актив. Эксперименты показали: целенаправленное внедрение практик даёт устойчивый прирост производительности на 10–20%.

Вывод

Качество управления можно измерить, сравнить и улучшить. Инвестиции в управление— самый мощный двигатель роста.

Единственный минус классического WMS — дорогие интервью раз в несколько лет. Именно поэтому мы в RConf построили на этой методологии непрерывное измерение: ИИ оценивает качество управления по реальному поведению руководителей на рабочих встречах — с доказательствами-цитатами и индексом MQI каждый месяц.

А насколько вы считаете полезным измерить качество управления в вашей компании?
Post #167 93
🏒 Чем чемпион отличается от просто хорошего игрока?

Не талантом. И даже не количеством тренировок.

В хоккее это известно точно: чемпион — тот, кто умеет смотреть на свою игру честно. После каждого матча — разбор. Не чтобы найти виноватых, а чтобы найти точку роста: здесь опоздал на смену, здесь отдал пас не туда, здесь можно было сыграть иначе.

Неприятно? Ещё как. Но спорт давно принял простую идею: изнутри свои слабые места не видит никто. Ни игрок, ни тренер, ни вся команда. «Своя игра всегда кажется лучше, чем она есть» — так устроен человек. Поэтому рост начинается не с усилий. Усилий у всех достаточно. Рост начинается со взгляда со стороны.

Уэйн Гретцки говорил, что мчится туда, где шайба будет, а не туда, где она была. Это умение не врождённое — оно выработано тысячами часов разбора своей и чужой игры.


А теперь честный вопрос к себе.
Когда вы в последний раз видели свою «игру» со стороны? Не отчёт о результатах — а именно то, как вы играете: как проводите совещание, как принимаете решения, как слышите (или не слышите) свою команду?

У каждого руководителя есть свой стиль управления. И почти никто не видит его со стороны. Руководитель уверен, что развивает команду, — а на встречах говорит 80% времени и сам отвечает на вопросы, которые задаёт. Или считает себя жёстким и требовательным — а команда слышит его иначе и просто перестаёт выносить проблемы наверх. Это не плохой руководитель. Это обычные слепые зоны — они есть у всех. Разница лишь в том, ищет ли человек того, кто поможет их увидеть.

В RConf мы занимаемся именно этим: помогаем честно взглянуть на управленческие процессы со стороны — как на самом деле проходят встречи, как принимаются решения, где можно раскрыть потенциал людей. Не ради оценок и контроля. А ради того же, ради чего хоккеисты пересматривают каждый матч, — чтобы следующая игра была сильнее.

Нельзя стать лучше, не увидев, где ты сейчас. С этого начинается любой чемпион — и на льду, и в переговорной.
  • 🔥 3
  • 👍 2
  • ❤ 1
Post #166 141
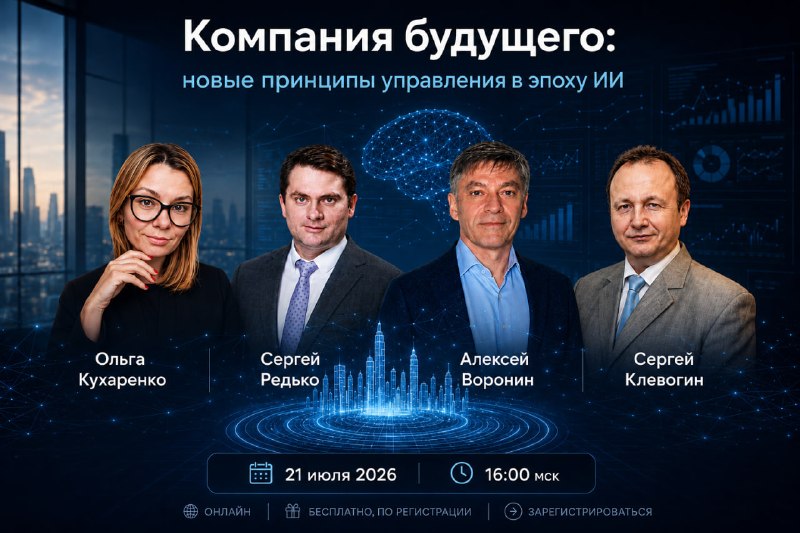
Приглашаем 21 июля на открытую панельную дискуссию, где практики, управляющие крупным бизнесом, обсудят, как ИИ меняет саму роль управленца — то, как первое лицо видит компанию, принимает решения и работает с людьми.

Разговор пойдёт по трём линиям
1️⃣Видение
Как с помощью ИИ точнее понимать, что происходит внутри компании, на рынке и в технологиях.
2️⃣Решения
Как меняется само принятие решений: становятся ли они оптимальнее, дальновиднее и своевременнее.
3️⃣Люди
Какие компетенции развивать команде и как меняется управление людьми в эпоху ИИ.

Отдельно разберём вопрос конкуренции: если ИИ-инструменты доступны всем, за счёт чего компании будут выигрывать друг у друга.

В финале — живое демо: разыгрываем реальную управленческую ситуацию и покажем, как ИИ её анализирует. Разберем вместе с экспертами.

Спикеры — практики, которые сами управляют бизнесом
В дискуссии — практики, которые сами управляют бизнесом:
▪️ Алексей Воронин — соучредитель RConf, д.ф.-м.н., модератор
▪️ Сергей Редько — цифровая трансформация ТЭК
▪️ Сергей Клевогин — руководитель департамента ИБ федерального холдинга
▪️ Ольга Кухаренко — руководитель отдела развития системы управления, «Доброцен»

❗️ 21 июля, 16:00 МСК, онлайн
Круг небольшой — до 30 участников.

Участие бесплатное, требуется регистрация
  • 🔥 2
Post #165 110
ИИ приносит деньги. Но не всем — и вот почему.
PwC опросила 4 454 CEO из 95 стран (29-й Global CEO Survey, 2026). Вопрос №1, который волнует первых лиц: достаточно ли быстро мы меняемся, чтобы успеть за технологиями?
Цифры дают честный ответ. 56% компаний пока не получили от ИИ ни роста выручки, ни снижения затрат. Но есть авангард — 12%, у которых сошлось и то и другое.

Чем они отличаются? PwC отвечает конкретно. Лидеры не запускают разрозненные пилоты — они строят фундамент: стратегию, данные, культуру работы с ИИ. И применяют его глубже: 44% авангарда встроили ИИ в собственные продукты и сервисы — против 17% у остальных.

Результат измерим. «Динамичные» компании — те, кто инвестирует и трансформируется несмотря на неопределённость, — растут на 9% против 7% у осторожных, а маржа у них 9% против 6%. Два пункта роста и три пункта маржи — цена выжидательной позиции.

Вывод исследования: главная опасность сейчас — не поспешность, а отрицание. Побеждают не те, кто «попробовал ИИ», а те, кто перестроил вокруг него работу компании.
pwc PwC’s 29th Global CEO Survey: Leading through uncertainty in the age of AI CEOs are reinventing their companies with technology and seeking growth opportunities in new sectors, even as they see elevated threats ahead.
  • ❤ 1
Post #164 104
Ловушка сильной культуры: когда единство убивает правду

В лучших компаниях, с которыми мы работали, рано или поздно возникал один и тот же вопрос: а как выглядит культура нашей компании на самом деле? Не в декларациях и ценностях на сайте, а в живой работе на ежедневных деловых встречах.

Собственник строит компанию годами. Вкладывает в людей, формирует ценности, создаёт традиции. В какой-то момент вокруг — только улыбки, энтузиазм, согласие. Это приятно! Но это и есть ловушка!

Тот, кто сомневается, смотрит на эти улыбки и думает: только я один сомневаюсь. И молчит, чтобы не нарушать согласие, не быть белой вороной, чтобы легче двигаться по карьерной лестнице, наконец! На самом деле сомневаются и молчат все.

Экономист Тимур Куран назвал это «фальсификацией предпочтений»: люди искажают свои взгляды под давлением среды. Всеми нелюбимые решения выглядят популярными, очевидно бесполезные практики живут годами, а наверх поступает исключительно благостная картина.

CEO видит единство → убеждается в правоте → усиливает культуру → молчание крепчает.


Как Тойота взломала культуру замалчивания. Японская культура - один из самых наглядных примеров ловушки молчания. Сохранение гармонии и уважение к авторитету- традиционная основа такой культуры. Тойота ввела андон — верёвку, которую любой рабочий мог дёрнуть, чтобы остановить линию при обнаружении дефекта. Когда руководитель прибывал, он первым делом благодарил того, кто остановил конвейер. Со временем это перестало быть признанием в ошибке — стало общепризнанным вкладом в общее дело.

Парадоксально, но сильная культура без встроенных механизмов несогласия - опасна. А психологическая безопасность — это вовсе не взаимная вежливость. Это верёвка андон.

Чем поможет ИИ в управлении культурой. Внедряя корпоративные правила и командные практики, легко невольно попасть в ту же ловушку: видеть желаемое, а не реальное. ИИ позволяет увидеть, как внедряемые практики работают на самом деле — не в мечтах, не в отчётах, а в живых встречах на рабочем месте.

Пример дашборда RConf по измерению корпоративной управленческой культуры на основе реального пилота (данные полностью анонимизированы) - по ссылке
  • 👍 1
  • 🔥 1
  • 👏 1
  • 💯 1
Post #163 85
Когда настройки промпта мало: как ещё повысить точность ИИ?
Аккуратной настройки промпта чаще всего хватает. Но если разброс остаётся слишком большим для цены ошибки — есть методы посерьёзнее.

Множественная генерация и разные модели. В отличие от человека, ИИ можно опросить не один раз, а двадцать — и не одной моделью. Усредняем прогоны: разброс сужается, оценка стабилизируется. А сам разброс становится сигналом: скачут результаты — критерий ещё размыт или данных мало. Честное «недостаточно данных» всегда лучше выдуманной цифры.

Тонкая настройка промпта для разных моделей.

У разных моделей- разные слепые зоны, разные особенности промптов, поэтому важно придерживаться как общих правил уточнения промпта, так и знать нюансы моделей, чтобы не увеличивать разброс.

1️⃣ Покажите 2–3 эталонных фрагмента: вот так выглядит «4», а так «2» — модель калибруется по примерам гораздо точнее, чем по определениям.
2️⃣ Требуйте сначала обоснование с цитатами и только потом балл.
3️⃣ Дробите «лидерство» на конкретные индикаторы — целое собирается из частей надёжнее.

Качественный скачок — больше данных.
Один разговор — это одна точка, случайная. Несколько встреч одного человека дают устойчивую картину и гасят погрешность отдельного интервью. В RConf для этого автоматически создаётся база знаний по встречам — анализ идёт по всей истории, а не по одному срезу.

Человек на границе. Уверенные случаи ИИ закрывает сам, пограничные — валидирует человек. Там, где цена ошибки выше всего, ответственность остаётся за человеком.

Итог.
Точность ИИ — не свойство модели, а результат настройки. Сначала четкие критерии и индикаторы, понятные примеры, обоснование перед баллом, дробление критериев. Если этого мало — множественная генерация по разным моделям. Пограничные случаи — всегда человеку.
  • 👍 1
  • 🔥 1
Post #162 72
Как надёжно оценивать компетенции с помощью ИИ?
Компетенция - это не то, что человек о себе говорит, а то, как он принимает решения. И этот способ надёжно отпечатан в речи. Не в отдельных словах, а в скрытой сети связей между ними: что с чем человек сцепляет, как переходит от факта к выводу. Речь устроена как паутина: подделать одну фразу легко, всю сцепку смыслов — невозможно. Языковая модель обучена ровно этому - улавливать близость смыслов. По-сути, языковая модель - прирожденный рекрутер, она, как и рекрутер, по тексту (собеседованию) выявляет отраженные в речи компетенции сотрудника.

Главное условие — чёткие критерии с индикаторами.
Если вы можете внятно объяснить человеку, что такое «лидерство» в вашей компании, то и ИИ поймёт. Чем размытее формулировка, тем больше разброс. Размытый критерий даёт красиво упакованную размытость.
Типичная ошибка при проверке точности оценки - это прикинуть в голове оценку знакомого сотрудника и сравнить с ИИ. Но так не работает. Так вы измеряете не точность, а разницу между своим субъективным впечатлением о конкретном человеке - на основании всего опыта знакомства - и оценкой ИИ по заданным критериям на основании одного интервью. Сравнивайте круглое с круглым!

Правильная процедура.
Собрать 3–5 оценщиков, дать каждому чёткие критерии с индикаторами и шкалу (например, от 0 до 3). Каждый независимо смотрит интервью кандидата, выставляет балл и письменно обосновывает его — какой конкретно момент стал основанием. Это и называют мотивировкой.
У пяти независимых экспертов баллы не совпадут идеально - это нормально. Среднее этих баллов — ваш результат, разброс между оценками — погрешность метода.
Затем прогнать ту же запись через ИИ с теми же критериями, шкалой и требованием к обоснованию — столько раз, сколько было экспертов. Считаете среднее и погрешность у людей, считаете у ИИ. Сошлись - ИИ работает не хуже ваших людей.
Никаких итоговых вердиктов: только среднее и погрешность. Так работают профи.

Пример фрагмента промпта, который мы используем:
Модель оцениваемых компетенций
«Стратегическое мышление» - способность видеть картину в целом, анализировать проблему в долгосрочной перспективе и предлагать решения с учетом различных факторов и последствий.

Поведенческие индикаторы:
- Определяет ключевые факторы и тенденции, влияющие на отток сотрудников
- Анализирует проблему комплексно, учитывая различные перспективы
- Предлагает решения, ориентированные на долгосрочный эффект
- Соотносит предлагаемые меры с бизнес-целями компании
- Учитывает рыночный и отраслевой контекст

Шкала оценки (0-5):
1. 0-1: Не демонстрирует стратегического мышления; фокусируется только на очевидных и сиюминутных аспектах проблемы, рассматривает проблему узко, без учета долгосрочных последствий.
2. 2-3: Демонстрирует базовое стратегическое мышление; видит некоторые взаимосвязи, но анализ недостаточно глубокий.
3. 4 -5: Демонстрирует выдающееся стратегическое мышление; предлагает инновационные решения с учетом всех аспектов проблемы, четко видит долгосрочные перспективы и связь с бизнес-стратегией.


Если средние не сошлись — читайте мотивировки. По нашей практике, обычно вскрывается одно из трёх: ИИ заметил то, что эксперты пропустили и они меняют мнение; модель или эксперты недопоняли критерий — добавляем примеры в промпт; не хватает контекста и целей компании, который эксперты держат в уме по умолчанию- добавляем контекст. Процесс настройки оценки с помощью ИИ (да и спомощью людей)- всегда иттеративный. Если все сошлось с первого раза - это случайность! Закономерность- уточнения и настройка.

Оговорка: речь о современных больших моделях — уровня Claude Sonnet или GigaChat. На слабых локальных возможны сюрпризы.
В большинстве случаев эта процедура даёт отличное совпадение между группой экспертов и ИИ.
  • ❤ 2
  • 👍 1
Post #161 74
Откуда берётся погрешность — у людей и у ИИ

До 50% результата оценки зависит от того, кто оценивает, а не от того, кого оценивают. Неудобная цифра, но она воспроизводится в исследованиях снова и снова.

Происходит это не потому, что оценщики некомпетентны. Просто мозг экономит усилия и делает это автоматически, без спроса. Одно яркое качество окрашивает всю картину целиком: человек уверенно держится на входе — значит, скорее всего, и компетентен, и надёжен. Первое впечатление складывается за 30 секунд и почти не меняется — всё остальное время интервью оценщик его незаметно для себя подтверждает. А эффект контраста работает ещё проще: кандидат выглядит сильнее или слабее в зависимости от того, кто проходил собеседование перед ним полчаса назад. В отдельных исследованиях это давало до 80% погрешности — просто от порядка в расписании.

К этому добавляется то, о чём в компаниях говорят редко: обоснованных критериев успешного кандидата в большинстве случаев нет, а скачанные из интернета модели компетенций ничего не предсказывают, как бы убедительно они ни выглядели. «Рекрутер с чутьём» — это, конечно, хорошо, но не масштабируется: уходит в отпуск — и воспроизводимость оценки уходит вместе с ним.

На этом фоне ИИ выглядит почти как решение. Он не устаёт, не знает эффекта контраста, не забывает цели компании к концу дня найма. Всё это правда — но это не значит, что у него нет погрешности. Она есть, просто другая: вероятностный разброс выводов (температура), переоценка красноречия, потеря контекста на больших объемах. Не человеческая предвзятость, но и не её отсутствие.

Поэтому правильный вопрос не «точен ли ИИ» — а достаточно ли он точен для конкретной задачи именно вашей компании. И как это проверить — об этом в следующем посте.
  • 🔥 4
Post #160 84
Какая точность оценки вам нужна?

Когда говорят «эти весы очень точные» — сразу возникает разумный вопрос: для чего? Взвесить крупицу золота или картошку? С оценкой людей этот вопрос почему-то не задают.

А стоило бы. Потому что у любой оценки персонала три разных свойства и в зависимости от задачи важны разные из них.

Надёжность - это повторяемость. Два эксперта смотрят одного кандидата и приходят к одному выводу. Оценки до и после обеда совпадают.

Валидность - оценка действительно измеряет то, что нужно. Например, предсказывает, как человек сработается с командой, а не просто фиксирует, что он бойко отвечает на вопросы.

Точность - попадает ли в цель, нет ли систематического смещения.

Какое из трёх свойств важнее — зависит от цены ошибки. При найме времени мало, данных мало, и отсечь хорошего кандидата дороже, чем взять слабого: второго шанса не будет. Нужна валидность. При формировании кадрового резерва ошибка имеет долгосрочные последствия, зато есть время накапливать данные — здесь нужна надёжность, не блеск одной встречи. При оценке для развития цена ошибки низкая, но нужна не цифра «7 из 10», а карта сильных и слабых сторон.

И вот что крайне важно, но редко встречается в практике оценки людей: профессиональная оценка — это всегда два числа: среднее и погрешность. Без второго первое почти ничего не значит.

Кандидата берут в кадровый резерв, если оценка ≥ 2.8.

Оценщики поставили 1, 3, 5 → среднее 3, погрешность ±2. Брать? Неизвестно. Мы знаем лишь, что кандидат где-то между 1 и 5.

Оценки 2.8, 3.0, 3.2 → среднее тоже 3, погрешность ±0.2. Вот тут всё понятно — с учётом погрешности кандидат проходит.


Откуда берётся эта погрешность у людей и что происходит, когда оценивает ИИ — в следующем посте.
  • 🔥 3
Post #159 93
Наш цифровой помощник наконец получил имя и это заслуга сообщества RConf.
🥇 1 место — Нео
Автор имени-победителя Эльмира Пугачёва получает полный набор из трёх книг. Эльмира, мы свяжемся с вами лично.
🥈 2 место — Сократ
Автор имени @igorborodinnn получает книгу «От хорошего к великому» — Джим Коллинз 📗
🎖 Специальный приз
Среди всех вариантов было одно имя, которое не попало в финал, но запомнилось команде — Рики. Екатерина получает книгу «Фрикомыслие» — Левитт, Дабнер 📙

Спасибо всем, кто участвовал - вы помогли Нео появиться на свет)
Скоро расскажем, кто такой Нео и как он будет помогать вам работать с RConf 🚀
  • 🔥 5
  • ❤‍🔥 2
  • 👏 1
Post #157 90
Чек-лист по использованию ИИ .png1.5 MB
В прошлом посте мы разобрали, почему внедрение буксует - даже когда команда кивает на обучении и говорит «всё понятно».
Спойлер: дело не в саботаже. Люди ведут себя рационально.

Но как тогда понять, что инструмент реально используется, а не просто числится в списке «внедрённых»?
Мы собрали конкретные сигналы - поведенческие, метрические и тревожные. И упаковали их в чек-лист.

📎 Он в приложении к этому посту.

Главный вопрос для быстрой проверки - спросите любого участника:
«Расскажи конкретный случай за последнюю неделю, когда инструмент тебе реально помог?»
Отвечает с примером - пользуется.
Мнётся или говорит абстрактно — скорее всего нет.

Банально? Да. Но именно это работает.
  • 🔥 2
  • ❤‍🔥 1
Post #156 91
Мы много внедряем ИИ-инструменты в компаниях. И провал - часть ценного опыта. Делимся, берите!)

- Коллеги, все ли понятно?
Команда кивала на обучении.
Через неделю — тишина. А через две - кислые лица ответственных за проект.

Мы прошли через это. И вот что поняли.

Сотрудники не саботируют инструмент с ИИ. Они ведут себя рационально.

Как только мы перестали думать об этом как о "сопротивлении" — картина стала другой:
1. Польза шла наверх, а не к тем, кто работает с инструментом каждый день. Отчёт улетал руководителю, а сотрудник не получал ничего обратно. Никакой подсказки, никакой обратной связи.
2. Мы не договорились, что считать успехом до старта. Не зафиксировали "сейчас отчёт занимает 3 часа" — не удастся доказать, что добились успеха, хотя время на отчет теперь - 2 минуты. Без базовой метрики любой результат воспринимается как "ну и ладно".
3.Всё держалось на одном человеке. Он ушёл в отпуск и проект завис.

После нескольких болезненных провалов, мы сделали так, чтобы наш инструмент давал что-то лично каждому участнику бизнес- процесса снизу доверху. Подсказки, полезные лайфхаки, развивающую обратную связь с поддержкой и похвалой от ИИ.

Больше союзников - больше шанса на успех. Нашим союзникам не надо долго объяснять, что было до и что стало после. Они объясняют это сами коллегам и своим руководителям.

Банально, скажете вы? Банально, но именно это работает!
  • 🔥 2
Older posts →

About this channel

How can I read @rendallconf without a Telegram account?
TGViewer shows the public web preview Telegram publishes for RConf AI: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does RConf AI have?
RConf AI (@rendallconf) has 215 subscribers on Telegram, refreshed roughly every 30 minutes.
Does RConf AI know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →