TGViewer
Channel Public Channel
Ученый без степени | AI-блог Ани

Ученый без степени | AI-блог Ани

@applied_scientist_blog

📊 Applied Scientist из Amazon о технологиях AI. Исследования, практика, новости из индустрии, полезные инструменты с AI - делюсь всем, чем сама интересуюсь.

Для связи: @piunova_a
Subscribers
834
Photos
114
Videos
5
Links
81
Recent Posts 13 shown
Post #165 1.17K
Почитала тех репорт 🔗Fun-Audio-Chat — LALM (Large Audio Language Model) от Tongyi Team (Alibaba). Интересно, что теперь большинство конкурентов в сравнительных таблицах это другие китайские модели (Kimi-Audio, GLM4-Voice, …), опенсорс-гонка сместилась, такое время. По бенчмаркам уже становится сложно делать однозначные выводы, результаты смешанные в зависимости от задачи

Тем не менее в статье нашла пару интересных архитектурных и тренировочных решений 👇

Архитектура

⏺Модель в двух версиях: 8B (опенсорс, на основе Qwen3-VL-8B) и MoE 30B-A3B (30B параметров, 3B активных)
⏺Whisper-large-v3 audio encoder
⏺Семантические токены S3Tokenizer от CosyVoice V3

🥺 Dual-Resolution Speech Representations

Модель генерит текст и речевые токены авторегрессионно. При этом у нее две головы: текстовая (по одному токену за шаг генерации) и аудио голова (k=5 токенов за шаг). И здесь появляется проблема audio-LLM: temporal rate mismatch. Текст генерится со скоростью ~3 Hz (токенов в секунду), а речь ~25 Hz (зависит от токенов конечно).

Решение такое: (см. картинку)

Grouping (25 Hz → 5 Hz): на вход LLM каждые k=5 последовательных речевых токенов конкатенируются и проецируются в эмбеддинг. Длина последовательности сокращается в 5 раз. Далее мерджат с текстовым эмбеддингом

Speech Refined Head (SRH): из output'а LLM отдельная голова разворачивает сгруппированные эмбеддинги обратно в 25 Hz токены, авторегрессионно генерируя 5 токенов за группу.


🍸 Core-Cocktail training

Классическая проблема мульти-модального обучения: если файнтюнить LLM на аудио-данных с высоким learning rate, то модель быстро учится новой модальности, но забывает текстовые способности. Если с низким, то обучение стагнирует. Из 🔗DrVoice (их же статья) есть конкретные цифры: после агрессивного fine-tuning текстовые метрики падают с 81.77 до 70.19, что существенно.

Тренируем агрессивно, потом частично откатываем:

🔴Фаза 1: full fine-tuning с высоким LR (LLM, энкодера, адаптера). Модель сдвигает параметры в сторону мультимодальности.

🟣Intermediate merge: интерполируем веса обученной модели M₁ с исходной LLM M₀: M_r = α × M₁ + (1-α) × M₀. В тех репорте используют α=0.5, то есть 50/50 микс.

💚Фаза 2: продолженное обучение с низким LR для стабилизации

Результат из DrVoice такой: после merge и фазы 2 текстовые метрики восстанавливаются до 74.73.

Интересно, что в DrVoice для маленькой модели использовали α=0, то есть полный откат к исходной LLM (при этом аудио-энкодер, SRH и адаптеры сохраняют обученные веса). В Fun-Audio-Chat уже α=0.5, но авторы не показывают, как это влияет на метрики. Хотелось бы увидеть сравнение.

🐱 Чего не хватило

Авторы упоминают мульти-таск DPO стейдж для устойчивости к шумным аудио, instruct-following и voice empathy, но нет деталей. Ни таблиц, ни абляций. Для сравнения, их же статья 🔗Fun-ASR содержит куда больше подробностей про RL пост-тренинг.

Также авторы упоминают full-duplex версию, но я не разобралась, как она поддерживает параллельный аудио-стрим пользователя вместе с генерацией модели. Если кто разобрался, напишите пожалуйста, как устроена параллельная обработка входящего аудио?
  • ❤ 10
  • 👍 3
  • ✍ 2
  • 🍾 1
Post #164 799

Forwarded from max.sh

Год подходит к концу, поэтому самое время подводить итоги.

В этом посте разбираю одну из центральных тем блога в этом году: собеседования на ML/Research роли.

⚫️В первой половине года я много собеседовал и понял, что хочется делиться тем, что может помочь соискателям. Так появились эти тексты. Они разные по формату и теме, все субъективные и основаны на личном опыте. А теплые сообщения в личку о пользе текстов только мотивируют стараться ✨

Типы вопросов на собеседованиях про Трансформеры
Подборка ресурсов для изучения RL в контексте LLM
Лонгрид ML Breadth Interview Deep Dive

Как готовиться к Coding Interview
Как готовиться к ML Design Interview
Как готовиться к ML Depth Interview

Рисерч стажировки в биг техе. Часть 1. Как попасть на собеседование
Рисерч стажировки в биг техе. Часть 2. Структура Интервью

⚫️Потом я оказался по другую сторону и начал собеседоваться сам. Собесы – это во многом рандом, поэтому любая информация помогает хоть немного увеличить шансы в этой лотерее. А реальные отзывы других людей так тем более. Я начал собирать истории подписчиков канала и делиться ими здесь. В итоге получилась солидная коллекция интервью-историй за 2025 год.

Все отзывы можно найти по тегу #интервью. А здесь оставлю ссылки на истории в зарубежные компании:

🌐Research Engineer в Google DeepMind
🍏Senior ML Engineer в Apple Music
💻Performance Engineer в Nvidia, Munich
💻OpenAI, Solutions Architect, Generative AI Deployment, London
Ⓜ️ Senior ML Engineer в Meta
🖥 Research Fellowship в Anthropic
🛒Applied Scientist, Amazon
🎧 Senior DL Engineer в Spotify, Personalization, London

Senior ML Engineer в Waymo, Perception Team, California
Solutions Architect в ByteDance, Дубай.
VP of AI ML в J.P. Morgan Chase, London
AI Engineer в Mistral.AI

🔥 Буду рад если поддержите пост репостами или поделитесь с друзьями. И забирайте себе в коллекцию, если готовитесь к новому приключению в следующем году!
  • ❤ 12
  • 🔥 5
  • 👍 4
  • 🤯 1
  • 🍾 1
Post #163 991
✨ Meta выпустила 🔗SAM Audio, модель для open-domain audio separation. В отличие от классических сепараторов с фиксированными стемами (vocals/drums/bass/other), здесь можно изолировать произвольный звук

🎧 Архитектура

В основе flow matching модель на базе Diffusion Transformer (DiT). На вход подаем замиксованное аудио и промпты для изоляции. Промпты могут быть трёх типов:

1️⃣ Текстовый: описание звука текстом («dog barking», «woman speaking»). Текст обрабатывает T5-Base энкодер, фичи инжектятся через cross-attention

2️⃣ Визуальный: видео + маска объекта. Хотим изолировать голос конкретного спикера в кадре? Обводим его и модель понимает, чей звук вытаскивать. Обрабатывается с Perception Encoder vision (PE), как утверждают, сота среди визуальных энкодеров. Frame-level фичи конкатенируются с аудио по времени.

3️⃣ Временной (span): границы желаемого звука. Я сперва думала, что span нужен для вырезания кусочка аудио в качестве reference. Но нет, это последовательность токенов <sil> и «+» для каждого фрейма, а энкодер это просто learnable embedding table.

Во время тренировки промпты рандомно дропают, чтобы модель была устойчивой к разным сетапам.

😎 DAC-VAE вместо обычного DAC

Интересная часть для тех, кто работает с TTS. Про DAC-VAE можно подробнее почитать в с статье 🔗«Movie Gen: A Cast of Media Foundation Models», а код 🔗здесь.

Стандартный DAC (Descript Audio Codec) использует RVQ — дискретное пространство с кодеками. DAC-VAE это VAE-версия DAC (с компрессией 25Hz), из которой убрали RVQ квантайзер. Избегая потерь при квантизация, получают более качественную реконструкцию, чем Encodec.

Кажется, что сейчас realtime становится дефолтным сетапом, и адаптация DAC-VAE 25Hz для стриминга может быть непростой задачей. Тем не менее, интересно поработать с DAC VAE для генерации.

🐹 Про данные

За такими моделями всегда стоит огромная работа с данными. И вот что мне показалось полезным:

Текстовые промпты. Авторы используют PLM-Audio для генерации описаний. Затем описание и метадата идут в Llama 3, которая выбирает NP/VP фразы, описывающие звуковые события. Затем CLAP filtering (убирают сэмплы с text-audio similarity < 0.28).

Pseudo-labeling. Реальных данных мало, а синтетические миксы далеки от реалистичных. Авторы пошли по пути бутстраппинга, используя промежуточный чекпоинт SAM Audio для разделения аудио, которые потом отбираются через многоступенчатую фильтрацию, включая CLAP scores, VAD, Audiobox-aesthetics и другие шаги.

💪 Чем SAM Audio полезна на практике?

Модель большая и довольно медленная (16-step ODE + beam-size-8 reranking), и скорее подойдет для предобработки данных:
⏺Изоляция foreground speech от фоновой речи, шума, музыки
⏺Разделение male/female спикеров в диалоге (даже с пересечениями работает хорошо)
⏺Изоляция паралингвистики: вздохи, смех (хотя я потестировала на паре аудио из AMI и впечатление так себе)

С изоляцией конкретного голоса среди нескольких мужских (или женских) не справляется, даже с временным промптом и описанием «female speaker who starts speaking first». Среди речевых тренировочных данных преобладали 2-speaker диалоги, что и объясняет, почему multi-speaker сценарии работают хуже.

💡 Полезные модели из пайплайна

В статье упоминается несколько моделей, которые тоже интересны сами по себе:

AED PANNs: модель для audio event detection. В SAM Audio её используют для auxiliary alignment loss: выравнивают репрезентации MLP-головы DiT с эмбеддингами AED, чтобы помочь модели понять, что и где искать.

PEA-Frame: language-queried temporal localization. По текстовому описанию акустического события возвращает временные метки. В SAM Audio используют для генерации span промптов и (насколько я понимаю) для инференса тоже.

SAM Audio Judge (SAJ): оценщик качества сепарации. Используется и для evaluation, и как reranker при инференсе. Авторы заявляют значительно более высокую корреляцию с human ratings, чем CLAP.

🥹 Что думаете на счет DAC-VAE?
  • ❤ 13
  • 👍 8
  • 🔥 7
Post #162 998
Давно не было разборов. А все потому, что последние ~1,5 месяца я много собеседовалась.

🐹 В сумме прошла 28 интервью, включая HR-скрининги, технические этапы, два онсайта, один из которых — с исследовательской задачей и презентацией результатов в конце дня. Что из этого вышло и вышло ли расскажу позже, а пока впечатления именно о процессе поиска и подачи. Было стрессово, трудно, местами изнурительно 🌸

Искала вакансии в Европе и на удалёнке. В приоритете были американские стартапы и бигтехи с офисами в Европе, а также быстрорастущие европейские команды в области аудио, речи (ASR, TTS, speech-to-speech) и мульти-модальности. Может кому-то пригодится опыт.

По цифрам:
💌 ~46 заявок в 28 компаний
📞 11 приглашений на интервью
✔ 5 процессов до финальных этапов

Вроде неплохо, но тут важен контекст: я подавалась в компании, где мой опыт релевантен, не меняя сферу

❔ На какие позиции подавалась

Мне нравится моя позиция сейчас Applied Science. Так что подавалась на Applied Scientist, Applied ML Engineer, Research Engineer, в общем все вокруг прикладного ML, с фокусом на моделирование и прикладной ресерч

🔍 Как искала компании

1⃣ Многие интересные команды в аудио сейчас довольно заметны: они делают open source, публикуют статьи, релизят сильные коммерческие модели. Из таких компаний я составила список и регулярно его пополняла (Mistral AI, ElevenLabs, Black Forest Labs, HeyGen, ...)

2⃣ Лидерборды по ASR и TTS, чтобы понимать, какие команды сейчас успешно трудятся над этими задачами (TTS Arena, STT бенчмарки)

3⃣ B2B-стартапы в аудио мне были знакомы чуть хуже, поэтому часть компаний находила через startup.jobs.

4⃣ Мониторила ленту в LinkedIn, особенно подборки AI-стартапов и компаний, которые активно растут. Отдельно замечу: в Q4 рекрутеры стали писать заметно активнее, часть интервью пришла именно оттуда.

💌 Как подавалась

Раз в неделю проверяла карьерные порталы компаний из моего списка. Подавалась напрямую через сайты, часто сразу на несколько релевантных позиций.

Рефералка была одна. Когда долго не было ответа от компании, нашла в LinkedIn менеджера смежной команды и написала ➡получила рефералку ➡процесс ускорился. Впечатление такое, что рефералки всё ещё работают, НО если они от члена нанимающей или смежной команды. Иначе влияние заметно меньше.

Перед подачами серьёзно переработала резюме (все главные проекты описаны кратко, с цифрами, в порядке импакта и значимости). Гайдов по тому как составлять резюме довольно много.

В большинстве компаний при подаче нужно либо ответить на вопросы («Почему хотите к нам?», «Главное достижение за год?»), либо написать cover letter. И тут важно было продумать ответы под каждую компанию, изучить их продукт, ценности, и подумать, а что я могу им предложить. По ощущениям, этот этап влияет на конверсию не меньше, чем резюме. Да, это все непросто и требует времени и вовлеченности.

💻 Этапы интервью

В бигтехах процессы стандартизированы: ML system design, ML coding (1–2 этапа), algorithmic coding (обычно 2 этапа), специализированные ML-интервью по фокусу команды, плюс разговор с hiring manager.

В стартапах форматы менее предсказуемы. По моим впечатлениям, там сильный упор на ML coding и практические задачи даже на senior-позициях. System design почти всегда привязан к реальным задачам команды.

Готовиться я начала заранее, где-то за 2 месяца к алгоритмам (это моя ахиллесова пята), просто решала почти каждый день по 2-3 задачи, за месяц начала повторять ML coding. К ML system design готовилась немного по книге "Generative AI System Design Interview", но здесь больше помог имеющийся опыт, также полезно если ориентироваться в статьях, sota архитектурах, ведь в статьях пишут и про пайплайны подготовки данных, и про челленджи в тренировке, и про метрики (все релевантно для system design).

🥹 Что из всего этого вышло расскажу отдельно. А пока интересно: кто ещё проходил собесы в этом году? Какие у вас впечатления от рынка?
  • ❤ 28
  • 🔥 11
  • 👏 6
  • 🍾 4
  • 👍 2
  • 🥱 1
  • 💔 1
Post #161 1.22K
Генерация речи с LLM задача нетривиальная, мы тренируем модель воспроизводить наиболее вероятную последовательность аудио / речевых токенов; но это усреднение часто ведет к плоским ненатуральным интонациям, эмоциям и паузам, множеству артефактов. 💃 И здесь RL как раз неплохо вписывается, дает возможность вознаграждать разборчивость, и не поощрять непонятную речь

Если вам интересно попробовать RL post-training для TTS на практике, вот хороший пост-tutorial и репозиторий с кодом.

Что тут происходит?

🌸Архитектура: TTS модель Llasa, на базе Llama-3.2 1В с X-codec-2 токенизатором

🪻Вдохновением стала вот эта статья: 🔗GROUP RELATIVE POLICY OPTIMIZATION FOR TEXT-TO-SPEECH WITH LARGE LANGUAGE MODELS

🍀Подход: GRPO с композитным ревордом, оценивающим качество синтетической речи через ASR word error rate (WER) и negative log likelihood на транскрипции. То есть оценивается разборчивость речи через WER и то, насколько для ASR модели вероятна референсная транскрипция при данном синтетическом аудио. В качестве ASR оценщика взяли Whisper-large v3

Бенчмарков нет, по оценке автора генерация стала стабильнее и улучшились интонации. Но… из-за вознаграждения за WER, модель стала синтезировать очень быструю речь, особенно если в промпте длинный текст. Это side-effect скорее всего проявился из-за того, что при фиксированной длине output’а модель пытается успеть произнести как можно больше

Чуть ранее другой автор проводил схожий эксперимент (🔗пост). Он натренил немецкую TTS SmolKartoffel-135M 😄 на базе SmolLM2 с почти таким же сетапом — GRPO с Whisper ASR ревордом.

Одной из проблем его бейзлайн модели было 🍔«зажевывание пластинки», когда модель застревала на повторении одних токенов. Так вот, post-training помог, но также как и в первом случае привел к довольно сильному ускорению речи.

В общем, если есть парочка свободных GPU, то можно поэкспериментировать с RL. Думаю, есть смысл попробовать разных ASR оценщиков, и лучше даже не самые мощные robust модели, чтобы усилить обучающий сигнал на аудио с артефактами. И как-то нужно контролировать скорость речи.

🐱 А какие у вас есть идеи по улучшению этого сетапа?
huggingface.co Llasa Goes RL: Training LLaSA with GRPO for Improved Prosody and Expressiveness A Blog post by Steven Zheng on Hugging Face
  • 🔥 9
  • ❤ 7
  • 👍 4
  • 🍾 1
Post #157 1.15K
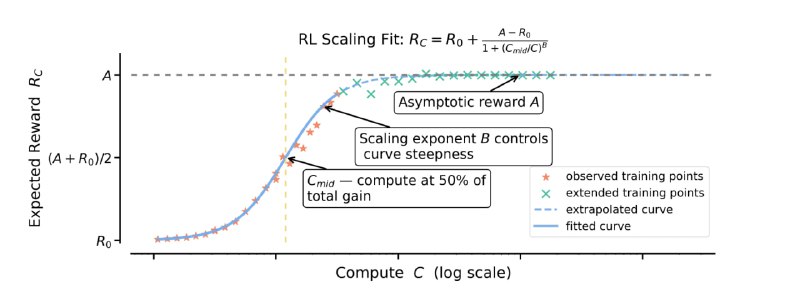
В далеком 2020 году вывели степенные законы масштабирования для pre-training. Теперь команда Meta (и партнеры из академии) попытались сделать то же самое для RL

🔗«The Art of Scaling RL Compute for LLMs» показывает, что это предсказуемая сигмоида и предлагает ScaleRL рецепт стабильного RL проверенный на 100k GPU‑часов

😑 Почему не power law, а sigmoid?

В отличие от pre-training, где cross-entropy loss следует степенному закону, в RL метрики обычно ограничены сверху (accuracy, pass@k) и ведут себя как sigmoid. Логично: в начале модель исследует пространство, учится базовым навыкам, рост медленный. Затем наступает начинает собирать атомарные навыки в сложные стратегии, и точность взлетает. Ближе к потолку прогресс снова замедляется, образуя S-кривую.

Зачем это нужно? 💵 Чтобы на малом compute 10k GPU-часов предсказать, что будет на 100k, и не тратить бюджет на алгоритм, который рано упрется в потолок

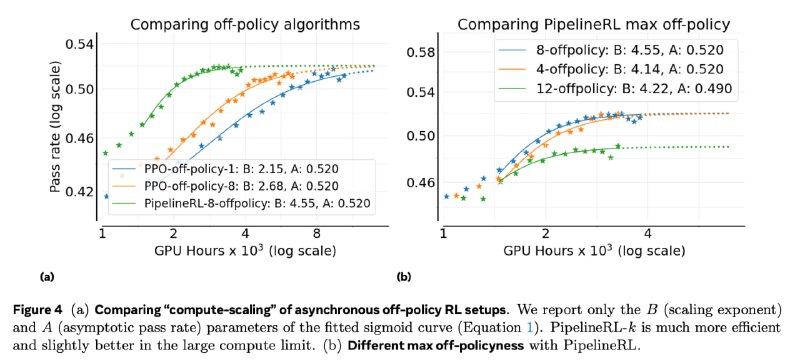
Авторы выяснили, что компоненты рецепта влияют на два параметра: асимптотический потолок (достижимая точность) и крутизну кривой (скорость обучения)

А теперь три самых важных параметра в RL тренировочном рецепте:

💪 Pipeline-RL off-policy архитектура

Обычный PPO синхронный. Генераторы создают роллауты, ждут, пока тренирующиеся обновят веса, получают новые веса, повторяют. Получается, что половину времени кто-то ожидает

А вот PipelineRL‑k стримит роллауты и делает на лету обновление весов генераторам даже посреди генерации последовательности (со старым KV‑кэшем); тренирующиеся инстансы ждут, если ушли вперёд более чем на k шагов. При схожей верхней асимптотике PipelineRL‑k значительно ускоряет обучение

🕺 Loss функция: CISPO vs DAPO

Сравнили лоссы основанные на GRPO: DAPO (GRPO с asymmetric DAPO clipping) CISPO (из Minimax) и GSPO. И вот у DAPO верхнюю границу оценили гораздо ниже (см. картинку), что критично на практике

GRPO в свое время запустил всю эту волну reasoning моделей (см. картинку). Идея такая: давайте избавимся от critic model и будем считать для каждого сэмпла advantage в зависимости от того, какой реворд он получил относительно всех других кандидатов в группе.

Последующие работы документировали недостатки алгоритма. Например была такая тема с fork токенами ("однако", "но", "следует", …), которые в базовой модели получали низкую вероятность, но они важны в рассуждениях и в RL получают высокий реворд, а из-за clipping’а не могут особо повлиять на тренировку и сдвинуть output distribution в верном направлении

CISPO возвращается к REINFORCE, но клипает только importance sampling ratio, оставляя градиент по самим токенам: sg(clip(π_new/π_old, ε)) × Â. Stop-gradient делает это коэффициентом. GSPO в отличие от GRPO (и DAPO) переходит к importance sampling на уровне всей последовательности и стабильнее на длинных ответах

❕FP32 для LM головы

FP32 precision для LLM лоджитов. Это третий столп стабильного RL. Проблема в том, что генераторы и тренирующиеся используют разные compute kernels, к небольшим численным отличия в лоджитах. В importance sampling расхождения дестабилизируют, а FP32 для финального слоя почти устраняет проблему

Авторы вывели рецепт самых «оптимальных решений для RL». Там множество трюков: исключение промптов, где все генерации имеют одинаковый реворд, форсирование ответа на длинных цепочках и др.

Так как эксперименты ограничены проверяемыми задачами с бинарным ревордом (математика, кодинг), то я бы пока просто приняла к сведению идеи. Непонятно, будет ли ScaleRL скейлиться на непроверяемых задачах, например prosody в TTS, мало абляций на downstream задачах.

На мой взгляд инсайт в том, что алгоритмические выборы значительно влияют не только на скорость, но и на потолок реально достижимой производительности; а в совокупности составляют мощный рецепт, где влияние каждого отдельного выбора уже не ломает систему

😎 P.S.: О precision в RL давно спорят, в x идет движ по этой статье. Предлагают переходить с bf16 на fp16. Оба типа занимают 16 бит, но fp16 аллоцирует больше бит под мантиссу, дает большую точность (при меньшем диапазоне) и помогает избежать коллапса тренировки
  • ❤ 8
  • 👍 5
  • 🔥 2
Post #156 962
Хороший пост от разработчика PyTorch с обзором внутреннего устройства фреймворка

пост 2019 года, так что некоторые детали уже эволюционировали (слияние Variable/Tensor уже случилось, например), но ментальные модели про тензоры, страйды, автоград и путь вызова — это всё ещё актуально, мне понравилось

🔗 https://blog.ezyang.com/2019/05/pytorch-internals/
  • ❤ 10
  • 🔥 7
  • 👍 6
Post #154 1K
🐹 ARC-Encoder от Kyutai: plug-and-play компрессия для LLM

На прошлой неделе вышла крутая статья от Kyutai Labs (да, я им симпатизирую): 🔗ARC-Encoder learning compressed text representations for large language models

Почему-то осталась относительно незамеченной, хотя на мой взгляд работа хорошо сделана и достойна deep-dive чтения. Как уже видно из названия, эта статья даже не про TTS & STT, здесь авторы придумали универсальный энкодер для сжатия длинных контекстов в LLM'ках в х4-8 раз практически без потерь качества ответов на различных downstream задачах (QA, text summarization, перевод), включая ICL

ARC-Encoder сжимает контекст в короткую последовательность эмбеддингов, которые напрямую подставляются в LLM декодер (после embedding layer), при этому саму LLM не до-обучают❕. И в дополнение, ARC-Encoder можно легко адаптировать к нескольким разным декодерам через небольшие MLP модули

🍅 Немного про context compression

LLM-пайплайны (RAG, multi-document QA) нуждаются в длинных контекстах. Но pre-fill на длинных промптах стоит дорого и быстро упирается в лимиты контекстного окна. Можно просто дропнуть наименее важные токены, или кратко суммаризировать промпт. Это hard compression. Альтернативный подход, soft compression, подразумевает извлечение смысловых эмбеддингов из пассажей контекста (инструкции промпта или документы). Часто такие методы также подразумевают fine-tune LLM декодера, ведь ему нужно еще научиться использовать эти сжатые репрезентации. ARC-Encoder же тем хорош, что никак не трогает decoder LLM, таким образом модель никак не будет менять своего поведения на других задачах 💲🤩


☕️ Архитектура

⭐️В недавней работе (тут) показали, что LLM декодер можно успешно использовать для компресси текста. Поэтому авторы взяли за основу LLaMA‑3.2‑3B, убрав output head и cаusal mask (чтобы энкодер видел весь контекст сразу, а не только влево)

⭐️Поверх последнего self-attention блока применяют pooling (average) с фактором сжатия от 4 до 8, но только для queries, в то время keys & values остаются полноразмерными. Авторы пишут, что пробовали пулить на разных слоях, но эффективнее всего на последнем, что логично, репрезентации на последнем слое семантически богаче

⭐️Далее MLP слой (без активации🌸) отображает encoder outputs в размерность латентного пространства LLM. Получившиеся эмбеддинги просто подставляются в латентное пространство LLM декодера (на вход transformer layers)

Как и что тренили?

1️⃣ Pre-training на Common Crawl на двух задачах (см. картинку): реконструкция последовательности (а) и продолжение последовательности (б), что оказалось критично, так как это по сути та же задача, что и любой downstream task

2️⃣ Fine-tuning делали на миксе синтетических и реальных QA, summarization и др. датасетах. При этом сжатые эмбеддинги перемежаются с обычными токенами, что сохраняет few-shot способности модели

Понравился оценочный сетап. Модели‑декодеры: Llama‑3.1‑8B и Mistral‑7B (base). Бейзлайны авторы ре-имплементили сами на базе тех же декодеров, данных и задачах. Дополнительно оценили open book (весь промпт вместе с документами для QA у модели в контексте) и closed book сетапы. Тренировочные сеты бенчмарков предусмотрительно не включали в тренировки.

🟣На всех бенчах context compression ARC держится близко к open‑book на Llama‑3.1‑8B и обгоняет closed‑book и большинство бейзлайнов; на Mistral‑7B отставание от open‑book небольшое, что ожидаемо (архитектурно декодер Mistral дальше от Llama-3.2 энкодера)

🔴Также круто: удалось увеличить эффективнй контекст Llama2-chat с 4 до 32k обогнав по некоторым метрикам Llama2-32k Instruct (специально до-трененную на длинных последовательностях)

🥹 А что же дальше?

На мой взгляд вся идея хорошо ложится на речевые и аудио модели, в которых проблема длинных контекстов стоит еще острее. Как думаете, является ли эта работа своего рода proof of concept и увидим ли мы эту идею в следующем Moshi? Также интересно, как далеко можно зайти с multi-decoder подходом: один универсальный энкодер для сжатия + мини адаптеры под каждую LLM
  • ❤ 10
  • 👍 4
  • 🔥 1
Post #150 1.13K
Microsoft предлагает использовать speech-LLM для оценки качества синтетической речи. Идея практичная, стандартные протоколы типа MOS и A/B тестов трудозатратны, а на выходе получаем оценку без качественных инсайтов, что именно пошло не так

🔗SpeechLLM-as-Judges: Towards General and Interpretable Speech Quality Evaluation

🐯 SQ-LLM

Авторы собрали датасет SpeechEval: 32к аудио (реальных и синтетики, включая коммерческие TTS), 128к аннотаций на 4 языках (en/zh/ja/fr). Аннотации включают оценки по 8 измерениям: overall quality, intelligibility, distortion, speech rate, dynamic range, emotional impact, artistic expression, subjective experience, а также развернутое текстовое описание «что не так».

Модель SQ-LLM на базе Qwen2.5-Omni-7B. Файн-тьюн LLM через LoRA, аудио энкодер не трогали. Обучали на 4: speech quality assessment (краткий текстовый разбор по 8 измерениям), парные сравнения A/B по тем же аспектам, генерация советов по улучшению, и детекция дипфейков.

Добавили CoT (это самое важное): модель предсказывает сами численные оценки по 8 измерениям ❕(см. картинку), затем текстовое описание и итоговый скор

Эксперименты в статье не совсем убедительны. Но есть все же несколько инсайтов 🌸

🌀Без доп. файн-тюна все speech-LLM дают слабую корреляцию с человеческими оценками (zero-shot не в деле). Эмерджентности не наблюдается, speechLLM, обычно крайне чувствительны к out-of-domain задачам. ‼️ Между их SQ-LLM и их же кастомными бейзлайнами (Whisper+Qwen3-8B, WavLM+Qwen3-4B) большой разницы тоже не вижу...

😎Чтобы быть хорошим судьей, не нужно уметь генерить речь, важно глубоко понимать акустические характеристики. Бейзлайны с Whisper в среднем опережают остальных (особенно на deepfake detection), что подсказывает важность мощного энкодера. Было бы интересно проверить, даст ли до-обучение энкодера с головами предсказания отдельных метрик бОльший буст

🐈CoT улучшает метрики, логично: 8 промежуточных численных предсказаний дают модели доп. сигналы помимо текста. Это мотивирует модель выучить отдельно факторы влияющие на качество и численно их оценивать, подкрепляя ответ. Полагаю, CoT еще снижает кол-во связных и красивых, но фактически некорректных формулировок

RL в виде GRPO даёт прирост по всем задачам, особенно на детекции дипфейков: модель достигает EER 6.2% и точности 89.4% против 15-18% у спец. систем типа RawNet2 (EER 15.84%, ACC 72.04%)

В своих проектах пришла к похожим выводам: учим LLM’ку извлекать и предсказывать количественные и качественные характеристики аудио внутри цепочки CoT (даже те, которые лишь косвенно связаны с down-stream) — получаем лучшее качество на основной задаче. Правда, это лишь мое эмпирическое наблюдение.


Что не понравилось в статье 😭

🟡Система якобы решает проблему интерпретируемости, но ни одного человеческого исследования нет, было бы круто прогнать на какую-нибудь TTS и проанализировать отзывы модели

🔴SQ-LLM показывает, что speech-LLM можно адаптировать для оценки качества речи со средней точностью.. Pearson correlation 0.476 на оценке качества это скромно (хотелось бы 0.7+). Точность 67% в парных сравнениях, что всего на 17 п. выше угадывания

🟡Непонятно, как файн-тюнили кастомные бейзлайны: была ли LoRA, был ли CoT? Не хватает сравнения разных аудио-энкодеров и LLM-декодеров

Самое главное: датасет не выпущен. Авторы собрали ценный ресурс, 128к качественных аннотаций, но пока не зарелизили

Выводы?

Я все еще скептически отношусь к LLM as a judge. Но для частичной автоматизации оценивания, почему бы и нет, например, чтобы выловить сложные примеры и углубиться в их анализ уже вручную.

P.S.: В этом году вела проект аннотации данных: подготовка, дизайн UI, правила для аннотаторов, обработка edge cases. Впечатление, что компании, специализирующиеся на данных, уже чаще вовлекают людей только для проверки и исправления ошибок ML пайплайнов. Это оптимизация и ускорение, но критически важна due diligence аннотаторов, не кликнуть на «тут все верно, идем дальше», если есть ошибки

Пока дописывала пост, релизнули 🔗OmniVinci. Идём читать 🤓
  • ❤ 7
  • 👍 6
  • ✍ 3
  • 🔥 2
Post #149 848
Летом вышла HRM, модель на 27М с «биологически вдохновленной иерархией» и 32% на ARC-AGI. У нас тут был обзор на deep-dive от ARC-AGI, где показали, что эта самая иерархия не так и нужна

В комьюнити HRM уже успели покрутить, и вышел еще разбор, из которого про модель я узнала больше, чем из оригинальной работы. А следом Tiny Recursion Model, в которой отбросили всю сложность HRM

🔗HIERARCHICAL REASONING MODELS: PERSPECTIVES AND MISCONCEPTIONS
🔗Less is More: Recursive Reasoning with Tiny Networks

🤔 Что не так с RNN

RNN страдают от BPTT. Vanishing gradients возникают из-за того, что hidden state h_t зависит от всех предыдущих состояний. Чтобы посчитать градиент для h_0, нужно пройти через все промежуточные h_t. Градиент превращается в произведение якобианов, и при длине последовательности в сотни шагов испаряется.

В трансформерах каждый токен смотрит на весь контекст через self-attention. Параллелизация вычислений, стабильные градиенты. Недостаток в квадратичной сложности по длине последовательности и в фиксированной архитектурно «глубине обдумывания» каждого токена (кол-во слоев).

А ведь рекуррентность имеет смысл. ❗️Возможность «обдумать» входные данные несколько раз, уточняя ответ — хорошая стратегия, чего не хватает трансформерам.

❔ HRM напоминает диффузию?

HRM перенесла рекуррентность в латентное пространство. Вместо обновления hidden state по токенам, модель итеративно уточняет латентное представление z всего ответа.

В обучении HRM использует one-step gradient через Implicit Function Theorem: градиенты считают только для последних двух итераций рекурсии. Память получается константной.

Это похоже на диффузию. Там модель учится из зашумленного x_t воспроизводить чистый x_0, обучаясь на парах (x_t, x_0) независимо. Рекурсия (постепенное убирание шума) появляется только на inference. HRM делает концептуально похожее: учится улучшать ответ с любого промежуточного состояния

😐 Deep supervision

Команда ARC Prize тогда еще обнаружила, что deep supervision даёт ~+20% на ARC-AGI бенче. Что это значит? Обычно модель получает feedback только в самом конце: правильное ли решение. А с deep supervision модель получает feedback на промежуточных шагах. HRM делает 16 итераций уточнения (внутри каждой еще несколько итераций L-модуля без градиентов), и на каждой модель учится: первая итерация — первая попытка, последняя улучшает финальный ответ.

Помимо этого, HRM предполагает, что рекуррентный процесс достигает fixed point (где дальнейшие итерации ничего не меняют), и на этом основании использует упрощенный расчет градиентов. Но абляции показали, что модель по факту не достигает этой точки. Формула для градиентов работает не совсем корректно, и модель учится на неточных сигналах.

Механизм Adaptive Computation Time (ACT) тоже вызвал вопросы. В оригинальной статье Q-head предсказывает, когда остановить уточнение через Q-learning (Q_halt vs Q_continue). Но на практике максимальное число шагов всегда даёт лучший результат, что ставит под сомнение адаптивность.

😐 Tiny Reasoner Model

Авторы TRM просто начали удалять компоненты HRM, проверяя абляциями

Убрали H-модуль, оставили только L. Это согласуется с наблюдениями ARC-AGI.

Два слоя вместо восьми. Уменьшили глубину с 4+4 слоёв до 2 слоёв. Логично, что на датасете из ~1000 примеров, маленькие сети лучше генерализуются

Возвращение к полному BPTT вместо приближения. Это главное, пожалуй. Да, тут память растёт линейно с числом шагов, но сеть очень маленькая (2 слоя). В результате (вместе с заменой Attention на MLP) +30.9% на задаче Sudoku по сравнению с HRM

Выводы?

Рекуррентность пытаются возвращать. В виде итеративных обновлений в латентном пространстве, с deep supervision и адаптивной глубиной вычислений

🟠RNN рекуррентны во времени (токен → токен)

🔴Universal Transformer рекуррентен по глубине: один и тот же блок повторяется для всех позиций, иногда с ACT-остановкой

🔴HRM/TRM рекуррентны в латентном пространстве: есть состояние, которое итеративно уточняется

Как думаете, есть будущее у этого подхода? Будет ли масштабироваться с ростом количества данных?
  • 👍 6
  • ❤ 3
  • 🔥 2
Post #148 695
🐈Learning is not supposed to be fun

Карпатый зарелизил новый репозиторий для обучения LLM’ок с нуля — 🔗nanochat

It weighs ~8,000 lines of imo quite clean code to:

- Train the tokenizer using a new Rust implementation

- Pretrain a Transformer LLM on FineWeb, evaluate CORE score across a number of metrics

- Midtrain on user-assistant conversations from SmolTalk, multiple choice questions, tool use.

- SFT, evaluate the chat model on world knowledge multiple choice (ARC-E/C, MMLU), math (GSM8K), code (HumanEval)

- RL the model optionally on GSM8K with "GRPO"

- Efficient inference the model in an Engine with KV cache, simple prefill/decode, tool use (Python interpreter in a lightweight sandbox), talk to it over CLI or ChatGPT-like WebUI.

- Write a single markdown report card, summarizing and gamifying the whole thing.


С какими еще техниками можно тут поупражняться:

⏺Архитектура — упрощенная Llama
⏺Rotary Embeddings, QK Normalization, Multi-Query Attention (MQA)
⏺ReLU² активации, logit softcapping
⏺Muon+AdamW из modded-nanoGPT

Ресурсы: ~4 часов 8XH100

В общем, берем на заметку🙌

🔗https://github.com/karpathy/nanochat
GitHub GitHub - karpathy/nanochat: The best ChatGPT that $100 can buy. The best ChatGPT that $100 can buy. Contribute to karpathy/nanochat development by creating an account on GitHub.
  • ✍ 8
  • ❤ 4
  • 🔥 4
Post #145 1.03K
🎧 Align2Speak: TTS для мало-ресурсного языка на 30 минутах аудио

Статья о том, как прокачать синтез речи для мало-ресурсных языков. Авторы показывают, что даже на 30 мин парных данных (аудио & текст) можно получить качественный TTS с помощью GRPO post-training.

🔗Align2Speak: Improving TTS for Low Resource Languages via ASR-Guided Online Preference Optimization

Статья понравилась, потому что идея простая и прикладная (разбирать что-то сложное пока нет времени). Ну и интересно все, что связано с бутстрэппингом на новые языки. Это, кстати, продолжение 🔗Koel-TTS (NVIDIA) от той же команды.

💻 Архитектура

Здесь у нас encoder-decoder из Koel-TTS. Не самое современное решение на фоне диффузионок, но надёжное и показывает хорошие результаты при ограниченных данных.

Текст, что нужно озвучить, проходит через NAR text encoder, затем AR transformer decoder получает аудио-токены референсного голоса в контекст и через cross-attention считывает текстовые представления. Декодер оперирует только аудио-токенами, ему не нужно учить мульти-модальность, что выгодно для мало-ресурсных сценариев. Такая архитектура была признана оптимальной в Koel-TTS, так как перенос голоса через контекст сработал лучше, чем через spk embedding. На каждом шаге модель параллельно генерит все токены кодбуков 🔗Nanocodec.

Базовая модель построена на IPA токенах (International Phonetic Alphabet). Это универсальные фонетические представления, позволяют модели выучить относительно независимый от языка мэппинг между звуками и речевыми токенами.

😑 Как адаптировали к новому языку?

Базовая TTS натренена на ~21к часов речи, где ~18к это англ, а все остальное европейские языки (German, Dutch, Spanish, French). Затем адаптировали к польскому, португальскому и хинди — трём языкам, которых модель не видела.

1⃣ Fine-tune на миксе пре-трейна и 30 минут - 5 часов нового языка
2⃣ GRPO (Group Relative Policy Optimization) с композитным reward из трёх сигналов: Character Error Rate (Whisper-v3-large), Speaker Similarity (TitaNet embeddings) и PESQ

При генерации вариантов для GRPO на 50% примеров включили CFG (Classifier-Free Guidance)

🤔 Результаты

Авторы оценивали по четырём метрикам: Intelligibility (CER от того же Whisper-v3-large), Speaker Similarity (TitaNet), Audio Quality (PESQ), Naturalness (Squim-MOS).

🐹 GRPO дает стабильные приросты, особенно в разборчивости (например, на португальском с 30 мин данных FT + GRPO CER падает с 33% до 3.94%). Конечно, использование whisper и в reward, и в оценке создаёт определённый bias, ведь мы учим модель подстраиваться под ASR (и ее галлюцинации). Но фреймворк гибкий, компоненты reward можно заменить под ваш сетап.

🐹 И даже без fine-tune на целевом языке, только через GRPO, модель значительно улучшает разборчивость. Даже на хинди, который сильно далёк от европейских языков в пре-трейне (54%➡32.6%). Модель не видела реальных пар текст-аудио, но научилась генерить внятную речь. Думаю, что во многом благодаря IPA, дают универсальную инициализацию.

🐹 На английском (high-resource язык из пре-трейна) тоже получили заметные улучшения после GRPO (лучше DPO). То есть метод работает не только для адаптации, но и для общего улучшения качества.

А чем бы вы заменили whisper? А еще, пробовали ли CFG в TTS?
  • ❤ 12
  • 👍 2
  • 🔥 2
Older posts →

About this channel

How can I read @applied_scientist_blog without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Ученый без степени | AI-блог Ани: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Ученый без степени | AI-блог Ани have?
Ученый без степени | AI-блог Ани (@applied_scientist_blog) has 834 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Ученый без степени | AI-блог Ани know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →