
Hierarchical Reasoning Model (HRM) — моделька всего на 27M параметров, которая в начале лета привлекла внимание в AI сообществе. Причина такая: будучи крошечной по нынешним меркам, она набрала 41% на ARC-AGI. Меня такой результат тоже впечатлил, но статья так и лежала в бэклоге. Я думала, что авторы просто заоверфитили на задачи из теста.
Команда ARC-AGI поисследовала модель и причины ее мощного перфоманса, и запостила выводы в статье 🔗The Hidden Drivers of HRM's Performance on ARC-AGI, которые мне показались интересными и важными, так что статью прочитала
🧩Коротко про ARC‑AGI
Это визуальные пазлы на цветных клетках (типо цветного тетриса), где нужно вывести правило из 2–3 примеров и применить его к новому вводу. Для людей это тривиально, для моделей долгое время было сложнаа. Прогресс в CoT и in-context learning позволил LLM’кам научиться решать эти головоломки, но результаты оставались скромными. И тут появляется моделька на 27М и показывает 41% (32% на semi-private). По лидерборду видно, что из НЕ ризонинг моделей выше 30% почти никто не поднялся.
🤔 Как работает HRM
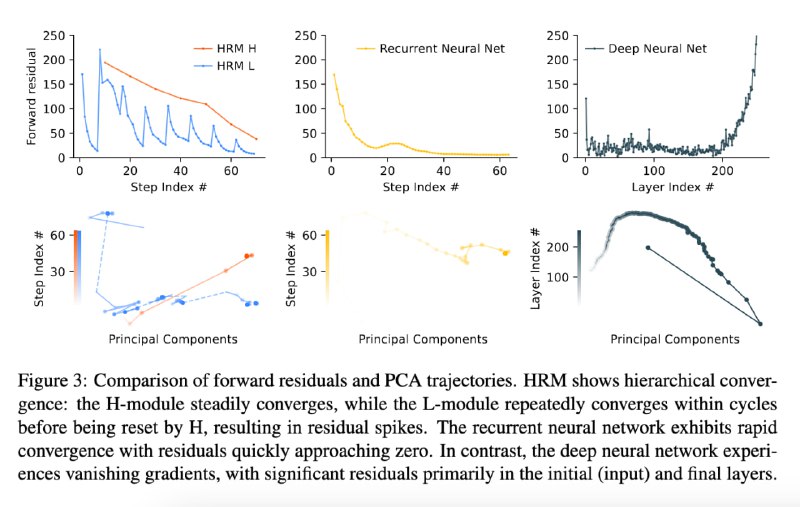
Архитектура HRM действительно интересная. Авторы вдохновлялись структурой мыслительных процессов человека (напоминает "Thinking, Fast and Slow" Канемана). У модели два модуля: High и Low — это два небольших трансформера. Low модуль итеративно обрабатывает задачу, обновляя своё внутреннее состояние и улучшая предсказание с каждой итерацией. High модуль включается только каждые T шагов, задавая общую стратегию, которую затем исполняет Low модуль.
Внешне это напоминает RNN, но с важным отличием. Обычные RNN быстро сходятся к решению, и поздние итерации почти не влияют на результат. HRM продолжает активно "размышлять" и обновлять ответ на протяжении всего процесса благодаря двухуровневой рекурсии (см. картинку)
Важно, что HRM это не языковая модель в привычном смысле. Она не генерит рассуждения на естественном языке. Получив пазл в виде цветной сетки, она проецирует его в пространство эмбеддингов и работает с латентными представлениями.
Команда ARC Prize перепроверила и подтвердила рез-ты HRM на скрытых задачах. Но «общий интеллект» это пока не про нее, и вот почему:
🔍 Архитектура HRM не так критична, как казалось. Когда обычный трансформер с тем же количеством параметров поместили в тот же пайплайн обучения, разница составила всего около 5 пунктов. Особенно интересно, что при одной итерации внешнего цикла производительность моделей была практически одинаковой
🌀 Внешний цикл уточнения (outer loop) — это ключевое. Переход от одной итерации к двум даёт прирост в 13 пунктов (!) А увеличение до 8 итераций удваивает производительность
🐈Большая часть результата приходит от обучения именно на задачах, по которым потом тестируется модель. Если учить только на этих evaluation‑тасках (с аугментациями), метрика падает совсем немного. Это ближе к «test‑time training», чем к универсальному интеллекту
😳 И это важное ограничение. HRM использует puzzle_id вместо few-shot контекста. Каждый пазл получает уникальный идентификатор, который модель связывает с нужной трансформацией. Это привязывает её к конкретным типам задач, которые она видела при обучении. Поэтому авторы включили демонстрационные примеры из тестовых данных в тренировку — не сами тесты, но типы задач.
Вообще, думаю, что ARC-AGI — это не самая подходящая задача для HRM. А вот длинные пазлы, по типу лабиринтов и судоку — именно то, где HRM раскрывает, так сказать, свой потенциал. А еще думаю, где бы применить подобный подход в аудио? Может, для улучшения сегментации/выравнивания в ASR? Какие у вас мысли?
☕ Что еще почитать и посмотреть:
🌸Схожая идея — zero-pretraining test-time training
🪻Неплохое видео с разбором HRM
🐱 P.S.: В следующем посте хочется уже про speech & audio — накопилось много интересного. А ещё на этой неделе я в Роттердаме на Interspeech 2025 🎉 уже составила себе расписание на два дня. Если кто-то тоже там и хотели бы пообщаться — пишите
Post #73
813


- ❤ 11
- 🔥 5
- 👍 3