



🔗«The Art of Scaling RL Compute for LLMs» показывает, что это предсказуемая сигмоида и предлагает ScaleRL рецепт стабильного RL проверенный на 100k GPU‑часов
😑 Почему не power law, а sigmoid?
В отличие от pre-training, где cross-entropy loss следует степенному закону, в RL метрики обычно ограничены сверху (accuracy, pass@k) и ведут себя как sigmoid. Логично: в начале модель исследует пространство, учится базовым навыкам, рост медленный. Затем наступает начинает собирать атомарные навыки в сложные стратегии, и точность взлетает. Ближе к потолку прогресс снова замедляется, образуя S-кривую.
Зачем это нужно? 💵 Чтобы на малом compute 10k GPU-часов предсказать, что будет на 100k, и не тратить бюджет на алгоритм, который рано упрется в потолок
Авторы выяснили, что компоненты рецепта влияют на два параметра: асимптотический потолок (достижимая точность) и крутизну кривой (скорость обучения)
А теперь три самых важных параметра в RL тренировочном рецепте:
💪 Pipeline-RL off-policy архитектура
Обычный PPO синхронный. Генераторы создают роллауты, ждут, пока тренирующиеся обновят веса, получают новые веса, повторяют. Получается, что половину времени кто-то ожидает
А вот PipelineRL‑k стримит роллауты и делает на лету обновление весов генераторам даже посреди генерации последовательности (со старым KV‑кэшем); тренирующиеся инстансы ждут, если ушли вперёд более чем на k шагов. При схожей верхней асимптотике PipelineRL‑k значительно ускоряет обучение
🕺 Loss функция: CISPO vs DAPO
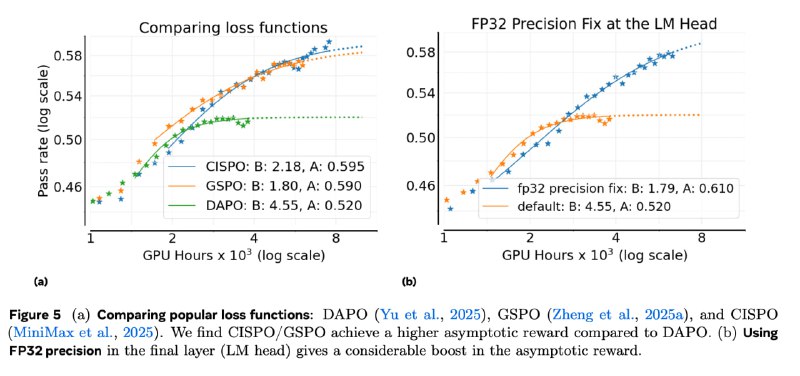
Сравнили лоссы основанные на GRPO: DAPO (GRPO с asymmetric DAPO clipping) CISPO (из Minimax) и GSPO. И вот у DAPO верхнюю границу оценили гораздо ниже (см. картинку), что критично на практике
GRPO в свое время запустил всю эту волну reasoning моделей (см. картинку). Идея такая: давайте избавимся от critic model и будем считать для каждого сэмпла advantage в зависимости от того, какой реворд он получил относительно всех других кандидатов в группе.
Последующие работы документировали недостатки алгоритма. Например была такая тема с fork токенами ("однако", "но", "следует", …), которые в базовой модели получали низкую вероятность, но они важны в рассуждениях и в RL получают высокий реворд, а из-за clipping’а не могут особо повлиять на тренировку и сдвинуть output distribution в верном направлении
CISPO возвращается к REINFORCE, но клипает только importance sampling ratio, оставляя градиент по самим токенам:
sg(clip(π_new/π_old, ε)) × Â. Stop-gradient делает это коэффициентом. GSPO в отличие от GRPO (и DAPO) переходит к importance sampling на уровне всей последовательности и стабильнее на длинных ответах❕FP32 для LM головы
FP32 precision для LLM лоджитов. Это третий столп стабильного RL. Проблема в том, что генераторы и тренирующиеся используют разные compute kernels, к небольшим численным отличия в лоджитах. В importance sampling расхождения дестабилизируют, а FP32 для финального слоя почти устраняет проблему
Авторы вывели рецепт самых «оптимальных решений для RL». Там множество трюков: исключение промптов, где все генерации имеют одинаковый реворд, форсирование ответа на длинных цепочках и др.
Так как эксперименты ограничены проверяемыми задачами с бинарным ревордом (математика, кодинг), то я бы пока просто приняла к сведению идеи. Непонятно, будет ли ScaleRL скейлиться на непроверяемых задачах, например prosody в TTS, мало абляций на downstream задачах.
На мой взгляд инсайт в том, что алгоритмические выборы значительно влияют не только на скорость, но и на потолок реально достижимой производительности; а в совокупности составляют мощный рецепт, где влияние каждого отдельного выбора уже не ломает систему
😎 P.S.: О precision в RL давно спорят, в x идет движ по этой статье. Предлагают переходить с bf16 на fp16. Оба типа занимают 16 бит, но fp16 аллоцирует больше бит под мантиссу, дает большую точность (при меньшем диапазоне) и помогает избежать коллапса тренировки