
🎧 Align2Speak: TTS для мало-ресурсного языка на 30 минутах аудио
Статья о том, как прокачать синтез речи для мало-ресурсных языков. Авторы показывают, что даже на 30 мин парных данных (аудио & текст) можно получить качественный TTS с помощью GRPO post-training.
🔗Align2Speak: Improving TTS for Low Resource Languages via ASR-Guided Online Preference Optimization
Статья понравилась, потому что идея простая и прикладная (разбирать что-то сложное пока нет времени). Ну и интересно все, что связано с бутстрэппингом на новые языки. Это, кстати, продолжение 🔗Koel-TTS (NVIDIA) от той же команды.
💻 Архитектура
Здесь у нас encoder-decoder из Koel-TTS. Не самое современное решение на фоне диффузионок, но надёжное и показывает хорошие результаты при ограниченных данных.
Текст, что нужно озвучить, проходит через NAR text encoder, затем AR transformer decoder получает аудио-токены референсного голоса в контекст и через cross-attention считывает текстовые представления. Декодер оперирует только аудио-токенами, ему не нужно учить мульти-модальность, что выгодно для мало-ресурсных сценариев. Такая архитектура была признана оптимальной в Koel-TTS, так как перенос голоса через контекст сработал лучше, чем через spk embedding. На каждом шаге модель параллельно генерит все токены кодбуков 🔗Nanocodec.
Базовая модель построена на IPA токенах (International Phonetic Alphabet). Это универсальные фонетические представления, позволяют модели выучить относительно независимый от языка мэппинг между звуками и речевыми токенами.
😑 Как адаптировали к новому языку?
Базовая TTS натренена на ~21к часов речи, где ~18к это англ, а все остальное европейские языки (German, Dutch, Spanish, French). Затем адаптировали к польскому, португальскому и хинди — трём языкам, которых модель не видела.
1⃣ Fine-tune на миксе пре-трейна и 30 минут - 5 часов нового языка
2⃣ GRPO (Group Relative Policy Optimization) с композитным reward из трёх сигналов: Character Error Rate (Whisper-v3-large), Speaker Similarity (TitaNet embeddings) и PESQ
При генерации вариантов для GRPO на 50% примеров включили CFG (Classifier-Free Guidance)
🤔 Результаты
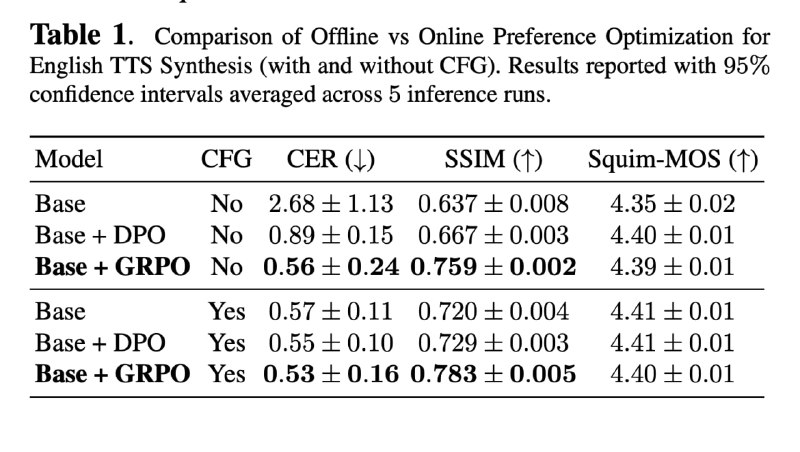
Авторы оценивали по четырём метрикам: Intelligibility (CER от того же Whisper-v3-large), Speaker Similarity (TitaNet), Audio Quality (PESQ), Naturalness (Squim-MOS).
🐹 GRPO дает стабильные приросты, особенно в разборчивости (например, на португальском с 30 мин данных FT + GRPO CER падает с 33% до 3.94%). Конечно, использование whisper и в reward, и в оценке создаёт определённый bias, ведь мы учим модель подстраиваться под ASR (и ее галлюцинации). Но фреймворк гибкий, компоненты reward можно заменить под ваш сетап.
🐹 И даже без fine-tune на целевом языке, только через GRPO, модель значительно улучшает разборчивость. Даже на хинди, который сильно далёк от европейских языков в пре-трейне (54%➡32.6%). Модель не видела реальных пар текст-аудио, но научилась генерить внятную речь. Думаю, что во многом благодаря IPA, дают универсальную инициализацию.
🐹 На английском (high-resource язык из пре-трейна) тоже получили заметные улучшения после GRPO (лучше DPO). То есть метод работает не только для адаптации, но и для общего улучшения качества.
А чем бы вы заменили whisper? А еще, пробовали ли CFG в TTS?
Post #145
1.03K


- ❤ 12
- 👍 2
- 🔥 2