


Привет! На связи Макс 🖖
Сегодня разберём секцию, которая ощущается как финальный босс ML-собесов — ML System Design
Раунд проверяет, можешь ли ты спроектировать ML-систему под реальную бизнес-задачу, аргументировать инженерные решения и уверенно вести разговор от сбора данных до мониторинга в проде.
Почему этот раунд сложный?
Потому что он не про «правильный ответ», а про мыслительный процесс. В зависимости от настроения или специфики роли на которую собеседуетесь (ML инженер, Data инженер, рисерчер), интервьюер может уйти в метрики, данные, модель, приватность или продакшн — и тебе нужно держать весь пайплайн в голове.
👍 Чтобы упростить подготовку, я собрал шаблон построения беседы. Он вдохновлён структурой из этого блога — очень советую.
0️⃣1️⃣ Уточнение требований
Ключевая часть раунда 🔽
Сначала нужно уточнить всё, что возможно: правильные вопросы определяют весь сценарий. Что должно проясниться:
➡️Суть задачи и какую систему ждут?
Т.к. на интервью, особенно в FAANG, могут дать задачу вне твоего домена → сильно помогает насмотренность на разные типы:
📎 Сборник примеров от CV до TTS
📎 Реальный кейс с собеса
➡️Как решение влияет на user experience? Мыслить через пользовательский опыт — это сильный сигнал, что ты проектируешь осознанно и по-сеньорски.
➡️Масштаб: сколько данных и пользователей?
➡️Ресурсы: какие мощности, есть ли GPU или только CPU?
Тут важно знать FLOPS, TPS, VRAM и уметь переводить их в реальный кейс.
📎 Арифметика для LLM
📎 Что нужно, чтобы сделать свой Cursor
➡️Ограничения по моделям: нужна ли максимальная точность или скорость, сегменты пользователей, как часто устаревают данные (это дает понимание, как часто нужно переобучать модель), нужна ли интерпретируемость, делать ли одну модель для всех стран или несколько отдельных моделей.
➡️Метрики: когда появилось четкое понимание задачи, определи, какие метрики лучше всего подойдут. Нужно назвать минимум 2 метрики: одну для офлайн-оценки и одну для онлайн.
📎 Курс Евгения Соколова по метрикам
Не переживай, что уточнения занимают 15–20 минут — после них проектировать систему сильно проще.
Нажми, чтобы открыть полностью
0️⃣2️⃣ Данные
Любое ML-решение требует данных 🔽
➡️ Таргет: явный/неявный, как собираем.
В рекомендациях — понравился ли продукт по историческим данным. Пример явного таргета → когда мы смотрим в логи и проверяем, поставил ли пользователь явную оценку или нажал на кнопку.
➡️ Связь таргета и метрик.
Чем раньше понятно, что оптимизируем, тем быстрее замыкается цикл дизайна.
➡️ Фичи: какие признаки используем, как храним и обрабатываем.
➡️ Biases / Data Privacy. Умение увидеть байасы и подумать о безопасности данных — редкий, но ценный навык.
📎 Книга Валерия Бабушкина хорошо покрывает этот кусок.
0️⃣3️⃣ Моделирование
Любимый кусок любого ML инженера 🔽
➡️ Не закапываться в глубокие технические детали (это для ML Depth).
➡️ Иметь хороший baseline, желательно без обучения сложной модели.
➡️ Проговорить интерпретируемость: почему модель делает то, что делает.
➡️ Объяснить, как дебажить и подбирать гиперпараметры на больших данных.
📎 Оставлю полезные заметки Chip Hyuen из ее книги ML System Design Interview
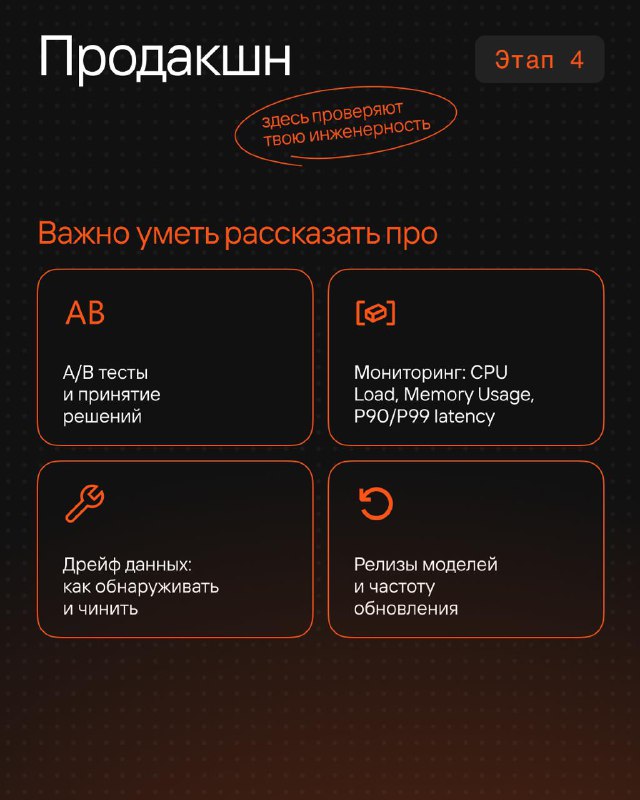
0️⃣4️⃣ Продакшн
Как система будет жить «в полях» 🔽
➡️ A/B-тесты: как понять, что новая модель лучше старой.
➡️ Мониторинг: CPU Load, Memory Usage, P90/P99 latency.
➡️ Дрейфы данных и обновление модели: когда и как часто обновлять, что может пойти не так.
📎 Лучший вход в ML-продакшн — курс Andrew Ng. Покрывает все, что нужно, чтобы уверенно говорить про продакшн на интервью.
Ставь ⚡️ — если было полезно
🙂 и подписывайся на мой канал, там про карьеру, образование и исследования в AI через призму собственного опыта!
➡️ Выпуск про Live Coding
➡️ Выпуск про DL-специализацию
🛡 Стать экспертом AI Talent Hub
@aitalenthubnews
#ITMO #NapoleonIT