админ - @workakkk
@ai_machinelearning_big_data - Machine learning
@itchannels_telegram - 🔥лучшие ит-каналы
@pythonl - Python
@pythonlbooks- python книги📚
@datascienceiot - ml книги📚
№ 5037635661
Post #1269
2.61K
🔬 IBM показала как заставить ИИ отвечать одинаково каждый раз
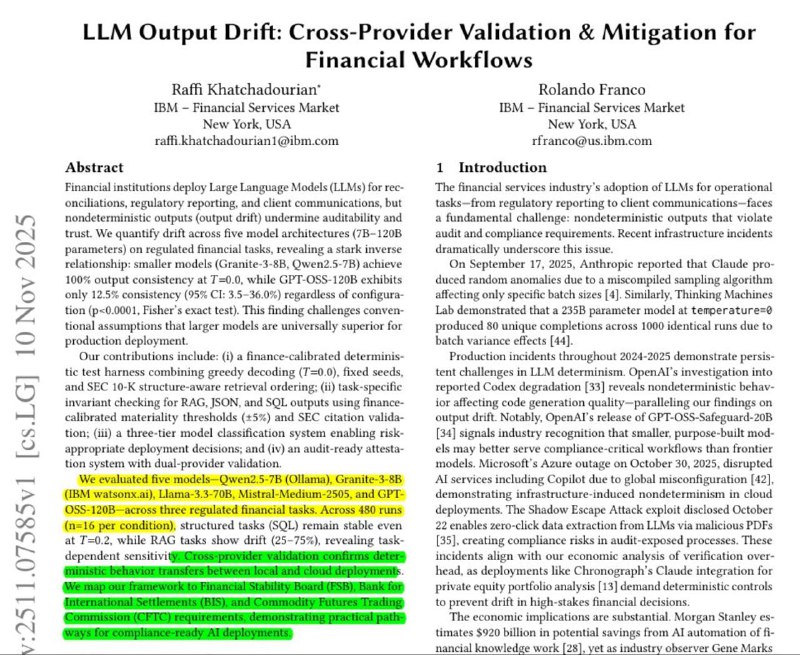
Обычно большие языковые модели работают вероятностно и дают слегка разные ответы даже при одинаковом запросе. Команда IBM проверила можно ли полностью убрать эту случайность и добиться стабильности в критичных системах.
Исследователи провели 480 прогонов на пяти моделях и трёх задачах при температуре 0. Модели объёмом 7B и 8B выдавали полностью одинаковые ответы. Модель 120B совпадала только в двенадцати с половиной процента случаев даже при полном отключении случайности.
Главные источники нестабильности оказались в порядке извлечения документации и в процессе выборки токенов. Команда принудительно включила greedy decoding зафиксировала seed и использовала строгий порядок параграфов SEC 10K чтобы каждая попытка шла по одному и тому же пути.
Дополнительно они добавили схемы проверки для JSON и SQL а числовые ответы считали корректными только при отклонении не более пяти процентов. Это сохраняет смысл и факты но не позволяет считать мелкие отличия дрейфом.
При температуре 0.2 задачи с RAG теряли стабильность а SQL и короткие сводки оставались стопроцентно одинаковыми. Структурированный вывод стабилен по природе а свободный текст остаётся чувствительным к любым флуктуациям.
В результате IBM предложила уровни использования. Модели 7B и 8B подходят для всех задач в регулируемых областях. Модели 40B и 70B подходят только для строго структурированного вывода. Модели 120B признаны нестабильными для процессов где нужна полная повторяемость.
Тесты между локальными и облачными средами совпали. Значит детерминизм переносится если соблюдены все контрольные механизмы.
Для финансовых стеков рекомендуют температуру 0 фиксированный порядок извлечения версионированные промпты и двойную валидацию перед запуском в прод
Источник arxiv.org/abs/2511.07585
- ❤ 7
- 🌚 3
- 👍 2
- 🤔 2