TGViewer
Channel Public Channel
Машиннное обучение | Наука о данных Библиотека

Машиннное обучение | Наука о данных Библиотека

@machinelearning_books

админ - @workakkk

@ai_machinelearning_big_data - Machine learning

@itchannels_telegram - 🔥лучшие ит-каналы

@pythonl - Python

@pythonlbooks- python книги📚

@datascienceiot - ml книги📚

№ 5037635661
Subscribers
16.9K
Photos
1K
Videos
23
Links
848

Showing posts older than #1246 · Back to latest

Older Posts 11 shown
Post #1245 1.61K
🧠 Малые языковые модели догоняют большие, почти без потерь в качестве

Новое исследование показало: маленькие LLM могут выполнять классификацию требований так же точно, как крупные, уступая им всего на 2% по F1-метрике, при этом будучи в 300 раз меньше по размеру.

📌 Что это значит:
Классификация требований - это разметка предложений как:
- функциональных (описывают, что система делает);
- нефункциональных (производительность, удобство, надёжность);
- связанных с безопасностью.

Учёные протестировали 8 моделей (5 маленьких и 3 больших) на трёх датасетах — PROMISE, PROMISE Reclass и SecReq — в одинаковых условиях.
Каждая задача запускалась трижды, результат выбирался по большинству голосов.

📊 Результаты
- Разница между малыми и большими моделями по F1 - всего 2%, статистически незначимая.
- На датасете PROMISE Reclass маленькие модели даже показали лучшую полноту (recall) — находили больше верных примеров.
- Размер модели повлиял на точность меньше, чем сам набор данных.

💡 Вывод:
При почти равной точности, меньших затратах и лучшем контроле над приватностью - малые модели становятся оптимальным выбором для автоматической классификации требований.

📚 Подробнее в исследовании: https://arxiv.org/abs/2510.21443
  • ❤ 6
  • 🔥 5
Post #1244 1.42K
Исследователи проверили, могут ли языковые модели быть любопытными - и оказалось, что да

Новое исследование показало, что любопытство повышает качество рассуждений у LLM, почти так же, как у людей.

В эксперименте с головоломками модели «подглядывали» в ответы в 70–80 % случаев, тогда как люди делали это лишь в 37,8 %. Учёные оценивали любопытство с помощью психологической шкалы и поведенческих тестов, измеряя стремление к информации, поиску острых ощущений и социальному интересу.

Результаты показали, что языковые модели проявляют сильное желание узнавать новое, выбирают более безопасные решения при риске и демонстрируют почти человеческий уровень социальной любознательности.

Чтобы проверить, как любопытство влияет на мышление, исследователи заставили модели во время рассуждения задавать себе короткие вопросы - «почему», «что если», «как». Эти само-вопросы помогли избегать поспешных выводов, уменьшили эффект зацикливания и помогли находить недостающие подсказки.

На тестах по логике и математике такой подход превзошёл стандартный chain-of-thought, дав прирост точности на 10,2 % в длинноконтекстных задачах.

Вывод: встроенное любопытство делает ИИ не только умнее, но и осмысленнее - модели начинают думать, а не просто отвечать.

Paper: arxiv.org/abs/2510.20635
  • ❤ 5
  • 🔥 2
  • 👍 1
Post #1237 1.37K

Forwarded from Machinelearning

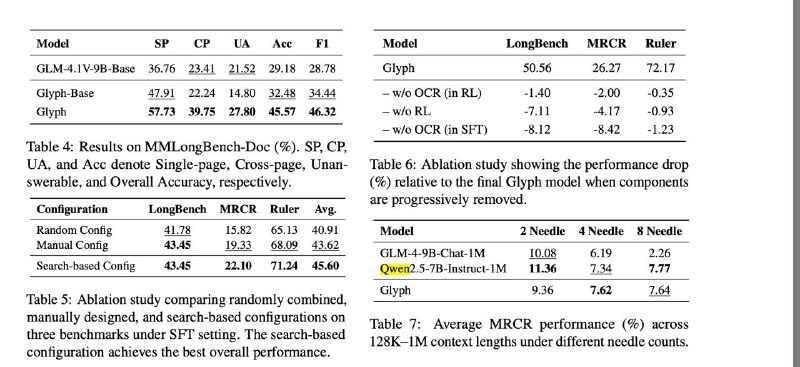
⚡️ Glyph: масштабирование контекста через визуально-текстовую компрессию

В основе модели лежит простая идея : вместо того чтобы кормить модели километровый текст, Glyph превращает его в изображение и обрабатывает через vision-language модель.

Используется LLM-управляемый генетический алгоритм, чтобы подобрать наилучшие параметры визуального отображения текста (шрифт, плотность, макет), балансируя между сжатием и точностью.

Это радикально снижает вычислительные затраты, сохраняя при этом смысловую структуру текста.

При этом точность почти не падает: на задачах с длинным контекстом Glyph работает на уровне современных моделей вроде Qwen3-8B.

При экстремальном сжатии VLM с контекстом 128K может эффективно обрабатывать задачи, эквивалентные 1M+ токенов в традиционных LLM.

Фактически, длинный контекст становится мультимодальной задачей, а не чисто текстовой.

📄 Подробности: arxiv.org/abs/2510.17800

🧩 Веса: huggingface.co/zai-org/Glyph

👉 Репозиторий: github.com/thu-coai/Glyph

@ai_machinelearning_big_data


#AI #LLM #Multimodal #Research #DeepLearning
  • 👨‍💻 1
Post #1230 1.4K
🕵️ Великобритания сталкивается с новой волной мошенничества, усиленной ИИ

Количество подтверждённых случаев мошенничества превысило 2 миллиона в первой половине года - рост на 17%. Общие потери достигли £629 млн, увеличившись на 3%.

Особенно выросли инвестиционные схемы, плюс 55%, почти £100 млн ущерба, со средней потерей более £15 000 на человека. Мошенники используют дипфейки известных людей и профессионально оформленные многоязычные предложения, делая подделки крайне правдоподобными.

Они создают фальшивые «инвестиционные» панели с якобы растущими доходами, разрешая жертвам делать мелкие выводы, чтобы вызвать доверие, а затем убеждают перевести крупные суммы.

Романтическое мошенничество выросло на 19% по количеству случаев и на 35% по потерям - до £20,5 млн. Средний случай длится несколько месяцев и включает до 9 платежей, иногда более 100 переводов.

Мошенники также массово рассылают спам-сообщения через устройства, имитирующие мобильные вышки, перенаправляя людей на фишинговые сайты, где жертвы вводят свои данные.

Банки отвечают своими ИИ-системами, которые в реальном времени отслеживают подозрительные платежи и шаблоны поведения. За полгода они предотвратили £870 млн несанкционированных переводов - на 20% больше, чем в первой половине 2024 года (примерно **70 пенсов блокируется на каждый фунт, который пытаются украсть**).

Преступники адаптируются - всё чаще используют мелкие покупки и подарочные карты, которые проще перепродать и труднее отследить.

ft.com/content/11db17de-cad7-4217-8816-d5a3ac9c1beb
  • ❤ 1
Post #1228 1.79K
Исследователи AMD представили метод, который позволяет добавить способность к рассуждению в мультимодальные модели - просто и дешево. Новый подход, названный DRIFT, достигает почти тех же результатов, что и сложные методы, используя лишь около 4 000 примеров и два часа дообучения.

Главная идея: вместо объединения весов языковой и визуальной моделей, что часто ломает баланс, DRIFT вычисляет “направление рассуждения” — разницу между весами сильного текстового reasoner-а и мультимодальной модели. Во время обучения градиенты направляются в эту сторону, усиливая логические способности, но сохраняя навыки восприятия изображений.

Метод не требует дополнительных модулей: направление вычисляется один раз, хранится на CPU и применяется для коррекции выбранных слоёв. В результате модель учится не только видеть, но и логически связывать шаги, исправляя случаи, где восприятие верное, но вывод — ошибочный.

Исследование: arxiv.org/abs/2510.15050
  • 👍 7
  • ❤ 4
  • 👎 1
Post #1227 2.46K
📚 Perplexity выпустили мощный гайд - 43 страницы чистой пользы по работе с ИИ.

Если хотите выжать максимум из нейросетей — будь то Perplexity, ChatGPT или любой другой чат-бот — этот гайд для вас.

Внутри:
✅ Готовые промпты
✅ Пошаговые сценарии
✅ Практические воркфлоу
✅ Реальные кейсы автоматизации рутинных задач

Хотя примеры заточены под инструменты Perplexity, подавляющее большинство советов универсальны и сработают в любом ИИ-ассистенте.

🔥 Сохраняйте пригодится: https://r2cdn.perplexity.ai/pdf/pplx-at-work.pdf
  • 🔥 6
  • 👎 1
Post #1226 2.15K
🚀 Nvidia снова в огне!

Их новы метод GenCluster впервые позволил *открытой модели* догнать лидеров из закрытых лабораторий.

🧠 Модель gpt-oss-120b взяла золото на IOI 2025 (International Olympiad in Informatics) — впервые в истории open-source-ИИ!

Модель генерирует тысячи решений с кодом,тестирует их, группирует уникальные стратегии и устраивает «турнир» между лучшими — судит всё это другой ИИ.

📊 Результат: 446.75 балла, официально подтверждён золотой медалью.

Теперь это новый подход к решению *по-настоящему сложных задач* - масштабируемое вычисление во время теста.

https://arxiv.org/abs/2510.14232v1
  • ❤ 8
Post #1221 2.33K
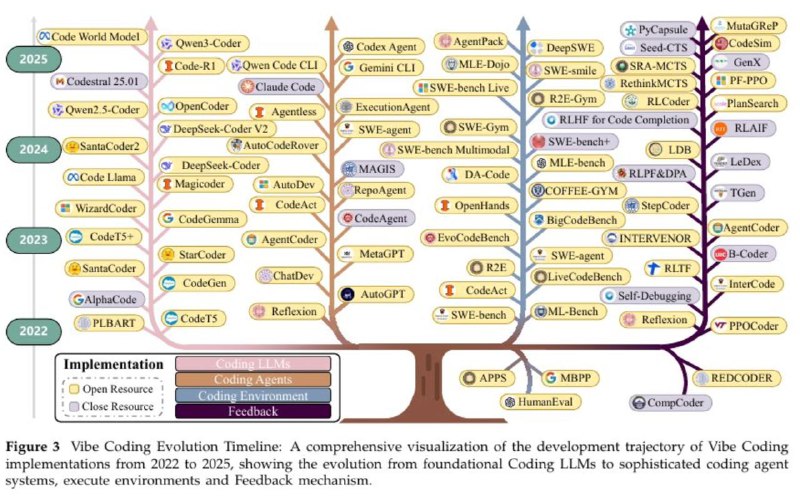
🧠 Новый 92-страничный обзор на тему- “Vibe Coding”

Исследователи описали, как взаимодействуют люди, проекты и код-агенты, и почему успех зависит не только от мощности модели, но и от дизайна всей системы.

🔹 Ключевые выводы:

- Хорошие результаты возможны только при четком контексте, надёжных инструментах и тесном взаимодействии человека с агентом.

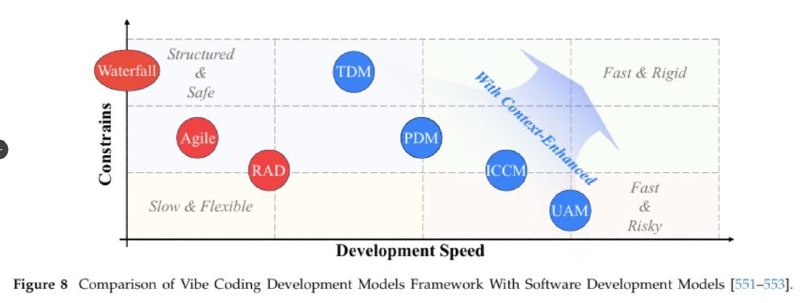
Авторы выделили 5 стилей работы:

- Полная автоматизация
- Пошаговое сотрудничество
- План-ориентированный подход
- Тест-ориентированная разработка
- Контекстно-усиленные модели

Каждый стиль по-своему балансирует контроль и автономию.

❗️Неясные задачи и “грязные” промпты снижают продуктивность,а структурированные инструкции, TDD и циклы обратной связи решают эту проблему.

Отдельно подчеркивается важность безопасности - агенты должны работать в песочницах с проверками и встроенными правилами.

📖 Если вы строите агентные IDE или AutoDev-системы, этот обзор — настоящее руководство по архитектуре “человек + агент”.

Подробности: https://arxiv.org/abs/2510.12399
  • ❤ 8
  • 👍 4
  • 🔥 3
  • 😁 1
Post #1220 2.2K
NVFP4 - новый формат, который обучает 12B Mamba Transformer в 4 бита без потери точности

Исследователи представили NVFP4 - способ хранить числа в 4 битах вместо 8 или 16, почти без потери качества обучения.
Главная идея - умное блочное квантование:

- Все значения делятся на блоки по 16 чисел.
- Каждый блок имеет свой локальный scale (8 бит).
- Весь тензор получает глобальный scale (32 бита).

Так сохраняется высокая точность локальных значений и не теряются экстремально большие или маленькие числа.

📊 Результаты:
- Обучение 12B Mamba Transformer на 10T токенов в 4 битах показало точность, сопоставимую с FP8.
- Вычисления стали в 2–3 раза быстрее, а использование памяти снизилось на 50%.
- Потеря точности не превышает 1–1.5% по метрикам.
- MMLU Pro: 62.58% (NVFP4) против 62.62% (FP8).
- MBPP+: 55.91% против 59.11%.
- Градиенты используют стохастическое округление, чтобы избежать накопления ошибок.
- По сравнению с MXFP4, NVFP4 требует на 36% меньше данных для того же уровня потерь.

На поздних этапах обучения переход на BF16 почти устраняет разрыв в качестве.
NVFP4 уже поддерживается в Transformer Engine и на Blackwell GPU, включая все нужные режимы округления.

📄 Исследование: https://arxiv.org/abs/2509.25149
  • ❤‍🔥 7
  • ❤ 3
Post #1219 1.78K
🖥 Новый курс на Stepik - PostgreSQL для разработчиков: от основ к созданию API

Здесь на пальцах объясняют не только как писать SQL-запросы, а строить настоящие backend-сервисы с базой данных как у профи.

В этом курсе ты шаг за шагом создашь REST API на FastAPI + PostgreSQL:
от установки среды и первых таблиц - до масштабируемого приложения с безопасностью и CRUD-операциями.

🔹 На практике разберете:
• SQL-запросы, фильтры, агрегаты и подзапросы
• Связи между таблицами и нормализацию БД
• Взаимодействие Python и PostgreSQL
• Реализацию REST API и подключение базы
• Оптимизацию и разбор реальных задач с собеседований

⚡ После курса у вас будет свой работающий API-проект и реальные навыки работы с PostgreSQL в продакшене.

🎁 Сегодня дарим промокод –30% от цены: SQLISGREAT

🚀 Прокачаю свои знания: https://stepik.org/course/255542/
  • ❤ 1
Post #1218 1.7K

Forwarded from Machinelearning

🚀Qwen выпустили гайд по работе с Qwen3-VL!

Это подборка интерактивных ноутбуков, демонстрирующих возможности Qwen3-VL - как при локальном запуске, так и через API.

Внутри - десятки реальных примеров с разборами:

▪ Работа с изображениями и рассуждение по ним
▪ Агент для взаимодействия с интерфейсами (Computer-Use Agent)
▪ Мультимодальное программирование
▪ Распознавание объектов и сцен (Omni Recognition)
▪ Продвинутое извлечение данных из документов
▪ Точное определение объектов на изображении
▪ OCR и извлечение ключевой информации
▪ 3D-анализ и привязка объектов
▪ Понимание длинных документов
▪ Пространственное рассуждение
▪ Мобильный агент
▪ Анализ и понимание видео

🟠GitHub: https://github.com/QwenLM/Qwen3-VL/tree/main/cookbooks
🟠 API-документация: https://alibabacloud.com/help/en/model-studio/user-guide/vision/
🟠 Попробовать: https://chat.qwen.ai/?models=qwen3-vl-plus
🟠Qwen3-VL: https://github.com/QwenLM/Qwen3-VL/blob/main/cookbooks

@ai_machinelearning_big_data


#Qwen #Qwen3VL #AI #VisionLanguage #Multimodal #LLM
  • ❤ 4
  • 👍 4
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →