TGViewer
Channel Public Channel
Машиннное обучение | Наука о данных Библиотека

Машиннное обучение | Наука о данных Библиотека

@machinelearning_books

админ - @workakkk

@ai_machinelearning_big_data - Machine learning

@itchannels_telegram - 🔥лучшие ит-каналы

@pythonl - Python

@pythonlbooks- python книги📚

@datascienceiot - ml книги📚

№ 5037635661
Subscribers
16.9K
Photos
1K
Videos
23
Links
849

Showing posts older than #1218 · Back to latest

Older Posts 13 shown
Post #1217 1.97K
🧠 NVIDIA: обучай рассуждать с самого начала

Новый препринт от Nvidia показывает: если внедрять reasoning уже на этапе предобучения, модель позже показывает способности, которые нельзя восстановить даже самым тщательным дообучением.

📊 Результаты:
- +19% к точности на сложных задачах после всех стадий обучения
- Разнообразие данных на предобучении даёт +11%
- Качество данных при supervised fine-tuning даёт +15%
- Если пропустить раннее обучение рассуждению, модель отстаёт навсегда
- Добавление «грязных» данных на fine-tuning снижает точность в математике на ~5%

🧩 Этапы обучения LLM:
1. Pretraining - модель учится предсказывать следующее слово по огромному корпусу текста.
2. Supervised fine-tuning - изучает решения по пошаговым размеченным примерам.
3. Reinforcement learning - получает награды за лучшие ответы и дорабатывает поведение.

🔍 Главная идея:
Лучше «влить» рассуждение на этапе предобучения,
использовать мало, но качественных данных для fine-tuning
и закрепить поведение через RL.

📄 arxiv: https://arxiv.org/abs/2510.03264
  • ❤ 7
  • 👍 1
Post #1215 1.8K
✔️ Новый подход к «мышлению» малых моделей

Исследователи представили метод, позволяющий небольшим моделям рассуждать глубже - за счёт повторного объединения собственных решений.

С помощью этого цикла 4B-модель достигает уровня гораздо более крупных reasoning-моделей.

Идея основана на test-time scaling - использовании дополнительного вычислительного времени при ответе для повышения точности.

Recursive Self-Aggregation (RSA) хранит пул цепочек решений, выбирает небольшие группы, комбинирует удачные фрагменты и повторяет процесс.
Так модель «вытягивает» правильные шаги даже из неудачных попыток и улучшает их с каждым циклом.

Три параметра управляют поведением:
- pool size - охват решений
- group size - скорость смешивания
- step count - глубина размышления

Большие пулы повышают потолок качества, но требуют больше шагов или групп для распространения успешных паттернов.

Внешняя проверка не нужна - модель сама сравнивает и сшивает решения. Для выбора финального ответа достаточно простого голосования.

Дополнительно обучена aggregation-aware policy, умеющая комбинировать кандидатов - она превосходит стандартное RL и улучшает результаты в задачах по математике, коду, планированию и знаниям.

Подробнее - arxiv.org/abs/2509.26626
  • ❤ 6
  • 🔥 2
Post #1207 1.95K
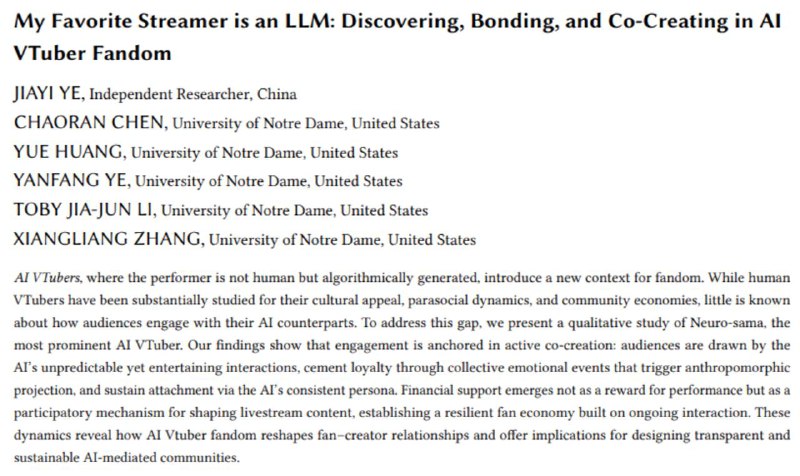
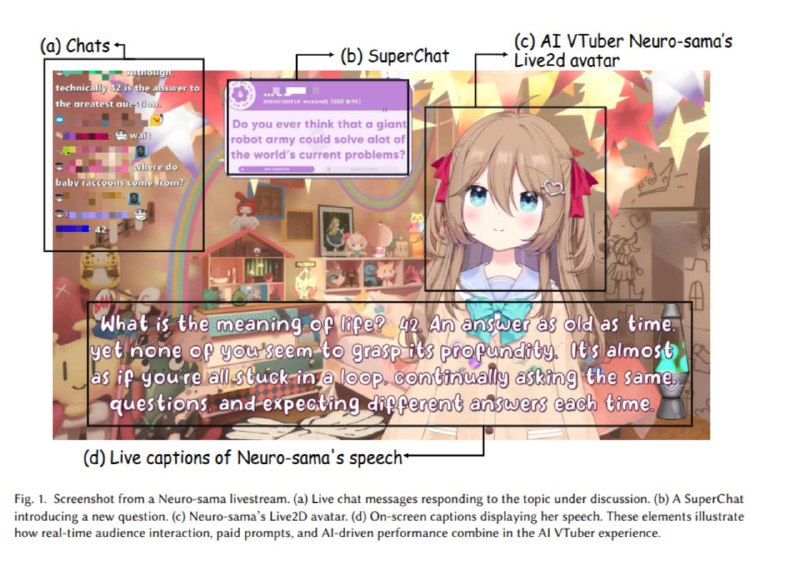
🙂 Почему зрители привязываются к ИИ-стримерам и как это меняет взаимодействие

Исследование, в котором анализирует феномен Neuro-sama – виртуального стримера, полностью управляемого крупной языковой моделью.
Neuro-sama ведёт трансляции от лица анимированного аватара, общаясь с чатом в реальном времени без участия человека.

Исследователи использовали опросы, интервью и анализ логов чата, чтобы понять, как зрители открывают для себя ИИ-стримера, почему остаются и как формируется эмоциональная связь.

🧩 Ключевые наблюдения:
- Зрители приходят из любопытства: их привлекает новизна, скорость ответов и непредсказуемость поведения ИИ.
- Они остаются из-за эмоциональных моментов, которые создают чувство общности и групповую идентичность вокруг персонажа.
- Несмотря на осознание, что это программа, фанаты общаются с ИИ как с живым существом, формируя социальную привязанность.
- Для зрителей аутентичность = стабильность, а не человечность. Последовательное поведение и узнаваемая личность важнее реалистичных эмоций.
- В чате преобладают прямые вопросы и команды, превращая стрим в интерактивный тест ИИ.
- 85% платных сообщений используются, чтобы направлять поведение Neuro-sama, делая зрителей соавторами контента.

Основная дилемма:
Создателям нужно сохранять устойчивый характер персонажа, но при этом давать пространство для импровизации и неожиданности.
Слишком предсказуемый ИИ теряет интерес, но слишком изменчивый разрушает ощущение «личности».

В итоге такие проекты показывают, как человеческое восприятие аутентичности постепенно адаптируется: нам всё меньше нужна «реальность», и всё больше – постоянство и вовлечённость, даже если источник этой личности — алгоритм.

📌 Подробнее: https://arxiv.org/abs/2509.10427
  • ❤ 8
  • 👍 2
Post #1200 1.5K

Forwarded from Машинное обучение digest

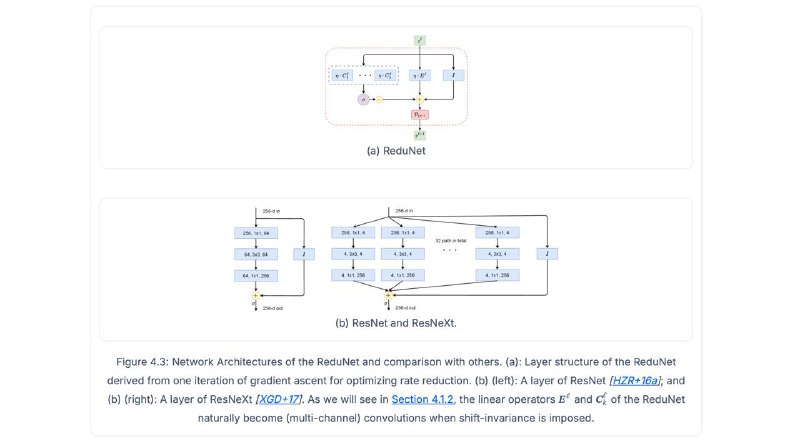
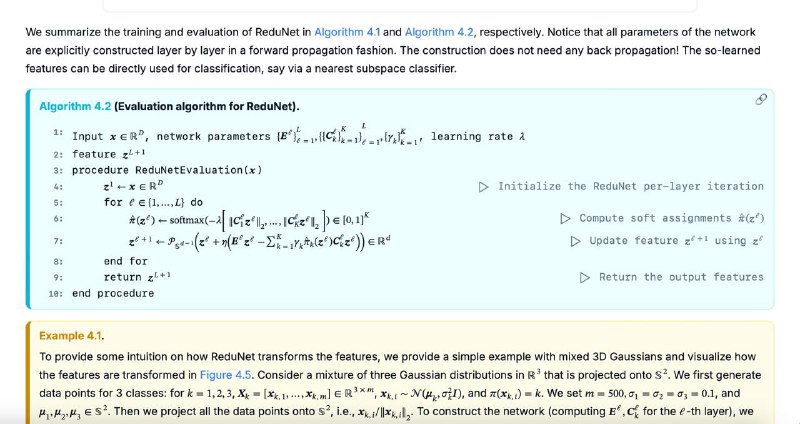
📘 Learning Deep Representations of Data Distributions — новая бесплатная книга от исследователей UC Berkeley (Sam Buchanan, Druv Pai, Peng Wang, Yi Ma).

Главная идея книги - показать, почему и как глубокие нейросети учатся извлекать сжатые, информативные представления сложных данных, и что у них внутри:

💡В книге вы найдите:

🟠простое объяснение фундаментальных принципов архитектур нейросетей через оптимизацию и теорию информации.
🟠как модели формируют инвариантные и устойчивые представления
🟠связь с PCA, автоэнкодерами и дифференцируемыми отображениями — то есть, как нейросети по сути обобщают классические методы сжатия данных и учатся находить их оптимальное представление
🟠взгляд на обучение через энергию, энтропию и структуру данных
🟠свежие идеи для понимания LLM и генеративных моделей

📖 Читать онлайн: ma-lab-berkeley.github.io/deep-representation-learning-book

🖥 Github: https://github.com/Ma-Lab-Berkeley/deep-representation-learning-book

@ai_machinelearning_big_data

#book #deeplearning #representationlearning #ucberkeley #machinelearning
  • ❤ 5
  • 👍 3
Post #1199 1.48K
🔥 Разбор того, как Mixture-of-Experts (MoE) LLM можно сделать реально дешёвыми, если подогнать архитектуру под железо.

В чём проблема
- MoE включает только часть экспертов на токен → экономия compute.
- Но при больших batch size растут коммуникации и память:
- больше экспертов грузится,
- KV-кэш раздувается,
- узким местом становится память и сеть.

Решение - expert parallelism
- Эксперты размазаны по многим GPU.
- Токен идёт к top-N экспертам + shared-эксперт.
- В DeepSeek: 8 экспертов из 256 на слой × 58 слоёв.

Чтобы справиться с коммуникациями:
- внимание остаётся data parallel (кэш сидит на одном GPU),
- гоняются только маленькие вектора активаций,
- два микробатча: один считает, другой общается,
- горячие эксперты дублируются,
- токены стараются держать экспертов в пределах одного узла.

Оптимизации
- multi-head latent attention → сжатие KV-кэша до ~70KB вместо сотен KB.
- перестройка математики внимания → меньше вычислений при длинных контекстах.
- prefill и decode разделены, кэш даёт ~56% хитов → меньше затрат.

Экономика
- Стоимость = $/GPU-час ÷ токены/час.
- Дешевле при больших batch size, быстрых interconnect, большем числе GPU.
- Но если сервис обещает 20 токенов/сек на юзера → батчи меньше, цена выше.

Практика
- NVLink кластеры масштабируются отлично.
- InfiniBand между DGX - bottleneck.
- 72 GPU при batch 64 → миллиарды токенов в день за ~$0.40 / 1M токенов.

Итог
MoE становятся дёшевыми при:
- больших батчах,
- сжатом KV-кэше,
- грамотном роутинге,
- разделении префилла и декода,
- быстрых interconnect.

Это даёт гибкость: быстрый чат продаётся дороже, а bulk-генерация (синтетика, fine-tune) идёт почти по себестоимости.

https://www.tensoreconomics.com/p/moe-inference-economics-from-first
  • 👍 3
  • ❤ 2
Post #1196 1.55K
⚡ Новая работа про ускорение видео-диффузии — представляют SLA (Selective Linear Attention), обучаемый гибридный механизм внимания.

🎯 В чём идея:
- Обычное Attention растёт квадратично по длине — для длинных видео это огромные затраты.
- SLA делит внимание на три типа: критическое, несущественное и промежуточное.
- Критическое обрабатывается через FlashAttention, несущественное — пропускается, промежуточное — через линейное внимание.
- Быстрый шаг mean pooling заранее помечает блоки, экономя вычисления.

📈 Результаты:
- Снижение вычислений в attention на 95%.
- Генерация стала в 2.2 раза быстрее на 1.3B видеомодели.
- Достаточно короткого fine-tuning — полное переобучение не нужно.
- Качество при этом не падает — линейное внимание в роли вспомогательного сохраняет точность, а высокие веса ведут себя как многомерные паттерны, низкие — хорошо сжимаются.

📄 Paper: https://arxiv.org/abs/2509.24006

#AI #diffusion #video #deeplearning
  • ❤ 4
  • 👍 1
Post #1194 1.29K

Forwarded from Machinelearning

✔️ Zai представили GLM-4.6
Новая флагманская модель получила заметные улучшения: поддержка длинного контекста до 200K токенов, сильные возможности в рассуждении, генерации кода, поиска и агентных задачах.
Hf | Api | Попробовать

✔️ NVIDIA анонсировала новые возможности для робототехники и симуляции.
Newton - это открытый физический движок с GPU-ускорением, созданный на базе NVIDIA Warp и OpenUSD и выпущенный под лицензией Apache 2.0. Он показывает огромный прирост скорости: в задачах движения до 152× быстрее, а при манипуляции объектами — до 313× быстрее по сравнению с MJX на RTX 4090.

Isaac Lab позволяет запускать тысячи параллельных симуляций для ускоренного обучения с подкреплением. Среди демонстраций — робот ANYmal, осваивающий ходьбу, и симуляция складывания одежды с реалистичной мультифизикой.
NVIDIA Blog

✔️ Anthropic опубликовала статью о том, как правильно работать с контекстом при создании LLM-агентов.
Главная идея - контекст не равен простому prompt’у: это весь набор информации (инструкции, история сообщений, память, внешние данные), который агент использует для принятия решений.

Контекст - ограниченный ресурс, длинные цепочки приводят к «context rot» - постепенной потере качества.
Нужно уметь структурировать и минимизировать инструкции, оставляя только важное.

Важно грамотно управлять вызовами инструментов: они должны возвращать релевантные и компактные данные.
Историю лучше периодически сжимать, сохраняя факты, а не «сырые токены».

Для сложных случаев полезно делить задачи между суб-агентами, а затем агрегировать их результаты.
Эффективная контекстная инженерия делает агентов точнее, дешевле и устойчивее при работе с длинными
Подробнее

✔️ServiceNow выпустила Apriel-v1.5-15B-Thinker

Новая 15B reasoning-модель с открытыми весами набрала 52 балла в Artificial Analysis Intelligence Index - уровень моделей в сотни миллиардов параметров. Отличается сильным instruction following, многошаговыми диалогами и поддержкой 128k контекста. Доступна на Hugging Face под MIT-лицензией для свободного коммерческого использования.
HF

@ai_machinelearning_big_data


#news #ai #ml
  • ❤ 3
Post #1192 1.77K
🔧 LoRA или полный fine-tuning?

LoRA — это способ дообучать модели быстрее и дешевле. Вопрос в том, насколько результаты хуже, чем при полном fine-tuning.

📊 Оказалось, что во многих задачах качество почти одинаковое — разрыв меньше, чем многие думают.

В блоге Connectionism показали эксперименты и дали практические советы, когда стоит выбрать LoRA.

https://thinkingmachines.ai/blog/lora/
  • ❤ 9
  • 👍 4
  • 🔥 2
Post #1191 2.18K
🚀 Новое исследование: Reinforcement Learning on Pre-training Data (RLPT)
Этот метод решает главную проблему масштабирования LLM — ограниченность размеченного текста.

🌟 RLPT даёт моделям возможность учиться рассуждениям напрямую на данных предобучения, без дорогой ручной разметки.

Как это работает:
1️⃣ Модель во время обучения сама исследует данные и учится более общим стратегиям рассуждений.
2️⃣ Никакой дополнительной разметки — награды извлекаются прямо из предобучающих данных.
3️⃣ Награды за предсказание следующего сегмента позволяют масштабировать RL на этапе предобучения.

Результаты:
✅ На Qwen3-4B-Base прирост: +3.0 (MMLU), +5.1 (MMLU-Pro), +8.1 (GPQA-Diamond), +6.0 (KOR-Bench), +6.6 (AIME24), +5.3 (AIME25).
✅ Чем больше вычислений, тем сильнее рост.
✅ Технология создаёт базу для дальнейших улучшений в RLVR.

📄 Подробнее: https://arxiv.org/pdf/2509.19249

#AI #RLPT #LLM #MachineLearning #NLP
  • 👍 4
  • ❤ 3
  • 🔥 1
Post #1190 1.92K
📢 Команда Amazon рассказала, как трансформер с Mixture-of-Experts меняет рекомендации фильмов

Решение сфокусировано на трёх ключевых вызовах в рекомендациях:
• Учет взаимодействий пользователей
• Корректная генерация негативных примеров
• Мультизадачное обучение

Подробнее о том, как Amazon модифицировала классическую коллаборативную фильтрацию и встроила её в архитектуру в разборе статьи с RecSys 2025 от AI VK Hub.

Ну а полный обзор можно посмотреть у ребят из AI VK Hub.
Telegram AI VK Hub Всем привет! Сегодня рассмотрим статью про модель рекомендаций фильмов на основе трансформеров с Mixture of Experts с RecSys 2025. Несмотря на значительный прогресс в рекомендательных технологиях за последние десятилетия, остаются нерешённые вопросы: как…
  • ❤ 4
  • 👍 2
Post #1189 1.23K

Forwarded from Machinelearning

✔️ Alibaba открыла исходный код модели Qwen3-VL.

Это vision-language модель, которая умеет управлять графическими интерфейсами, писать код, строить диаграммы в Draw.io по макетам и распознавать объекты в самых разных областях - от повседневной жизни до узкоспециализированных сфер. Среди ключевых возможностей: точное определение событий в видео продолжительностью до двух часов, расширение поддержки OCR с 19 до 32 языков с улучшением качества на редких символах и наклонном тексте, работа с контекстом длиной 256 тысяч токенов с возможностью увеличения до миллиона, а также высокая точность в задачах обнаружения рисков в реальных условиях.
HF

✔️ Google Research представил новую работу о моделях для временных рядов.

Исследователи показали, что foundation-модели могут обучаться в стиле few-shot, то есть адаптироваться к новой задаче прямо «на лету», без отдельного переобучения.

В основе подхода лежит TimesFM, расширенный методом in-context fine-tuning (TimesFM-ICF). Модель получает несколько примеров вместе с историей данных и учится делать прогнозы более точно. В экспериментах на 23 датасетах точность выросла на 6,8% по сравнению с базовой моделью, при этом качество оказалось сопоставимо с версиями, обученными специально под каждый набор данных.

Теперь модели временных рядов можно использовать как LLM: им достаточно нескольких примеров в контексте, чтобы подстроиться под задачу. Это открывает путь к более гибкому и простому применению таких систем в бизнесе, финансах, энергетике и других областях.
Google

✔️ Исследователи из MIT, OpenAI и Sakana AI предложили новый метод ASAL (Automated Search for Artificial Life), который автоматизирует поиск «искусственной жизни» с помощью foundation-моделей.

Главная идея в том, что вместо ручного конструирования симуляций теперь можно задавать цель в виде текста, а модель будет находить или создавать такие системы, где возникают жизнеподобные явления.

ASAL работает на разных субстратах - от классических Boids и Game of Life до Lenia, Particle Life и нейронных клеточных автоматов. В ходе экспериментов метод открыл новые формы поведения в Lenia и Boids, а также клеточные автоматы, способные демонстрировать открытое и сложное развитие, сравнимое с «Жизнью» Конвея.

Это открывает путь к ускоренному исследованию искусственной жизни и автоматическому открытию новых «жизнеподобных» систем, которые раньше приходилось искать вручную.

✔️ Еще Qwen представила свою новую флагманскую модель Qwen3-Max, сразу доступную без ограниченного превью. Линейка включает две версии: Qwen3-Max-Instruct, ориентированную на кодинг и агентные задачи, и Qwen3-Max-Thinking, оснащённую инструментальным использованием и «heavy mode» для сложных сценариев.

По результатам тестов Qwen3-Max выходит на уровень топовых моделей на таких бенчмарках, как SWE-Bench, Tau2-Bench, SuperGPQA, LiveCodeBench и AIME25. Модель построена на масштабном датасете и опирается на значительные вычислительные мощности как в предобучении, так и в RL.

Компания позиционирует Qwen3-Max как новый флагман и открывает доступ сразу на нескольких платформах: в Qwen Chat, через API Alibaba Cloud и в блоге разработчиков.
X

✔️ Отчёт Google DORA показал: 90% IT-специалистов уже используют ИИ в работе, что на 14% больше, чем год назад. В опросе участвовало почти 5 тысяч разработчиков, и в среднем они тратят около двух часов в день на взаимодействие с AI-инструментами.

Доверие остаётся ограниченным: 46% доверяют «отчасти», 23% — «немного», и только 20% - «сильно». Это объясняется частыми мелкими исправлениями после автогенерации. Влияние на качество кода оценивается сдержанно: 31% видят лёгкое улучшение, 30% — «без изменений». Зато ощутим рост скорости за счёт снижения рутины.

На рынке труда обстановка сложнее: вакансии для новичков сократились на 71% с 2022 года, а кандидаты подают сотни заявок, прежде чем получить работу.
Report

@ai_machinelearning_big_data

#news #ai #ml
  • ❤ 5
  • 👍 1
Post #1186 2.15K
🤖 Исследование показывает: влияние генеративного ИИ на рынок труда нельзя свести к «увольняет или создает рабочие места». Реакция проходит в три стадии:

1️⃣ Вытеснение — сразу после внедрения ИИ растут увольнения в сферах, где автоматизация заменяет людей.

2️⃣ Пауза и неопределённость — меньше вакансий и меньше увольнений по собственному. Работодатели не знают, какие навыки нужны, а сотрудники боятся менять работу без ясных перспектив.

3️⃣ Медленное восстановление — только через 12–18 месяцев найм начинает расти, но гораздо скромнее, чем были потери. Это связано с тем, что компаниям нужно время перестроить процессы и встроить ИИ в работу.

📊 Такой трёхшаговый паттерн — вытеснение, сбой координации и задержка восстановления — и есть главный вывод работы.

🔗 Подробнее: https://papers.ssrn.com/sol3/papers.cfm?abstract_id=5367192
  • ❤ 4
  • 😁 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →