TGViewer
Channel Public Channel
Не AБы какие тесты

Не AБы какие тесты

@abba_testing

Канал - оголтелая реклама курсов по A/B, ну еще размышления по A/B, статистике и не только.

https://t.me/smatrosov - до связи
Subscribers
1.8K
Photos
82
Videos
0
Links
71
Recent Posts 19 shown
Post #155 826
Привет, товарищи-статистики!

Обживаем Новый дивный мир аналитики в эпоху ИИ-агентов: не так давно в рамках должностных инструкций "агентная аналитика" стала официальной частью требований к DA/PA/DE, да в целом ко всем аналитикам. Поэтому кое-что понимать по этой части надо. 

Внутри моих команд формируются практики и инструменты, которые вот-вот станут ожидаемым стандартом работы. Этим всем и хочу поделиться, должно быть полезно:

1) Плагин Zoo в VS Code, через него по API подключаем LLM и можем работать с ней в режимах Ask / Code / Architect / Debug и тд.

Модель может быть либо внутренней, либо внешней, но с принятием ответственности (доп. согласшение) за утечку данных в последнем случае. Впрочем, тут может помочь согласованная безопасниками внутренняя прокси, которая будет маcкировать данные

2) MCP серверы как расширение для п.1. MCP = Model Context Protocol, - звучит-то как, - нужны, чтобы давать возможность нейронке ходить куда-либо и выполнять какие-либо действия в рамках вашей инфраструктуры, локальной или корпоративной. Скажем, делаем MCP сервер, который позволяет LLM’e смотреть репозитории в Git или задачи в таск-трекере, MCP для подключения к данным в БД. 

Пример: с подключенными MCP можно попросить агента в Zoo Code посмотреть новые задачи по своей колонке таск-трекера, а потом найти информацию по конкретным витринам данных, сделав SQL запрос согласно стандартнам, описанным в репе.

В гите можно сделать папку Skills (скиллы), в которой лежит инструкцией в .md формате (нейронки их любят) и вспомогательными файлами: примерами, шаблонами, скриптами. Внутри может быть написано, как выполнять повторяющуюся задачу, как оформлять и тд. Это просто по сути текст, которому следует модель. Задача скиллов в том, чтобы не давать модели одну и ту же инструкцию самостоятельно. Можно сделать целый репозиторий со скиллами для своей команды, чтобы все могли их переиспользовать и улучшать.

Вообще, MCP любят разворачивать и компании для клиентов: например, пускай есть такой сервис у ритейла, обращается к нему через агента с запросом “собери всё для пасты Алио и Олио”, он сам собирает тебе корзину и все. Никаких заходов в приложение / сайт. Что наталкивает на мысль об образовании в скором будущем доли цифровых клиентов, которые НЕ будут обращаться к приложению/сайту вообще. 

Если задуматься об этом поплотнее, то сегментов будет скорее два:
1) люди, которые любят использовать ЛЛМ-ассистенты в приложении / на сайтах для заказа
2) используют исключительно своих агентов, которые через MCP подключаются к любым сайтам / сервисам для заказа

Первым нужно давать токены, так как они будут работать с ИИ-шкой на стороне компании - последним приготовиться к своим датацентрам!, - вторым не нужно ничего кроме MCP. Отсюда же это сказывается на компаниях: в дата центры свои не смогут лишь все, увы. 

Подумайте над этим - готов ли ваш продукт/бизнес к этому?


3) (Опционально) накидываем Superwhisper, скачиваем Small модель, проговариваем masterpiece промнт, вставляем, закидываем нога на ногу и таска выполняется

На самом деле вы, конечно, должны будете сделать ее ревью, прежде чем сквозь гнев и отрицание сделать действие - пошевелить мышкой и отправить таску в done, а иначе вы не будете отличаться от "meat proxy", но таковы тяжести современного аналитика!

Если вы еще это не сделали, потратьте пару дней, чтоб разобраться
—

AI поменял рынок найма, безусловно. Также, как когда-то его поменял SQL, Python: сначала это было желательным в связке с Excel, а потом и вовсе требованием. Теперь в этот ряд, - замечу, не вместо всего этого, а вместе со всем этим, - добавились еще вот эти 2-3 пункта. За те же деньги, даже ветки сверху не накинут :)

И требовать все прочее имеет смысл: Ой-Ай позволяет быстро развернуть MVP (от идеи до релиза пара промтов), а вот продуктивизация - это совсем другое дело. Особенно весело, когда всё сломалось и надо ручками это починить.

Другое дело, что проверять это надо иначе, старая воронка с лайфкодингом и алгоритмами никуда не годится, это и без того насилие, так в эпоху ИИ еще и бессмысленное.

Как проверять? Пока идей тут у меня две:

1. Брат (в рамках разработки) недавно рассказал интересный способ проверки, который мне запал в душу: показываем некоторое уже написанное решение задачи (написанное немного странным мидлом), просим прокомментировать всё то, что кажется странным и пр. Конечно, это задачу можно даже сфотографировать и отправить в ИИ, вопросов нет, но в рамках живого диалога говорить и читать будет крайне сложно, тем более можно легко челенджить вопросами туда-сюда так, что ИИ не поспеет (но если, ЕСЛИ (!) кандидат найдет способ справится, значит, он крутой и его тем более надо брать)

2. Тестовое. Да-да, именно тестовое а-ля дизайн AB от и до. Но с двумя особенностями:
- Ограничение по времени, скажем, 3 часа (время идет с момента нажатия на какой-то форме "Старт")
- История промнтов с ИИ (как правило, ими можно делиться)

Скорее всего, как всегда, не все ответы будут правильными. Скорее всего промнты будут уровня masterpiece "сделай тестовое". Это - первый фильтр. Второй - это, конечно, защита решения, где могут быть неожиданные вопросы и пр., которые по-быстренькому уже нейронку не спросишь. 

Получается такой гибрид с кейсом. И с учетом того, что защита всегда важнее, то вес правильного ответа был бы, скажем, 30%, а защиты - 70%. Такое сочетание идейно вроде бы удовлетворяет найти прежде всего думающего человека, чем кодящего, так как никто уже кодить как раньше в ближайшее время не будет.

"Раньше было лучше", я понимаю, 3 часа это больше чем 1 час алгосов, зато как в жизни, где есть только ты, таска, ИИ и дедлайн. Защиту же можно, опять-таки, зачесть за разбор кейса, минуя этот этап как вариант. То есть по времени будет плюс-минус тоже самое, проверка вроде бы релевантна духу времени, трат нервов меньше.

Берите на вооружение, привыкайте к новой реальности. Успехов!

P.S. Этот пост вдохновлен работой и комментариями моих ребят, в частности Василисой и Василием
  • 👍 13
  • 🔥 11
  • ❤ 3
  • 😱 2
Post #154 1.39K

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • 🔥 19
  • 👍 1
Post #153 2.09K
Post #152 2.37K
Надо стартовать 11-ый поток "Наглядное АB-тестирование: от основ до современных стандартов" !

Старт планируется примерно в первых числах июня: кому каникулы, кому - учёба!

Список актуальных тем на скрине, о чем они кратко - тут. Отмечу, что теперь есть не только блоки, но и вехи: первая веха про то, что вы обязаны знать в рамках индустрии, вторая про методологию, с которой неплохо бы познакомится, но которая не всегда нужна в бою. Да-да, представьте, любимый ответ Яндекса про свитчбэки не является обязательным для понимания, так как эта малая часть тестов, которые реально запускаются, ну извините! Аналогично и с последовательным тестированием: прикольно, но давайте просто подождем конца теста, ок?

Формат прежний:
- Обучение идет по вечерам, в 19 по Мск, 2-3 раза в неделю, примерно 4 месяца. Будние дни, часто (но не всегда) в шахматном порядке 3x2: понедельник-среда-пятница, вторник-четверг. Обычно порядок зависит от сопряженности тем, где-то может быть и по паре недель по 3 раза + поправка на праздники
- Каждый поток веду лично, оказывая максимальное сопровождение по материалу; веду с удовольствием, в душе педагог; подача такая, будто надо объяснить детям, чтобы они могли объяснить это другим детям
- Можно и нужно задавать вопросы, которые вам кажутся дурацкими, дебильным и пр. Это только приветствуется! Для стесняшек - всегда пожалуйста в личку)
- Все материалы, видео и презентации, будут доступны и после окончания в формате read.
- Цена - 50к

Вы придете, конечно, за AB и получите это сполна, но уйдете на самом деле с гораздо большим - статистическим взглядом на мир и базовым методом науки в кармане!

Если есть желание - пишите мне в ЛС @smatrosov :) По курсу в начале вы будете общаться только со мной (!), далее подключу супругу в помощь по юр./фин.вопросам.

Все официально, есть договор, ЭДО, ИНН: 780535671209; остерегайтесь плохих людей, сам я первый никому не напишу, оплата только через интернет-эквайринг или счет для юр.лиц, никаких "на карту"!

Все отзывы, повторюсь, тут.

P.S. Те, кто писал мне ранее - о вас помню, вы записаны, свяжусь.
  • ❤ 10
Post #151 1.72K
———
Привет, товарищи-статистики!

Возрадуемся, ибо в апреле к науке статистике приобщилось еще группа людей, так как завершился юбилейный 10-ый поток по AB

В этот раз среди компаний были в том числе: JetBraisn, Бургер Кинг Тех, T-Банк, и родимые X5 :)

По обновленным отзывам, - каждый из них дорог мне! - выдел такое:

"Я ушел с полным пониманием как выстраивать АБ среди функций, за которые я отвечаю и на что обращать внимание при масштабировании, какие вещи спрашивать у кандидатов...

... Мне также тяжело судить, поскольку я вне российкого рынка, но у меня сложилось впечатление, что курс очень хорошо подготавливает к поиску работы, откликам, прокачивает резюме, ответы на вероятные тестовые задания и даже готовит к тому что может ждать в tier 1 работодателях...

... Курс поражает своим объемом и детализацией темы, насколько глубоко она прокопана. В каждой презентации — сотни слайдов, что очень впечатляет. Кажется, что этот курс, на самом деле, по наполнению сопоставим с полноценным годовым университетским курсом. Каждая тема проработана очень серьезно, я вообще не предполагал даже что будет настолько серьезно... "

"И вот здесь бы я хотела отметить главную пользу курса - это полноценный курс, без упрощений и насыщенный мат аппаратом, но при этом понятный и последовательный в освоении. К лекциям прилагаются конспекты и саммари, что позволяет быстрее вспомнить предыдущий материал, для меня это было очень важно и удобно. В отличие от всех остальных курсов, здесь уделяется большущее внимание взаимосвязи формул, выводов, обозначений - а это еще более важно на начальном этапе, поэтому этот курс я точно рекомендую новичкам, но и продолжающим не будет скучно с первых лекций, потому что рассматривается не только сухая теория, но и практики в индустрии."

Из замечаний:
- Некоторые темы как FDR во множеством тестировании показались "без задач".

В целом, оно в индустрии действительно без задач, но концепцию знать необходимо, как и её отличие от FWER, а то ведь однажды откроете ее для себя и забьете на FWER, чтоб потом через год к нему же вернуться обратно)

- Хочется большей индустриальных кейсов

Думаю сейчас над этим. Проблема тут в том, в какой это превратить формат и как, если, например, это проговаривать голосом. Делать отдельной встречей или пытаться внести в уже запланированные? Не знаю.

Что вас ждет в версии v11:

1. Вновь переработал резюме: в них стало еще больше доп. материалов, которые я постарался дать ровно тогда, когда обучающийся должен быть к этому готов. Большая часть, конечно, закрывает любознательность, но делает это основательно, чтоб закрыть вопрос от и до (тут отдельно выражу благодарность ученику Никите, который этой основательности сильно поспособствовал!)

2. Стало больше отдельного (вне резюме) материала. Где-то это доп. шпарлагки, - разбор-повторение типичных вопросов из собеседований, - где-то полноценные заметки, например, про подводные камни трансформации метрик

3. Больше кода - больше симуляций. +поправлено ряд багуль :)

4. Опять переработал блок про множественное тестирование и переработаю к моменту соответствующих встреч еще раз, учитывая заметку Spotify, о которой пишет Влад и которую мы вместе с ним перевариваем для нашей внутренней кухни.

5. Помните хедбук про Causal Inference? Было 40 страниц, а стало больше 120 :)
Это часть материалов, поэтому время от времени делаю и его редакцию.

Кстати сказать, часть оттуда была рассказана студентам в ВШЭ, поэтому я уже морально близок к тому, чтобы превратить это в отдельные встречи в рамках данного курса.

Что планируется:
- Байес близко. Знаю, обещаю давно, но тут как столкновение с белыми ходоками: надо подождать n сезонов!

- A/B-платформы: есть у меня мысль как это сделать более предметно, пока не понимаю, получится ли

- Когда-то были приглашенные гости со своим докладом: хочется попробовать воскресить это, дав побольше кругозора участникам

—
В целом, прошедший поток показал мне, что материал созрел и получил достойную выдержку: вносилось минимум правок в слайды, минимум изменений в повествование. Что-то это да значит!
—

Продолжение далее.
Google Docs Все отзывы с курса С актуального 10-го потока Отзыв от JetBrains: https://docs.google.com/document/d/1OiM8i4QLJAUm0N7eTEvYTbmLBZCZTvAr4WexVXL7Nlg/edit?tab=t.0 Далее С 9-го потока Немного обсудили статистику, далее: Предыдущие
  • ❤ 17
  • 💯 1
Post #150 1.7K
Привет, товарищи-статистики!

2-в-1:

Во-первых
, 22 мая в Москве будет конференция AHA-26, одна из двух моих любимых, а потому всегда искренне рекомендуемых от меня, lержите по промокод ABBA10 на скидку 10%. Вот темы докладов, один из них будет от моего подопечного, Никиты Никитченко, "Методология Глобальной Контрольной Группы: оценка эффекта от тысячи кампаний в CVM", - это то, над чем сейчас часть мои ребят плотно работают, и уже готовы поделится всеми пережитым опытом (и чем я дополню материалы курса, конечно).

К сожалению, сам я попасть в этот раз не смогу, но зато могу разыгрывать 1 офлайн билет!

И вот тут уже во-вторых: сейчас через теорию игр (повторяющиеся игры, стратегию конфликта и пр.) учусь решать управленческие кейсы (однажды расскажу подробнее, когда сформилуется) в рамках доменной области, которые подбираю как из личного опыта так и от сообществ, плюс придумываю сам и, конечно, с помощью ИИ.

Предлагаю и вам решить один их них.

—
Итак, вас приглашают в компанию, где все команды катят свои фичи в основном через тесты. Прекрасно, но конкретно от вас хотят, чтобы вы починили давно назревшую проблему в KPI - он завязан прежде всего на стат.значимые зеленые тесты, где далеко не обязательно, чтобы это была финансовая метрика. Также есть ряд особенностей:
- топ-менеджмент в целом любит стат.значимость и верит в предоставляемые цифры
- процесс налажен и согласован, никто не хочет его менять
- тот, кто вам обратился по проблеме, сказал, что ряд еле-еле согласованных ретестов показал невоспроизводимость значимости

Отдельная сложность в том, что вам никто не готов дать безоговорочные полномочия все в корне поменять, - процесс же отлажен и вообще - не беспокойте людей! То есть если вы начнёте вот так сходу чинить методологию, то вас будут саботировать.

Какие конкретные шаги вы бы предприняли, чтобы достичь поставленной цели? Абстрактное про "поменять культуру" не принимается.

Подсказка: я недаром обмолвился о повторяющихся играх, - вам потом с этими людьми работать далее, а систему поменять надо!
—

Победителя к концу недели в воскресение, 10 мая, определю так: будет моя оценка + лайки/позитивные реакции других участников + мнение организатора. Об этом напишу в комментарии в этом посту.

P.S. Кто ждал инфу по новому потоку по AB, - обещаю, скоро! Кто не ждал, тому тоже достанется, рассмотрим очередной последовательный тест
  • 🔥 12
  • ❤ 2
  • 👎 1
Post #148 1.78K
Привет, товарищи-статистики,

Эй-Ай в AB или наконец-то мысленные эксперименты!

Один из моих учеников, (Михаил, привет!) спросил, а можно ли сделать в продуктовой аналитике что-то вроде этого, где есть “миллионы ИИ-ботов со своим характером, паттернами поведения и памятью, которым кидаешь любую инфу или новость, типа нового запрета или повышения цен, и смотришь, как агенты это примут и что будут делать” для предсказания результата.

Ответ “да” мне пришел сразу, так как давно думаю о “бесплатной” проверке гипотез, - с помощью такого hive-mind, аки синтетической фокус-группы, можно делать предварительную валидацию гипотез. Это, конечно, не тест, но некоторое доп. взвешивание, а стоит ли проводить тест в принципе.

Для этого нужно выполнения нескольких условий:
1) история экспериментов, где в каждом дизайне тщательно была описана продуктовая гипотеза, как мы к ней пришли, что делали и пр.

2) таблица, где по каждому пользователю будет написан статус участия его в прошедших экспериментах и индивидуальный эффект, который можно оценить через Uplift-моделирование (для быстрого понимания самый простой метод, S-Learner: проводим AB, накидываем модель на данные по тесту, где есть переменная участия и ряд независимых от теста ковариат, обучаем, меняем в переменной участия статус, получаем оценку контрфакта по каждому юзеру, дельта и есть этот эффект)

3) Описание каждого юзера на базе исследований хотя бы кластеризации, дополнительно его оценки/жалобы/отзывы/результаты опросов

Итого у вас есть по каждому юзеру его профиль и какие-то личные данные, индивидуальная реакция на прошедшие тесты с описанием, о чем были эти тесты. Берете гипотезу, “опрашиваете”, получаете фидбек и оценку от каждого юзера, вуаля, Эй-Ай в AB в действии! Далее можете фильтровать там по скору и пр.

MVP навайбкодил за минут 20, писал в VS, переложил в Colab, используйте свои ключи к OpenAI, должно завестись по идее. Она сгененирует таблицу по юзерам и экспериментах, а потом даст ответы на предложенную гипотезу. Результаты на скринах.

Конечно, есть ряд ограничений:
- Если у вас 100500 юзеров, то опрашивать каждого это дорого по токенам. Нужно тогда брать выборку, стратифицированную по профилям для репрезентативности вашей “генеральной” и уже ее опрашивать.
- Это не замена тесту! Поэтому надо убедиться, что есть сонаправленность такого претеста с реальным тестом. Из-за этого исторические данные в полном объеме для этой hive-модели вы использовать не сможете, иначе у вас не будет на чем тестировать ее, все по классике ML: оцените требование к истории в этом случае! Но даже если в прошлом есть сонаправленность это не избавляет от того, что впредь все будет также, конечно, нет.
- Хорошо бы через UX-исследователей провалидировать выборочно профили пользователей, уточнить их мнения и представления

А вообще, между нами говоря, неплохо бы убедиться, что у вас выполняется хотя бы условие для начала 1), та самая история экспериментов и проработанные хорошо описанные гипотезы, у вас ведь, так, да? …или нет?

В целом, предвижу, что подводных там больше и нужна прям команда с приличным таймлайном под это, но ведь красиво, согласитесь)
  • 👍 12
  • 🔥 7
  • ❤ 2
Post #147 2.12K
Привет, товарищи-статистики!

Во-первых, с Международным Днем солидарности женщин в борьбе за женские права и эмансипацию, 8 марта: твердо убежlён, что в России курс на домострой аки "традиционные ценности", который от которого так и несёт средневековыми нравами, переломится, и люди будут видеть в друг в друге не "баб" и "мужиков", а субъектов.

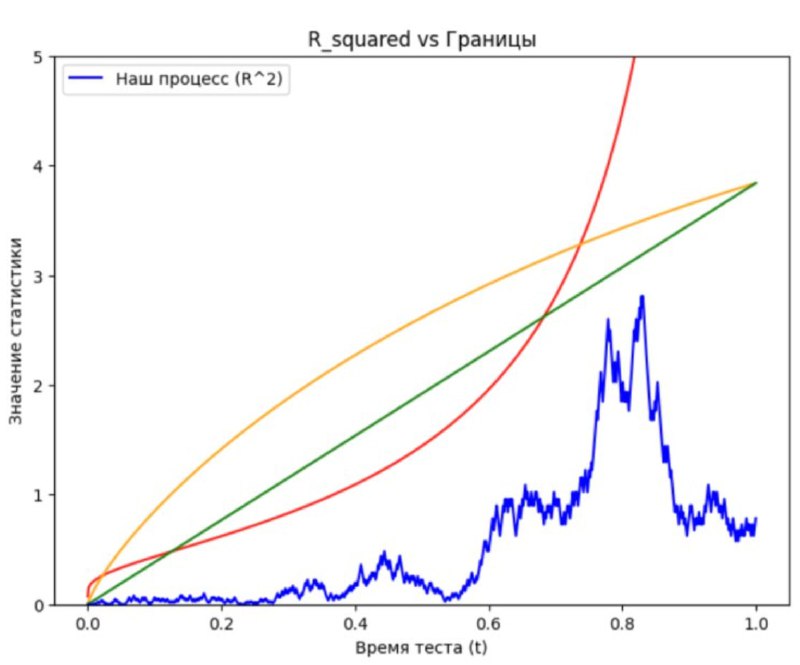
Во-вторых, вот вам тонус на предстоящую неделю: мой разбор критерия последовательного тестирования SRM (Sample Ratio Mismatch, - есть ли перекос от ожидаемого сплита групп), который предложил Виктор Харламов (Math for Impact), см. его презентацию в комментариях, где уж больно интересные темы поднимаются а-ля процессы Бесселя, гёльдеровость и пр.

Попробую, огрубив ряд моментов, погрузить в логику критерия и ряд приведенных понятий, надеюсь, не слишком погрешил против истины.

Приобщиться к случайно высокому
  • ❤ 20
  • 👍 4
  • 🔥 3
  • 👎 1
Post #146 2.19K
Привет, товарищи-статистики! С праздником, днём Красной Армии, днём образования первой регулярной и массовой армии в мире, которая отстаивала интересы трудящихся.

Раз сегодня праздник, то и пост будет несложный, чтоб не прерывал отдых

Когда на курсе я с ребятами дохожу до p-value, мы рассматриваем распределение p-value при верности H0. Оно, распределение, равномерное, и частенько возникает вопрос: но почему оно равномерное? Ведь чаще же значения статистики будут у центра в рамках z-распределения, то есть как будто должно быть больше p-value's около 1 (с перекосом в пользу единицы).

А давайте посмотрим, почему равномерное.
  • ❤ 12
  • 🔥 8
  • 👍 5
  • 👎 3
  • 👏 1
  • 💯 1
Post #145 2.2K
Привет, товарищи-статистики!

Интересный вопрос по базе: почему при средних объемах выборки мы используем t-распределение, если средние уже вроде бы распределены нормально?

Действительно, при некотором объеме выборки (условно 30-50 измерений) у нас соблюдается не только нормальность средних, но и выборочная дисперсия начинает вести себя предсказуемо (моделируется через Хи-квадрат, одно не 1-в-1 с ним совпадает!). Это обеспечивает в принципе t-распределение для большинства случайный величин, то есть что-то универсальное.

Но многих в контексте "среднего объема" выборок ставит в тупик наблюдение о выборочных средних согласно нормальном распределении, значит и перевод в z-score должно давать z-нормальное, однако применение критерия без знания дисперсии генеральной дает именно t-распределение. Почему?

Действительно, наблюдаешь нормальность средних, применяешь z-score = z-нормальное. Но это если есть знания отклонения средних, что на практике невозможно, увы. Однако мы можем использовать оценку отклонения средних, стандартную ошибку: именно это и лежит в критерии в знаменателе.

Сразу скажу, числитель критерия тут почти вообще ни при чём: небольшая выборка может быть весьма непоказательной по среднему, давая большую удаленность, но все-таки львиная доля ответственности в знаменателе, где у нас стандартная ошибка.

И проблема как раз в незнании дисперсии генеральной. Знай мы её, использовали сразу в стандартной ошибке, тогда от выборке к выборке у нас было бы константное значение, константа же тем и хороша, что означает отсутствие вариации. Критерий давал бы z-распределение, так как постоянно бы делили на одно и тоже значение при фиксированном размере для всех наших выборок.

Вместо этого мы вынуждены использовать _оценку_ стандартной ошибки (еще раз: оценку оценки) в знаменателе, где мы используем выборочную дисперсию. При небольших объемах эта выборочная дисперсия очень шумная, она сильно варьируется, при чем достаточно специфическим образом, на уровне приближения мы моделируем ее поведение через Хи-Квадрат, см. картинку (повторюсь сама она не совсем так распределена, но это уже духота), а у этого распределения при малых степенях свободы значения в массе своей лежат у нуля.

То есть: вы подставляете в знаменатель значения, близкие к нулю, а при делении на очень малое значение вы как результат получаете очень большое значения (в пределе бесконечность), вот вам и объяснения длинного хвоста. Но так как у вас бОльшая доля значений дисперсии около нуля, то подставляете в знаменатель близкие к нулю чаще прочих, оттого хвосты не только длинные, но и еще и толстые. Значения числителя, будь они даже около маленькие, "вымываются" из центра кратно меньшей дисперсией (чаще всего), делая центр более приземистым: он будет ниже и менее плотным в сравнении с нормальным, так как все уйдет в хвосты.

В этом смысле t-распределение хорошо абсорбирует шум от выборочной дисперсии небольших выборок, оно естественным образом дает нам необходимый запас осторожности (консерватизма), пока выборка мала. При n -> бесконечность, выборочная дисперсия будет приближаться к истинной, то есть практически не колебаться, а значит от выборки к выборке мы будем делить по сути на саму дисперсию, что и хочет от нас как раз z-критерий, поэтому t станет z! - то, с чего начинался пост.

Можно сказать пафоснее: t статистика это есть нормированная z статистика и при стремлении n в бесконечность у нас нормировка, - отношение дисперсии истинной на дисперсию оцененную, - превращается в 1. Такие дела)

P.S. Что такое средняя выборка вопрос риторический и зависит от природы данных, готовых ответов у меня тут для вас нет: собирайте данные вашего домена, исследуйте.
  • ❤ 15
  • 🔥 2
Post #144 2.33K
Привет, товарищи-статистики!

Влад опять сделал это: нашел новую свежую статью, которую я коротко окрестил бы как "точки над CUPED". Пока Владислав пилит свой пост на тему как статьи, так и CUPED (ожидайте!), я отмечу самое примечательное на мой взгляд:

1) Начнем с того, что китайцы, выделили два вида симуляций: DBF - Design-Based Framework и MDF - Model-based framework.

Во время теста мы, как правило, случайно сплитуем пользователей в группы A и B, то есть у нас есть механизм назначения - рандомная сплитовалка, это раз.

Второе, модель генерации данных / модель, порождающая данная: во время симуляции мы можем задать популяцию на основе нормального распределения с Mu=24, sigma=2, то есть наша популяция (данные) будут порождены (сгенерированы) моделью N(24, 2)

population = np.random.default_rng().normal(mu_H0, sigma, population_size)
sample_based_on_population = np.random.choice(population, size = sample_size)


Далее мы брали выборки из этой популяции (тогда она сама бы была порождающей данные)
Но... а что если сразу задавать модель генерации данных на уровне выборки? Те же N(24, 2), только всего, условно, пара-тройка измерений?...

sample_based_on_model = np.random.default_rng().normal(mu_H0, sigma, sample_size)


Вот об этом и речь, что есть два подхода к симуляции, которые могут давать разные результаты при проверке работоспособности критериев:

1.1. DBF - Design-Based Framework, это подход к причинному выводу и статистическому анализу,
в котором единственным источником случайности считается механизм назначения (сплитовалка),
а не модель генерации данных

1.2. MBF - Model-based framework (модельно-ориентированный подход) - это подход к статистическому выводу, в котором данные рассматриваются как реализации случайных величин (в рамках выборок),
порождённых некоторой вероятностной моделью, а случайность исходит от процесса генерации данных, а не от сплитовалки.

При этом вся математика с ее E(X)=... построена именно на Model-based: поэтому если вы хотите обобщения корректности выводов вашей придумки для всех-всех, то надо обязательно доказывать корректность модели на MDF подходе, иначе вы просто доказали, что это работает в рамках вашей оценки ген. совокупности (DBF), то есть только для вашего случая (!)

В чем разница в рамках результатов симуляции-то?
MDF cимуляция каждый раз генерирует _новые_ данные. Если в модели заложен тяжелый хвост, выбросы будут приходить всегда вне ограничений по удаленности, но такое ограничение как раз будет при DBF (=просто популяция, мы делаем ее большой, но не бесконечной, а значит и не весь хвост соберёем). Используя MBF там, где надо DBF (а мы всегда в этом формате работаем), можно получить слишком много шума (=большая дисперсия), то есть.

Коротко: сначала проверка через Model-Based framework, а потом на Design-Based Framework на своих исторических данных; в случае же чистых симуляций, если у вас n очень большое, то особой разницы уже не будет.

2) Китайцы вывели поправку для theta (это такой коэффициент, который оптимальным образом позволяет ковариате минимизировать дисперсию), когда мы считаем ее отдельно для контроля и теста.

Всего есть три сценария расчета theta, которые вызывали (кажется, до этого момента) споры в индустрии:
1. theta сразу по всем данным теста и контроля, - используют Booking, Walmart, Statsig (Стасик, Стасик, Стасик, - сможешь ли ты меня остановить!?)
2. theta "усреднённая" (pooled) по тесту, контролю, - Netflix, Airbnb
3. отдельно по данным групп, - запрещенная в РФ Meta, Microsoft; эта theta как раз спорная, так как при не шибко больших выборках и MDF может быть смещенность дельты (не совпадать с истинным, например, нулем при отсутствии эффекта).

Но:
- cкриншот показывает, что 3-ая при DBF менее конвервативна и самая мощная из всех
- самое важное: китайские братушки вывели поправку для дисперсии разниц CUPED, чтобы не бояться bias'a! И при этом вывели они просто через базу в статистике! Ту самую, которую скипнуть бы и обмазаться сразу кьюдеп-х*юпед. Оказывается, нельзя! База всему голова.

Проникнуться гениальностью вывода
  • 👍 11
  • 🔥 6
Post #143 2.09K
Привет, товарищи-статистики!

Вот и прошла первая рабочая неделя января, а значит, наконец-то можно поговорить об итогах прошлого года и планах на грядущий.

1. Head of Analytics CVM (коммуникации) - это моя новая роль в X5 с прошедшей осени.
Ох, что сказать про роль хеда в целом?

Это достигнутый предел для набора ваших хардовых знаний, дальше только их сплошная стагнация: SQL, Python деградируют, всякие навыки работы с API, данными и пр., сложно будет обновлять, развитие только "это новая штука работает по аналогии как-то так", ручками уже не потрогаешь. И помочь ты можешь подопечным только тем, что не выветрилось.

Еще стоит учесть, что "нельзя взять так просто и вернутся в лиды/синиоры". Начнется: нуууууу, нам нужен играющий тренер и всё такое.

Звучит как риски? Да, поэтому в вас должно быть то, что их балансирует.
- Вы хотите этой роли, потому что знаете что сделать, но сделать это своим рукам или небольшим коллективом просто невозможно

- У вас есть желание получить навыки управления. Я вот думал, а есть ли математике место в управлении; все, что приходило в голову раз за разом на эту проблему это теория игр, но я не развивал эту мысль далее one-shot игр. А потом понять, что управление это repeated game, где есть память агентов, адаптация и пр. И вообще "Стратегия конфликта" Шеллинга и повтор азов из теории игр всё мое) Пока так скажу: действовать по Шеллингу кажется ну максимально контринтуивно, однако потенциально очень эффективно. Когда буду готов, расскажу больше.

- С точки зрения хардов в рамках нашего домена аналитики это уверенность в статистики. Её нельзя забыть, можно только не знать. Скорее всего вам придется заниматься ей больше, так как вы будете конечным согласующим: лично у меня стало вопросов методологии кратно больше прежнего!

- Если вам достаточно а) мат. доказательства б) исследование, сделанное вашим коллегам, которое вы оцениваете в) вам жутко лень было бы делать это исследование самому, так как давно нет восторга от "реализовал сам" и вообще, сама идея лучше любого воплощения, то... вы созрели.

2. Прошлый год это год также методологии: например, кумулятивных эффектов, которым теперь официально используются в оценке эффектов в приложении, адаптируют по индустрии в целом (например, Ozon).

Еще в нашем аналитическом дискурсе появилось "разложения Эджворта", которым в этом году Владу возможно решит для X5 проблемы с малыми выборками при неизвестной природе данных. Кратко, разложение исправляет ассимметрию t-статистики от ненормальных случайных величин. Надеюсь на его с ребятами исследование, идея вдохновляет.

Стало больше Causal Inference в силу продуктовый кейсов. Очень вероятно, что у нас появится реализация Interrupted Time Series, но и тут всему своё время. И да, интересная тенденция, что про CI теперь в вакансии пишут отнюдь не одной строкой

Наработок оценки эффектов у X5 выше крыше: для магазинов, приложений и веба, CVM. Надеюсь, я с ребятами сможем явить людям в этом году методологию приложения и CVM на хабре!

3. Уже скоро стартует не только мой юбилейный поток по AB (подумать только!), но и оффлайн обучение питерских студентов ВШЭ по базе ML для экономистов. Буду вести с коллегой Виктором по субботам, живая аудитория, возможность интерактива и пр., - красота. Давно мечтал и вот, пожалуйста!

Вообще, с энтузиазмом берусь помогать ребятам, - запросов в 25-ом хватало! - ведь обучение никогда не одностороннее, иногда спрашивают такое, что думаешь, "действительно, а почему так?". Ну, конечно, странно, если бы такое было после каждого вопроса :), но именно в обучении других ты сам переобдумываешь то, что отдаешь. Учите и сами мудрее станете)

4. Инструменты 2025: Gemini, GPT и Kонтур.Толк
Кидать в Gemini видео из ютуба для резюме бесценно. GPT - ну просто перекрёстно вместе с Gemini спрашивать по одной и той же теме)

Толк оказался идеальной заменой MTS Link, как минимум он сразу пишет + отдает видео встречи в сжатом виде (у MTS надо было отдельно конвертацию кликать). Говорят, у Толка классная продуктовая команда!...

Что ж, начинаем 2026, удачи нам всем!
  • 👍 30
  • ❤ 17
  • 🔥 2
Post #142 2.15K
Привет, товарищи-работники!

Перед итогами года я хотел бы представить свое видение 2026-го года в контексте прежде всего работы. Кратко: считаю, что для трудящихся всё будет сложнее, чем в этом, но Эй-Ай нас не заменит.

Часть-1:
Текущая экономическая реальность представляет собой рост непроизводительных, то есть военных расходов из-за СВО, рост фискальной нагрузки (утильсбор + будущий технологический сбор и, конечно, НДС с сокращением "льготной" оборотки), высокая инфляция (расчёт ее официальным способом видится непоказательным), ставка ЦБ и курс рубля. Это не может не сказываться на индустрии, так как всё это бьёт по возможностям что-то купить большей части трудового населения.

Слово, которое я чаще стал слышать за последние полгода в рамках IT (через сообщества, людей и пр.), это "оптимизация". Сейчас речь прежде всего идет о сокращении бюджетов на мало перспективные проекты с переброской людей на что-то более обещающее. Пока не про сокращение ФОТ, но на увеличение команды смотрят с большей осторожностью.

Отсюда рекомендую:
1) получше спланировать свои расходы в будущем году, постарайтесь сохранять часть средств как финансовую подушку.
2) семь раз подумать, прежде чем вот так просто уходить с работы, особенно в никуда. Рынок труда сейчас, во-первых, рынок работодателя, во-вторых, людей ищут как будто меньше, часто слышу про фризы и пр.
3) если вы хотели как-то имеющиеся средства приумножить, но у вас их не с десяток миллионов, то лучше вложить их в образование. Это ничего не гарантирует, но хотя бы держит в тонусе ваш головной мозг.
4) если не хочется в образование, а денег все равно не с миллионы, то может имеет смысл уже позволить себе что-то, что давно хотели. Скорее всего дальше будет просто дороже, может, кратно. Это не противоречит с пунктом 1 при условии, если вы и без того откладываете на подушку. Если не откладываете, то лучше, как мне кажется, все-таки фин. подстраховка: цикл поиска нового места может занять больше, чем вы думаете сейчас

Часть-2:
Изменилось ли что-то по ожиданиям от кандидата в DA/PA ? На мой взгляд все, что писал тут, осталось верным и сейчас, но есть дополнений

Три обязательных навыка осталось как есть: Python, SQL, мат.cтат. Все они имеют одинаковую важность, но не одинаковую сложность освоения. Первые два набиваются через практику: кодим, делаем запросы, повторяем, результат.

А вот мат. стат всё-таки сложнее, не сильно, но сложнее.
Если вы метите в "просто синиоры", то базы+ряд продвинутых тем более чем достаточно. Это у нас понимание классической вероятности,условной вероятности, теоремы Байеса, дизайн тесто, t-test (+требования к нему), p-value, ошибки 1/2-го рода и пр. Провинутое это бутстрап, линеаризация, CUPED. На самом деле не так много, как кажется, поверьте.

Если вы хотите быть принципалом или методологом, понадобится раза в 2 больше, где нижняя планка показателя состоятельности это стоическое отношение к формулам (допускается сказать "пу-пу-пу"). Эти люди позволяют бизнесу считать сложные вещи правильно. Другой вопрос, что несмотря на то, что такие люди на рынке уже не первый год, спрос на них даже не начался! Просто сложных вещей не так уж много возникает из года в год. Там достаточно небольшой группы таких мозговитых, которые нанимают себе зрелые компании такие как X5, Авито, T-Банк и пр., остальным достаточно перенимать выработанную практику и нормально делать базу.

По базе, кстати, мой тех.лид Никита однажды совершенно справедливо сказал так: "все эти кьюпеды-хуюпеды, конечно, классно, если вы провалили базу, то это всё бессмысленно, так как подаете на вход в кьюпед заранее херню", - чем дольше работаю, чем ярче эти слова откликаются во мне.

Часть-3
Нейронки меняют найм, работу и привычный рост ребят от джуна и далее. Кратко, джунам тут уже не место, но и о замене всех не идет речь. Об этом написал далее: https://telegra.ph/GPT-ehto-instrument-a-ne-zamena-ne-vseh-12-30
Telegraph GPT: зоноза в найме и всего лишь инструмент Найм Лайкодинг Чаты влияют на лайфкодинг. Скажу сразу, у меня есть смещение, я терпеть не могу лайфкодинг по ряду причин: Это не репрезентация того, как человек работает. В рамка работы за вами никто не смотрит через плечо по каждой вашей таске (если смотрят…
  • 👍 21
  • ❤ 11
  • 💯 3
  • 🔥 2
Post #140 2.06K
Привет товарищи-статистики!

Последние дни декабря "очень продуктивны", поэтому вот вам новое на почитать "в обед".

Одно из самых занимательных в статистике, на мой взгляд, это то, а как вообще люди, чьими именами часто названы критерии, эти самые критерии вывели. К сожалению, обратная инженерия стат. теста не всегда может быть точна и будет отличаться от того, как оно было на самом деле.

И вот случай, а точнее вопрос про выбросы, заставил меня задуматься над совершенно другим, но связанным с выбросами проблемой - показательностью обычного среднего. То есть насколько вообще целесообразно использовать среднее, когда налицо есть выбросы. Очевидно, если у нас есть ряд [6, 7, 8, 9, 10, 100], то среднее = 23.3 так себе смотрится.

И как результат родил "критерий" показательности среднего как меры: результат наивный, требующим ряда проверок и пр., да и вообще, скорее всего нежизнеспособный. К тому же есть коэффициент вариации. Но для вас он полезен как раз другим: возможно, я смог показать рождение критерия. В статье расскажу как думал над ним, как несколько раз уходил не туда (и не факт, что "туда" как раз пришел), возвращался к началу, корректировал статистику для учета ряда нюансов и пр.

Рожаем критерий показательности среднего

P.S. Напоминаю про неспешный набор на 10-ый поток по AB и статистике, пост выше :)
Telegraph Как придумать свой критерий, не привлекая внимания статистиков Важное Для понимания, cтрого говоря, критерий это в том числе про исследование поведения рассчитанной функции от выборки, то есть статистики, в рамках случайного результата при некотором начальном состоянии получения выборок. Например, мы считаем разницу…
  • ❤ 8
  • 👍 1
Post #139 2.34K
Пора стартовать 10-ый поток "Наглядное АB-тестирование: от основ до современных стандартов" !

Старт планируется примерно в 20-ых чисел января, как раз все придут в себя после праздников и я тоже.

Список актуальных тем на скрине, о чем они кратко - тут.

- Обучение идет по вечерам, в 19 по Мск, 2-3 раза в неделю, примерно 4 месяца. Будние дни, обычно (но не всегда) в шахматном порядке 3x2: понедельник-среда-пятница, вторник-четверг
- Условия неизменны: "каждый поток веду лично, оказывая максимальное сопровождение по материалу; веду с удовольствием, в душе педагог; подача такая, будто надо объяснить детям, чтобы они могли объяснить это другим детям"
- Можно и нужно задавать вопросы, которые вам кажутся дурацкими, дебильным и пр. Это только приветствуется! Для стесняшек - всегда пожалуйста в личку)
- Все материалы, видео и презентации, будут доступны и после окончания в формате read.
- Цена, с учётом юбилейного 10го я сохраню 45к, на 11-ом планирую повышение!

Если есть желание - пишите мне в ЛС @smatrosov :) По курсу в начале вы будете общаться только со мной (!), далее подключу супругу в помощь по юр./фин.вопросам.

На всякий случай: все официально, есть договор, ЭДО, ИНН: 780535671209; остерегайтесь плохих людей, сам я первый никому не напишу, оплата только через интернет-эквайринг или счет для юр.лиц, никаких "на карту"!

Все отзывы, повторюсь, тут.

P.S. Те, кто писал мне ранее - о вас помню, вы записаны, свяжусь.
  • 🔥 8
  • ❤ 7
Post #138 1.99K
———
Привет, товарищи-статистики!

Аллилуйя! В декабре свидетелей статистики стало больше, завершился 9-ой поток по AB. Неожиданно, но половина людей пришли в рамках обучения от компаний: Авито, Литрес, Контур, Крейзи Панда пр., - наверное, это что-то да значит)

По отзывам в этот раз отмечу вот такое: "самое главное, что после курса появилось желание разобраться и тратить время на прикладную статистику" (это при том, что у человека за плечами было 1.5 года оной в вузе, тогда она казалась ему мёртвой)

Из того, над чем мне надо поработать:
- автоматизация проверки ДЗ. Да, ДЗ теперь есть, они с некоторого момента про сплошной дизайн, реальная практика как и хотели. Однако с моей стороны есть еще внутреннее сопротивление дз вообще, поэтому я задерживал проверки/

- темп повествования и местами дикция, тут еще думаю, как улучшить, ищу материалы

Из примечательного вам на заметку: нагрузка на участника составляет 7-8 часов в неделю (львиная доля это встречи)

Что вас ждет в версии v10:

0. Теперь есть симпатичные сертификаты по окончанию :) Могу выписать всем желающим, что были до)

1. Переработанные резюме каждой встречи, туда же теперь добавил ряд доп.материалов, которые не обязательны для курса, но существенно расширяют кругозор по статистике, математике, теорверу.

2. Помимо резюме для ряда встреч будет прям отдельный материал, рекомендованный для ознакомления: он будет больше про науку, ее методы и пр., большее погружение в Байеса

3. Также есть теперь срезовые шпаргалки: например, после завершения базы (это ~15 встреч) есть отдельная дока - разбор-повторение типичных вопросов из собеседований

4. Стало больше кода (линеаризация, дельта-метод, бутстрап), добавились симуляции, которые численно доказывают ряд утверждений про ЦПТ, ЗБЧ и пр.

5. Текстовые заготовки до и после встреч занимают теперь еще на 30 страниц A4 больше (в сумме 160). В них мы вспоминаем школьный курс алгебры (если требует тема), читаем интересные заметки для любознательных и пр., которые релевантны моменту и теме, конечно.

6. Разбил пару встреч на две, теперь точно каждая из будет в среднем 1.5 часа, то есть риск вскипания будет меньше)

7. Вновь переработал блок про множественное тестирование: ну теперь там прям совсем последовательно и дозировано, стало больше доказательств, четко разделены подходы FWER и FDR

8. Начал раскрывать особенности AB в индустрии: какие бывают особенности, какие могут быть коллизии (пересечение тестов, эффекты текущих тестов на прошлые и пр.)

9. Улучшил и углубил материал по дельта-методу: все-таки это очень важная тема в рамкам статистики, ей стоит упороться больше!

Что планируется:

- Все также рожаю A/B по Байесу. И сейчас-то немало байесианства вплетено в повествование (ба, да ты еретик), но отдельной прям встречи еще нет.

- Пытаюсь добавить материал про A/B-платформы

Встречи будут теперь как в лучших домах индустрии - в Talk от Контура: это действительно классный отечественный продукт!

—
Вообще, с учетом всех доп.материалов, углубления в методы в рамках встреч, понимание AB и умение его проводить - это лишь эффект этого курса. Вы, конечно, придете за AB, а уйдете мне теперь в этой жизни все понятно статистиками. Теперь куда с большей вероятностью, чем это было раньше.
—

Продолжение далее.
Google Docs Все отзывы с курса С актуального 10-го потока Отзыв от JetBrains: https://docs.google.com/document/d/1OiM8i4QLJAUm0N7eTEvYTbmLBZCZTvAr4WexVXL7Nlg/edit?tab=t.0 Далее С 9-го потока Немного обсудили статистику, далее: Предыдущие
  • ❤ 16
  • 👏 2
Post #137 2.64K
Привет, товарищи-статистики!

Пост 2-в-1

Во-первых, написал Введение в Causal Inference, выложить пришлось в формате гугл-дока в силу объема: доступ у меня, как говорится, ранний, еще допиливаю время от времени, но как-то больших дополний/изменений за последнее время не было да и не предвижу. Есть возможностью комментирования, - так мне можно помочь пофиксить чушь.

Постарался на 35+ страницах максимально мягко погрузить в тему, покрыть теорию настолько, насколько это позволит вам уверенне поступиться к практике. Надеюсь, вам понравится и пригодится!

—
Во-вторых, завтра будет моя любимая конфа, "Матемаркетинг 25" (ссылка на программу), там расскажу (также завтра) про расчет кумулятивных эффектов в X5 в мобильном приложении: доклад будет полезным тем, кто внедряет методологии по оценке эффектов. Я считаю, что вы можете после доклада не только понять его (сделаю всё-всё возможное + можно будет поговорить после), но легко переиспользовать через:
а) приложенные примеры в спредшитах/колабе
б) презентацию -> там полное и детальное доказательство подхода, копируйте -> представляете как готовую методологию

Есть промокод: ABBA10. Цена билета дорогая, но тут как и всегда расчет на то, что это оплатит ваша компания. И как всегда, повторю, ММ как и Aha стоят того, чтобы посетить: это как большой синк, который вы искренне ждали. Много ли таких? То-то!
Google Docs Causal Inference Последняя редакция: 28 августа 2026 См. тут Написать автору, тг @abba_testing, @smatrosov Оглавление Оглавление 0 Изменения 5 Вступление 8 Вероятный сценарий для CI 8 Сценарии для CI 8 Подводный камень Observed Data (Примеры) 9 Еще примеры 12 С другой стороны…
  • 🔥 41
  • ❤ 14
  • 👍 3
Post #136 2.5K
Доверительные интервалы, часть 2

Привет, товарищи-статистики!

Можно ли при стат.значимом результате добирать аудиторию для получения более суженного доверительного интервала эффекта? Хороший вопрос, так как кажется, что тут нет никакого подвоха, результат-то стат. значимый, можем открывать шампанское и вообще. Но все не так просто.

1) Концептуально, мы не застрахованы от того, что наш результат это ошибка 1-го рода, отсюда это мало чем отличается от обратной ситуации “донаберем данных до стат. значимости”. Стат. значимость не делает эффект достоверным, нам просто так удобнее думать.

2) Мы продолжим работать с условными CI, что охватили истинный эффект, то есть с 95 из 100, но после донабора охватывать истинный эффект будет уже 94. И вот тут вряд ли есть где-то ошибка в очень дубовой симуляции.

Почему так происходит? Дело в том, что каждые новые данные это реализация случайной величины с определенным разбросом, отсюда CI не только сужаются, но и колеблются, а поэтому из CI, которые уже охватили эффект, могут не охватить при новом наборе данных.

При этом CI как механизм охвата истинного параметра не сломаются, полна группа такая после добора:
CI охватил эффект | CI охватил эффект = 94,
CI не охватил эффект | CI охватил эффект = 1
CI не охватил эффект | CI не охватил эффект = 4,
CI охватил эффект | CI не охватил эффект = 1

Чуть перетасуем и получим более читаемый вид:
CI охватил эффект | CI охватил эффект = 94,
CI охватил эффект | CI не охватил эффект = 1

CI не охватил эффект | CI охватил эффект = 1
CI не охватил эффект | CI не охватил эффект = 4

п.2 порождают риск того, что ваш следующий интервал будет не стат. значимый. И что вы будете делать тогда? Мета-анализ зависимых гипотез? Но был ли он у вас в дизайне? Сможете ли вы его объяснить заказчику?

Я думаю, запланировать донабор возможно, но это потребует корректировки альфы и мощности; можно запланировать и мета-анализ. Просто это выглядит избыточным, мудреным и абсолютно не нужным. А незапланированный набор выглядит как, грубо говоря, подлог, который нужно штрафовать на уровне оценки объективности теста.

Если вам нужен узкий доверительный интервал, то на этапе дизайна:
- обратите внимание на то, что стандартная ошибка (вшитая в CI, если что) пропорциональна 1/корень(n). Это значит, например, увеличение в 2 раза выборки приведет только лишь к сокращению в 1.41 раза ширины CI, то есть на ~29%:
1/корень(1) - 1/корень(2) = 1 - 1/корень(2) = 1 - 0.71 = 0.29

—
Пользуйтесь эвристикой, вывод ее простой, сначала обобщим пример выше:
1 - 1/корень(1+k) = d, где d - доля снижения, где k - наш множитель

Через ряд алгебраических преобразований, мы получим:

k = (1 / (1-d) )^2, - смотри картинку поста для читаемости

Указывай долю снижения = получай множитель.
—

- подберите прокси-метрику с меньшей дисперсией, сохраняя тот же размер выборки по базовой метрике, но только помните про требования к таковой - связанность и сонаправленность с этой базовой

P.S. И к слову о штрафах. Так как игнорирование дизайна это бич стат. анализа, то уже давно думаю над тем, как внедрить как раз оценку объективности теста. Пока в голове просто прикидка а-ля пускай тест, задизайненный как следует и сделанный как планировалось, имеет объективность 100 баллов. За каждое отклонение, будь то “че-то еще давай посмотрим” или техническая проблема, минус сколько-то баллов. Само собой, не хватает конкретики, за что и насколько будем штрафовать, но мысль уже есть, думаю, рано или поздно что-нибудь да развернется. А если у вас что-то готово, делитесь :)
  • 🔥 12
  • ❤ 2
  • 👍 1
Post #135 2.48K
Привет, товарищи-статистики!
Поговорим про доверительные интервалы.

По окончанию теста мы всегда строим доверительный интервал эффекта с заданным уровнем надежности, который согласно заранее выставленной альфе равен 1 - альфа, пускай у нас он вышел 95%.

Внимание, вопрос, сколько раз такой интервал при стат. значимости охватит истинный эффект, если мощность = 80% ?

Так как уровень надежности и мощности независимы, то P(CI охватит Mu_эффект) * P(CI стат.значимый) = 0.95*0.8 = 0.76, то есть всего в 76%*. Это кажется как будто контринтуитивно, но дело в том, что прочие 4% стат. значимых интервала как раз не охватывают эффект и, в таком конфиге, переоценивают эффект, см. картинку.

Почему нет интервалов между нулем и эффектом? На самом деле редко-редко, но они проскальзывают в симуляции, а их отсутствие в подавляющем объясняется так: чтобы такой CI получился, у вас должны собраться обе выборки с малой дисперсией, при этом А, которую мы берем из одного распределения, должна быть больше своего 50-го перцентиля, а B - меньше своего 50-го.

Но полезнее все-таки информации 76 на 4, как минимум это мы можем как-то учитывать при расчетах экономической модели.

Что остается нестат. значимыми интервалам? 95 - 76 = 19 из них будут охватывать интервал, а 5 - 4 = 1 - нет (эти цифры - в идеале). Это уже, как мне кажется, не так полезно, но просто интересно.

Ссылка на симуляцию (там* надо играться с seed, чаще 76 будет, для сходимости ровно как на картинке, как мне кажется, надо заряжать еще больше попыток)

Пост появился благодаря Владу в том числе, спасибо тебе за комментарии и уделённое время.

P.S. Спрашивать на собеседовании я это, конечно, не буду.

*Важный UPDATE, возможно, слишком быстрый:
- Рома заставил еще раз задуматься, а все ли верно было рассчитано. У него выходило 77.5, это 80-2.5, где 2.5% значений лежали в зоне HA, которые находятся справа и попадают в 97.5 квантиль. То есть это были бы также "стат. значимые CI" (= не охватывают ноль, считать синонимом), но со значительным перелетом, без охвата истинного эффекта. Мы с Владом начинали с этих 77.5, потому что предполагали, что задача решается исключительно в голове, но симуляции нас заставили задуматься

- Упорно выходили значения 75-76, только оценкой перемножения наступления двух событий сразу вполне объясняло происходящее. И это казалось и кажется все еще логичным. Однако!

- Повторный возврат к симуляциям выявил следующее:
1) если у вас прям очень большие популяции, то изменение дисперсии в большую сторону (sic!) охватывало до 80% эффект согласно мощности. Это кажется логичным, так как такие популяции с большой дисперсией сильно разряженные, у вас будут высокодисперсивные выборки.

2) если популяции небольшие (1 млн.), то чем больше дисперсия, тем покрытие наоборот падает вплоть чуть ли не до 70%. Тут, возможно, проблема в конечной популяции и, как следствие, коррекции интервала. Хотя по идее конечная популяция создает проблему преувеличения надежности, тогда быть может, коррекция слишком сильная?..

3) Если зафиксировать seed генерации популяции, то результат = 77.5. Почему? Есть гипотеза, что фактически мы просто сдвигаем все элементы изначальной популяции на эффект, тем самым наши выборки также получались очень уж хорошо сдвинуты на этот эффект, то есть каждый элемент тестовой выборки получил тритмент с истинным эффектом (это имеет отношение sharp H0, которая как раз проверяет по каждому объекту сдвиг, представьте себе, что каждому из теста был свой клон в контроле). Тут, по-хорошему, проверить бы повторяемость этого.

Отсюда результат очередного подхода к этой проблеме такой:
- Покрытие мы получали от 70% до 80%
- Средние колебались от 75 до 76
- Есть подозрение, что есть оценщик всего этого, соблазнительна мысль, что это перемножение тех вероятностей выше, но такие результаты говорят будто о том, что это не независимые вероятности

Искали медь, а нашли портал в ад
  • 👍 21
  • ❤ 4
  • 😱 3
Older posts →

About this channel

How can I read @abba_testing without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Не AБы какие тесты: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Не AБы какие тесты have?
Не AБы какие тесты (@abba_testing) has 1.8K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Не AБы какие тесты know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →