
Привет, товарищи-статистики,
Эй-Ай в AB или наконец-то мысленные эксперименты!
Один из моих учеников, (Михаил, привет!) спросил, а можно ли сделать в продуктовой аналитике что-то вроде этого, где есть “миллионы ИИ-ботов со своим характером, паттернами поведения и памятью, которым кидаешь любую инфу или новость, типа нового запрета или повышения цен, и смотришь, как агенты это примут и что будут делать” для предсказания результата.
Ответ “да” мне пришел сразу, так как давно думаю о “бесплатной” проверке гипотез, - с помощью такого hive-mind, аки синтетической фокус-группы, можно делать предварительную валидацию гипотез. Это, конечно, не тест, но некоторое доп. взвешивание, а стоит ли проводить тест в принципе.
Для этого нужно выполнения нескольких условий:
1) история экспериментов, где в каждом дизайне тщательно была описана продуктовая гипотеза, как мы к ней пришли, что делали и пр.
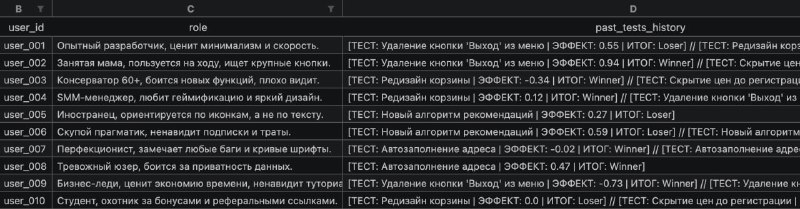
2) таблица, где по каждому пользователю будет написан статус участия его в прошедших экспериментах и индивидуальный эффект, который можно оценить через Uplift-моделирование (для быстрого понимания самый простой метод, S-Learner: проводим AB, накидываем модель на данные по тесту, где есть переменная участия и ряд независимых от теста ковариат, обучаем, меняем в переменной участия статус, получаем оценку контрфакта по каждому юзеру, дельта и есть этот эффект)
3) Описание каждого юзера на базе исследований хотя бы кластеризации, дополнительно его оценки/жалобы/отзывы/результаты опросов
Итого у вас есть по каждому юзеру его профиль и какие-то личные данные, индивидуальная реакция на прошедшие тесты с описанием, о чем были эти тесты. Берете гипотезу, “опрашиваете”, получаете фидбек и оценку от каждого юзера, вуаля, Эй-Ай в AB в действии! Далее можете фильтровать там по скору и пр.
MVP навайбкодил за минут 20, писал в VS, переложил в Colab, используйте свои ключи к OpenAI, должно завестись по идее. Она сгененирует таблицу по юзерам и экспериментах, а потом даст ответы на предложенную гипотезу. Результаты на скринах.
Конечно, есть ряд ограничений:
- Если у вас 100500 юзеров, то опрашивать каждого это дорого по токенам. Нужно тогда брать выборку, стратифицированную по профилям для репрезентативности вашей “генеральной” и уже ее опрашивать.
- Это не замена тесту! Поэтому надо убедиться, что есть сонаправленность такого претеста с реальным тестом. Из-за этого исторические данные в полном объеме для этой hive-модели вы использовать не сможете, иначе у вас не будет на чем тестировать ее, все по классике ML: оцените требование к истории в этом случае! Но даже если в прошлом есть сонаправленность это не избавляет от того, что впредь все будет также, конечно, нет.
- Хорошо бы через UX-исследователей провалидировать выборочно профили пользователей, уточнить их мнения и представления
А вообще, между нами говоря, неплохо бы убедиться, что у вас выполняется хотя бы условие для начала 1), та самая история экспериментов и проработанные хорошо описанные гипотезы, у вас ведь, так, да? …или нет?
В целом, предвижу, что подводных там больше и нужна прям команда с приличным таймлайном под это, но ведь красиво, согласитесь)
Post #148
1.78K

- 👍 12
- 🔥 7
- ❤ 2