TGViewer
Channel Public Channel
Data Science. SQL hub

Data Science. SQL hub

@sqlhub

По всем вопросам- @workakkk

@itchannels_telegram - 🔥лучшие ит-каналы

@ai_machinelearning_big_data - Machine learning

@pythonl - Python

@pythonlbooks- python книги📚

@datascienceiot - ml книги📚

РКН: https://vk.cc/cIi9vo

#VRHSZ
Subscribers
36K
Photos
1.2K
Videos
99
Links
1.2K

Showing posts older than #655 · Back to latest

Older Posts 19 shown
Post #654 3.85K
🖥SQLModel

Полезная библиотека SQLModel для Python, которая упрощает взаимодействие с SQL базами данных.

С помощью SQLModel можно использовать Pydantic-подобные классы, использующие аннотации типов Python для повышения читаемости.

▪Github
▪Документация

@sqlhub
  • 👍 8
  • ❤ 4
  • 🔥 1
Post #653 3.7K
⚡Легкий способ получать свежие обновлении и следить за трендами в разработке на вашем языке. Находите свой стек и подписывайтесь:


Машинное обучение: @ai_machinelearning_big_data
Go: @Golang_google
C#: @csharp_ci
Базы данных: sql
Python: @python_job_interview
C/C++/: @cpluspluc
Data Science: @data_analysis_ml
Devops: @devOPSitsec
Rust: @rust_code
Javascript: @javascriptv
React: @react_tg
PHP: @phpshka
Docker: @docker
Android: @android_its
Мобильная разработка: @mobdevelop
Linux: linuxacademy
Big Data: t.me/bigdatai
Хакинг: @linuxkalii
Java:@javatg
Собеседования: @machinelearning_interview


💼 Папка с вакансиями: t.me/addlist/_zyy_jQ_QUsyM2Vi
Папка Go разработчика: t.me/addlist/MUtJEeJSxeY2YTFi
Папка Python разработчика: t.me/addlist/eEPya-HF6mkxMGIy

🔥ИТ-Мемы: t.me/memes_prog

🇬🇧Английский: @english_forprogrammers
  • 👍 5
Post #652 3.69K
Post #651 3.55K
🖥 Finetuning LLaMa + Text-to-SQL

Llama 2 - отличная модель, но она не очень хорошо справляется с преобразованием текста в SQL запросы.

Приходится прибегать к тонкой настройке 💡.
Вышла отличная библиотека для Llama 2 преобразования текста в SQL.

git clone https://github.com/run-llama/modal_finetune_sql.git

▪GIthub
▪Ipynb

@sqlhub
  • 👍 5
  • 🔥 3
  • ❤ 2
Post #648 3.11K
🔍 ScyllaDB в K8S: как справляться с интенсивными рабочими нагрузками на спотовых экземплярах без простоев

Почему не MongoDB?
Чем плоха Mongo?

• У нее открытый исходный код, поддерживается разделение данных, но совершенно иная архитектура — с единой точкой отказа. При «падении» главного узла, то есть координатора, в БД начинается отработка отказа, во время которого БД недоступна.

• Кроме того, для достижения высокой доступности каждый сегмент Mongo должен запускаться как набор реплик —  больше узлов. Кольцевая архитектура Cassandra в этом смысле превосходнее. Драйвер Scylla «знает» о сегментах и добирается до конкретного узла/процессора, ответственного за запрашиваемую строку, делая распределение действительным.

• Но почему так важны отработка отказов без простоев и высокая доступность? На спотовых экземплярах — а это 1/4 стоимости вычислений — часто ежедневно случаются отработки отказов: узлы в k8s постоянно уничтожаются и воссоздаются, что чревато завершением всех запущенных в них подов/процессов, в том числе БД.

Установка Scylla
Сначала запустим локально, используя драйверы и что-нибудь на Cassandra Query Language:
docker run -p 9042:9042 -p 7002:7000 -p 7001:7001 -p 9160:9160 -p 9180:9180 --name scylla --hostname scylla -d scylladb/scylla --smp 1 --developer-mode 1

Этой командой запустится одноузловой кластер Scylla. Так в режиме разработчика Scylla требуется минимум ресурсов в отличие от Cassandra, с которой у Docker Engine много работы.

Применение драйвера Scylla
Вот простой пример на Golang с использованием официального драйвера Scylla:
import "github.com/gocql/gocql"

func Connect(config Config) (*gocql.Session, error) {
cluster := gocql.NewCluster(config.Hosts...)
cluster.Keyspace = config.KeySpace
cluster.CQLVersion = "3.11"
cluster.RetryPolicy = &gocql.ExponentialBackoffRetryPolicy{
NumRetries: 5, Min: time.Millisecond * 5, Max: time.Second * 5}
cluster.ProtoVersion = 3
cluster.PoolConfig.HostSelectionPolicy = gocql.TokenAwareHostPolicy(
gocql.RoundRobinHostPolicy())
cluster.ConnectTimeout = time.Second * 10
cluster.Consistency = gocql.One
if config.Timeout != nil {
cluster.Timeout = *config.Timeout

}

cluster.Authenticator = gocql.PasswordAuthenticator{
Username: config.Username, //'cassandra' по умолчанию
Password: config.Password, //'cassandra' по умолчанию
}
session, err := cluster.CreateSession()
if err != nil {
return nil, err
}

return session, nil
}


Здесь стоит обратить внимание вот на что:
cluster.PoolConfig.HostSelectionPolicy = gocql.TokenAwareHostPolicy(
gocql.RoundRobinHostPolicy())


Драйвером-клиентом TokenAware с помощью ключа раздела пробуется первый сегмент, затем методом циклического перебора — следующий, если первый недоступен. Для этого необходимо подключиться не к порту Cassandra по умолчанию 9042, а к порту Scylla с поддержкой сегментов 19042.

Попробуем простой запрос:
func Ping(session *gocql.Session) error {
var str = new(string)
if err := session.Query("SELECT uuid() FROM system.local;").Scan(str); err != nil {
return err
}
if str == nil || len(*str) == 0 {
return errors.New("failed sanity check")
}
return nil
}
// альтернатива «select 1;» в SQL


Переходим в облако

ПРОДОЛЖЕНИЕ

@sqlhub
  • 👍 10
  • ❤ 1
  • 🔥 1
Post #647 2.97K

Forwarded from PHP Academy

PHP, PDO SQL Injection

SQL Injection минимум который должен знать каждый разработчик код которого работает в production

00:00 Вступление и оглавление
01:06 Определения (теория)
01:45 Чем опасны SQL Injection
03:34 Практический стенд
06:12 Обхода аутедентификации
09:23 Модификации базы данных
11:47 Защита с помощью placeholder
15:49 Защита там где placeholder не применимы

источник

@phpshka
  • 👍 8
  • ❤ 2
  • 🥰 1
Post #646 3.51K
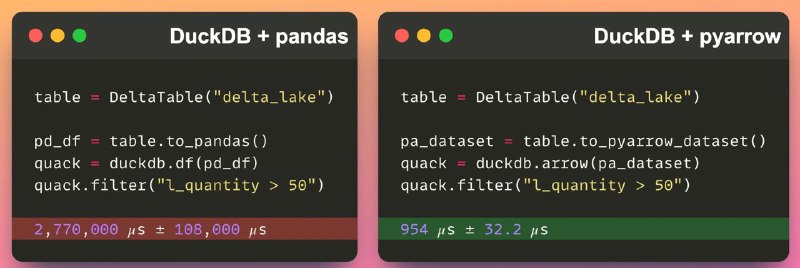
Сочетание DuckDB и PyArrow позволяет эффективно обрабатывать на одной машине массивы данных, превышающие объем памяти.

В приведенном ниже коде запуск DuckDB на наборе данных #PyArrow примерно в 2906 раз быстрее, чем запуск #DuckDB на #pandas DataFrame.

▪Pyarrow
▪DuckDB

#tips

@sqlhub
  • 👍 12
  • 🔥 4
  • ❤ 2
Post #644 4.4K
🔥Большая подборка бесплатных SQL курсов.

▪ Интерактивный тренажер по SQL (— практические задания на создание SQL-запросов. Каждый шаг включает минимальные теоретические аспекты по базам данных или языку SQL, примеры похожих запросов и пояснение к реализации

▪ Марафон данных: первое знакомство с SQL и Python — это симулятор профессии дата-аналитика, который познакомит вас с базами данных и методами работы с ними

▪ Знакомство с SQLite (4.6 из 5) — этот небольшой курс покажет, как использовать SQLite в повседневной работе. Вы научитесь загружать, анализировать и выгружать данные, а также познакомитесь с разными типами данных

▪ Введение в базы данных - курс посвящен структурированному хранению данных, основами SQL, принципами использования баз данных в приложениях, обзор нереляционных способов хранения данных

▪ Погружение в СУБД — курс для тех, кто уже имеет некоторый опыт проектирования баз данных и разработки приложений и хочет расширить свои знания


🌐 Youtube
▪ Реляционные базы данных. SQL (39 видео) — курс раскрывает все аспекты реляционных баз данных, начиная от определения и создания баз данных, схем, таблиц и полей этих таблиц (DDL), и заканчивая запросами к этим таблицам (DML)

▪ Практика по SQL

▪ Основы SQL (18 видео) — объясняют базовые концепции языка: операторы, фильтрация, сортировка, группировка, декомпозиция и т. д.

▪ Уроки по SQL для начинающих (25 видео) — эти уроки помогут быстро разобраться с основами

12 Англоязычных курсов

Платформы: Stepik, Coursera, Udacity, Udemy и Kaggle.

1. Databases and SQL for Data Science with Python
2. SQL for Data Science
3. Introduction to Databases and SQL Querying
4. Intro to Relational Databases
5. Introduction to Structured Query Language (SQL)
6. Advanced Databases and SQL Querying
7. SQL for Data Analysis
8. Oracle SQL – A Complete Introduction
9. Intro to SQL
10. Advanced SQL
11. Oracle SQL Basics
12. Beginners Guide to SQL

👍 Лайк, если полезно

@Sqlhub
  • 👍 42
  • ❤ 4
  • 🔥 4
Post #643 3.74K
🖥 Relational Databases Explained

Принцип работы реляционных баз данных. В этой статье рассказывается о том, как работают индексы и транзакции внутри реляционных баз данных.

Отличная иллюстрированная статья для глубокого понимания реляционных баз данных.

▪Читать

@sqlhub
  • 👍 9
  • 🔥 4
  • ❤ 1
Post #639 3.41K
Распределенный SQL: Альтернатива шардированию баз данных

Шардирование баз данных — это процесс разделения данных на более мелкие части, называемые «шарды». Шардинг обычно используется, когда необходимо масштабировать записи. Распределенный SQL представляет новый способ масштабирования реляционных баз данных с использованием стратегии сегментирования, полностью автоматизированной и прозрачной для приложений. Подробнее ты узнаешь из этой статьи.

🚀 Читать статью

@sqlhub
  • 👍 6
  • ❤ 4
  • 🔥 1
Post #636 3.66K
🖥 Postgres, MongoDB и MySQL - три наиболее известные и широко используемые базы данных, причем Postgres является самой популярной.

Redis и Planetscale - лучшие варианты при запуске нового проекта. Более подробная информация и интересные статистические данные приведены в полном тексте отчета.

📌Читать

@sqlhub
  • 👍 13
  • ❤ 4
  • 🔥 1
Post #635 3.84K
🟡 Дайджест полезных материалов из мира sql за неделю

Почитать:
— Проблемы студентов курсов при работе с реальными данными
— Что такое «хорошо» и что такое «плохо» в NiFi. Часть 3
— pgmig — история разработки инструмента управления изменениями в БД или чего нам не хватило в Liquibase и Flyway
— Список популярных утечек с GitHub: Анализ репозиториев компаний
— Когда SQL решает, и задачки для прокачки
— Генеративный ИИ с базой данных SQL: Персональный чатбот разработчика SQL
— What is SQL?
— YugabyteDB official Dockerfile
— Golang Database Migration With Golang Migrate and Sqlc
— Window Functions: A comprehensive guide to mastery.
— MySQL CheatSheet
— Roadmap to Become a Database Engineer
— Securing Your Graph Database: Best Practices for Apache AGE
— Counters with YugabyteDB
— Stored Procedures: The Secret to Improving Your Database Applications
— Master the Technique of 'Update Only When Changes Occur' in SQL! Boost Your Database Efficiency

Посмотреть:

🌐 SQL Data Analytics Project (PART 2) | Data Analyst Portfolio Project


Хорошего дня!

❤️ Лайк, если полезно

@sqlhub
  • ❤ 14
  • 👍 6
  • 🔥 2
Post #634 3.67K
🖥 Как удалить сразу все избыточные индексы в каждой базе данных

Избыточные индексы в SQL Server - это явление значительно более общее, чем мне бы хотелось. Я встречал это довольно часто. Это означает, что данное сообщение в блоге все еще будет иметь значительную целевую аудиторию!

Статья Brent Ozar дает исчерпывающую информацию об избыточных/дублирующих индексах, что они означают, почему это плохо, и что нужно с этим делать.

Несколько лет назад Guy Glantser также опубликовал статью об удалении избыточных индексов. Она весьма полезна для нахождения всех избыточных индексов во всех таблицах в заданной базе данных.

Но вот чего не хватает в этих статьях, так это возможности легко генерировать команды Drop/Disable для этих избыточных индексов.

Кроме того, что если имеются "похожие" индексы, которые только "частично" избыточны, и, следовательно, недостаточно просто удалить один из них? Иначе это может негативно сказаться на производительности некоторых запросов.

Есть ли способ учесть все эти проблемы?
Каждый из них? Повсюду? Сразу?


В посте я собираюсь показать вам, как обнаружить, получить подробную информацию и иметь возможность удалить КАЖДЫЙ избыточных индекс ЛЮБОЙ формы и размера:

▪Полностью дублируемые индексы
▪Избыточные индексы на основе ключевых столбцов + включенных столбцов
▪Частично избыточные индексы только на основе ключевых столбцов
▪Все таблицы
▪Все таблицы с минимальным числом строк
▪В конкретной базе данных
▪Во всех доступных базах данных

📌 Читать дальше
📌 Скрипт
📌 Индексы: обнаружение неиспользуемых индексов

@sqlhub
  • 👍 9
  • ❤ 3
  • 🔥 1
Post #632 3.58K
🖥 Аналитика небольших данных: как совместить Excel, Python и SQL с помощью инструментов с открытым исходным кодом

Однажды Джоэл Спольски в своей знаменитой презентации «You Suck at Excel» сказал, что существуют сотни коммерческих продуктов, вместо которых можно было бы использовать табличку Excel.

В этой шутке очень высокая доля правды. Excel благородя интуитивному UI, формулам и VBA дает возможность пользователям самим решать широкий спектр задач, избавляя от необходимости каждый раз обращаться за помощью к разработчикам или внедрять в компании новый продукт. Excel используется везде от мелкой розницы до Fortune 500 и CERN.

Пользовательский интерфейс Excel оказался, настолько удачным – ни один из конкурентов так и отошел от привычных таблиц. Для пользователя Excel интерфейс Google Spreadsheet будет привычным и интуитивно понятным. А вот по своим функциональным возможностям Excel до сих пор превосходит большинство конкурентов.

Как с помощью двух мощных инструментов с открытым исходным кодом можно совместить привычный для пользователей интерфейс, надежность и мощь SQL, гибкость Python и командную работу как в Google Spreadsheet? Давайте рассмотрим это на простом примере.

📌Читать дальше

@sqlhub
  • 👍 10
  • ❤ 4
  • 🔥 3
Post #630 3.41K
🖥 Продвинутые темы SQL для дата-инженеров

Дата-инженер контролирует и анализирует большие наборы данных. SQL — мощный инструмент выполнения запросов и манипулирования данными, и для создания эффективных решений здесь имеется немало продвинутых функциональных средств. Рассмотрим ряд важных для дата-инженеров тем SQL, иллюстрируя их примерами применения набора данных.

Пример набора данных
Имеется три таблицы:

• product_table с данными различных продуктов — название, цена, категория;
• category_table с данными о категориях продуктов;
• order_table с данными о заказах: заказанный продукт, его количество, дата заказа.

Вот схема каждой таблицы:
product_table
+----+----------------------+-------+-------------+
| id | Название | Цена | category_id |
+----+----------------------+-------+-------------+
| 1 | iPhone 13 | 1000 | 2 |
| 2 | Galaxy S21 | 800 | 2 |
| 3 | Pixel 6 | 700 | 2 |
| 4 | MacBook Air | 1000 | 4 |
| 5 | Surface Pro 8 | 1200 | 4 |
| 6 | iPad Pro | 800 | 3 |
| 7 | iPad Mini | 400 | 9 |
| 8 | Smart TV | 800 | 1 |
| 9 | Home Theater System | 600 | 1 |
| 10 | Galaxy S21 Ultra | 1400 | 2 |
| 11 | iPhone 13 Pro Max | 1300 | 2 |
| 12 | Pixel 6 Pro | 1000 | 2 |
+----+----------------------+-------+-------------+

category_table
+----+-------------+
| id | Название |
+----+-------------+
| 1 | Электроника |
| 2 | Телефоны |
| 3 | Планшеты |
| 4 | Ноутбуки |
| 5 | Бытовая техника |
| 6 | Одежда |
| 7 | Спорттовары |
| 8 | Игрушки |
| 9 | Аксессуары |
+----+-------------+


order_table
+----+------------+-------------+------------+
| id | product_id | Количество | Дата |
+----+------------+-------------+------------+
| 1 | 1 | 2 | 2022-03-28 |
| 2 | 2 | 1 | 2022-03-28 |
| 3 | 3 | 3 | 2022-03-29 |
| 4 | 4 | 1 | 2022-03-30 |
| 5 | 5 | 2 | 2022-03-31 |
| 6 | 6 | 3 | 2022-03-31 |
| 7 | 7 | 2 | 2022-03-31 |
| 8 | 8 | 1 | 2022-03-31 |
| 9 | 9 | 1 | 2022-03-31 |
+--------------------------------------------+

Фильтрация данных
Предложение WHERE — это важный SQL-функционал для фильтрования данных по конкретным условиям. WHERE, которым определяется условие включения данных в результаты, добавляется в конце оператора SELECT.

Пример. Чтобы получить все продукты дороже 1000 $, применяем WHERE для их фильтрации по цене, в результаты включаются только продукты дороже 1000 $:
SELECT *
FROM product_table
WHERE price > 1000;


Возвращаемый результат:
+----+---------------------+-------+-------------+
| id | Название | Цена | category_id |
+----+---------------------+-------+-------------+
| 5 | Surface Pro 8 | 1200 | 4 |
| 10 | Galaxy S21 Ultra | 1400 | 2 |
| 11 | iPhone 13 Pro Max | 1300 | 2 |
+----+---------------------+-------+-------------+


Объединения
Чтобы иметь полную картину о данных нескольких таблиц, эти таблицы объединяют. Для этого в SQL имеются внутренние, левые, правые и полные внешние объединения.

Пример. Чтобы получить список всех заказов и название заказанного продукта, с помощью объединения в SQL объединяем таблицы: в одной данные о заказе, в другой — о продукте:
SELECT order_table.*, product_table.name
FROM order_table
INNER JOIN product_table ON order_table.product_id = product_table.id;


📌 Читать дальше

@sqlhub
  • 👍 17
  • 👎 5
  • 🔥 2
  • ❤ 1
Post #629 4.54K
PostgreSQL_Python.pdf677.1 KB
🔥 Полезная Шпаргалка-гайд по работе с Python и PostgreSQL.


Все от установки и соединение с БД до создания таблиц и работы с полями.

@sqlhub
  • ❤ 10
  • 👍 6
  • 🔥 4
Post #627 4.94K
🖥 NoSQL: виды, особенности и применение

NoSQL — это семейство нереляционных баз данных. В них разработчики отошли от использования традиционной табличной модели представления информации.

• Уже само название заявляет, что управлять данными можно не только с помощью Structured Query Language (SQL), т. е. языка структурированных запросов.

• Модель NoSQL появилась в ответ на необходимость оперативно обрабатывать действительно огромные объёмы данных. Поэтому NoSQL по большей части заточена под масштабирование по горизонтали и работу с недостаточно структурированными или постоянно меняющимися данными.

Почему появилась модель NoSQL
Расцвет реляционных (relation — «связь, взаимосвязь») баз данных пришёлся на 80-е годы, когда в БД в основном хранили текстовые документы и изображения. Однако с развитием технологий и ростом объёма обрабатываемой информации реляционные СУБД перестали справляться со всеми задачами одинаково хорошо. Термин NoSQL впервые прозвучал в 1998 году: его применил итальянский учёный Карло Строцци для описания своей open source СУБД. При разработке он отказался от SQL, а также от основного принципа реляционных СУБД — ACID (atomicity, consistency, isolation, durability).

В начале XXI века NoSQL БД стали популярны, в том числе у корпораций. Чтобы решить проблемы параллельных вычислений с очень большим объёмом информации и масштабируемости, Google построила на основе модели распределённых вычислений MapReduce колоночное хранилище. На базе этих технологий выросло целое семейство высокодоступных open source СУБД.

Основные причины появления NoSQL:

📌 Читать

@sqlhub
  • 👍 13
  • ❤ 4
  • 🔥 1
Post #626 4.63K
⚡️Маст-хэв список для программистов, каналы с последними книжными новинками, библиотеками, разбором кода и актуальной информацией, связанной с вашим языком программирования.
Лучший способ получать свежие обновлении и следить за трендами в разработке.

Машинное обучение: t.me/ai_machinelearning_big_data
Python: t.me/pythonl
C#: t.me/csharp_ci
C/C++/ t.me/cpluspluc
Data Science: t.me/data_analysis_ml
Devops: t.me/devOPSitsec
Go: t.me/Golang_google
Базы данных: t.me/sqlhub
Rust: t.me/rust_code
Javascript: t.me/javascriptv
React: t.me/react_tg
PHP: t.me/phpshka
Android: t.me/android_its
Мобильная разработка: t.me/mobdevelop
Linux: t.me/+A8jY79rcyKJlYWY6
Big Data: t.me/bigdatai
Хакинг: t.me/linuxkalii
Тестирование: https://t.me/+F9jPLmMFqq1kNTMy
Java: t.me/javatg

💼 Папка с вакансиями: t.me/addlist/_zyy_jQ_QUsyM2Vi
Папка Go разработчика: t.me/addlist/MUtJEeJSxeY2YTFi
Папка Python разработчика: t.me/addlist/eEPya-HF6mkxMGIy

Папка машинное обучение: https://t.me/addlist/_FjtIq8qMhU0NTYy

📕 Бесплатные Книги для программистов: https://t.me/addlist/YZ0EI8Ya4OJjYzEy

🎞 YouTube канал: https://www.youtube.com/@uproger

😆ИТ-Мемы: t.me/memes_prog

🇬🇧Английский: t.me/english_forprogrammers
  • 🔥 4
  • 👍 3
  • 🥰 2
  • ❤ 1
Post #625 4.7K
🤓 Набор обучающих материалов по базам данных

1. Статьи.
2. Блоги.
3. Курсы.
4. Выступления.

5. Книги.

Дает возможность углубленно изучить работу с базами данных.

👇

📌 GitHub

@Sqlhub
  • 👍 10
  • 🔥 4
  • ❤ 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →