TGViewer
Channel Public Channel
Eli Rum - Tech & Ai

Eli Rum - Tech & Ai

@somecrazyhands

Пишу про Ai, стартапы и технологии. Немного за жизнь. Моя визитка https://elirum.me Harness AI framework https://forgeplan.dev Мастерская по Ai кодингу https://extraboost.ai Чат центрик таск трекер https://orch.so и ai knoweledge layer https://gerta.ai
Subscribers
580
Photos
51
Videos
0
Links
27

Showing posts older than #67 · Back to latest

Older Posts 13 shown
Post #66 155
🎼 Maestro, your baton is waiting.

Вести с полей.
У меня есть проект Orchestra который мы пилим со времен ковида. Мало про него пишу, а зря. И вот info:
• нас трое фаундеров + наша dream team
• все специализируемся на продуктовой разработке
• проект в США и ориентируемся на весь мир
• взяли 1 место сразу в 3 категориях во время запуска на Product Hunt. В этот же день запускался OpenAi со своим Apps
• прошли акселерацию
• венчурный проект
• привлекли западыне деньги от известного инвестора Jason Calacanis

Про Ai:
Мы в Orchestra уже несколько лет ведем эксперименты с AI с разных сторон. Наша команда ищет для него не “красивую кнопку”, а реальное место в продукте — там, где AI не развлекает, а помогает доводить работу до результата.

Orchestra — это chat-centric workspace.

Внутри одного рабочего пространства живут чаты, задачи, проекты, звонки, документы, медиа и AI. Не как отдельные вкладки и разрозненные инструменты, а как единый контекст, в котором команда реально работает.

Мы пробовали разные AI-сценарии:

• ассистентов для разбора звонков
• автоподбор семантических смайлов для сообщений
• генерацию иконок для задач
• названия для задач и чатов
• summaries, подсказки и автоматизацию вокруг рабочего контекста

И сейчас мы делаем следующий шаг.

Мы открываем waitlist на Orchestra Agents и запускаем агентов в закрытое тестирование.

Идея простая: AI-агент должен стать не игрушкой в отдельном окне, а вашим рабочим подручным. Он получает доступ только к тому, к чему вы сами разрешите доступ, понимает контекст и помогает забирать на себя рутину.

Мы переходим из эпохи “поговорить с AI” в новый этап, где AI начинает координировать работу.

Не отдельный чатбот, которого нужно постоянно пинать промптами.
И не ещё один сайдбар с магической кнопкой.
А система агентов, которые понимают контекст, подключаются к инструментам и помогают двигать задачи дальше. И это еще мы не доделали https://gerts.ai который бустанет в разы наших агентиков

В обычном сценарии ты открываешь чатбота и снова объясняешь ему всё с нуля:

— кто клиент
— что обсуждали
— какие задачи уже есть
— где дедлайн
— какой проект
— что решили на звонке
— что нужно сделать дальше

А потом руками переносишь результат обратно в рабочие инструменты.

В Orchestra идея другая.

AI живёт внутри рабочего пространства, где уже есть чаты, задачи, проекты, звонки, документы и медиа. Он не висит где-то сбоку от работы, а становится частью самой рабочей среды.

Что это может дать:

🔹 Auto-triage задач

Агент помогает разобрать входящие задачи, сообщения и запросы: понять смысл, приоритет, контекст, возможного исполнителя и следующий шаг.

🔹 Ответы по рабочему контексту

Не “ответь как эксперт из интернета”, а “посмотри, что у нас реально происходило в проекте, задачах, чатах и звонках”.

🔹 Custom workflows

AI не просто пишет текст, а запускает цепочку действий: резюмирует обсуждение, достаёт action items, создаёт задачи, готовит follow-up, обновляет проектный контекст.

🔹 Меньше ручного prompting

Пользователь задаёт intent — что должно получиться на выходе. А агенты помогают с логистикой: найти, связать, разложить, подготовить, напомнить, запустить.

Для меня это основная смена курса в Ai ко воркинге.

Побеждать будут не те продукты, где “есть AI-чат”.
Побеждать будут продукты, где AI встроен в рабочий граф: люди, задачи, переписки, встречи, документы, решения, дедлайны и зависимости.

Поэтому Orchestra лично для меня — не просто очередной team chat.

Это попытка собрать AI-native workspace, где коммуникация, задачи и агентный слой находятся в одном контексте.

1/3 продукта — понятная база:
чаты, звонки, задачи, проекты, документы, медиа.

2/3 будущей ценности — AI-агенты:
они понимают контекст, работают рядом с командой и постепенно забирают на себя координационную рутину.

Именно поэтому мне нравится метафора Maestro.

Пользователь не должен становиться оператором десяти чатботов.
Он должен управлять намерением, приоритетами и результатом.

Private preview открыт:
https://orch.so/agents

#ai #agents #orchestra #dev #product #task #slack #notion #calls #vibecoding
  • ❤ 5
  • 🔥 5
  • 👍 4
Post #65 120
🔥 64–128 ГБ HBM2 для локального AI за цену одной современной видеокарты

Я сейчас подбираю себе конфигурацию для локального инференса: хочу начать с недорогого рига, а затем постепенно масштабироваться до моделей класса 70B–120B.

И нашёл совершенно безумного китайского Франкенштейна: готовую машину с четырьмя NVIDIA Tesla V100 SXM2, жидкостным охлаждением и NVLink.

Версия за $2 223:

• 4 × V100 SXM2 16 ГБ HBM2 — суммарно 64 ГБ VRAM;
• до 900 ГБ/с пропускной способности памяти на каждой карте;
• NVLink 2.0 — продавец заявляет 300 ГБ/с;
• Xeon E5-2698B v3, X99-TF, 64 ГБ RAM и SSD 1 ТБ;
• отдельная R5 240 для вывода изображения;
• два блока питания по 1000 Вт;
• четыре водоблока и готовый корпус 1CatAI QX620A.

Вот сам лот:

https://www.alibaba.com/product-detail/4-GPU-V100-16GB-graphics-card_1601670638004.html

Важно: 4 × 16 ГБ — это не одна видеокарта с единой памятью на 64 ГБ. Модель должна быть распределена между GPU через tensor/pipeline parallelism или layer split.

На такой конфигурации нормально выглядят:

• gpt-oss-20b;
• Qwen/Gemma-класс 27–35B в AWQ/GGUF;
• 70B-модели в Q4/Q5;
• Stable Diffusion, FLUX и другие задачи, где важен объём VRAM.

А вот для gpt-oss-120b версия на 64 ГБ уже слишком тесная: OpenAI ориентирует модель на одну 80-гигабайтную GPU. Веса почти помещаются, но не остаётся нормального запаса под KV-cache и runtime.

Поэтому интереснее версия 4 × V100 32 ГБ — уже 128 ГБ HBM2 за $4 363:

https://www.alibaba.com/product-detail/4-GPU-V100-32GB-graphics-card_1601666431506.html

И это уже реально риг для 120B-класса. Автор даже сделал 1Cat-vLLM — отдельный форк vLLM под Volta/V100.

В нём описан запуск Qwen3.5-122B-A10B-AWQ на четырёх V100 32 ГБ через TP4 и с контекстом до 256K:

https://github.com/1CatAI/1Cat-vLLM

Но V100 — на архитектуре 2017 года:

• нет нативных BF16/FP8/FP4-кернелов новых поколений;
• CUDA 13 уже убрала сборку библиотек под Volta, поэтому стек придётся фиксировать на CUDA 12.x;
• современные RTX/A100/H100 будут заметно быстрее;
• это китайская кастомная плата плюс списанные серверные GPU — перед оплатой нужны ECC-логи, nvidia-smi topo -m и тест NVLink.

Что по альтернативам?

По текущему вторичному рынку:

• 4 × RTX 3090 = 96 ГБ, примерно $4 200 только за GPU;
• 2 × RTX A6000 = 96 ГБ, примерно $7 600;
• одна RTX PRO 6000 Blackwell 96 ГБ сейчас стоит около $13 000.

То есть 4 × V100 32 ГБ дают максимальный объём VRAM за деньги, но ценой старого software stack и инженерных приключений.

Аренда тоже интересна:

• 4 × V100 на Vast.ai: примерно $0,74–1,61/час;
• A100 80 ГБ на Runpod: $1,39/час;
• RTX PRO 6000 96 ГБ: $2,09/час;
• H100 SXM 80 ГБ: $3,29/час.

При работе 24/7 это примерно от $538 до $2 402 в месяц.

Покупка 128-гигабайтного V100-рига формально отбивается за 2–4 месяца непрерывной аренды — но без учёта электричества, доставки, налогов и разницы в скорости.

А вот API пока убивает локальную сборку по чистой экономике.

gpt-oss-120b стоит:

• DeepInfra — $0,039 за 1 млн входных и $0,19 за 1 млн выходных токенов;
• Groq, Together и Fireworks — около $0,15 / $0,60.

Даже 10 000 запросов в месяц по 10K входа + 2K выхода — это примерно $7,70 на DeepInfra или $27 у остальных.

Поэтому локальный риг нужен не ради «сэкономить на ботике». Он нужен, когда важны:

• закрытые данные и полный on-prem;
• собственные веса, LoRA и нестандартные модели;
• постоянная высокая нагрузка (RAG/GRAPH-RAG)
• отсутствие rate limits и оплаты за каждый токен;
• возможность ковырять весь inference stack самому.

Короче, рационально — API, если есть бабки. Инженерно и стратегически — мне очень нужно собрать этого 128-гигабайтного монстра чтобы строить дальше https://gerts.ai так как пока я его строю много и много раз гоняю переиндексацию докуметов а это уже выходит дороговато. Если честно то за несколько лет я сжег денег на 30+ KUSD по грубым прикидкам.

Что думаете?

#ai #elirum #aisdlc #llm #vibecoding #development
  • 👍 3
  • 🔥 3
  • 👀 1
Post #64 126
Итак, что там по Claude Fable 5?

Anthropic выпустила Fable 5 — модель, которую лучше воспринимать не как "Claude для чата", а как дорогого senior-агента для длинных автономных задач.

🔹Где у неё основной буст

Не в коротких вопросах и не в исправлении одной строки.

Fable заточена под задачи, где нужно несколько часов подряд:

• изучать большую кодовую базу
• составлять и удерживать план
• работать с tools и файлами
• запускать проверки
• находить свои ошибки
• доводить большой кусок работы до результата

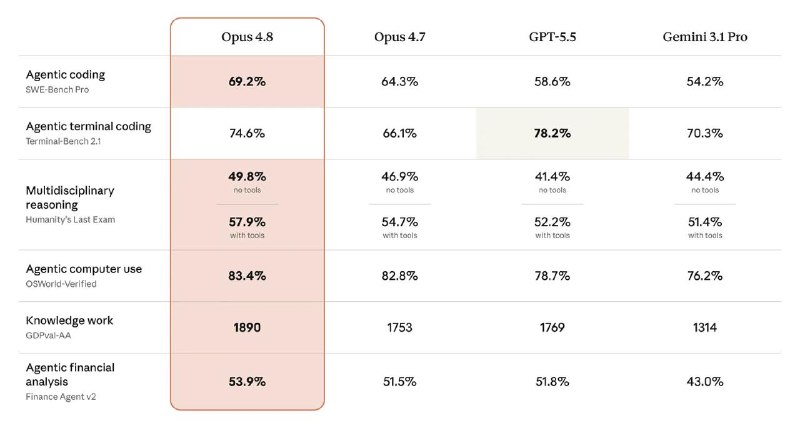
По ранним тестам модель особенно сильно отрывается именно на long-horizon задачах. Every на своём внутреннем инженерном бенчмарке получила 91/100 против 63 у Opus 4.8 и 62 у GPT-5.5.

Это не универсальный научный бенчмарк, но разница интересная.

В другом тесте Fable одним промптом собрала клон collaborative document editor примерно за три часа без доступа к исходному коду. Затем сняла скриншоты desktop и mobile, нашла визуальные дефекты и исправила их без отдельного QA-промпта.

То есть скачок не в том, что она чуть лучше пишет функцию. Скачок в том, что ей можно отдать результат целиком.

🔹Но есть нюанс

Fable дорогая:

• $10 за миллион входных токенов
• $50 за миллион выходных

Это примерно в два раза дороже Opus 4.8.

До 22 июня она включена в платные подписки Claude, дальше Anthropic планирует перевести использование на credits. Если мощностей станет больше, условия могут изменить.

На коротких задачах разницу можно не почувствовать, а заплатить заметно больше. Использовать её как модель «на каждый вопрос» пока выглядит странно.

🔹Ещё один важный момент — safety-фильтры

Fable проверяет не только последнюю фразу пользователя. Под фильтр может попасть весь контекст:

• system prompt
• CLAUDE.md
• skills и memory
• документы
• результаты tools и MCP
• предыдущие сообщения

И вот мой студент уже поймал false positive.

Он попросил выполнить ADI-цикл для решения инварианта, затем создать ADR. После загрузки skill fpf:fpf Claude Code показал:

“Fable 5's safety measures flagged this message for cybersecurity or biology topics”

После чего система сама переключила запрос на Opus 4.8.

Никакого кибербеза или биологии в запросе не было.

Вероятнее всего, классификатор зацепился за инструкции внутри skill: reasoning, гипотезы, пошаговый анализ или формулировки, похожие на извлечение внутреннего thinking модели.

То есть safety теперь работает уже не только на уровне prompt. Она анализирует весь harness-контекст агента.

Автопереключение можно отключить через /config, но сам фильтр это не выключает. Вместо fallback задача просто остановится.

🔹И здесь начинается самое интересное

Старые skills, раздутые системные промпты и слишком жёсткий scaffolding могут уже не помогать, а ограничивать новую модель — или вызывать ложные срабатывания.

Больше harness — не всегда лучше harness.

Нужно проверять:

• какой контекст получает модель
• какие инструкции дублируются
• сколько она делает tool calls
• где сама проверяет результат
• где нужен recovery loop
• где human approval действительно обязателен

🔹Мой предварительный вывод

Fable 5 — это не замена Opus для каждого запроса.

Это дорогой senior-агент для больших long-horizon задач, где важны итоговое качество, стоимость всей работы и количество человеческих вмешательств, а не скорость первого ответа.

И это ещё раз подтверждает мою любимую формулу:

Agent = Model + Harness.

Оценивать отдельно модель уже почти бессмысленно. Нужно смотреть, как конкретная модель работает внутри конкретного harness: сколько стоит задача, сколько времени занимает, сколько делает tool calls, сколько раз ошибается и какой результат выдаёт в конце.

Собственно, именно для этого я и делаю POLLMEVALS.

Буду гонять Fable на больших задачах. Если уже успели попробовать — пишите, где увидели разницу с Opus 4.8, а где просто потратили лимиты 😂

#ai #developemnt #agents #lessons #vibecoding #aidevelopment
  • 🔥 3
Post #60 196
POLLMEVALS (Panel of LLM evals) - лидерборд по связкам «модель + харнес»

Как и обещал - пост-спойлер.

🔹Я делаю лидерборд по агентам. То есть по связке Модель + Харнес. Хочу на разных задачах видеть три вещи сразу: стоимость, время и качество выполнения. Фронт, бэкенд, документация, тесты, цикломатика, типизация, SOLID и так далее.

Делаю это постепенно и не так быстро, как хотелось бы. Суть в том, что прогон разного количества моделей и сборок агентов занимает немало времени. А ещё это дорого - один разовый прогон сегодня обошёлся мне в 100$+.

Если хочешь узнать, какая комбинация даёт показатель выше, или проверить свою конкретную сборку модель + харнес - пиши мне, и я запущу. Донат приветствуется.

🔹Смысл - понимать, какая связка модель + харнес хорошо сочетается по деньгам и по качеству. Вместо дорогих оркестраторов от тех же вендоров.

Показываю в супер-альфа версии панельку POLLMEVALS.

🔹Что там есть. Задачи по категориям - как мои собственные, так и из публичных датасетов, например от SWE. Все задачи разбиты на категории. Есть модели: от дешёвых, которые можно развернуть на маке или винде, до тех, что не по карману и только через провайдеров. Есть харнесы - буду добавлять их постепенно. Пока на английском, будет и на русском.

🔹В планах:
• сделать панель публичной в течение недели
• раскатать всё в k8s, чтобы раз в неделю запускалось + 1 новый агент/оркестратор из голосовалки или из запросов
• форма для запроса на расчёт новой комбинации модели и агента
• сбор донатов - лидер борд штука дорогая, а деньги нужны чтобы гонять модели
• отдельный лидерборд для запуска моделей на лаптопах: macOS + LLM + agent под разные поколения M-чипов, объём памяти и т.д.
• новый ux/ui и всякое по мелочам

🔹Вообще всё это я делаю на чистом энтузиазме, и цель такая. Понимать не на ощущениях, а по реальным цифрам - какая модель и какая связка работает хорошо. Если ты тоже хочешь видеть реальные показатели - ставь лайк и гони бабки на расчёт твоей модели и твоего агента 😂

🔹Прикрепил несколько скринов из альфа-версии панельки.
  • 🔥 8
  • 👍 4
  • ❤ 2
  • ❤‍🔥 2
  • 😁 1
  • 👌 1
Post #59 119
Друзья, всем привет. Немного потерялся в разработке =) Сейчас делаю 5 проектов одновременно благодаря своему СДВГ и AI-агентам. Параллельно веду курсы для начинающих и разработчиков - кто хочет в следующий батч, пишите в директ. Ещё делаю один очень не приятный процесс для суда. А ещё прошёл в Яндекс как поставщик знаний до 2028 года включительно. Через конкурс, конечно же.

Короче, на посты совсем не осталось времени. Точнее, на их нормальную доработку напильником. Но всё же хочу сделать небольшой + спойлер сразу следющим постом.

Я занимаюсь разработкой с AI-агентами уже достаточно долго по современным меркам. И за это время видел несколько итераций эволюции инструментов и всего обвеса вокруг AI-разработки.

🔹Было примерно так:

• Сначала была чистая модель. Ты отправляешь текст - получаешь текст. Единицы понимали, что реально происходит, как с этим работать и почему модель ошибается.
• Потом появился ChatGPT, и все начали говорить про prompt engineering. Это был этап, когда казалось, что всё решается правильной формулировкой запроса. Но со временем prompt engineering перестал быть отдельной магией и стал базовой частью следующего уровня - context engineering.
• Дальше появились агенты, tools, RAG, memory и оркестраторы. Агенты стали multi-turn, tool-using и long-running. Они начали не просто отвечать, а выполнять цепочки действий: искать, читать, писать код, запускать проверки, обращаться к API, сохранять состояние и продолжать работу через несколько шагов.

🔹И вот тут стало понятно, что важен уже не только промпт. Важно всё, что модель видит на каждом шаге: история, память, документы, tool outputs, инструкции, ограничения, состояние задачи, текущий план, ошибки, результаты тестов.

Так появился context engineering. Но и он постепенно стал частью более широкого слоя - agent/orchestration engineering.

А сейчас мы заходим в следующий слой - harness engineering.

Если совсем коротко: Agent = Model + Harness.

🔹Модель - это только reasoning/generation engine. Harness - это всё, что не является самой моделью, но делает её пригодной для реальной работы:

• system prompts
• tools
• MCP
• sandbox/filesystem/browser
• orchestration logic
• hooks/middleware
• memory
• state
• compaction
• continuation
• lint checks
• tests
• evals
• guardrails
• observability
• recovery loops
• human approval gates

🔹То есть harness - это не просто ещё один промпт и не просто оркестратор. Harness engineering - это проектирование всей среды, в которой агент работает, ошибается, проверяет себя, восстанавливается и доводит задачу до результата.

И вот здесь начинается самое интересное. Потому что настоящий AI-agent workflow - это не написал промпт и получил магию. Это итеративное и последовательное проектирвоани и производство результата.

🔹Агент делает шаг. Проверяет. Получает ошибку. Исправляет. Снова проверяет. Сохраняет состояние. Переходит к следующему шагу. Оставляет трассировку. Делает результат воспроизводимым. И при этом весь процесс лежит на поверхности где каждая итерация контролируема, наблюдаема и может быть инкапсулирована.

Ничего не напоминает? Правильно. Agile в SDLC. Только теперь у нас появляется AI-native версия этого подхода.

Не просто разработчик пишет задачи, коммитит код и гоняет тесты. А агент работает внутри инженерного harness: с правилами, ограничениями, инструментами, проверками, памятью, контекстом и циклами обратной связи.

И, на мой взгляд, именно это сейчас становится главным отличием от я просто пользуюсь AI и я строю production-grade процессы с AI-агентами.

🔹Если по слоям:

• Prompt engineering был про то, как попросить модель.
• Context engineering - про то, что дать модели в голову прямо сейчас.
• Orchestration - про то, какой шаг выполнить дальше.
• Harness engineering - про то, в какой инженерной среде агент живёт, работает, ошибается, проверяется и доводит задачу до результата.

В следующих постах пишу про BIMAD, SPARC, SDD/SPEC, RIPER, FPF ADI подходы и методологии чтобы построить ваш собственный AI-PDLC. И то как @forgeplan дает это и умеет все это сразу + пишет документацию как это нужно.
  • ❤ 9
  • 🔥 4
  • 👍 3
Post #57 131
Ну шта, тестируем новый Opus 4.8 🤞
  • 🔥 6
  • ❤ 3
Post #56 159
Попал сегодня в руки вот такой зверек Herdr. Погоняю недельку, расскажу как работает.

Что это:
Терминальный мультиплексер нового поколения. Внешне - как tmux: workspaces, табы, панели, persistent-сессии, переживающие disconnect. Внутри - семантическое понимание состояния AI-агентов: Herdr через process-detection и эвристики по output видит, что Claude Code сейчас working / blocked (ждёт твой "yes") / done / idle - и показывает весь зоопарк в сайдбаре одним взглядом.

Поддержка из коробки: Claude Code, Codex, Droid, Amp, OpenCode, Cursor Agent, Copilot CLI, Grok, Hermes, Kiro, Pi, Gemini, Cline.

Зачем:
Когда ты гоняешь 3-5 агентов параллельно — tmux не понимает, кто из них залип в ожидании approve, а GUI-обёртки (Electron-приложения) тащат браузер в терминал. Herdr закрывает разрыв: остаёшься в шелле, видишь state-bar, можешь по SSH с телефона приконнектиться к работающим агентам.

🔑 Killer-фича - socket API + CLI, через которые сам агент может открывать панели, запускать в них команды, читать чужой output и ждать чужого done:
• herdr pane split 1-1 --direction right
• herdr pane run 1-2 "npm test"
• herdr wait agent-status 1-2 --status done
• herdr pane read 1-2 --source recent --lines 50

Это превращает терминал в runtime для multi-agent orchestration - агенты координируются между собой, а не дёргают человека.

Как пользоваться (за 30 секунд):
• curl -fsSL https://herdr.dev/install.sh | sh # или brew install herdr
• herdr
• herdr integration install claude # forward state

Конфиг - ~/.config/herdr/config.toml.
18 встроенных тем (Catppuccin, Tokyo Night, Gruvbox…).
Запускается внутри tmux без конфликта.

✅ Use cases
• Параллельно гоняешь 2+ AI-агентов на разных тасках и устал переключать окна
• Хочешь видеть «кто работает, кто залип на approve, кто закончил» одним взглядом
• Работаешь по SSH с удалённого сервера / с телефона — нужен лёгкий single-binary без Electron
• Хочешь, чтобы агент сам открывал side-panel для tail -f логов или прогонял тесты в соседней панели, а не просил тебя
• Команда из нескольких разработчиков делит один remote-хост и хочет shared workspace со statefull-сессиями

❌ Не подходит, если
• Один агент, один проект, один таб - голый терминал или tmux достаточно
• Windows (нативной поддержки нет)
• Нужен просто классический мультиплексер без agent-awareness — tmux/zellij стабильнее и легче
• Не работаешь с CLI-агентами вообще - overhead без пользы
• Корпоративная политика запрещает AGPL в продакшене (тогда нужна коммерческая лицензия - hey@herdr.dev)
  • ❤ 6
  • 🔥 3
Post #55 153
Пример того что у вас проблемы с сессией в Claude Code. Контекст выше 50% или забит до предела.

Это значит одно, фокус внимания модели на днище. Он забывает то что у него было передано в начале и просьбы из AGENTS.md или из CLAUDE.md будут выпадать и повлиять на это без хуков, невозможно.

А /compact вас тоже не спасет так как он теряет важные артефакты. Эффективность LLM в текущей задаче снижается с 80% до 50-60%

Выход один, не делаем несколько разных задач в одной сессии.

Читайте про внимание моделей и станет понятно о чем я.

Upd:
Главный контекст обязан помнить те правила, которые сам применяет - решения о делегировании, роутинге, безопасности.

МЕТА-правила должны быть в оркестраторе и должны выживать.

Узкие правила исполнения он помнить не должен - они принадлежат агентам и скиллам. Но если в главном контексте перегрев - он перестаёт правильно роутить, и тогда правильно прописанные агенты просто не будут вызваны. Поэтому стратификация: инварианты в хуки, роутинг в оркестратор, исполнение в агентов. И будет мэджик 🍑
  • 👍 3
Post #53 187
Обещал рассказать, зачем я ForgePlan вообще начал.

🔸Я делал gerts.ai в соло. Система сложная, многослойная - каждый слой сам по себе нетривиальный, и почти каждый кусок можно было собрать пятью разными способами. Из-за этого вокруг каждого слоя - большой ресёрч и документация: PRD, RFC, ADR, спеки, эпики. В какой-то момент у меня лежало больше тысячи файлов.

🔸Параллельно - другие проекты. Отвлекаюсь на пару недель, возвращаюсь в gerts.ai - и не помню что там уже было. Какой вариант выбрал по этому модулю и тому. Почему именно так. Что уже описал в спеки, а что ещё в работе. Более тысячи файлов есть с артефактами, ориентироваться в голове крайне трудно.

🔸Когда система многослойная, задачи надо закрывать помодульно: эпик, в эпике стори, стори по очереди. Без структуры - перескакиваешь между слоями и ни один до конца не доводишь. Когда используешь агентов.

🔸Я начал ловить себя на том, что второй раз ресёрчу то, что уже ресёрчил месяц назад. И что больнее - похожие ресёрчи никак не связывались с тем, над чем я работаю сейчас. Лежат рядом и не связаны друг с другом.

🔸Открываю папку с каталогами в которых десятки и сотни документов - сам за минуту не скажу, какие релевантны задаче. Агенту я тем более не объясню. А какждый раз посылать агента такое себе. В ответ они пишут дубликаты: уже есть документ про авторизацию - они пишут второй.

🔹Я остановился и выписал, чего не хватает.
- единый формат артефактов по типам
- эпики и стори, чтобы закрывать помодульно
- связный граф документов прямо в артефактах
- сигнал «можно брать задачу в работу или нет», без перечитывания пяти документов
- у каждого решения - аргументы, не «исторически сложилось»
- защита от агентов, которые молча пишут параллельный документ про то же самое

🔸Так начался ForgePlan. Сначала только для gerts.ai. Потом понял, что в любой большой системе с агентами получается то же самое - и инструмент перерос меня.

🔹Сегодня — версия 0.31.0

Почти три сотни артефактов в моём собственном пространстве, около двух тысяч тестов. Каждое решение оставляет след. Каждый след - с подтверждением. Каждое подтверждение честно стареет.

Не «делаю красивый процесс». Просто перестаю забывать сам у себя.

Технические детали — на канале продукта @forgeplan
  • 🔥 4
  • 👍 3
  • ❤ 2
Post #51 187
Инструмент честнее автора — и это норма

Шесть дней назад выкатил версию 0.30.0 ForgePlan @forgeplan.

Защитный спринт, одиннадцать починок разом. Среди них одна, которую я добавил буквально, чтобы инструмент ловил меня самого

PROB-059 (артефакт с типом проблема и под номером 059) Звучит сухо. На практике вот что.

Когда я пишу обоснование решения по продукту, в теле документа перечисляю другие решения, на которые опираюсь. Просто пишу: «связано с тем-то и тем-то». Мысленно ставлю галочку: связь обозначена.

И забываю отдельной командой сказать инструменту: «вот этот документ опирается вот на этот». В тексте связь есть. В системе связь не зафиксирована.

С точки зрения читателя — порядок: он видит ссылку. С точки зрения системы — документ висит сам по себе, без входящих связей. Через месяц инструмент найдёт «сирот» и удивится: «а это что такое лежит без родителей?».

Я ловил себя на этом трижды за пару месяцев. Поэтому в 0.30.0 добавил проверку: читает таблицу связей в теле документа, сверяет с формальной разметкой связей в служебной шапке. Расходится — пишет предупреждение с готовой подсказкой, как починить одной строкой.

Через два дня после релиза запускаю проверку на свежем документе. Предупреждение. На моём собственном. В первый же день.

Я написал проверку, чтобы инструмент ловил меня. Выкатил. Она поймала меня в первый запуск. Не подписчика, не «команду из будущего». Меня. Автора. На свежем документе.

Это и есть парадокс собственного "dogfood". Не «дисциплинированный фаундер тестирует продукт». А «инструмент честнее автора, потому что не помнит, кто его написал».

Если я встраиваю проверку для себя — это норма. Это значит, инструмент стал внешним проверяющим, а не помощником, который кивает и поддакивает лишь бы угодить. Как это любит делать семейство моделй и агентво от антропиков =)

Пишу про обвязку вокруг Ai тут
  • 🔥 4
  • ❤ 2
  • 👍 2
Post #50 157
Всем привет, давно ничего не писал.

Следующие несколько недель открыто рассказываю, что строю.

Я фаундер с четырьмя стеками одновременно.

ForgePlan — инженерный фреймворк решений, главный мой долг прямо сейчас.
Orchestra — управление задачами и общение команды.
Gerts.ai — отдельная история, расскажу когда созреет.

И есть еще https://extraboost.ai + поток обучения который я в данный момент веду, через который я перевожу методологию на человеческий и обучаю разработчиков и не тольок, вайбкодить/кодить с ai/создавать свой личный harness

В голове это не четыре проекта. Это один стек времени, прокрученный через четыре поверхности.

Ближайшие нескольок недель — серия из постов, в которой я честно показываю:

— зачем я вообще начал ForgePlan и какую боль он решает
— самый болезненный баг, который я нашёл сам у себя
— как у меня уживаются четыре (на самом деле больше) проекта одновременно
— что я вижу, когда работаю с разработчиками над AI
— один паттерн, который повторяется везде
— и куда это всё движется через 6 недель / 6 месяцев / 6 кварталов

Без приукрашивания. С конкретными примерами, артефактами и своими ошибками.

Если интересно — лайк.

Если про техническую начинку ForgePlan — есть отдельный канал продукта @forgeplan

🔸GitHub: https://github.com/ForgePlan
🔸ProductPage: https://forgeplan.dev/
🔸Docs: https://forgeplan.dev/docs/methodology/overview
🔸MarketPlace: https://github.com/ForgePlan/marketplace
  • ❤ 7
  • 🔥 5
  • 👍 3
Post #48
Channel name was changed to «Eli Rum and Ai»
Post #42 219
Всем привет!

Как вы?

А я вот с лета прошлого года в активной разработке нового проекта (дам скрины из ЛК чтобы хоть одним глазком посмотреть) и вот только сейчас выдохнул чуть чуть, было очень много работы. В соло и с моими 20+ агентами я написал проект с более чем 1.5 млн строк: фронтенд + бэкенд + ai systems. И это не считая еще более чем 500K строк проектной документации.

В конце прошлого года вышли флагманские модели от Google, Anthropic и OpenAi. И львиная доля людей которые хоть как то касались мира разработки (и не только они) прочуствовала силу разработки с помощью Ai агентов.

Вот основные инсайты:
• Вместо месяцев продумывания и провреки/разработки своей гипотезы/идеи/pet-project или любого другого проекта на который нет много времени и средств, сейчас ты на это тратишь какие то дни.
• Вместо года продуктовой разработки для MVP и многих бессонных ночей, сейчас стало возможным сделать это за 1-2 месяца. И это я говорю про продуктовый проект а не про кривую какую то штуку запиленую на коленке.
• Вместо месяцев ресерчей и прототипирования архитетктуры и месяцев сбора информации и анализа сейчас ты тратишь всего лишь недели.

В данный момент почти любой человек даже не из мира It может достаточно быстро включиться в индустрию. И также быстро и относительно легко получит то что ему нужно.

Это стало чем то фантастическим но уже вполне реальным.

Это стало реальностью и для меня. Я смог сделать первую версию своего решения. Но оно пока в закрытой бете. Сейчас доделываю последние правки для первого пилотного коммерчсекого проекта.

Что это вообще такое, рассказываю:
Я делаю платформу для создания слоя памяти как для думающих агентов так и для построения KMS (Knoweledge managemnt system) Это платформа которая обрабатывает входящие данные и затем позволяет ходить в эти данные и не просто получать а понимать структуру и контекст. Понимать домен данных и работать с данными на языке домена. Например на терминах медицины, it или юриспруденции и других. Тоесть агент обращаясь в Gerts получает карту знаний, сами знания и инструкции как ходить по этим знаниям. Если проводить аналогию то агент получает зрение и инстурменты чтобы ориентироваться в системе знаний с помощью gps и карты. Он видит как данные связаны между собой. Агент может спросить: "Эй! Где я? Какие есть данные? Как мне получить вот это или то? Как они связаны? И дай мне вот такую вот информацию. Дай мне путь до таких вот данных"

Кроме самих знаний там есть многослойная система памяти для агентов. С рефлексией и многим другим что необходимо агентам при построении пайплайнов автоматизаций и не теряться в своих же рассуждениях.

Сайт проекта https://gerts.ai, вы можете попасть в лист ожидания для первого демо показа.

Прикладываю несколько картинок чтобы было что показать (и простите за ужасное качество скринов, в будущем будет лучше)
  • ❤ 5
  • 👍 2
  • 🔥 2
  • 🥰 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →