
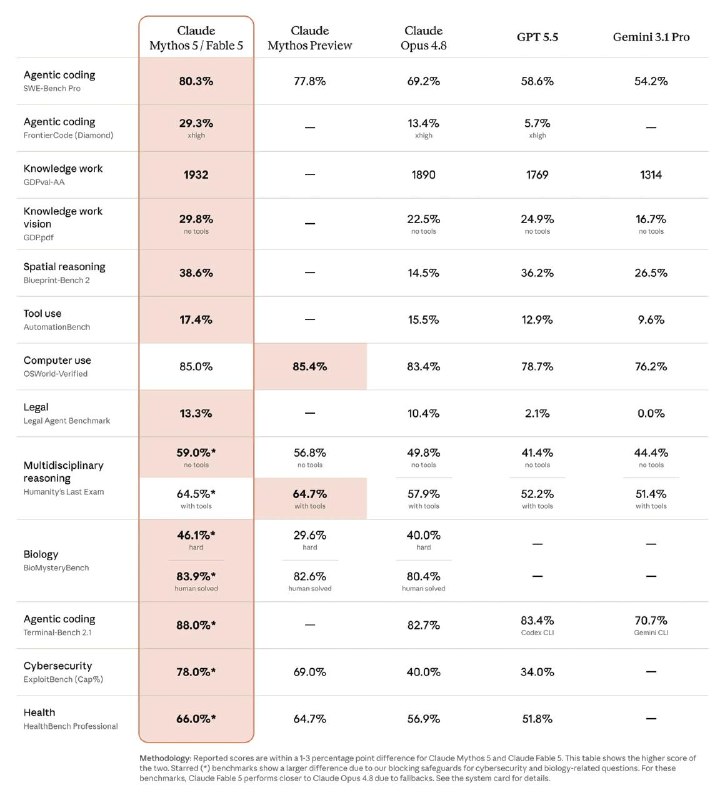
Anthropic выпустила Fable 5 — модель, которую лучше воспринимать не как "Claude для чата", а как дорогого senior-агента для длинных автономных задач.
🔹Где у неё основной буст
Не в коротких вопросах и не в исправлении одной строки.
Fable заточена под задачи, где нужно несколько часов подряд:
• изучать большую кодовую базу
• составлять и удерживать план
• работать с tools и файлами
• запускать проверки
• находить свои ошибки
• доводить большой кусок работы до результата
По ранним тестам модель особенно сильно отрывается именно на long-horizon задачах. Every на своём внутреннем инженерном бенчмарке получила 91/100 против 63 у Opus 4.8 и 62 у GPT-5.5.
Это не универсальный научный бенчмарк, но разница интересная.
В другом тесте Fable одним промптом собрала клон collaborative document editor примерно за три часа без доступа к исходному коду. Затем сняла скриншоты desktop и mobile, нашла визуальные дефекты и исправила их без отдельного QA-промпта.
То есть скачок не в том, что она чуть лучше пишет функцию. Скачок в том, что ей можно отдать результат целиком.
🔹Но есть нюанс
Fable дорогая:
• $10 за миллион входных токенов
• $50 за миллион выходных
Это примерно в два раза дороже Opus 4.8.
До 22 июня она включена в платные подписки Claude, дальше Anthropic планирует перевести использование на credits. Если мощностей станет больше, условия могут изменить.
На коротких задачах разницу можно не почувствовать, а заплатить заметно больше. Использовать её как модель «на каждый вопрос» пока выглядит странно.
🔹Ещё один важный момент — safety-фильтры
Fable проверяет не только последнюю фразу пользователя. Под фильтр может попасть весь контекст:
• system prompt
• CLAUDE.md
• skills и memory
• документы
• результаты tools и MCP
• предыдущие сообщения
И вот мой студент уже поймал false positive.
Он попросил выполнить ADI-цикл для решения инварианта, затем создать ADR. После загрузки skill
fpf:fpf Claude Code показал:“Fable 5's safety measures flagged this message for cybersecurity or biology topics”
После чего система сама переключила запрос на Opus 4.8.
Никакого кибербеза или биологии в запросе не было.
Вероятнее всего, классификатор зацепился за инструкции внутри skill: reasoning, гипотезы, пошаговый анализ или формулировки, похожие на извлечение внутреннего thinking модели.
То есть safety теперь работает уже не только на уровне prompt. Она анализирует весь harness-контекст агента.
Автопереключение можно отключить через
/config, но сам фильтр это не выключает. Вместо fallback задача просто остановится.🔹И здесь начинается самое интересное
Старые skills, раздутые системные промпты и слишком жёсткий scaffolding могут уже не помогать, а ограничивать новую модель — или вызывать ложные срабатывания.
Больше harness — не всегда лучше harness.
Нужно проверять:
• какой контекст получает модель
• какие инструкции дублируются
• сколько она делает tool calls
• где сама проверяет результат
• где нужен recovery loop
• где human approval действительно обязателен
🔹Мой предварительный вывод
Fable 5 — это не замена Opus для каждого запроса.
Это дорогой senior-агент для больших long-horizon задач, где важны итоговое качество, стоимость всей работы и количество человеческих вмешательств, а не скорость первого ответа.
И это ещё раз подтверждает мою любимую формулу:
Agent = Model + Harness.
Оценивать отдельно модель уже почти бессмысленно. Нужно смотреть, как конкретная модель работает внутри конкретного harness: сколько стоит задача, сколько времени занимает, сколько делает tool calls, сколько раз ошибается и какой результат выдаёт в конце.
Собственно, именно для этого я и делаю POLLMEVALS.
Буду гонять Fable на больших задачах. Если уже успели попробовать — пишите, где увидели разницу с Opus 4.8, а где просто потратили лимиты 😂
#ai #developemnt #agents #lessons #vibecoding #aidevelopment