TGViewer
Channel Public Channel
Eli Rum - Tech & Ai

Eli Rum - Tech & Ai

@somecrazyhands

Пишу про Ai, стартапы и технологии. Немного за жизнь. Моя визитка https://elirum.me Harness AI framework https://forgeplan.dev Мастерская по Ai кодингу https://extraboost.ai Чат центрик таск трекер https://orch.so и ai knoweledge layer https://gerta.ai
Subscribers
463
Photos
51
Videos
0
Links
27

Showing posts older than #42 · Back to latest

Older Posts 14 shown
Post #41 499
Первый пост про кредиты и поддержку стартапов

Готовые ответы-шаблоны (можно копипастить в формы)


A. «Поддержка акселератора/фонда»
Да. Мы — портфель {название акселератора/VC}, batch {год}. Organization ID для AWS: {XXXX}. Контакт: {Name, email}. Участвуем в программе Microsoft Investor Offer через {фонд/акселератор}.
Нет. Ничего не пишем

B. «Описание продукта и AI-нагрузки»
Мы строим {1-2 предложения о продукте}. Основные AI-задачи: {инференс/файнтюн/обучение}, объёмы — {примерный трафик/час}. Инфраструктура: Workers/edge для LLM-оркестрации, GCP для тренировки/данных, AWS Bedrock для доступа к провайдерам (Anthropic, Cohere, Mistral).

C. «План использования кредитов»
Q1–Q2: миграция фронта/API-шлюзов на Workers, CDN/безопасность, R2. Q2–Q3: эксперименты с Claude/Bedrock, пилотный тренинг на GCP. Q3–Q4: масштабирование стабильных путей, подключение Customer Care/Enhanced Support (GCP) по мере роста.
The Cloudflare Blog
Google Cloud

D. «Комплаенс/биллинг»
Корпоративный домен, платежный метод добавлен. С условиями кредитов и сроками ознакомлены, следим за датой в консоли.


Тактика подачи (чек-лист)

✅ Сначала — статус: кто вы, стадия, ссылка на сайт/дек/демо (некоторые пакеты требуют сайт и возраст компании).

✅ Аффилиации: добавьте в заявку акселератор/VC и Organization ID (AWS), отметьте участие в Microsoft Investor Offer (если применимо)

✅ AI-use-case: 2–3 предложения, какие модели и зачем; укажите план по compute и хранению (edge-инференс / тренировки в облаке).

Полезные ссылки (сохраните)
- Cloudflare for Startups (tiers и срок действия)
- Ограничения корзин (Workers AI/R2/Cache Reserve)
- AWS Activate — кредиты и eligibility
- AWS Activate Portfolio — шаги и требования (Org ID и пр.)
- GCP Startups — до $350k для AI (программа/бенефиты)
- Microsoft for Startups — базовый вход и Investor Offer
- Anthropic for Startups — страница для стартапов и VC-партнёров

Итог:
У каждого стартапа есть шанс собрать значимый «кредит-стек». Аффилиация с акселератором/VC ускоряет и увеличивает пакеты; (подавайтесь в аксели как тольок сможете) многие программы напрямую спрашивают про поддержку и проверяют её через партнёров.

Если кому то нужна помощь, пишите в личку, помогу.
  • ❤ 7
  • ❤‍🔥 5
  • 🔥 2
Post #38 317
По просьбам рябят из чата LLM neighbors (здаров парни 🤘) пишу пост о том как я собрал более ста тысяч $ в облачных/AI кредитах для своего стартапа — и как может это сделать почти любой (моя компания https://orch.so имеет поддержку акселератора)

Будет несколько постов

На данный момент мы пока получили 152 600 USD:
- Amazon 25 100 USD (можно увеличить, нужно писать им еще раз)
- Google 25 000 USD (можно увеличить до 350 если выйти на >2k берна в месяц)
- Cloudflare 100 000 USD
- Microsoft 1 000 USD (у этих тоже можно поднять, нужно им еще раз написать, они что то напутали когда заявку обрабатывали. Дали 1к для неаффилированных — до $5k а мы аффилированны)
- Anthropic 1 500 USD

Пдаваться может почти каждый. Если вы уже в акселераторе/у инвестора — суммы и шанс выше: многие программы проверяют аффилиацию и дают «портфельные» пакеты например,
- у AWS нужен Organization ID партнёра;
- у Microsoft есть Investor Network;
- у Anthropic — стартап-программа через VC/акселераторы

Что дают крупные программы (моя выборка и ориентиры)

Cloudflare for Startups — до $250k кредитов на Developer Platform
- Workers
- R2
- Workers AI и др
C лимитами внутри корзины (например, до $50k на Workers AI и до $10k на R2/Cache Reserve по условиям плана). Кредиты обычно действуют до 1 года или пока не израсходуете.

AWS Activate — до $100k кредитов. Для Portfolio пакета нужен Organization ID вашего акселератора/фонда; есть и Founders путь для self-funded. Типичные критерии: pre-Series B, сайт, возраст компании ≤10 лет. Срок действия кредитов ограничен (чаще 1–2 года, смотрите дату в консоли/письме).

Google for Startups Cloud (AI Program) — до $350k кредитов для AI-стартапов (Scale-tier), плюс стандартные Start/Scale пакеты (например, покрытие до $100k в 1-й год и до $100k на 20% во 2-й для Scale). Срок/инкременты видны в консоли; кредиты имеют дату истечения.

Microsoft for Startups — базовый вход с Azure-кредитами (для неаффилированных — до $5k), а Investor Offer для портфельных — обычно от $100k Azure и выше.

Anthropic for Startups — API-кредиты + повышенные лимиты через VC/акселераторы (подаваться через партнёра/инвестора).

Бонус: у AWS отдельно продвигают кредиты на модели через Bedrock (Anthropic, Cohere, Mistral, Meta и др.) — удобно для быстрых экспериментов.

Что спрашивают в заявках (и как отвечать)

1) «Есть ли у вас поддержка акселератора/фонда?»
Если да — укажите программу и контакт. Для AWS это прямо ключ к Portfolio (нужен Organization ID), для Microsoft — попадание в Investor Network даёт другой уровень бенефитов, у Anthropic — заявки идут через VC/акселераторов.
Пример формулировки:

Да. Мы — портфельная компания X Accelerator (Batch 2025). Контакт менеджера: First name Last Name, email@…

2) «Стадия, возраст, сайт»
Следите за базовыми критериям: < или pre-Series B, возраст до 10 лет, работающий сайт/профиль.
Пример:
Инкорпорированы в 2024, pre-seed, сайт https://…


3) «Как вы используете AI/облако?»
Покажите понятный продуктовый сценарий и план расходования compute (инференс/тренировка, хранение, сеть).
Пример:
Используем Claude/GPT-модели для суммаризации тикетов и RAG. План: 60% инференс в edge (Cloudflare Workers AI), 30% — GCP TPU/GPU на обучение узких моделей, 10% — AWS Bedrock для мульти-моделей и экспериментов.

4) «Когда активировать кредиты?»
Следите за датой истечения — во многих программах кредиты ограничены по сроку и начинают «тикать» с момента выдачи/активации. Проверяйте дату в консоли/писме и условия программы.
Пример:
Активируем поэтапно, чтобы не было параллельного расхода. Контролируем даты в консоли (AWS/GCP показывают expiry).
  • 🔥 5
  • ❤ 3
  • ❤‍🔥 2
  • 👍 1
Post #36 216
Пост #3 - про работу LLM на простых аналогиях.

Первый пост - прыг
Второй пост - прыг

6. Почему Они "Знают" Так Много? (Масштаб)
- Технический термин: Масштаб данных, модели и вычислений.
- Аналогия: Почему LLM кажутся такими умными? Масштаб!
- Данные: Их "средой обитания" при обучении был практически весь значимый текчт челловечества. Это как если бы животное прожило миллионы жизней в самых разных уголках планеты. Такой прокачанный супер заяц который шел к реке и видел миллиарды проявлений этой вселенной и все познал на своем пути =)
- Параметры: Их "мозг" (количество параметров) колоссален (миллиарды/триллионы связей). Это позволяет "запомнить" невероятно сложные и тонкие закономерности.
- Вычисления: Обучение требует мощнейших компьютеров и много времени. Это как интенсивное, ускоренное формирование опыта. Как если бы заяц получил опыт триллионов вариаций его жизней за 1 секунду. Вот в реальной работе LLM, чтобы добиться таких показателей необходимо много вычислительной мощности. Чтобы не ждать последовательно выполняющихся жизней и кучи времени, когда модель обучится. А просто сделать это параллельно на тысячах серверах одновременно. Это как бы симуляция 100500 вариаций разных событий как уже ранее я пояснил.

7. Важные Ограничения (Галлюцинации, Смещения)
- Технический термин: Галлюцинации (генерация ложной, но правдоподобной информации), Смещения (Bias) (отражение предубеждений в данных).
- Аналогия: Помнишь, LLM — это не разум, а "замороженный статистический опыт" предположительно возможный опыт.
- Галлюцинации: Если животное в новом месте по ошибке принимает куст за хищника (ложная ассоциация), то LLM может "придумать" факт или ссылку, которая *статистически/предположительно правдоподобна* в ее "опыте", но не соответствует реальности. Она не "лжет", она "идет по неверной тропинке", которая кажется ей вероятной.
- Смещения: Если в данных, на которых училась модель, были предубеждения (например, стереотипы о профессиях), они отразятся в ее ответах. Как если бы животное выросло в опасной среде и видело угрозу там, где ее нет. LLM не понимает "хорошо/плохо", она отражает закономерности своих "сценариев обучения". У людей с ПТСР и разными травмами например такое, или у животных которые росли в насильственных условиях. Там суть одна и таже

Итого:
Большая Языковая Модель — это гигантский "замороженный опыт", полученный из океана текста. Ее "мозг" (параметры) настолько сложен, что позволяет ей "идти по тропинкам" слов (токенов), генерируя осмысленный текст. Каждый следующий шаг определяется статистической вероятностью, основанной на этом опыте, и контекстом всего пути (благодаря "вниманию"). Как и поведение животного, сформированного его жизнью, реакцию LLM на ваш запрос можно предсказать, зная ее "опыт" (параметры) и стартовую точку (промпт). Это не какая то магия, а результат колоссального масштаба данных и вычислений, кодирующих закономерности человеческого языка в миллиардах чисел.

Ключевая Мысль:
"Модель идет по тропинке. А тропинку задают параметры, которые в ней есть... Как животное, набравшее опыт, идет предсказуемым путем — так и LLM генерирует текст, следуя по 'тропе' своего замороженного опыта."

Спасибо за внимание, оч надеюсь что смог донести сложную штуку простым языком.

P.S На самом деле там все сложнее и есть 100500 разных нюансов, но я специально уппростил двсе ля понимания. И сделал это так чтобы основная механика работы осталась и не потерялся смысл. Так что в целом это можно использовать для объяснения как работает LLM кому угодно

Люблю лайки, перепосты и комментарии.
  • ❤ 5
  • 👍 3
  • ❤‍🔥 1
  • 🔥 1
Post #35 147
Пост #2 - про работу LLM на простых аналогиях.

Первый пост - прыг

2. Обучение: Формирование "Опыта" (Тренировка на Данных)
- Технический термин: Обучение на данных (терабайты/петабайты текста из интернета, книг и т.д.).
- Аналогия: Как животное учится в своей среде обитания (находит воду по запаху, прячется от опасности), так LLM "учится", "читая" огромные объемы текста. Она видит триллионы предложений, слов, фраз. Ее задача во время обучения: предсказать, какое слово (токен) будет следующим. Делая это снова и снова, корректируя свои внутренние "настройки" (параметры) на основе ошибок, она выявляет закономерности языка: какие слова часто стоят вместе, как строятся предложения, какие факты связаны. Этот процесс и формирует ее "опыт".

3. Текст = Цепочка Шагов (Токенизация)
- Технический термин: Токенизация (разбиение текста на мелкие части - токены: слова, слоги, символы).
- Аналогия: Представьте, что путь животного по лесу — это цепочка шагов. Каждый шаг ведет к следующему. В LLM любой текст — это тоже цепочка. Но вместо шагов — токены. Ваш вопрос или команда (промпт) сначала разбиваются на эти маленькие кусочки-токены. Это стартовая точка на "тропинке" модели.

4. "Идти по Тропинке" (Генерация Текста)
- Технический термин: Авторегрессивная генерация (предсказание следующего токена на основе предыдущих).
- Аналогия: Вы даете модели промпт (старт). Основываясь на своем "замороженном опыте" (параметрах), модель "видит" перед собой ландшафт возможных "тропинок" — то есть, последовательностей токенов, которые могут следовать за вашим промптом. Каждый ее следующий "шаг" (сгенерированный токен) — это выбор, куда идти дальше в этом ландшафте, исходя из ее "опыта". Она не думает, а следует по наиболее вероятному пути, который заложили в нее параметры, полученные при обучении. Как заяц в знакомой местности инстинктивно выбирает тропу к воде, так LLM "инстинктивно" (статистически) выбирает следующий токен.

5. "Вспомнить Всё Важное Сразу" (Механизм Внимания)
- Технический термин: Самовнимание (Self-Attention) в архитектуре LLM это называется Трансформер.
- Аналогия: Представьте, что животное идет по тропе и видит след хищника. Чтобы понять опасность, ему нужно мгновенно вспомнить весь прошлый опыт, связанный с этим следом, запахом, местностью — даже если это было давно. Механизм внимания в LLM делает нечто подобное! Когда модель генерирует *текущий* "шаг" (токен), она может "оглянуться" на ЛЮБОЙ предыдущий токен в цепочке (промпте и уже сгенерированном тексте) и решить, насколько сильно он важен для выбора *именно этого* следующего шага. Например, для слова "он" в предложении "Кот сел на коврик, потому что он был мягкий", механизм внимания сильно "посмотрит" на слово "коврик". Это позволяет модели учитывать контекст, даже если нужная информация была далеко назад. Это достаточно важный и супер сложный механизм.

Продолжение в след посте
  • ❤ 3
  • 🔥 3
  • 🦄 2
Post #34 127
Я обещал статьи про LLM и про GPT, вот первая

Как всегда в след постах будут хронологические ссылки, по ним можно будет прыгать.

Как "Думает" ИИ: А конкретно Большие Языковые Модели - (LLM)?
На западе хайп по ИИ уже очень давно а у нас в православной не так уж. Но зато время уже почти каждый знает что такое ChatGPT, Claude, Gemini и другие чатоподобные штуки с ИИ. Если кратко то это "умные" программы, умеющие писать тексты, отвечать на вопросы, сочинять стихи, делать исследования, писать код и много другое. Их называют Большими Языковыми Моделями (LLM - Large Language Models). Слышать слышали а что это и как это работают не все понимают, а некоторые даже даже приблизительно. Если кому интересно то попробую пояснить на примере... На аналогии животного, например зайца!

Сразу дам несколько терминов и их аналогии из мира животного, нашего зайца.
0. Модель ИИ - Это сам заяц
1. Параметры модели ИИ — Это "Замороженный опыт зайца"
2. Тренировка на данных для ИИ — Это обучение зайца или формирование "Жизненного опыта"
3. Токенизация модели или просто текст — Это цепочка шагов или последовательность действий у зайца.
4. Генерация текста в модели — Это как бы поход или бег зайца по по тропинке.
5. Механизм внимания ИИ — Это когда зайцу нужно было бы вспомнить Всё Важное Сразу при каких то событиях
6. Масштаб данных модели — Это размер и количество знаний в памяти у зайца.
7. Галлюцинации и смещения модели — Это важные Ограничения в работе мозга/памяти зайца

Теперь пояснение что есть что и как работает LLM

1. ИИ — Это "Замороженный Опыт" (Параметры Модели)
- Технический термин: Параметры нейронной сети (миллиарды/триллионы чисел внутри модели).
- Аналогия: Представьте животное, выращенное в уникальных условиях. Всю свою жизнь оно видит определенные пейзажи, слышит звуки, получает пищу в ответ на действия. Этот весь накопленный опыт формирует его мозг — его "настройки". У LLM эти "настройки" — и есть параметры. Их огромное количество (миллиарды или триллионы), и они фиксированы после обучения. Как мозг взрослого животного уже "запрограммирован" его прошлым, так и параметры LLM содержат весь ее "опыт". С людьми +- все тоже самое только в 100500 раз сложнее

Продолжение в следующем посте
  • ❤ 4
  • 👍 3
  • 🔥 3
Post #32 110
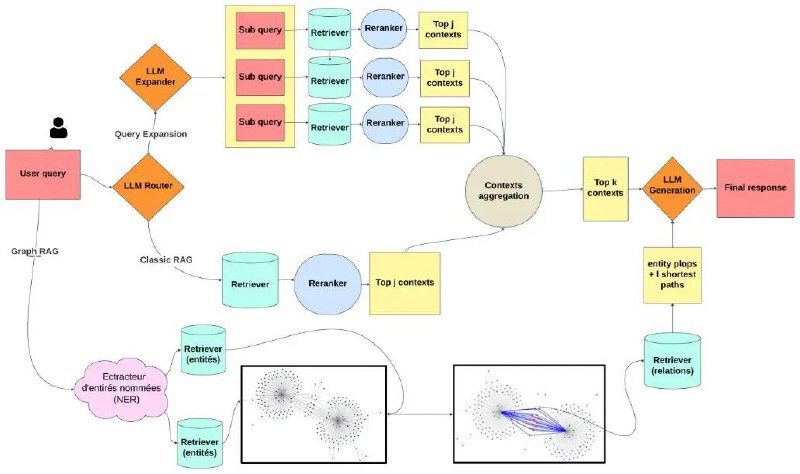
📝 Пост #5. Graph RAG — когда простого поиска недостаточно

Первый пост - что такое RAG
Второй пост - чанки для RAG
Третий пост - Router-LLM
Четвертый пост - Гибридный поиск для RAG

Обычный RAG умеет искать «похожие тексты». Но сложные вопросы — это связи между фактами. Тут в бой идёт граф знаний (Knoweledge graph)


💬 - На первом изображении супер простое пояснение
💬 - На втором то что работает хорошо и то к чему я сейчас стремлюсь разрабатываю ядро Graph Enhanced Realtime Summarization (GERTS) у себя в Orch.so

Где спотыкается классический поиск. Примеры запросов:
- «Кто руководит проектом, где идет диалог про дизайн нового лэндоса?» — нужно 2 прыжка (Чат/задача лендинга → проект → руководитель).
- «Какие главы политики ⚖️ GDPR перекрываются с нашим NDA?» — нужно сопоставить два набора документов.
- Dense / BM25 - SPARSE - дают набор разрозненных чанков и не понимают, как они связаны.

Что даёт граф
- Узлы — сущности (проект, задача, документ).
- Рёбра — отношения («участвует», «руководит», «ссылается»).
- Поиск по графу + текст = мульти-хоп reasoning без галлюцинаций.
- Легко показать путь ответа → повышается доверие.

Мини-pipeline

User query
│
▼
1. Graph traversal (2-3 хопа)
│ ↘ кандидаты узлов
2. Vector search по тексту узлов
│
3. Rerank + цитаты
│
▼
LLM-ответ + путь доказательства


Быстрый чек-лист внедрения
- Строим KG: Neo4j / AWS Neptune / ArangoDB или любая другая граф ориентированная база данных
- Связываем узлы с ID чанков в векторной базе (Milvus, PgVector and etc)
- GraphRetriever (LangChain) или graph_rag в Bedrock — из коробки.
- Для многоязычия: храните lang в атрибутах узлов и фильтровать на этапе traversal.
- Multi-hop > 3? Летим в recursion: LLM генерирует следующий под-запрос.

Когда точно пригодится
- Cross-project вопросы («Кто ещё использует либу jquery?»).
- Compliance: сопоставление внутренних процедур и внешних регуляций.
- Диагностика багов по цепочке зависимостей.
- Аналитика: «покажи KPI проектов, связанных с клиентом _Рога_и_Корыта_».

Что почитать
- Neo4j — Using a Knowledge Graph to implement a RAG app
- AWS Bedrock GraphRAG
- HopRAG (arXiv 2025)
- KG²RAG / Knowledge-Graph Guided RAG

💬 Следующий пост: выбор моделей и инфраструктуры
  • ❤ 4
  • 🔥 4
  • 👍 1
Post #30 113
📝 Пост #4. Гибридный поиск для RAG

Первый пост - что такое RAG
Второй пост - чанки для RAG
Третий пост - Router-LLM

💡Один вектор — хорошо, а два + reranker — точнее и быстрее


Hybrid search — объединение плотных (dense) эмбеддингов и разрежённых (BM25/SPLADE) счётчиков — даёт заметный прирост recall/precision для RAG-систем: лично мои бенчмарки показывают +8-25 % recall и –40 % галлюцинаций по сравнению с чистым векторным поиском. Ключ к успеху — правильно объединить два ранжирования и добавить лёгкий cross-encoder reranker (например BGE-Reranker-m3-v2 или Cohere v3) для последней сортировки топ-кандидатов

💬 - На первом скрине нарисован pipeline как делаем запросы с помощью гибрида.
💬 - А на втором то как я делаю с гибридной норрмализацией и fusion

Почему одного метода мало
- BM25/SPARSE отлично ловят точные идентификаторы и редкие термины (“TS-12345”, NullPointerException) а в случае с SPARSE и семантические синонимы— dense-вектор их часто игнорирует.
- Dense эмбеддинги спасают, когда формулировки различаются (“график продаж” vs “trend of revenue”).
- Reranker (cross-encoder) умеет видеть полный токен-в-токен контекст и поднимает действительно релевантные чанки вверх.

Базовый pipeline
- Query → получаем sparse-вектор (BM25 или SPLADE) и dense-вектор (BGE-M3).
- Hybrid retrieve: объединяем топ-k (например k=50) из обеих выборок. Milvus и Qdrant умеют делать это за один hybridSearch вызов.
- Rerank (k≈80 → 15 шт.) Reciprocal Rank Fusion или BGE-Reranker-v2-m3.
- LLM получает уже «вычищенный» контекст.

Практические советы
- Нормализуйте веса: score = 0.7*dense + 0.3*sparse, либо используйте встроенный RRF — не зависите от абсолютных шкал.
- Перед rerank’ом фильтруйте дубликаты по ID чанка, иначе cross-encoder впустую тратит время.
- Для кода полезно поднять вес BM25: точный токен (.env, rm -rf) важнее общей семантики и можно заморочиться с SPARSE, но это нужно уметь
- Multi-vector (Chroma, Milvus и тп) — храните рядом эмбеддинг summary и сырых чанкoв, повышает отзыв на диалогах.


Еще раз чтобы лучше запомнить:

Зачем скрещивать методы?
- BM25 ловит точные ID и редкие термины (`TS-12345`, `NPE`).
- Dense понимает смысл, даже если слова другие.
- Reranker (cross-encoder) ставит на верх то, что отвечает правде.

Как это работает
- Из запроса делаем *два* вектора: sparse и dense.
- Гибридный retriever берёт top-50 из каждого → объединяет.
- RRF или bge-reranker пересортировывает топ-15.
- LLM получает чистый контекст — меньше токенов, выше точность.

Настройка на практике
- Вес по умолчанию: 0.7*dense + 0.3*sparse.
- Если запрос содержит точный номер или код → 0.4/0.6.
- k для rerank: 80 (хватает, чтобы не упустить редкий факт).
- Удаляйте дубликаты по chunk\_uid до rerank’а.

Что почитать
- Milvus HybridSearch + RRF Ranker
- Weaviate «Hybrid search explained»
- BGE-Reranker v2-m3 (HF)
- Qdrant tutorial по rerank’у

💬 Следующй пост: Graph RAG — когда простого поиска недостаточно.

Люблю репосты и лайки 🥰
  • 🔥 5
  • ❤ 4
  • 👍 1
Post #27 99
📝 Пост #3. Router-LLM для RAG — мозг маршрутизации

Первый пост - что такое RAG
Второй пост - чанки для RAG

Чтобы RAG не стрелял из пушки по воробьям, научим его сначала понимать запрос.


Зачем нужен роутер?
LLM-бот 📜 ≠ универсальный ответчик.
• «Где ссылка на PR?» — хватит dense-поиска по коду.
• «Собери отчёт по продажам» — лучше SQL-tool.
• «Как на испанском будет “chunk”?» — достаточно встроенных знаний модели.

Router-LLM читает запрос и решает, какой инструмент (retriever/SQL/web/agent) нужен — экономим токены и время.

Как определить intent?
1. Маленький LLM-классификатор (≈ 1-3 ¢/к) выдаёт JSON:
{ "intent":"fact", "contains_code":false, "lang":"ru" }.
2. Правила fallback:
есть «http» ➜ веб-поиск
есть “SELECT” ➜ SQL
⌘-символы ➜ code-help
3. Можно подключить LangChain SelfQueryRetriever — он сам превращает вопрос в фильтр по метаданным.

Пример схемы


User query
│
▼
Router-LLM
├── fact / how-to → hybrid dense+BM25
├── code-help → code-vector + Reranker (DeepSeek и bge-reranker-m3-v3)
├── analytics → SQL-tool + summarizer
└── unknown → fallback LLM


Быстрый чек-лист
✅- Язык детектируем за 1 проход (bcp-47 tag).
✅- contains_code — RegExp на \`\`\`, {}, ;, `class`…
✅- pickRerank:
- есть exact id / номер → ↑BM25, ↓dense.
- запрос ≥ 70 симв. и без спец. слов → ↑dense.
✅- Отдавать Top-k = 10, потом Rerank (example: BGE-reranker-m3-v2) только если overlap < 0.4.

Что почитать
- LangChain Self-Querying Retriever — умеет писать фильтры сам.
- LlamaIndex Router Query Engine — пример на 3 хранилища.
- DeepSieve — роутит под-вопросы на лету.

Зачем именно так:
1️⃣ - Semantic routing повышает точность RAG-чат-ботов на 15–30 %.
2️⃣ - Self-Querying Retriever генерирует структурный filter → сокращает токены на 40 %.
3️⃣ - В LlamaIndex RouterQueryEngine достаточно 5–7 примеров, чтобы LLM стабильно выбирал нужный retriever.
4️⃣ - Свежая работа DeepSieve показывает sub-question routing между локальным и глобальным индексом.

💬 Следующий пост
- Гибридный поиск dense + BM25 + rerank — почему одного вектора мало.
  • 🔥 4
  • 👍 1
Post #26 99
📝 Пост #2. Чанки для RAG

Первый пост - что такое RAG

Без правильной «нарезки» документов даже самый умный бот найдёт не то, что вы ищете.


Что такое чанк?
Фрагмент текста (≈ 200–400 токенов, про токены я дам отдельный пост чтобы лучше понимать что это), который отправляется в векторную БД. Размер подобран так, чтобы:
• поместиться в память модели;
• содержать законченную мысль;
• быстро индексироваться.

Зачем нужен оверлап?
Добавьте 10–20 % (≈ 50 токенов) перекрытия — факты на границе не потеряются и увеличится recall. Чтобы был нахлест текста/контекста в старых и новых чанках. Хвост первого в начале второго.

Как «резать» правильно
— Скользящее окно для PDF и длинных статей.
— Семантический сплиттер — когда важна логика: LLM сама подсвечивает места разрыва.
— Диалог: одно сообщение = один чанк - это уже законченная мысль. Или несколько коротких сообщений по семантике

Многоуровневый приём
LOW → MID → TOP
1. Сначала сохраняем «сырые» куски.
2. На их основе генерируем краткие summary-чанки.
3. И лишь затем пишем «супер-резюме» документа/проекта.

Быстрый чек-лист
- size 200-400 токенов
- overlap 50-100
- чистый текст, без HTML/Markdown
- в индексе держим и текст, и summary
- текст, код, pdf — всё делим отдельно, чтобы выбрать правильную модель

Почему именно такие правила?
- Размер 200-400 токенов признан оптимумом для RAG: меньше — рвёт контекст, больше — падает точность
- Перекрытие 10–20 % спасает факты на границе чанков
- Иерархическое (multi-level) хранение улучшает recall на 25 % (MAL-RAG, Summary Index)
- Семантическое или кластерное разбиение полезно для плохо структурированных PDF и презентаций

💡 Помним
Хороший чанк — половина успеха гибридного поиска. Лучший поиск → меньше галлюцинаций → довольнее пользователи.
  • 🔥 3
Post #25 126
📝 Пост #1. Зачем вообще нужен RAG?

Пишу серию постов про AI, а конкретно про RAG. Если вы только начинаете разбираться в AI или думаете, как поступиться к задаче с большим объёмом данных.

Понятным зыком для православной.
RAG (Retrieval-Augmented Generation, генерация с расширением через поиск) — это подход, при котором языковая модель для ответа на вопрос сначала ищет релевантные фрагменты информации во внешней базе (документах, базе знаний, базе данных), а затем использует найденные данные для формирования ответа. Такой подход существенно улучшает качество и точность генерации, снижает «галлюцинации» и позволяет использовать модели на актуальных пользовательских данных.

TL;DR: Просто LLM не волшебная палочка. RAG даёт доступ к вашим данным в контуре (внутри вашей системы/хранилища) и резко снижает число «галлюцинаций».


1. Проблема “глюков”
Большие модели (GPT, Llama и тп) учатся на данных интернета до своей даты релиза и ничего не знают о ваших свежих документах, клиентах или багах в коде. Они уверенно отвечают даже тогда, когда информации нет — и часто просто выдумывают.

2. Идея RAG
— Разбиваем внутренние документы на маленькие фрагменты (*чанки*) по 200–400 токенов. Важно не рвать смысл: одна тема — в одном куске.
— Индексируем их двумя способами:
 🟢 Dense — смысловой эмбеддинг (поиск по смыслу, а не по словам)
 🟡 Sparse (BM25 или иные) — по ключевым словам: термины, коды, аббревиатуры
— При запросе ищем самые релевантные чанки по эмбеддингу и keywords, подтягиваем оригинальные документы и «скармливаем» найденное LLM в промпт.
— Модель в ответе опирается на ваши реальные данные, а не на старую память.

Результат — LLM «читает шпаргалку» прямо перед экзаменом!

3. Где это реально работает
- Orchestra Ai Assistant — видит ваши задачи, встречи, файлы и сообщения. Видит ваш контекст в вашем рабочем окружении
- GitHub Copilot Chat — вытягивает из репозитория контекст, объясняет падения тестов
- Notion AI — ищет по вашим страницам для итоговых сводок
- Боты-саппорта в SaaS и банках — работают на внутренних инструкциях, экономя время живых операторов

4. Что получает бизнес
— Было: Галлюцинаций ≈ 30%
  Стало с RAG: < 5% — всё опирается на ваши документы
— Было: Конфиденциальные данные нельзя сливать в OpenAI
  Стало: Модель и индексы можно держать локально
— Было: Модель не видит новые данные
  Стало: Залил новый PDF — бот через минуту «знает» о нём

💬 А где у вас LLM уже фантазировал вместо фактов?

Подписывайтесь
— дальше будет больше практики, псевдо кода и лайфхаков! И буду стараться пояснить за разные термины и абривеатуры.
  • 🏆 7
  • 🔥 2
  • 👍 1
Post #24 141
Системный ИИ в бизнесе: как работает на практике. Ничего нового не скажу, ради закрепелния усвоеного старого.

— Начинать стоит с простых задач, которые приносят реальную пользу и быстро проверяются

— Неважно, какая технология “на хайпе” — ключевое, чтобы она реально решала задачу, а не просто внедрялась ради внедрения.

— Человек остаётся в цепочке: ИИ-процесс всегда контролируется экспертом. Даже когда всё кажется автоматизированным, критические точки проходят через ручной контроль

— Самая сильная архитектура там, где человек и ИИ дополняют друг друга: автоматизация берёт рутину, эксперт подключается на сложных шагах. Экономия времени и качества

— Улучшения строятся через обратную связь: пользователи, аналитика, эксперты, реальные метрики. Всё идёт в единый цикл апдейтов и тестов

— Вся архитектура строится на структурированных данных компании — базы знаний, профили клиентов, внутренние системы. Эти данные регулярно обогащаются и индексируются для быстрого доступа.

— “AI-навыки” — небольшие пайплайны, которые легко тестировать и переключать. Каждый этап можно улучшать, подкидывать новые задачи и сценарии

— Гибкость архитектуры важнее “модного” решения: система готова к смене моделей, внедрению новых инструментов и миграции между поставщиками.

— Главная цель: минимизировать возможные ошибки ИИ и быстро их ловить, снижая любые риски для бизнеса

— Быстрые итерации: анализ, прототип, тесты, обратная связь, следующий раунд апдейтов
  • ❤ 1
  • 👍 1
Post #23 119
По следам прошлого поста

🤖 Что такое AGI и AI-суперинтеллект?

В мире искусственного интеллекта не случайно столько разговоров вокруг двух ключевых понятий: Artificial General Intelligence (AGI) и AI-суперинтеллект. Что это такое и почему это так важно для будущего технологий и общества.

What is the AGI?
- AGI — это уровень искусственного интеллекта, когда система способна понимать, учиться и решать задачи на уровне или лучше человека в любом интеллектуальном направлении. Если сегодняшние AI — это "узкоспециализированные" системы, которые делают конкретные задачи (например, играют в шахматы или распознают речь), то AGI — это универсальный интеллект.
- AGI умеет обобщать знания и применять их в новых областях.
- Он сможет распознавать контекст, учится на новых данных без постоянного программирования.
- AGI — это шаг к машинному разуму, где ИИ становится полнофункциональным помощником и творцом.

Почему AGI — это первая silver bullet?
- Возможность решать сложные проблемы из разных областей: медицина, наука, экономика, экология.
- Автоматизация ученых, инженеров и других специалистов на новом уровне.
- Качественный скачок в развитии технологий и инноваций.
- Потенциальное изменение глобальной экономической и социальной структуры.

AI-суперинтеллект — что дальше?
- Гипотетический уровень интеллекта, превосходящий лучших человеческих умов по всем направлениям.
- Такой интеллект сможет саморазвиваться быстрее любого человека.
- Потенциально может создавать научные открытия, технологии и выстраивать глобальные системы управления.

В целом возможны как невероятные плюхи, так и серьёзные риски, связанные с контролем и этикой. Привет скайнет и секс роботы с транспарантами на улицах.

Почему стоит следить за развитием?
Да как минимум это интересно а как максимум быть эффективным используя современные технологии.

Активно идет тренд по запуску мегазаводов таких как StarGate, которые создают мощнейшую инфраструктуру для приближения к AGI.

🤔 Что вы думаете об AGI? Насколько готовы мир и бизнес к AI-суперинтеллекту?

Подборка статей:
1 - Развитие искусственного интеллекта: что такое AGI и когда он появится (экспертные прогнозы, интервью с Альтманом, Герцель, Амодеи, Хассабисом)
2 - Какие проекты OpenAI представит в 2025 году, прогнозы по AGI от Альтмана
3 - Можно ли создать AGI уже в 2025-м, плюсы и риски, мнения экспертов
4 - AGI: умный ИИ или новый Скайнет? — концепция, влияние на рынок, шутки и реальность
5 - Будущее искусственного интеллекта — развитие AGI и перспективы суперинтеллекта, глубинные аналитические обзоры
6 - Artificial general intelligence — визитка и базовые сведения (Wikipedia)
7 - OpenAI планирует создать AGI и внедрить AI-агентов в 2025 году (о стратегии и планах OpenAI)
8 - Экспертные обзоры об этике, импакте и будущем AGI
  • ❤ 1
Post #22 96
Немного про бигтех

🚀 OpenAI запускает мегапроект "Stargate" — крупнейшую в мире AI-мегаплатформу за $500 млрд!

Что происходит?

OpenAI, при поддержке Oracle, Microsoft Azure, SoftBank, Nvidia и других топовых игроков, строит в Техасе гигантский дата-центр площадью 1 200 акров — эквивалент 485 футбольных полей.

Кстати на днях Orcale взяли контракт на 30Ярдов USD

Stargate — это 400 000 видеокарт Nvidia, специально для обучения моделей нового поколения и AI-экспериментов.

Это инфраструктурный проект-соревнование за лидерство в глобальной гонке AI: OpenAI напрямую конкурирует с Google, Meta, Amazon и xAI Маска.

Stargate — это не только про технологии. Ожидается мощный экономический эффект для региона: рабочие места, рост инвестиций и градообразующий эффект для Абилина, штат Техас.

Экологические вызовы: в центре внимание — потребление энергии, воды и охлаждение, однако команда OpenAI внедряет инновационные зеленые решения, чтобы снизить нагрузку.

Зачем это всё?

Такой масштаб нужен, чтобы выйти на новый уровень — построение искусственного общего интеллекта (AGI) и, возможно, AI-суперинтеллекта.

США с помощью Stargate хотят закрепить мировое лидерство в AI, снизить зависимость от отдельных поставщиков (например, Microsoft), и создать сотни тысяч новых рабочих мест.

Почему важно?

Это станет новым стандартом для AI-индустрии и ускорит развитие новых стартапов, технологий и исследований в AI, включая robotics, BioTech, и многое другое.

Передовой проект, за которым наблюдает весь мир: внимание медиа, инвесторов и даже правительств.

💡 Как CTO, не могу не отметить:

Такие инфраструктурные прорывы — это шикарные возможности для коллабораций, интеграций и запуска своих продуктов на глобальном уровне.

Вся цепочка поставщиков, оптимизации и масштабирования AI выходит на новый уровень — такие инфраструктурные гиганты как Stargate меняют всю архитектуру ИИ-рынка.
  • 🏆 1
Post #1
Channel created
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →