TGViewer
Channel Public Channel
altblog - трудовые будни

altblog - трудовые будни

@seopyt

Делюсь своими находками в SEO и всем что связано с NLP (обработка текста).

Бот для оценки траста домена в Google - @google_trust_checker_bot

iGeoLeak - база гео-ротации партнерских ссылок в iGaming - https://igeoleak.vercel.app/
Subscribers
301
Photos
33
Videos
4
Links
28
Recent Posts 17 shown
Post #72 106
Новая хайповая модель Jev, которая не пишет текст

Про Jev от TypeSafe в твиттере не написал только ленивый - за считанные дни ее прикрутили и к браузеру, и к
трейдинг-ботам. В 20-200 раз быстрее и в 40-400 раз дешевле обычной LLM - такими выводами делятся пользователи.

Текст она не генерирует вообще. Это классификатор. Отправляешь ей кусок текста и список вопросов - получаешь детерминированный json-ответ:
- да/нет с вероятностью
- выбор из фиксированного списка
- оценку по шкале

Ответ приходит почти моментально (за 200 мс), потому что модель долго не рассуждает, как это делают привычные LLM, стоит копейки ($0.042/M на вход и $0 за выход) и ответить вне заданных вариантов она физически не может - никаких галлюцинаций (привет Макс) и выдуманных селекторов (что важно при автоматизации в браузере).

Где может пригодиться:
- вычитка и аудит текстов («RTP 97% - правда?» не скажет; «в статье цифры совпадают?» - скажет)
- автоматизация браузера (выбрала правильный элемент из 55 вариантов на сайте меньше чем за секунду)
- оценка дропов

Воркфлоу не планирует. Результат работы будет настолько хорош, насколько хороши ваши вопросы.

Opensource

Уже появились опенсорс-альтернативы. Kev - дообучаемый, тренируется даже на MacBook. Jeff - self-hosted, но слабее (75.5% против 90.5%).

API у всех одинаковый - можно легко переключаться между оригинальной Jev, Kev и Jeff.

Попробовать: от провайдера только waitlist на typesafe.ai, либо через OpenRouter или Vercel. Локально - Kev или Jeff.
  • 👍 5
Post #71 428
😀 18.08.2026 - Google Spam Update: месяц спустя

Прошел месяц со злополучного апдейта - самое время посмотреть, какие категории запросов умерли, а какие выжили. Собрал статистику по сайтам за 4 недели до апдейта и сравнил с теми, что продолжают ранжироваться.

🔴 Выкосило под ноль:
- mirror/login (зеркала, вход) - 0% выживших
- brand_operator (навигация по бренду) - 3%

🟡 Держатся на треть:
- bonus/promo - 32%
- generic_casino - 33%

🟢 Выжили:
- demo/free - 41%
- game_slot (имена игр) - 48%
- app/download - 61%
- review/rating - 67%

Чем ближе запрос к деньгам пользователя, тем вероятнее выпил аффилейт-сайта из топа. Чем больше информационного интента - обзоры, рейтинги, демо - тем выше выживаемость.

Всем топа :)
  • 👍 12
Post #70 308
💰Разбор ссылочного бюджета 4 гемблинг-гигантов

Появилась идея сделать большой ревьюшник. Скачал бэклинки из Ahrefs по 4 сайтам - AskGamblers, Casino.Guru, VegasSlotsOnline и SlotCatalog - и нашел их доноров с ценами на биржах ссылок insert.link, PRnews.io и NeedMyLink.

📝 Сколько это стоит в месяц?

Это средний месячный бюджет за 2025 год.

Читается так: слева - подтвержденный бюджет с бирж, справа - он же плюс внебиржевые ссылки, чью цену оценила ML-модель.

🅰️ AskGamblers: $25K/мес → $76K/мес

✌️ VegasSlotsOnline: $23K/мес → $62K/мес

🇨🇦 Casino.Guru: $12K/мес → $53K/мес

🥴 SlotCatalog: $4K/мес → $29K/мес

Разные модели закупки. AskGamblers берет объемом, а Casino.Guru старается покупать более качественные ссылки и платит за каждый пункт DR примерно на 25% дороже остальных.

📝 Сколько всего потрачено?

Начнем с того, что можно проверить, сравнив цены на ссылки у доноров на биржах.

- AskGamblers: $826K (3036 доноров, 13% профиля)
- VegasSlotsOnline: $656K (2132 донора, 15% профиля)
- Casino.Guru: $433K (1237 доноров, 6,4% профиля)
- SlotCatalog: $109K (352 донора, 3,6% профиля)

Полная стоимость ссылочной массы с учетом внебиржевых (была использована модель оценки стоимости ссылки, которая была обучена на 42 тысячах доменов из бирж ссылок): $2,48 млн, $1,77 млн, $1,86 млн и $824K соответственно.

Средняя биржевая ссылка стоит ~$300 (медиана - $210), а 85% профиля составляют внебиржевые ссылки, которые стоят примерно $80.

📝 Что покупают все

- 102 донора из бирж встречаются у всех 4 сайтов одновременно. Бюджет на них - $34K.
- AskGamblers и VegasSlotsOnline делят 1 255 общих доноров. Бюджет на них - $336K.
- AskGamblers и SlotCatalog пересекаются на 72%. Бюджет на них - $79K.

Топ-5 самых дорогих среди общих доноров: wizardofvegas.com ($2 730), playtoday.co ($1 150), ibtimes.co.uk ($1 080), casinorus.se ($1 005), lakersnation.com ($780).

P.S. Передумал делать большой ревьюшник 🙄
  • ❤ 3
  • 😁 3
  • 👍 2
  • 😱 1
Post #69 484
Как сравнивать промпты и модели LLM перед запуском конвейера?

В прошлый раз разбирали как ловить плохую статью на выходе с помощью deepeval. Но можно ловить раньше: на самом промпте и модели, которой вы этот промпт скармливаете (спасибо, Кэп!). Инструмент для этого - бесплатный promptfoo (есть веб-версия на локалке и CLI).

Перечисляете промпты, модели и тесты с проверками, а promptfoo проверит их: каждый промпт * каждую модель * каждую проверку.

Проверки здесь двух видов, прям как в deepeval:
- Детерминированные: Проверяют, что в тексте есть нужное число, есть таблица и т.д. Это бесплатно.
- LLM-судья: Критерий пишется обычным текстом. Например: "верно ли передана механика?". Платим за токены.

С помощью promptfoo очень быстро можно протестировать новую модель, сравнив ее с другими.

📝 Лайв-тест

Я взял слот Gates of Olympus и собрал по нему: RTP, максимальный выигрыш, механика, множители, фриспины, ставки. И дал задание 14 моделям (OpenAI от gpt-4o-mini до gpt-5.6, плюс китайские Kimi-K3, GLM-5.2, Qwen3.8) написать обзор слота двумя промптами: по памяти и с фактами внутри промпта.

📝 Результаты по памяти

gpt-5.4-mini перепутал механику: назвал "Pay Anywhere / Cluster" вместо Scatter Pays. Насчитал 6 номиналов множителей вместо 15, заявил, что бонуса нет (есть).

➕gpt-5.6-sol выдумал номинал множителя 75x, которого в игре не существует, и hit frequency 27,27% (реальная 28,82%).

➕gpt-4o-mini перепутал вообще все выплаты за скаттеры (5x/100x/500x вместо 3x/5x/100x).

➕gpt-4.1-mini уверенно написал, что Ante Bet и Buy Feature "отсутствуют". Обе функции есть.

➕gpt-5.4-nano выдал сетку 5x4 вместо 6x5.

Ноль галлюцинаций у gpt-4o, gpt-5, gpt-5.2, Kimi-K3 и Qwen3.8 - они либо знают точные цифры, либо честно пишут "нет данных". Отдельно отмечу Kimi-K3: китайская модель знает слоты не хуже топового OpenAI (25 верных фактов, ноль галлюцинаций).

📝 Результаты с фактами

Промпт с фактами внутри - обнулил галлюцинации у всех 14 моделей. Ноль. Включая тех, кто по памяти путал механику.

📝 Вывод

Имея пару промптов и базу фактов, вы за полчаса получаете объективный, воспроизводимый рейтинг любых моделей по своей теме. Вышла новая модель - добавили строчку в конфиг, прогнали, увидели ее место в рейтинге.

Про LLM-судью: где нужна смысловая оценка, берите gpt-5-mini.

Сколько стоит? Весь эксперимент - 14 моделей, два прогона, сотни проверок - обошелся меньше чем в доллар.
  • 👍 7
Post #68 528
Контроль качества каждой статьи, а не только первой

Первую статью от нового промпта вычитывают все. А дальше конвейер: тексты выходят пачками, и остается только надеяться, что повезет и они окажутся не хуже. Если надежда - не ваш метод, этот пост для вас.

Знакомая ситуация: написали промпт, сгенерировали статью, прочитали, поправили, еще раз прочитали - отлично, запускаем. Дальше этим промптом генерятся еще тысячи текстов, которые уже никто не проверяет. А качество LLM плавает: где-то выдумала факты, где-то съела половину структуры.

Решение - тестировать тексты. Фреймворк называется deepeval (Codex или Claude поможет вам в установке и настройке): он гоняет каждую статью через набор тестов. Статья либо проходит, либо бракуется с указанием конкретной причины: "нет методологии оценки", "галлюцинация в фактах".

Как работает проверка

В deepeval два типа метрик.

Программатические: количество слов, один h1, повторы n-грамм, наличие дат, таблиц сравнения. Вы самостоятельно пишете код для проверки. Их может быть хоть 100 штук - это бесплатно. Настраивать можно вручную в браузере, через код, или дать задание вашему любимому ИИ.

G-Eval: LLM-судья, которому критерий проверки пишется обычным текстом. "Проверь, чтобы бонус был описан с реальными условиями: вейджер, минимальный депозит, срок отыгрыша".

Плюс встроенные: FaithfulnessMetric сверяет каждое утверждение с фактами из вашей БД (RTP, лицензии, платежки), есть еще HallucinationMetric и другие.

Калибровка на живых сайтах

Спойлер: пороги из головы не работают, их надо калибровать на реальных текстах.

Я прогнал свои тесты на статьях топовых сайтов и заведомый спам. Топы стабильно дают оценку ~0.76, спам ~0.46.

Максимальный разрыв между хорошим и плохим текстом:
- Попадание в интент запроса
- Переспам
- Таблица сравнения
- Числовой рейтинг с его обоснованием

Один вывод из калибровки, который сэкономит вам время:
В качестве судьи используйте gpt-4o-mini. Тестировал более свежую gpt-5.4-nano - в 4 раза медленнее и ставит либо 0.0, либо 0.9.


Сколько стоит? У меня выходит от $0.148 (меньше проверок) до $0.24 за статью (135 проверок).
  • 🔥 8
Post #67 454
SEOGets.com снова стал бесплатным (пока)

Монетизировать SEO-специалистов, особенно в эпоху вайб-кодинга, оказалось крайне непростой задачей. Даже если продукт рос вирусно, и его рекомендовали самые известные эксперты индустрии.

Обещать, что сервис всегда будет бесплатным, а потом внезапно закрыть все за paywall в $50 - не рабочая схема. ✍️
  • 👍 4
Post #66 550
Родной язык копирайтера определяется даже после DeepL - и ловится без нейросетей

Когда копирайтер прогоняет свой текст через DeepL или Google Translate, грамматика на выходе обычно чистая, но синтаксические привычки родного языка остаются. Я решил проверить, насколько легко это ловится, и натренировал простую модель с помощью Claude. Она угадывает исходный язык (русский, немецкий, итальянский и ещё 6) с точностью 72%. При этом Native English определяется почти идеально - 96%.

Никакого BERT, GPT и LLM. Просто TF-IDF + линейный SVM (вектора). Эта архитектура выиграла соревнование PAN-2017 по определению родного языка автора по его английскому тексту (ссылка на ресерч). Вся эта движуха называется Native Language Identification (NLI).

Мой обучающий корпус состоял всего из 600 пар по каждому языку "оригинал - английский перевод". И этого хватило!

Hi! Today I want to show you that it's actually quite easy to determine the original translation language. For example, if you wrote a text in...

Модель угадала, что это перевод с русского.
  • 👍 13
Post #64 742
Бот для оценки траста домена в Google

Запустил бота, который оценивает траст домена только на основе анализа выдачи Google. Без Ahrefs, Moz, Majestic и других внешних сервисов. И он отлично работает!

@google_trust_checker_bot

Бот делает 50+ запросов в Google и анализирует, как домен ранжируется:

— domain com
domain.com
— "domain.com"
— site:domain.com
— intitle, inurl, allinurl
— проверка по title, H1, H2, description
— и многое другое

Шкала оценки:

🟢 53+ — TOP (Wikipedia, Forbes, GitHub)
🟡 28–52 — MID (сильный сайт)
🔴 <28 — DROP (сайт с низким уровнем траста)

Пример

Автор сайта про Германию жалуется в Twitter, что Google AI Overviews убил его сайт. Но, возможно, дело не в Google AI, а в трасте сайта.

Его сайт:

🔴 allaboutberlin.com — 23.4 (DROP)

Его конкуренты в выдаче:

✅ TOP berlin.de — 67
🟡 MID iamexpat.de — 48
🟡 MID bzst.de — 47
🟡 MID settle-in-berlin.com — 40
🟡 MID germany-visa.org — 40
🟡 MID how-to-germany.com — 36
🟡 MID simplegermany.com — 35

Бесплатно

Для подписчиков этого канала - 3 бесплатных аудита любого домена. Плюс анализ еще 9 доменов из списка, чтобы можно было сравнить результаты работы бота со своей собственной оценкой.

@google_trust_checker_bot
  • 👍 4
  • 🔥 2
Post #63 494
Pangram: как устроен детектор ИИ-текста изнутри

Спойлер: Все проще, чем мы думали.

Pangram 3.3 построен на архитектуре EditLens, описанной в их собственном докладе на конференции ICLR 2026. Из него можно узнать, как именно работает детектор изнутри.

EditLens в свою очередь построен на основе Mistral Small - open source модели с 24 миллиардами параметров. Pangram взял готовую модель и дообучил ее под свою задачу через QLoRA (метод дообучения, при котором меняются не все параметры модели, а только небольшие надстройки - это дешевле и быстрее).

H2: Что они сделали?

1. Собрали 60 000 человеческих текстов из разных источников: обзоры с Amazon, посты с Reddit, образовательные статьи, новости.

2. Создали 303 различных промпта (список доступен на 18 странице доклада), которые люди реально дают ИИ. От "Исправь ошибки" до "Перепиши для SEO". Промпты разбиты по категориям:
- Тон и стиль: 84 промпта
- Добавление деталей: 59
- Сокращение: 32
- Плавность текста: 30
- Перефразирование: 26
- И другие

3. Прогнали каждый текст через три LLM (GPT-4.1, Claude Sonnet 4, Gemini 2.5 Flash) с каждым промптом. Получили пары: оригинальный текст - ИИ-отредактированный текст.

4. Для каждой пары посчитали косинусное расстояние. Чем сильнее ИИ изменил текст, тем больше расстояние.

Для эмбеддингов использовали модель Linq-Embed-Mistral на 7 миллиардов параметров с размерностью вектора 4096.

5. Обучили модель предсказывать, видя только финальный текст - без оригинала.

Весь датасет на 60 000+ примеров обошелся в $530. Обучение на 8 GPU A100 заняло 8 часов. Модели хватило одного прохода по данным (одна эпоха), чтобы научиться определять ИИ-текст.

H2: Open source

Pangram выложил все в открытый доступ на GitHub:
- Код для обучения и запуска предсказаний
- Датасет на HuggingFace
- Веса моделей

Но есть нюансы:
- В репозитории скрипты для RoBERTa-Large (355 млн параметров, запускается на обычном ноутбуке) и Llama-3.2-3B (нужно 16 GB RAM). А лучший результат в докладе показал Mistral Small 24B - скрипты для него не предоставлены.
- Лицензия только для некоммерческого использования
- Легкую версию (RoBERTa) можно запустить на обычном ноутбуке с 8 GB RAM. Для обучения Llama 3B нужен GPU с 24+ GB видеопамяти. Для Mistral 24B - мощный сервер.
  • 🤣 3
  • 👌 2
  • ❤ 1
Post #61 512
iGeoLeak - база гео-ротации партнерских ссылок в iGaming

Прогнал 219 мани-сайтов через резидентные прокси из 196 стран и собрал открытую базу, которая показывает, на какой бренд попадает юзер в зависимости от его гео.

Что внутри:
- 219 сайтов с гео-ротацией (без урлов)
- 297 брендов
- 196 стран - от US и DE до экзотики BD и KE
- фильтры по стране и бренду
- в разделе статистики реальные пары брендов в ротации по 196 странам.

В Tier-3 в два раза больше брендов в ротации по сравнению с Tier-1/2


Добро пожаловать на https://igeoleak.vercel.app/

Бесплатно, без регистрации. ❤️
  • 🔥 8
Post #59 4.35K
Как я пытался обойти проверку на ИИ-текст

Pangram - один из самых жестких ИИ-детекторов. Стояла задача: сделать так, чтобы он стабильно помечал тексты как написанные человеком, при этом контент должен быть качественным и точным.

Спойлер: большинство советов из интернета (писать проще, менять температуру, использовать хуманайзеры) - не работают.

В процессе борьбы с Pangram я просил Claude записывать все, что мы делаем и какие результаты получаем - набралось 4000 строк. Не без помощи ИИ я сжал это все до 1500 слов. На мой взгляд, получилось интересно.

Надеюсь, вы получите удовольствие от прочтения.

https://telegra.ph/Kak-ya-pytalsya-obojti-proverku-na-II-tekst-v-Pangram-04-21
  • 🔥 13
  • 👍 9
  • ❤ 2
Post #56 879
Может ли ИИ-текст ранжироваться в топ-10 Google?

Предисловие:
У Pangram (сервис для проверки текста на ИИ) есть API. За $10 можно сделать 200 проверок. Я его хорошенько погонял в попытках обойти (потратил 1000 запросов) - никакие промпты и никакие языковые модели (в том числе диффузионные модели) не проходят проверку как написанные человеком. Но об этом - в другой раз, когда мне хватит сил структурировать все мои попытки.

Поэтому результатам проверки можно доверять. Если каким-то чудом у кого-то из топа получилось пройти проверку, при этом сохранив качество текста - значит, там проделана колоссальная работа, повторить которую за один вечер или неделю, мучая Claude запросами "напиши так, чтобы прошло проверку Pangram", не получится. Различные комбинации нейронок тоже не помогут. Тем более на потоке.

А теперь суть:
Сделал веб-панель на основе выдачи Google от сервиса DataForSEO + Pangram API, чтобы проверить выдачу на ИИ-тексты. Результаты можно посмотреть на скриншотах.

Для некоторых сайтов можно увидеть количество слов - 950. Это намеренное ограничение, чтобы не отправлять на проверку тексты на несколько тысяч слов. 950 слов достаточно для качественной оценки.

Выводы делайте сами.
  • 👍 7
  • ❤ 5
Post #54 1.81K
Pangram - ИИ-детектор с точностью 99.98%

Сегодня поговорим о Pangram Labs - это ИИ-детектор, который активно набирает обороты и заявляет точность 99.98%. Уже сейчас у них 200 000 пользователей. Есть интеграция с Google Docs и есть Chrome-расширение.

Это не очередной клон GPTZero. Pangram основали в 2024 году в Бруклине двое выпускников Стэнфорда - бывший ML-инженер Google и бывший ML-ученый из Tesla. Они обучили собственную нейросеть на миллионе документов, причем скармливали ей специально подобранные, сложные примеры, где грань между человеком и ИИ минимальна. По их данным, сервис ошибочно помечает человеческий текст как ИИ только 1 раз из 10 000 проверок.

Заявляют, что детектят контент от всех основных моделей: ChatGPT, Claude, Gemini, Llama, Grok и других. Плюс есть поддержка 20+ языков.

Wiki Education уже внедрила Pangram для очистки Википедии от ИИ-контента.

Ценник:
- Бесплатно: 4 проверки в день
- Individual: 600 проверок в месяц за $20
- Professional: 3000 проверок в месяц за $65

Ограничение - 1000 слов за одну проверку. Документы длиннее 1000 слов тратят 1 кредит дополнительно на каждые 1000 слов.
  • ❤‍🔥 1
  • ❤ 1
  • 👍 1
Post #53 451
#пятница
  • 😁 3
Post #52 499
Насколько сильно отличается поиск Google и ИИ-поиск?

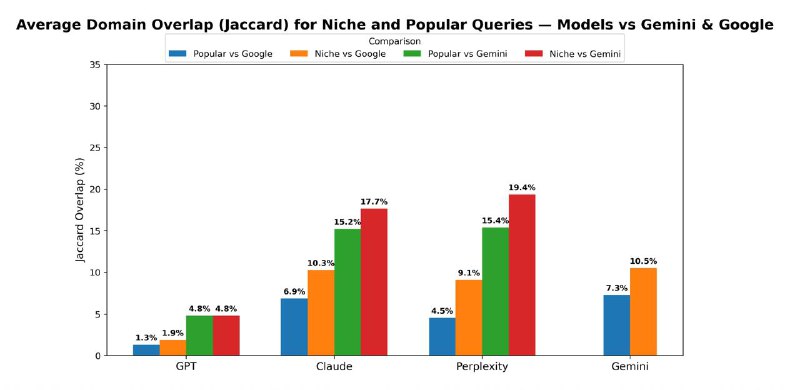
Исследователи из University of Toronto прогнали 1000 запросов через Google и ИИ-сервисы (GPT-4, Claude, Perplexity, Gemini) и сравнили, какие сайты они показывают. Запросы брали разные - от "лучшие SUV 2025" до нишевых типа "топ 10 семейных адвокатов Торонто" или "Garmin vs Coros для ультрамарафона".

Знаете, какое пересечение источников между Google и ИИ-сервисами?
- GPT-4o: всего 4% пересечения с Google
- Gemini: 11.1%
- Claude: 12.6%
- Perplexity: 15.2%

Google старается балансировать: 41% - это независимые СМИ типа TechRadar, CNET, Consumer Reports), 34% социальный сети, 26% сайты брендов.

А вот ИИ-чаты ранжируют по другому:
- Claude: 65% - независимые СМИ и всего 1% из соц.сетей
- GPT-4o: 57% - независимые СМИ
- Perplexity: 50% - независимые СМИ

Для транзакционных запросов ("купить iPhone 15") ИИ резко увеличивает упоминание сайтов брендов до 52-68%. Если тебя цитируют TechRadar, CNET или нишевые авторитеты - ты в ИИ-выдаче. Нет упоминаний - нет трафика.

Свежесть контента

Медианный возраст источников:

Бытовая техника:
- Claude: 62 дня
- GPT-4: 80 дней
- Perplexity: 90 дней
- Google: 130 дней

Авто:
- Claude: 148 дней
- GPT-4: 162 дня
- Google: 493 дня

ИИ показывает контент в 2-4 раза свежее. Если ваш сайт не обновлялся полгода - дела плохи.

Популярные и нишевые запросы

Вот тут начинается самое интересное.
Популярные запросы (SUV, iPhone):
- ИИ опирается на то, что выучил при обучении
- 16% сущностей появляются без цитирования вообще - модель "знает" ответ
- Toyota и Honda цитируются в 94-97% случаев, Cadillac и Infiniti - только в 27-42%
- Порядок источников* почти не влияет на результат (Kendall = 0.911)

*Исследователи перемешивали порядок сниппетов, которые подавали в ИИ, и смотрели - изменится ли итоговый ответ или нет.

Для популярных запросов (Kendall = 0.911):
Подали сниппеты в порядке A, B, C, D - ИИ выдал рейтинг: Toyota #1, Honda #2
Перемешали на D, B, A, C - ИИ все равно выдал: Toyota #1, Honda #2.

ИИ уже "знает" из предобучения, что Toyota и Honda - топовые бренды. Ему почти не нужны внешние источники.

Для популярных ниш - главное попасть в контекстное окно. Позиция менее критична.

Для нишевых запросов (Kendall = 0.556):
Подали сниппеты: Адвокат Смит первый - ИИ ответил: Смит #1
Перемешали: Адвокат Джонс первый - ИИ ответил: Джонс #1
ИИ не знает адвокатов Торонто. Он полностью зависит от того, что ему дали, и в каком порядке.

Для нишевых запросов позиция в выдаче критична. ИИ буквально берет первые результаты и строит ответ на них. Для транзакционных интентов ИИ активно тащит официальные сайты брендов.
  • 👍 5
Post #51 410
Галлюцинации в RAG

"Лучшие промты" - не помогают, т.к. галлюцинации - это архитектурная проблема.

"Чем больше документов занесу в RAG, тем более умной она станет" - это заблуждение. После 5–7 источников количество ошибок растет, а не падает, т.к. модель начинает склеивать несовместимое.


На сайте Стэнфордского университет было опубликовано исследование ИИ-сервисов (которые утверждали, что в них нет галлюцинаций) для юридических исследований (юридические RAG). Это платные сервисы которые стоят от 128 до 900 долларов в месяц (Lexis+ AI, Westlaw AI-Assisted Research, Ask Practical Law AI) и был еще обычный GPT-4 без специализированных юридических данных.

Цель исследования - выяснить как часто появляются галлюцинации в специализированных юридических ИИ-помощниках. Оценка проводилась по 200 юридическим запросам.

Результат

Коммерческие AI-инструменты для юридических исследований все ещё генерируют галлюцинации в 17-33% случаев, несмотря на использование RAG.

- Lexis+ AI - галлюцинации 17%
- Westlaw AI-AR: точность 42%, галлюцинации 33%
- Ask Practical Law AI: точность 19%, отказался отвечать в 62%
- GPT-4 (для сравнения): галюцинации в районе 40%

Типичные ошибки систем

- Путают решение суда с аргументами адвокатов
- Цитируют отмененные прецеденты как действующие или ссылаются на документ, который не подтверждает утверждение
- Не различают иерархию судов (например, могут сказать, что суд штата отменил решение Верховного суда США)
- Генерируют несуществующие параграфы законов

Выводы

- RAG действительно снижает галлюцинации по сравнению с базовыми LLM, но не устраняет их
- Более длинные ответы содержат больше галлюцинаций
- Системы плохо справляются с вопросами, требующими знания юрисдикции и временного контекста
- Нельзя доверять AI-системам без проверки
- Каждую цитату и утверждение нужно верифицировать вручную

Исследователи также дали рекомендации по уменьшению галлюцинаций в RAG.
Post #50 10.9K
🏆 Топ-10 SEO-каналов в 2025 году

2025 год подходит к концу, и самое время опубликовать рейтинг SEO-каналов в Telegram.

С помощью Fomogram (агрегатор постов из SEO-каналов) я посчитал количество пересылок постов в 100 SEO-каналах за весь 2025 год.

Топ-10 каналов:

1. iGamingNews (44.4К пересылок)
2. Mike Blazer (44.2К пересылок)
3. R2B.News (31.7К пересылок)
4. DrMax SEO (16.8К пересылок)
5. PMP Media (15К пересылок)
6. Михаил Шакин (14.8К пересылок)
7. Артем Бородатюк (14.7К пересылок)
8. Англоязычное SEO (12.9К пересылок)
9. iGaming CEO (12.5К пересылок)
10. Oleg Shestakov (11.8К пересылок)

Посмотреть весь топ-30 и самые виральные посты каждого канала можно здесь.
Older posts →

About this channel

How can I read @seopyt without a Telegram account?
TGViewer shows the public web preview Telegram publishes for altblog - трудовые будни: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does altblog - трудовые будни have?
altblog - трудовые будни (@seopyt) has 301 subscribers on Telegram, refreshed roughly every 30 minutes.
Does altblog - трудовые будни know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →