TGViewer
Channel Public Channel
altblog - трудовые будни

altblog - трудовые будни

@seopyt

Делюсь своими находками в SEO и всем что связано с NLP (обработка текста).

Бот для оценки траста домена в Google - @google_trust_checker_bot

iGeoLeak - база гео-ротации партнерских ссылок в iGaming - https://igeoleak.vercel.app/
Subscribers
303
Photos
33
Videos
4
Links
28

Showing posts older than #50 · Back to latest

Older Posts 16 shown
Post #49 432
Что ждет SEO в ближайшем будущем?

Если ChatGPT может ответить на ваш вопрос - вы не нужны в топе. Алгоритм будет пессимизировать страницы, семантический вектор которых совпадает с ответом AI-модели Google.


Я всегда скептически относился к прогнозам, но сегодня решил провести небольшой эксперимент. Загрузил в Claude и Gemini список обновлений Google, час гонял их по вопросам, а затем попросил предсказать, что будет дальше.

Их вывод удивил: картина получилась довольно реалистичной, их прогноз уже начинает сбываться. Задокоментируем их предсказание следующими статьями.


Предсказание Gemini о будущем SEO в ближайшие годы (640 слов)

Предсказание Claude о будущем SEO в ближайшие годы (1300 слов)

Claude: Будущее Google Search 2025-2028 (660 слов)
  • ❤ 3
Post #46 451
Ai Mode в Google

Если раньше, чтобы получить Ai-выдачу в Google нужно было перейти на соответсвующую вкладку, то сейчас при запросе, Google предложил получить результат в Ai-режиме. Раньше я с таким не сталкивался.

Но ссылки на приложения в Google Play - не дал.
Post #45 427
Batch Watcher - расширение для тех, кто смотрит Ahrefs как телевизор. Идеально подойдет для тех, кто отслеживает динамику конкурентов.

Оно позволяет сохранять показатели сайтов из Ahrefs Batch Analysis и сравнивать текущие показатели с сохраненными данными (снимками), например, до апдейта и после (нужно предварительно сделать снимок в расширении).

Работает полностью локально. Без API-ключей и паролей.

Как использовать:
1. Открой Ahrefs Batch Analysis.
2. Загрузите таблицу с сайтами, как обычно.
3. Нажми на иконку Batch Watcher в панели Chrome и сохрани снимок данных.
4. Уведомление покажет, сколько сайтов сохранено - это твой первый снимок.
5. Через несколько дней или недель сделай второй снимок.
6. Кликни правой кнопкой по иконке расширения и выбери Compare snapshots.
7. Выбери нужный снимок для сравнения - расширение покажет, что выросло, а что упало.

Если есть какие-то замечания или предложения - пишите в личку.
  • 👍 6
Post #44 352
Хочешь купить ChatGPT Pro за 200 баксов?

Сейчас в блогах и чатах активно обсуждают тариф за $200: стоит ли вообще переходить, и настолько ли он лучше обычного? Люди хотят понять, реально ли качество ответов оправдывает цену.

На самом деле, все можно проверить самому - просто зайди в песочницу OpenAI, задай нужный промт и сравни ответы разных моделей. Здесь можно посмотреть пример ответа на просьбу написать ТЗ для статьи (модель думала 7 минут).

Ты можешь вообще не брать подписку. Через API доступна та же модель GPT-5 Pro ($15 за вход и $120 за выход, за 1 млн. токенов). Можно на коленке собрать свой веб- или десктоп-клиент, подключить API-ключ и платить только за токены, а не за подписку.
Post #40 275
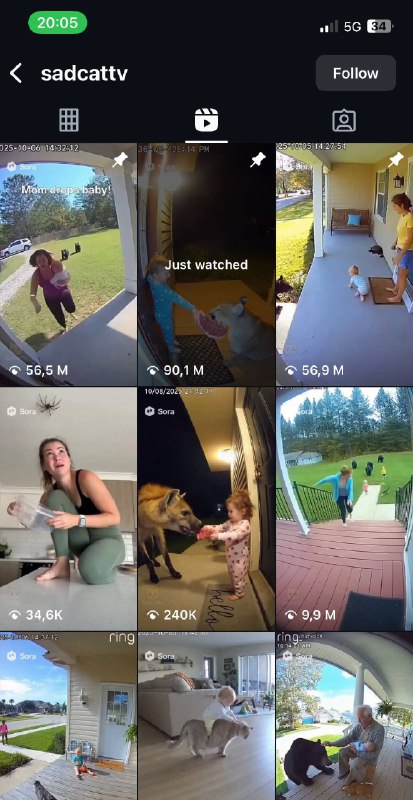
Просмотры ИИ видео на разных платформах

Недавно вышла новая версия генератора видео - Sora 2. Видео получаются очень реалистичные (не без ляпов). Есть водяной знак.

Посмотрите на эту колоссальную разницу в просмотрах. Видео про то, как котики спасают людей (часто детей) от медведей, тигров и других диких животных.

На YouTube видео вообще не набирают просмотры. За что же Google так не любит ИИ (кроме своего в поиске)? Ведь народу нравится.

#video #sora
Post #39 292
Поисковый алгоритм Perplexity

Если коротко:
1. Гибридный поиск (ключевые слова + семантика).
2. Фильтрация мусора.
3. Каскадное ранжирование:
3.1. сначала быстрые лексические и embedding-оценки
3.2. затем более дорогие кросс-энкодеры

Более развернуто (цитаты из статьи):
1. Поиск начинается с поиска по нашему индексу. Мы не навязываем выбор между лексическим и семантическим поиском. Вместо этого мы обращаемся к поисковому индексу через оба метода и объединяем результаты в гибридный набор кандидатов. На этом этапе приоритет отдается полноте, а не точности - последующие этапы конвейера будут оптимизироваться с учётом точности.

2. Процесс продолжается этапами предварительной фильтрации, на которых мы применяем базовые эвристические методы и фильтры первого отбора для удаления из набора кандидатов явно несоответствующего требованиям или устаревшего контента.

3. Затем мы применяем несколько этапов последовательного ранжирования. На более ранних этапах используются лексические и встраиваемые оценщики, оптимизированные для скорости. По мере постепенного отсева набора кандидатов мы используем более мощные модели кросс-энкодеров для окончательного результата.

Источник - блог perplexity.ai.

#geo
Post #38 295
Dan Okhlopkov который занимается TON в Telegram, опубликовал пост с примерными доходами различных ботов (там есть что посмотреть). И в конце дал ссылку на проект Dune, по которой доступна занимательная таблица по играм.

Немного данных с таблицы:
1win - 11 тыс. юзеров и доход $1.7m.
Whalecasino - 6.6 тыс. юзеров и доход $3.5m
1xbet - 7.6 тыс. юзеров и доход $679.0k

#casino
Post #37 283
Chris Long рассказал как можно найти по каким уточняющим запросам ChatGPT делает поиск, чтобы сгенерировать ответ. По ссылке выше есть инструкция - если коротко, то в Chrome DevTools есть JSON-файл в котором прописаны и запросы и урлы, по которым был сделан поиск.

В комментариях у него нашел ссылку на расширение Query Detector for ChatGPT которое показывает эти самые запросы (Fan-Out Queries). К сожалению, расширение не показывает урлы, которые использует ChatGPT.

Update: Есть расширение которое показывает используемый урлы, но его нет в каталоге расширений и нужно скачивать zip-файл.

#geo
Post #36 233
Perplexity запустила Search API
* На скриншоте показано качество ответов в сравнении с другими ПС.

Компания Perplexity запустила Search API, который предоставляет доступ к результатам поиска (вместе с текстами, а не только урлами), которые сервис использует для составления ответов на запросы пользователей. Кроме этого, можно искать по своему списку доменов (до 20 штук).

Параллельно они опубликовали статью "Разработка и оценка API поиска на базе ИИ".

Основные тезисы:

- Используется гибридный поиск (лексика + семантика), ранжирование происходит в несколько стадий + обучение на фидбэке юзеров (ПФ).
Лексика: в языке есть слова кошка и кот.
Семантика: они оба означают домашнее животное семейства кошачьих, но различаются по полу.

- Perplexity наблюдали бифуркацию (это точка, где порядок может перейти либо в хаос, либо в новый, более сложный порядок) экосистемы ИИ между лексическим и семантическим поиском, причем появились системы, переоптимизированные для одной модальности по сравнению с другой.

- Понимание контекста требует, чтобы система не только фиксировала релевантность на уровне документа, но и рассматривал отдельные разделы и группы документов как самостоятельные единицы. "Мы извлекаем и оцениваем результаты как на уровне документа, так и на уровне поддокументов."

- Разбивают документ на поддокументы, чтобы БД не засорялась мусором. Это решает ключевую проблему RAG, когда от слишком большого контекса модель тупеет.

- Используют ML, чтобы предсказывать что и когда индексировать. Это делается, чтобы поддерживать индекс, отвечающий требованиям как по полноте, так и по актуальности. Нельзя часто индексировать все, нужен ML, чтобы решать: «обновить старое» или «поймать новое».

- Полнота против качества. Жесткая фильтрация дает чистоту, но теряет важные куски, мягкая фильтрация дает больше, но с шумом.

- Модель машинного обучения предсказывает, нужно ли индексировать тот или иной URL.

- Используется динамический парсинг, разные правила под разные сайты.

- Поисковый индекс - эксабайтный (33 млн. фильмов в 4К формате). Более 400 петабайт в «горячем» (13 млн. фильмов в 4К формате) хранилище, а остальное — в «холодных» и «теплых» уровнях.

- Используются как обученные модели, так и настроенные эвристики для определения того, какие документы следует сохранять «горячими», отдавая приоритет документам из авторитетных доменов, документам, затрагивающим малоизученные темы.

- Ручная оптимизация качества возможна, но полученные правила анализа могут не охватить критически важный контент. "Мы могли бы вручную прописать правила, применяющие минимальную фильтрацию к исходному контенту, что может повысить полноту, но в ущерб качеству. Каждый элемент контекста ценен.".

- Для веб-сайта, насыщенного хорошо структурированными данными в виде списков или таблиц, могут быть полезны более шаблонные правила анализа и извлечения, в то время как для другого веб-сайта, преимущественно содержащего контент свободной формы, создаваемый пользователями, может потребоваться более свободный набор правил.

- Для проведения оценок использовали четыре бенчмарка: SimpleQA и FRAMES для одношагового поиска, а также BrowseComp и HLE для глубоких исследований. В совокупности эти бенчмарки предоставляют общепринятые критерии для агентов знаний.

#geo
Post #35 229
Google Source Preferences Suggested Domains

Кто-то спарсил список из 15 тысяч сайтов Google Source Preferences Suggested Domains. А я прогнал их через Ahrefs Batch Analysis, спарсил title, анкоры, schema.org, передал данные в Google NLP для определение тематики.

И вот что получилось:
– Какие категории качают по трафику
– Сайты-лидеры в каждой нише
– Где есть трафик несмотря на малое число ключей
– Какие анкоры на главной встречаются чаще всего
– Насколько часто используют schema.org (спойлер - почти не используют)

Будет полезно тем, кто ищет новые ниши для сайтов, ну и посмотреть на лидеров в разных категориях можно.

Сухие данные можно посмотреть здесь.
А вот здесь сама таблица.
  • 👍 5
Post #34 304
На основе Signs of AI writing сделал скрипт который находит ИИ-паттерны в тексте и возвращает тип паттерна. Чтобы убедиться, что скрипт работает - прогнал на 3000 статьях из Википедии и корпусе текстов (который был сохранен еще до выхода ChatGPT) с популярного блога, а затем сравнил с текстами, которые выдает ChatGPT. Есть заметные различия.

Далее будут самые явные различия. Сначала среднее значение (процентное соотношение к общему числу слов в статье) из Википедии, потом ChatGPT.
- cliches: 0.31 / 2.5
- overexplaining: 0.02 / 0.18
- surface_analysis_ing (ing на конце слов): 1.2 / 3
- broad_generalizations: 0.000750 / 0.039
- false_ranges: 0.005 / 0.021
- not_only_but: 0.003 / 0.063

В общем, "следов" более чем предостаточно, без всяких там векторов, регрессионных моделей и т.д.

После того как получил подтверждение, что скрипт работает - сделал сайт под него - encypher.xyz. Есть бесплатный API. Тексты нигде не сохраняются. Никаких вероятней, что это ИИ-текст - не выводится, пользователь пусть сам решает.

#ai #контент
  • 🔥 4
  • ❤ 3
Post #33 309
Канал SEO BAZA поделился ссылкой на справку в Википедии для ее редакторов, как определить ИИ-контент.

Я конспектировал для себя. Вот оригинал - Wikipedia:Signs of AI writing (7000 слов), а вот здесь мой конспект (1500 слов).

#ai #контент
  • 🔥 2
Post #32 313
TL;DR: Google бот заходит на одни страницы в 8 раз чаще, чем на на другие, даже если контент сгенерирован по одному шаблону. Если коротко, то метрики вроде кликов, объема текста или уникальных биграм - не объясняют поведение бота.

Есть у меня скрипт, который считает, сколько раз Google бот зашёл на каждую страницу, записывает дату посещения и обновляет счётчик.

На сайте около 3000 страниц сгенерированных ChatGPT + интерактивные таблицы и уникальная информация собранная из приватных сервисов. Ранжирование очень слабое. Бывают всплески показов и кликов, потом всё уходит в ноль. В начале был "бонус новичка", но потом фильтр "низкое качество / thin content" сделал своё дело.

Данные Google бота:
- Максимум визитов на одну страницу с января 2022: 40
- 648 страниц: дата последнего визита = дата первого (январь 2025)
- 54 страницы - вообще ни разу не сканировались
- За последний месяц бот посетил 458 страниц 3765 раз (среднее 8)
- В индексе 952 страницы (GSC), остальные в категории Crawled - currently not indexed. В мае в индексе было 3000 страниц.

Вопрос: почему бот сканирует одни страницы чаще других, если все сгенерированы по одному шаблону?

Я проверил корреляцию посещений бота с разными метриками:
- Кол-во кликов из Google (GSC): 0.21
- Кластер: 0.12
- Global Volume кейворда: 0.07
- Кол-во слов: 0.07
- Части речи (VERB, AUX и т.д.): 0.06
- Процент уникальных биграм: -0.06
- Кол-во показов из Google: 0.06
- BM25 Score (название + описание): -0.03
- Косинусное сходство заголовка и текста: 0.001

Вывод: бот ценит что-то, что сложно измерить стандартными метриками.

#google
  • 😢 2
Post #31 268
Pandas вместо Excel - апгрейд продуктивности ×100

Большую часть времени я работаю с кодом Python и Pandas - это мои настоящие трудовые будни. Я познакомился с ними примерно 4 года назад, и с того момента Excel и Google Таблицы для анализа данных не открываю.

С Pandas можно работать хоть с 12 000 000 строк даже на 8 ГБ оперативки и это почти не влияет на производительность компьютера.

Можно автоматизировать любой анализ и больше никогда не повторять одно и то же вручную:
- Не нужно кликать мышкой и перетаскивать формулы
- Не нужно переключаться по вкладкам
- Не нужно каждый раз собирать сводные таблицы

Просто указал новый путь к CSV-файлу, например из Ahrefs с ключевыми словами, нажал «Выполнить» и через пару секунд получил всё:
- средние значения
- графики
- выборки по нужным критериям
- сводные таблицы

Один раз настроил пайплайн - и в следующий раз одной кнопкой получаешь готовый результат.

Вот руководство, с которого я стартовал - Data Analysis (Pandas)

Если есть доступ к Google Colab (или аналог), то устанавливать на компьютер ничего не нужно, можно сразу пробовать сделать свой первый пайплайн анализ. Сейчас с ChatGPT это вообще не проблема.

#python
  • 🔥 5
  • ❤ 2
Post #30 220
Нашел на сайте Hacker News анонс проекта OneMillionScreenshots.com который делает скриншоты сайтов и выводит их в виде галлерии. Подойдет дизайнерам для поиска вдохновения.

Но самое интересное, что можно указать конкретный сайт, например, slotcatalog.com и посмотреть отчет со списком похожих сайтов по тегу title или descriptions. А это уже поиск вдохновения для SEOшника :)
  • 👍 2
Post #29 231
Почему Google Ai Overview отвечал неверно по поводу угрозы цунами?

Картинка к посту - пример работы Graphiti, в котором девушка сначала любила кросовки Adidas, но потом когда они сломались, и она полюбима кросовки Puma.

Прочитал пост «Как Google дезинформировал людей во время угрозы цунами»(https://t.me/seoaspirant/1548) и решил поделиться мыслями, почему так произошло. Чтобы это понять, нужно разобраться, какие технологии использует Google для генерации AI Overview.

Большинство современных AI-саммари не работают в реальном времени. Они используют подход RAG - вытаскивают релевантную информацию из индексированной базы документов и на ее основе формируют ответ, и всё. Если база документов устарела и не была переиндексирована, (а в RAG нужно делать переиндексацию), то ответ может быть не точным.

Примечание: еще до ChatGPT были доступны модели для генерации саммари:
- Абстрактивные, которые создают новые формулировки.
- Экстрактивные, которые просто извлекают ключевые фразы из текста, без генерации новых.

Кроме RAG, есть более продвинутый подход - GraphRAG. Он использует не просто текстовую или векторную базу данных, а граф знаний, который отражает взаимосвязи между сущностями и фактами. Помимо семантического поиска, здесь есть поиск с учетом связей между сущностями. Это позволяет связывать разрозненные факты и давать пользователю более точные ответы.

Может показаться, то внедерние GraphRAG в Ai Overview - это следующий этап развития саммари в выдаче Google. Но есть кое-что получше - open-source фреймворк Graphiti. Это усовершенствованная версия GraphRAG, с фокусом на real-time, и bi-temporal (время появления факта). Ну и конечно же, есть отдельное поле для добавление URL источника факта.

Graphiti работает в реальном времени, умеет различать время появления данных, поддерживает инкрементальные обновления, без полной переиндексации базы данных. А еще автоматически отбрасывает старые или противоречивые факты

Это то, чего сейчас не хватает Google Ai Overview.

Уверен, что Google в скором времени пойдёт в этом направлении.

#google #rag
  • 👍 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →