TGViewer
Channel Public Channel
Mike Blazer

Mike Blazer

@mikeblazerx

Все прелести SEO:

— результаты экспериментов
— секреты продвижения
— свежие идеи
— SEO-фишки
— кейсы
— топы без ссылок

Платный PRO-канал: https://t.me/MikeBlazerX/5841
...

Автор: @MikeBlazer
Рекламу не продаю!
Subscribers
8.92K
Photos
2K
Videos
267
Links
5.9K
Recent Posts 20 shown
Post #6705 456
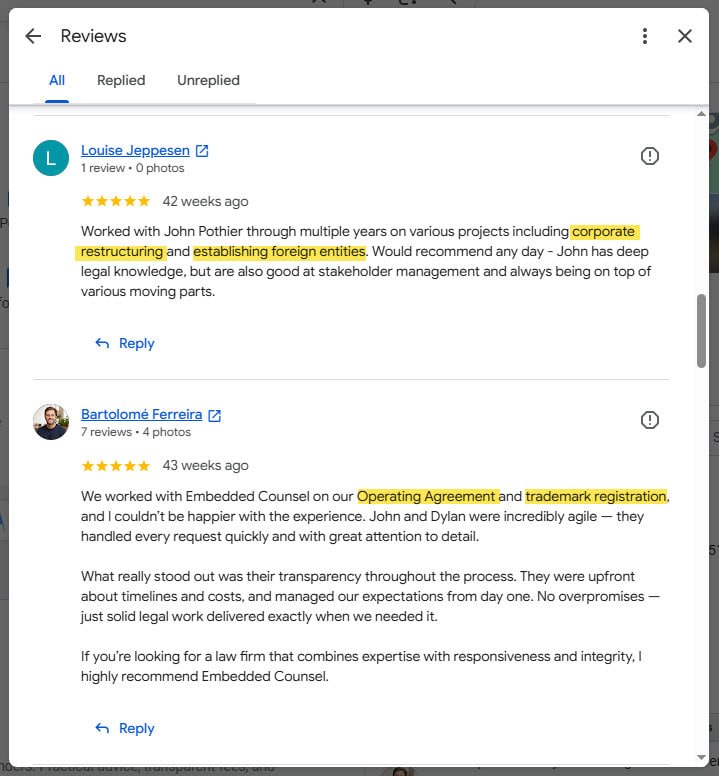
Отфильтрованные отзывы: живая ссылка в уведомлении дает прямой доступ к скрытому тексту

Классика списывает отфильтрованный отзыв как мертвый актив: клиент его написал, Google или Yelp его закопали, а Google даже не присылает бизнесу алерт о фильтрации.

Только сам автор все еще видит текст.

Сам отзыв остается целым.

Уведомление от Google содержит ссылку — она открывает этот отзыв для кого угодно, независимо от фильтра.

Этот же отзыв можно поднять в панели Google Business Profile.

Если закинуть текст на сайт и прикрутить эту ссылку, скрытый отзыв трансформируется в верифицируемое социальное доказательство — пруф для лидов, которые считают отзывы на сайте фейком.

Фильтрация — это не приговор.

Отзывы могут вылезти из-под фильтра позже, часто вообще без участия бизнеса.

Триггер фильтрации может сидеть в самом процессе сбора.

Главные подозреваемые — избыточный контроль за сбором:

— инструкции для юзеров, что именно писать
— перенаправление на конкретное устройство или приложение
— отправка прямых ссылок на отзыв
— прогон запросов через ORM-софт

Эта причинная связь не протестирована, но фикс пейсинга конкретный: просить об отзыве одного клиента в день на протяжении 30 дней, а не 30 клиентов за одни выходные.

Текст отфильтрованного отзыва все равно сохраняет ключи от людей, которые реально заплатили за услугу — включая термины, которые бизнес игнорировал или вообще не встречал.

Фотографии из отзыва можно запросить у автора напрямую, а затем оптимизировать и залить на сайт.

Автора также можно перетянуть на платформу с пустым профилем — BBB, HealthGrades, Avvo.

А клиенты, которые оставили ревью в Google Maps и имеют хотя бы пару отзывов в Yelp, с наибольшей вероятностью отпишутся и в Yelp.

Отзыв, улетевший в фильтр на старте, открывает окно для реакции: скрытый негатив дает несколько дней на то, чтобы выбрать между публичным ответом или прямым контактом с клиентом, пока текст не всплыл.

BBB сносит отзывы каждые 2-3 года и, судя по всему, вообще не использует фильтры.

Поэтому каждый стоящий отзыв нужно копировать и сохранять в момент захвата.

https://www.localvisibilitysystem.com/2026/08/31/how-can-filtered-reviews-help-your-local-seo-and-marketing/

#LocalSEO #Reviews #ORM

@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
  • ❤ 1
Post #6704 591
Карты сущностей на базе Search Console вскрывают разрыв между восприятием алгоритмов и тем, кем вы себя считаете

Поисковые и ИИ-системы собирают бренд из фрагментированных сигналов по всему вебу.

Когда эти данные противоречат друг другу, алгоритмам сложнее их интерпретировать и связывать.

Порог входа изменился: Kalicube сообщает, что во время крупного апдейта в июне 2025 года из Графа Знаний Google вылетело более трех миллиардов сущностей.

Эту чистку считывают как шаг к большей ясности и снижению двусмысленности.

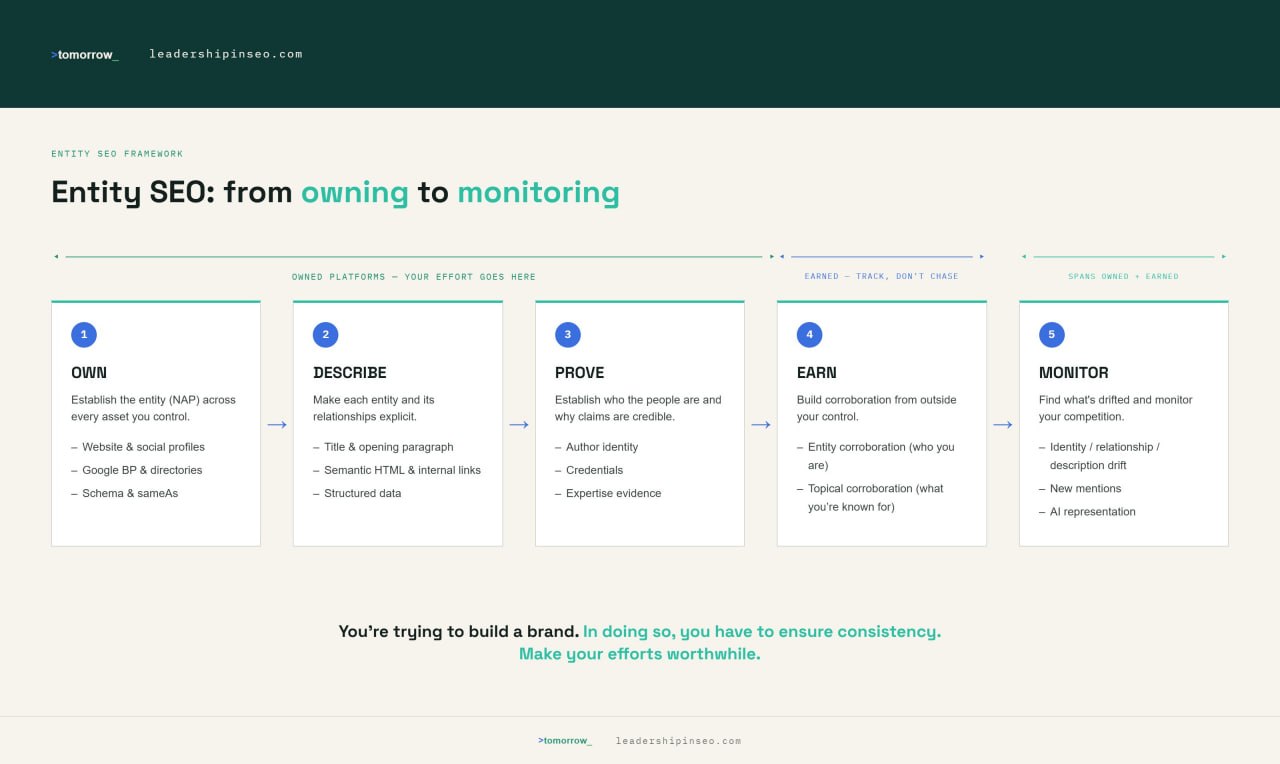
Аудит делится на пять этапов — Own, Describe, Prove, Earn и Monitor — причем редактировать можно только первые три.

Почти всё доступное время стоит тратить именно на эту контролируемую зону, а не на конвертацию старых упоминаний в бэклинки (хотя сама по себе такая гигиена вряд ли даст резкий рост).

Согласованность критически важна для менее устоявшихся брендов: BBC и NYT никогда не парятся из-за опечаток в названии.

Диагностический вес кроется внутри этапа Earn.

Подтверждение сущности отвечает на вопрос, кто вы: точные упоминания бренда, последовательные описания на сторонних ресурсах, корректные профили в директориях и ассоциациях.

Тематическое подтверждение отвечает на вопрос, чем вы известны: экспертные комментарии, интервью, цитации, авторские колонки, которые стабильно связывают вас с заявленными темами.

Называть себя главным экспертом по Bitcoin, когда весь остальной мир видит повара из Солихалла — это провал тематического подтверждения, и вы плывете против течения.

Идентичность также деградирует сама по себе.

Упоминания устаревают, сотрудники уходят без обновления корпоративного сайта, сторонние площадки продолжают описывать старую версию.

В совокупности эти проблемы с идентичностью, описанием и связями формируют дрейф сущностей — базовый концепт алгоритма GEO.

Двусмысленность нужно не просто предотвращать; её нужно вычищать.

Артефактом становится карта сущностей, которую можно собрать исключительно на базе запросов и постраничных данных из Search Console:

1. Определи первичную сущность для маппинга.
2. Выяви связанные сущности — людей, продукты, услуги, локации, темы, организации, мероприятия.
3. Разметь связи — основатель, сотрудник, находится в, специализируется на, пишет о, производит, владеет.
4. Прикрепи идентификаторы и доказательства — официальные урлы, профили LinkedIn, ID из Wikidata, страницы авторов.

Отфильтруй данные Search Console по странам и собирай по одной карте на каждую.

Восприятие дробится по локациям, и редко так, как ожидают специалисты.

На объемах извлечение берет на себя NER (Named Entity Recognition): прогоняешь 50k строк запросов из GSC через модель для классификации сущностей на людей, места и организации.

Либо прогоняешь страницы через краулер, вытаскиваешь h1, мета-дескрипшен и первые символы, а затем устраняешь неоднозначность по окружающему тексту.

https://www.leadershipinseo.com/p/entities-are-the-foundation-of-modern

#EntitySEO #GSC #SemanticSEO

@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Post #6703 759
Патент Google Visual Citations раскрывает механику: совпадение по картинке перевешивает текст при выборе источника

Патент, поданный в 2023 году и опубликованный в апреле 2026-го, описывает флоу генерации ответа.

Алгоритм сначала выбирает источник по совпадению картинки, а уже потом подтягивает окружающий текст для формирования ответа.

Это лишь заявка, а не подтвержденная механика в проде.

Google регистрирует их тысячами, и многие никогда не выходят в прод в описанном виде.

Если рассматривать это как вектор развития, а не как факт, патент переворачивает все правила, на которых строилось image SEO.

Картинка решает, какая страница попадет в ответ, а текст рядом с этой картинкой решает, что именно скажет ответ.

Операционное следствие — это плейсмент.

Факт, нужный покупателю, должен висеть прямо под картинкой в виде подписи или тега, а не в трех скроллах ниже по странице.

Распознавание не гарантировано.

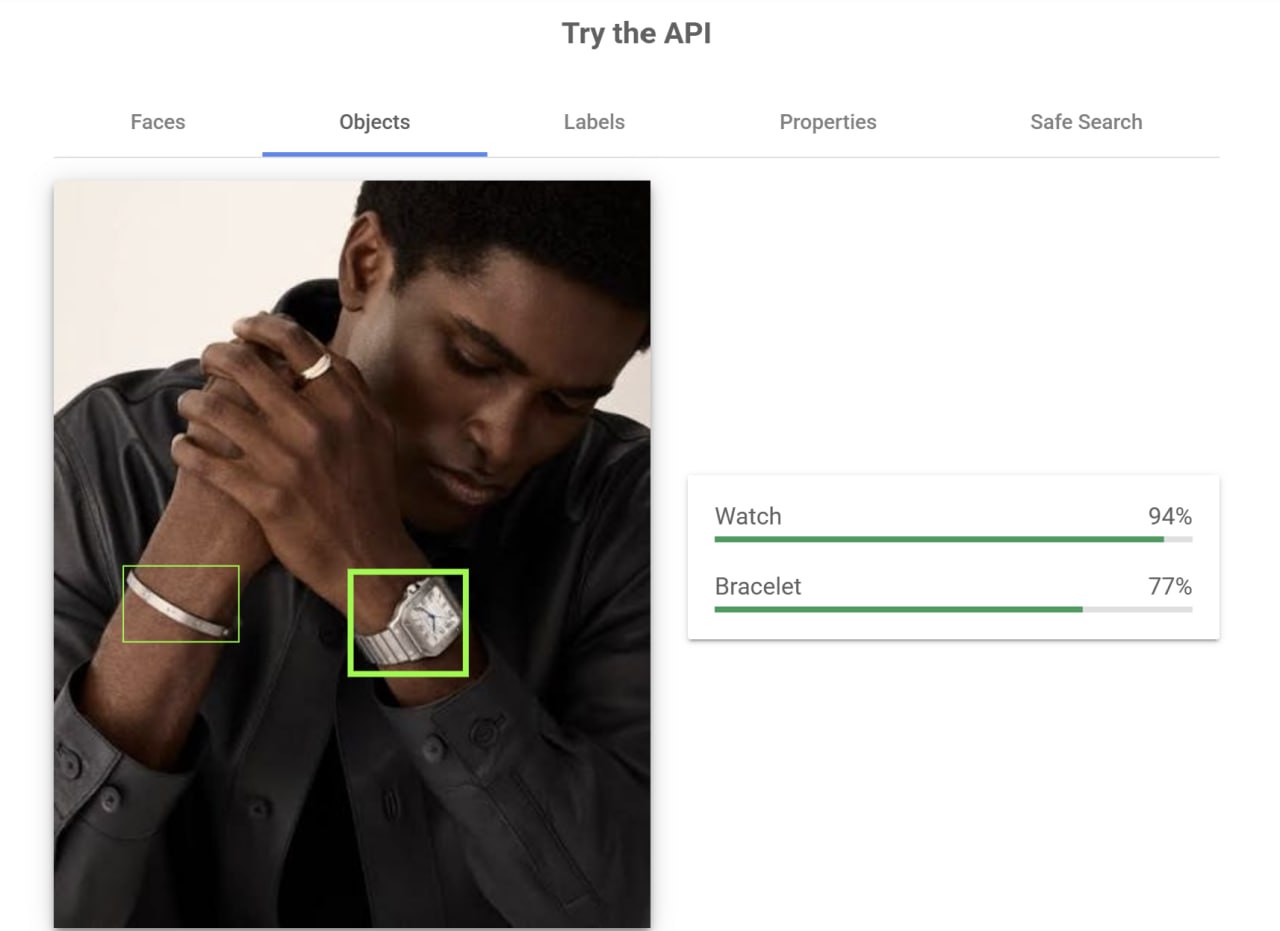
На одном из рекламных кадров Cartier модель компьютерного зрения выдала браслет и часы, но в упор не заметила кольцо.

То, что креативная команда пыталась донести, и то, что фиксирует алгоритм — это разные сущности.

И только вторая попадает в движок ответов.

Текст на картинке отваливается при измеримых условиях.

Пороги отказа, вытянутые из литературы Cognex и arXiv, а не из спецификаций Google, показывают: OCR ломается при высоте символов ниже ~30px, контрасте менее ~40 оттенков серого, на стилизованных шрифтах и бликах от отражающей упаковки.

Сжатие, заточенное исключительно под скорость загрузки, вычищает текст с упаковки, который модель должна была спарсить.

Большую часть слоя измерений берет на себя Google Cloud Vision API:

Web Detection отдает fullMatchingImages, partialMatchingImages, visuallySimilarImages и pagesWithMatchingImages. Это проверка на уникальность: реально ли hero image принадлежит вам, или это около-дубль, который юзает половина ниши.
OBJECT_LOCALIZATION возвращает названия найденных объектов, mid-идентификаторы, скоринг уверенности алгоритма (confidence) и координаты (bounding boxes). Это дает список объектов-соседей в кадре, чтобы контролировать совместную встречаемость по бренд-гайдлайнам. Сам по себе API контекст не оценивает.
TEXT_DETECTION прогоняет OCR-слой, отвечающий за метрику читаемости.
FACE_DETECTION отдает faceAnnotations и классификаторы эмоций от UNKNOWN до VERY_UNLIKELY, UNLIKELY, POSSIBLE, LIKELY и VERY_LIKELY (где VERY_LIKELY — это таргет). Отсечка по confidence: 0.90 и выше — железобетонно, 0.70-0.89 — сойдет для второстепенных кадров, все, что ниже 0.60 — это мусор.
— Масштабирование проверки идет через Screaming Frog плюс OpenAI Vision API и остается качественным. Связка флагит запросы, которые страница уже могла бы забрать, если бы ее текст подтверждал то, что нарисовано на фото.

За этими цифрами стоят два вопроса.

Первый: правильно ли машина прочитала то, что в кадре?

И второй: правильный ли объект туда вообще засунули на старте?

Первое — это слой денотации, который можно чекнуть на уровне объектов.

Второе — слой коннотации: проблема брифинга, которую не закроет ни один API.

https://searchengineland.com/images-new-job-ai-search-485840

#AIOverviews #ImagePack #Patents

@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Post #6701 1.13K
Главная беда хомяков — они жмутся платить за инфу, но потом платят оверпрайс за свои же факапы.

Экономят на базе, которая могла бы принести им иксы.

Сливают тысячи евро на тесты и связки, прожигают время, но зажать €20 за готовые, рабочие обходы фильтров в @MikeBlazerPRO — это классика.

Пока ты экономил, мимо тебя прошло вот это:

1. Паразитирование на чужих бюджетах в генеративной выдаче — архитектура контента, которая легально отжимает упоминания и конверсии у гигантов ниши прямо в ответах нейросетей.

2. Моментальная легализация дочерних активов — схема верификации, которая намертво пришивает твои дропы к авторитетной сущности и накачивает их весом за 24 часа.

3. Ты сам убиваешь локальное ранжирование — как снос одного дефолтного блока верскти физически фиксирует фокус краулера на нужной локации и бустит ее.

4. Безопасная заливка тысяч страниц без ручника — алгоритмический паттерн разгона, который позволяет масштабировать сетку и не отлететь в бан на ближайшем кор-апдейте.

5. Бетонная фиксация паразитов в топе на годы — маршрутизация ссылочной массы, которая отжимает выдачу у жирных конкурентов даже при минимальных затратах на продвижение.

6. Тотальная монополизация ответов нейросетей — как точечная игра с суффиксами бренда и размеченными чанками заставляет ИИ цитировать тебя во всех кластерах.

7. Вечные позиции в сложных нишах без реального ресерча — черный метод накачки страницы сигналами достоверности, который годами удерживает брендовый трафик.

8. Неснимаемый лок фантомных атрибутов на годы - как одна попытка хакнуть интерфейс платформы превращается в приговор, который не откатить даже через саппорт.

9. Машинная накачка сущности через аудио-синдикацию — как жесткое форматирование скриптов и веерная заливка по трастовым базам отжимает 75% визуального пространства в поиске за две недели.

10. Сброс негативного траста без потери времени в чистилище — метод мгновенной очистки архитектуры, который выводит домен из-под фильтра качества в разы быстрее дефолтных тегов.
-

Давай честно: если €20 для тебя — это «инвестиция всей жизни», ты просто выбрал не ту профессию.

Цена входа — это жесткий фильтр от случайных пассажиров и любителей собирать бесплатные объедки.

Бесплатная инфа стоит дороже всего, потому что она всегда опаздывает и выходит, когда перестала работать.

Хватит работать «по справке» и чуйке.

Забирай готовый профит!
  • 👍 7
  • 😁 4
Post #6700 1.64K
Я говорю Клоду, что он — эксперт с 20-летним опытом в SEO

#Humor

@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
  • 😁 39
Post #6699 1.49K
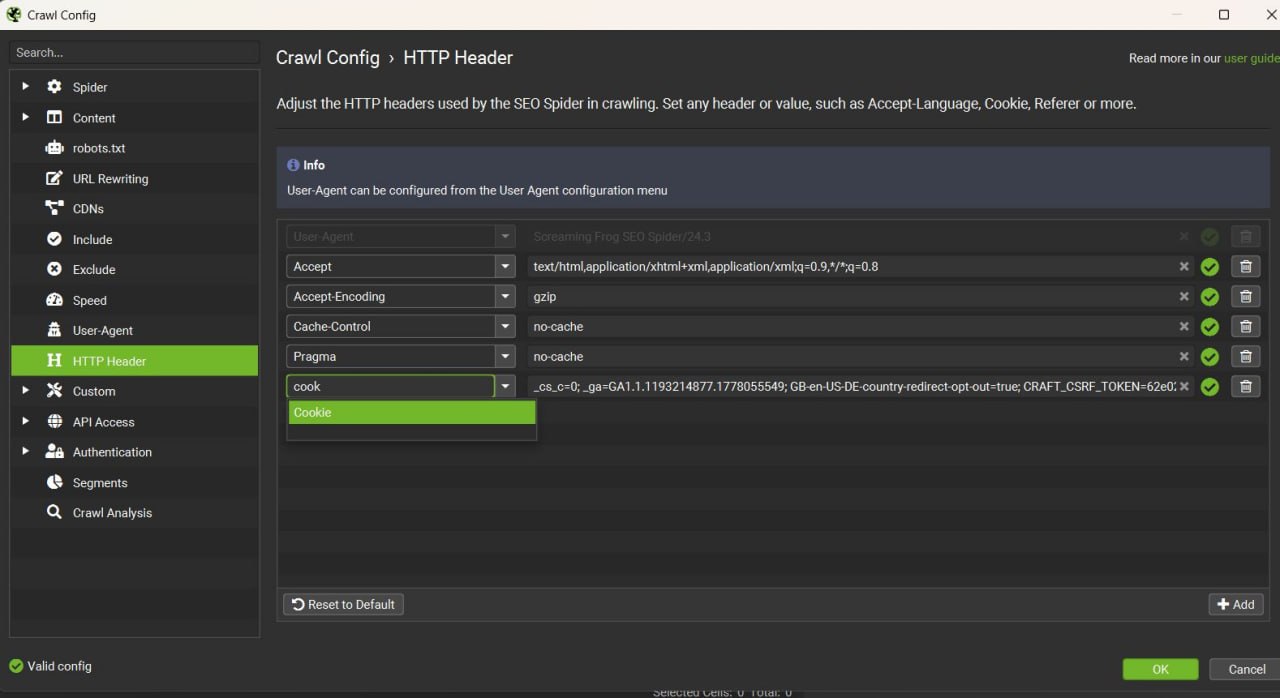
Мучаетесь с краулингом сайтов на Cloudflare из-за 403 статуса и блокировки ботов?

Просто откройте любую страницу нужного сайта.

Откройте Chrome DevTools.

Обновите страницу.

Перейдите в Network > Doc > основной HTML > Cookie и скопируйте их.

В Screaming Frog перейдите в Crawl config > HTTP Header > нажмите Add > добавьте Cookie и вставьте их туда.

Поздравляю, теперь в большинстве случаев вы получите статусы 200 и больше никаких 403, рассказывает Абдерразак Руаг.

#BotBlocking #Crawling #ScreamingFrog

@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
  • 👍 7
  • 👀 1
Post #6698 1.32K
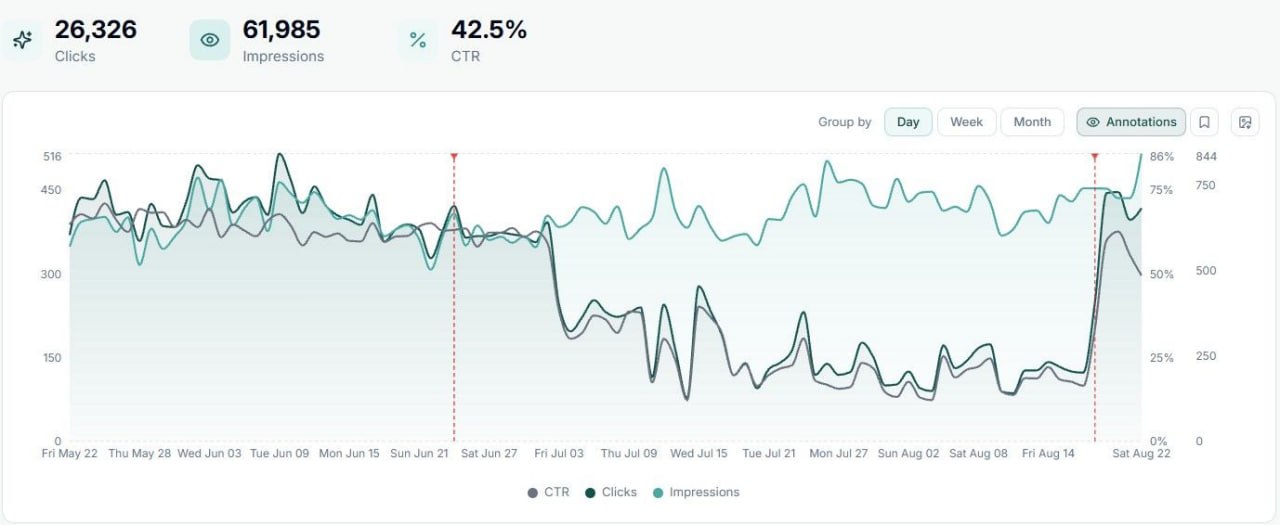
95% хорошего SEO — это базовое SEO. Возьмем этот пример.

На этом домене главная страница показала резкое падение CTR, за которым закономерно просели и клики.

После запуска редизайна главной страницы Google вообще перестал показывать мета-дескрипшн, что привело к массивному обвалу CTR.

Клиент пофиксил мета-дескрипшн -> CTR снова вырос -> Клики вернулись.

Думаю, пора мне тоже портировать Search Sentinel (searchsentinel.app сейчас трекает +/- 30 000 URL в минуту) в Gscwizard.com, рассказывает Ян-Виллем Боббинк.

Инсайты комьюнити

— Не проверено, но подразумевает: полностью пустой сниппет в выдаче — вместо того, чтобы Google по привычке автоматически переписал дескрипшн — сигнализирует о том, что текста для извлечения нет вообще, а не просто отсутствует мета-тег. Стоит проверить, не переехал ли рендеринг контента на сторону клиента после редизайна.
— Прежде чем списывать восстановление CTR только на возвращенный мета-дескрипшн, сопоставьте объем показов и CTR в пострадавшем окне, чтобы исключить сдвиг в миксе запросов из-за редизайна как искажающий фактор. В этом кейсе подтверждено, что тайтл и быстрые ссылки не менялись, что сужает изменения на стороне выдачи именно до мета-дескрипшна.
— Отчеты практиков о том, что именно подпитывает AI-ответы после редизайна, расходятся: одни считают источником мета-дескрипшны, поэтому их удаление бьет и по видимости в AI-ответах; другие указывают на первый абзац страницы, который точно так же часто теряется при переездах — и, в отличие от GSC, ничто не подсвечивает эту потерю, пока кто-то вручную не спросит AI-инструмент.
— Ограничение скоупа в этом кейсе: пострадавшая страница была главной и собирала в основном брендовые запросы, а исчезнувший дескрипшн четко разделял две разные группы пользователей — то есть сниппет работал на сегментацию аудитории, а не просто как шаблонный рекламный текст.

#OnPage #MetaDescriptions #CTR

@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
  • ❤ 2
Post #6697 1.08K
Entity Stacking: ссылки sameAs формируют сущность в Knowledge Graph, а не позиции

Триста мусорных прогонов по каталогам определяют компанию хуже, чем один массив sameAs в микроразметке Organization, который уже висит на сайте, причём этот массив бесплатен.

Entity Stacking — это полный маневр: выкатываешь внешние профили, а затем прописываешь каждый из них через sameAs, чтобы Google прочитал весь набор как единую сущность.

Выхлоп измеряется не в позициях.

sameAs напрямую вообще не помогает ранжироваться — он помогает Google утвердить сущность и ее KGMID.

А уже этот идентификатор кормит панель знаний, дает бизнес-контекст для Gemini и питает около 900 других систем и сигналов, которые потребляют эти маркеры.

Выкаченный массив уходит далеко за пределы социалок:

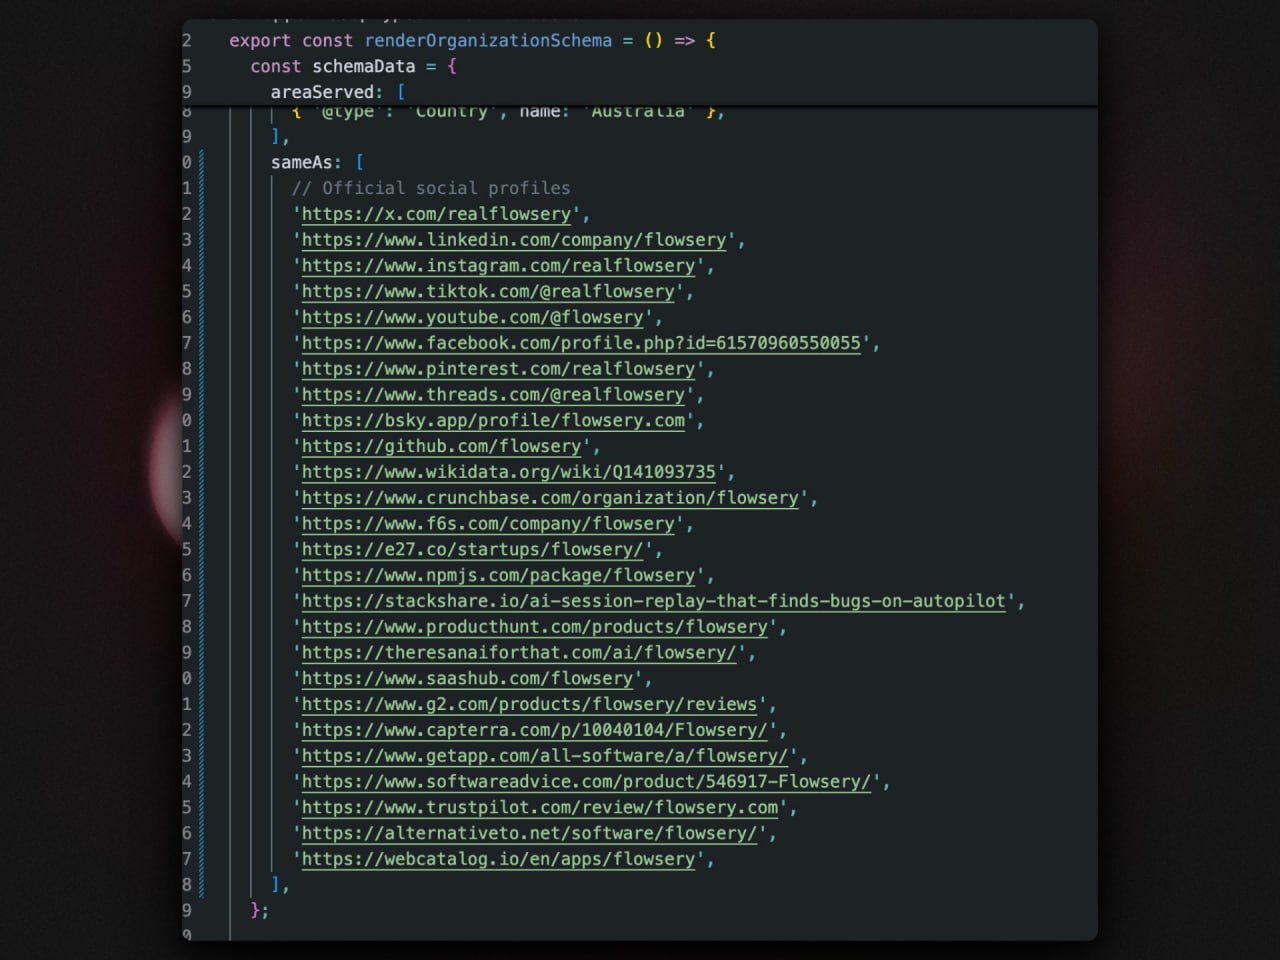
— Официальные соцсети: x.com, linkedin.com/company, instagram.com, tiktok.com, youtube.com, facebook.com, pinterest.com, threads.com, bsky.app, github.com
— Все остальное в том же массиве: Q-запись в Wikidata, Crunchbase, F6S, e27, npm, StackShare, Product Hunt, TheresAnAIForThat, SaaSHub, G2, Capterra, GetApp, Software Advice, Trustpilot, AlternativeTo, WebCatalog

Бóльшая часть второй строки — это профили в каталогах, и именно этот факт прячется за формулировкой "300 мусорных прогонов".

Критерий отбора здесь не в том, каталог это или нет.

Собственное определение свойства на Schema.org гласит: "URL эталонной веб-страницы, которая однозначно указывает на идентичность элемента. Например, URL страницы в Wikipedia, записи в Wikidata или официального сайта".

Однозначная идентификация — это то, что дает Wikidata, и то, чего лишен мусорный объем.

Никакого секретного соуса здесь нет — это задокументированное поведение свойства.

Точка отказа — разногласия внутри стека.

Полевые тесты показывают: Google игнорирует sameAs, если связанные профили расходятся в каноническом URL компании.

В итоге реальная работа сводится к аудиту существующих профилей на согласованность каноникалов, а не к самой разметке.

Базовое утверждение здесь остается скорее декларацией, чем метрикой — тестовых данных под него нет, а контрпозиция гласит, что на page-level SEO это вообще не влияет.

В паблик выложен только сам сниппет: репозиторий flowsery-entity-schema сшивает массив с блоком areaServed внутри единой функции renderOrganizationSchema.

Если закинуть эти ссылки в микроразметку Organization через sameAs, Google поймет, кто ты вообще такой, в разы лучше, чем через 300 мусорных прогонов по каталогам, и это бесплатно:

https://github.com/TarasShyn/flowsery-entity-schema

Инсайты комьюнити

— Трастовые профили в каталогах, которые уже есть на руках, спокойно стакаются в тот же массив, а не списываются в утиль как мусор — зафиксировано в юридической нише, без точных цифр выхлопа.

#EntitySEO #OrganizationSchema #SchemaOrg

@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
  • 🔥 2
Post #6696 885
Storyblok только что удалили 691 страницу со своего сайта. Их упоминания в AI выросли.

4 546 страниц проверено в ходе аудита.

691 удалена.

101 отправлена на обновление.

Я взял интервью у Шарлин Кейл, которая руководит контентом в Storyblok, об их стратегии SEO и GEO, пишет Билл Уидмер.

Шарлин рассказала мне, что в июне они пошли на кардинальные меры из-за гниющего бэклога контента.

Вот что они сделали:

→ Фаза 1: выгрузили каждую страницу из CMS с датами публикации и тайтлами
→ Фаза 2: прошлись по техничке с помощью Otterly AI и Peak AI на предмет пробелов в микроразметке и дублей
→ Фаза 3: вручную отсмотрели бэклинки и сам контент страниц

На аудит у них ушло около месяца, а на внедрение изменений — целый квартал.

Они удалили всё со старыми бренд-месседжами, неактуальные кейсы и страницы кампаний, а также страницы без какой-либо ценности на данный момент.

Каков результат?

→ На 15% ускорилась индексация (измеряли как падение среднего времени деплоя после того, как все истории закешировались в их API). Более быстрые сборки означают более быстрые краулинги — как со стороны Google, так и со стороны AI-движков.
→ На 5% выросли упоминания бренда Storyblok по пулу промптов, который они отслеживают.

Аудит библиотеки контента — это не самая привлекательная задача, и это не быстрый фикс, особенно если у вас сотни или тысячи страниц.

Но, по словам Шарлин, это вещь №1, которую вы можете сделать, чтобы улучшить свое присутствие в AI-поиске в этом квартале.

ChatGPT и Perplexity вытягивают живые страницы, когда формируют ответы.

Ваши неактуальные цены, закрытые фичи, кейс за 2023 год — всё это может быть вытащено и процитировано потенциальному клиенту прямо сегодня.

Гораздо приятнее думать о выпуске нового контента.

Оригинальные исследования, кейсы, статьи в блог...

Но решать, что убить или обновить — не менее, а то и более важно.

Когда вы в последний раз делали масштабный контент-аудит?

Если вам нужна помощь с этим, моя личка открыта.

У меня есть место для одного-двух новых клиентов с сентября, и я с удовольствием сделаю бесплатный первичный аудит и консультацию, чтобы понять, подходим ли мы друг другу.

Инсайты комьюнити

— В кейсе самой Storyblok есть данные, подтверждающие, что заявленное 15% "ускорение индексации" — это время пересборки индекса внутреннего поиска Algolia по сайту, которое упало с 36 минут 14 секунд до 30 минут 41 секунды. То есть это внутренняя операция, а не доказательство того, что Google или AI-системы стали быстрее краулить или индексировать сайт. Параллельный рост упоминаний бренда на 5% смазан одновременным внедрением редиректов, улучшением кэширования и тем фактом, что прошел целый квартал, поэтому его нельзя изолированно приписать только удалению страниц.
— Не проверено, но подразумевает: аудит по чистке контента должен выходить за рамки трафика и бэклинков, охватывая проверку на согласованность сущностей и дублирование. Нужно оценивать, вносит ли каждая оставленная страница уникальные данные в общую базу знаний сайта или просто дублирует и противоречит существующему контенту.
— Целевой ритм свежести контента: в идеале не должно быть страниц старше 3 месяцев, а 1 год — это реалистичный крайний предел.

#Pruning #ContentStrategy #AI

@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Post #6695 967
Данные доказывают: упоминания на 4+ внешних площадках форсируют ИИ-цитирование в 2.8 раза — у лидеров меньше KG-сущностей

Модели отдают ответ, который видят повсюду.

Вот почему запись в Knowledge Graph, за которой все советовали гнаться, — это ложный вектор.

Данные доказывают обратное: часто цитируемые страницы в среднем содержат меньше верифицированных KG-сущностей, чем те, что цитируются редко.

Вместо этого модели цепляются за конкретные, нишевые сущности — названный метод, точную статистику, именное сравнение — а микроразметка остается лишь гигиеной идентификации, а не драйвером цитирования.

Извлечение также идет на уровне чанков, а не целых страниц.

ИИ-ответы подтягивают абзацы, а большинство сайтов не содержат ни одного чистого блока, который движок мог бы безопасно процитировать.

Открывай каждый ключевой раздел прямым утверждением "[X] — это [Y]" и вычищай хеджирование: никаких "если", "но" или "возможно".

Упоминания бренда коррелируют с попаданием в AI Overview примерно в 3 раза сильнее, чем бэклинки.

Скорее всего, дело в том, что анкоры ссылок размываются, тогда как упоминание намертво привязывается к сущности самого бренда.

Упоминания без ссылок теперь засчитываются как голоса, а извлечение с 4+ сторонних площадок поднимает шансы на цитирование ~2.8x:

— Сайты-отзовики
— Листинг-статьи
— Транскрипты YouTube
PR

Половина жалоб в духе "почему меня не цитируют" сводится к правилу Cloudflare или WAF, которое втихую блокирует GPTBot, ClaudeBot, PerplexityBot и Google-Extended.

Лезь в логи файрвола и robots.txt, прежде чем трогать хоть слово в контенте — страница, которую запрещено краулить, никогда не станет ответом.

Модели также дают перевес доменам, которым уже доверяют.

Плотный, похожий на ответ чанк на трастовом хосте влетает в ИИ-выдачу, пока свежий домен все еще сидит в песочнице.

Арендуй траст, засеивай сущность, перехватывай клик или брендовый поиск.

Консенсус — это вообще вся суть игры: модель выдает то, с чем согласны везде.

Единственная оставшаяся задача — стать этим ответом на каждой площадке, откуда парсятся данные.

#AIOverviews #BrandMentions #KnowledgeGraph

@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Post #6694 969
Одно вшитое видео вытаскивает статью на 5 позицию и срезает отказы до 28%

Тот же пост, одно вшитое оптимизированное видео: позиция page 3 → page 1, position 5, трафик 180 → 1,200 в месяц (6.6x), время на странице 1m 20s → 3m 45s (+180%), отказы 58% → 28% (-52%).

Зафиксировано единственное измерение до/после, методология не раскрывается.

Подача, привязанная к таким цифрам — видео как фактор ранжирования 2026 года — преувеличивает то, что документирует Google.

Видео внедрено в расширенные фичи выдачи: фичерд сниппеты, мобильные карусели, отдельный SERP по видео, плюс индексация самого ролика как контента через субтитры и метаданные.

Прямой статус сигнала ранжирования для стандартной органики — это отдельное утверждение, и оно не задокументировано.

В итоге этот стек заточен под захват поверхностей, и работает он на тексте.

Автосгенерированные субтитры тянут за собой ошибки, ручные субтитры их правят, а полный транскрипт — это тот элемент, который улучшает краулинг.

Субтитры скармливают понимание, транскрипт скармливает индексацию.

Настройка метаданных на стороне YouTube:

Title: [Primary keyword] | [Benefit/outcome] | [Brand name]
Tags: 5-10 релевантных тегов, драйвят поиск по YouTube плюс блок похожих видео
Category: точный выбор, который влияет на рекомендации
Visibility: public, никогда не unlisted или private
Playlists: тайтлы с плотной семантикой, так как плейлисты сами ранжируются во внутреннем поиске
— Уровень канала: название с ключом, детальное описание, теги канала

Описание занимает 500+ слов и бьется на пять блоков:

1. Хук — что узнает зритель и почему это важно
2. Структура — таймкоды для каждого раздела
3. CTA — подпишись, лайкни, перейди по ссылке
4. Ключи, вписанные естественно, а не спамно
5. Ссылка на транскрипт

На стороне сайта видео вшивается нативно, а не ссылкой, прямо внутрь поста, который является текстовой версией ролика.

Пост ссылается на видео, а видео ссылается обратно.

Страница с эмбедом несет JSON-LD VideoObject с name, description, duration в формате ISO-8601 (например, PT5M30S), uploadDate, thumbnailUrl и url.

ПФ, которые решают позицию видео: время просмотра, средняя длительность и CTR превьюшки.

Хук в первые 3 секунды, разрыв шаблона, главы, CTA на конечной заставке для перехода к следующему ролику.

Тумбам нужен сильный контраст, чтобы выжить при мелком рендере, лицо плюс эмоция, главный ключ текстом поверх и A/B-тестирование вариаций.

Выбор формата гейтит все остальное.

How-to, туториалы, кейсы, интервью с экспертами и визуализация данных ранжируются выше всего, потому что под них есть соответствующий интент запроса.

Влоги, нетематические стримы и размытый образовательный контент сидят на самом дне этого стека — под них нет интента для сопоставления.

Инсайты комьюнити

— Короткие клипы, вшитые в тело статьи, отрабатывают лучше, чем отдельная страница под видео, согласно полевым наблюдениям без точных цифр.
— Переиспользование в ecommerce — недооцененная половина схемы: продуктовый ролик индексируется, а заодно бустит страницу товара и email после покупки. В итоге одна съемка окупается в трех местах вместо одного.

#Video #FeaturedSnippets #VideoSchema

@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
  • ❤ 5
Post #6693 940
2.2% цитат в ChatGPT выживают после трех промптов — данные раскрывают, почему аудиты AI-видимости проверяют не те уровни

Заголовки переписываются для тематического охвата на страницах, которые ни один агент не фетчил уже шесть недель, документирует Ян-Виллем Боббинк.

Качество контента, полнота охвата и авторитет бренда — из-за всего этого теряются цитаты, но диагностировать это можно только после того, как пройдены все базовые уровни под капотом.

Лестница для клиента строится снизу вверх.

0. Базовая планка измерений. Данные AirOps фиксируют, что если прогнать один и тот же промпт через ChatGPT трижды, в живых остается лишь 2.2% исходных цитат. То есть одна сессия — это шум, а не показатель. Базлайн собирается за 5-10 прогонов в разные дни. При этом один из практиков возражает: Perplexity API выдал нулевую дисперсию внутри дня — идентичный набор цитат на каждый повтор, хотя сам UI ведет себя как совершенно другой инструмент. Получается, количество повторов — это предписание под конкретную площадку, а не универсальное правило для аудита.

1. Доступность для фетчинга — получает ли агент байты вообще. Директивы robots, которые никто не обновлял под GPTBot, OAI-SearchBot, PerplexityBot или ClaudeBot, антибот-системы, отдающие 403 статусы, и контент, который существует только после гидратации — всё это обрывает процесс прямо здесь. Логи серверов фиксируют ответ на этот вопрос за полдня.

2. Право на индексацию. Извлечение идет по индексу, и это не всегда индекс Google: Bing кормит Copilot и закрывает часть выдачи ChatGPT Search, наряду с Brave и его собственным индексом. Страница, выпавшая из этих баз, теряет шансы на весомую долю цитирований — проверяйте это по конкретному URL, а не по всему сайту.

3. Ранжирование извлечения по суб-запросу — именно здесь живет то, что принято называть проблемой fan-out запросов. Частота цитирования составляет 58% на 1-й позиции → 14% к 10-й позиции, и никакой качественный копирайтинг этот разрыв не закроет. Страница просто отфильтровывается еще до начала этапа отбора.

4. Отбор — этап, на котором 85% извлеченных страниц исчезают без цитирования. Точное попадание заголовка в запрос двигает метрику: 41% для точных совпадений против 29% для слабых, равно как и фокус самой страницы. Domain Authority не прогнозирует ничего: сайты с DA 20-40 собирали больше цитат, чем гиганты с DA 80-100.

5. Предпочтение: страницу стабильно цитируют, но она всё равно проигрывает рекомендацию. Противоречивые утверждения на собственных площадках бренда, слабое подтверждение от сторонних источников и размытое позиционирование оседают на этом уровне.

Вопрос всё еще открыт: анализ 173 902 URL от Surfer показывает, что страницы, ранжирующиеся по fan-out запросам, на 161% чаще цитировались в AI Overviews.

Это противоречит выводам об извлечении и отборе, приведенным выше.

Инсайты комьюнити

— Порядок уровней оспаривается по двум причинам. Экономика ресурсов: пофиксить контент часто дешевле и быстрее, чем чинить фетчинг, где нужно согласовывать роадмапы и привлекать разработку. Поэтому контент выкатывают первым, чтобы повысить шансы на то, что следующий фетч пройдет фильтры. Ценность измерений: прогонять промпт 100 раз ничего не решает, пока сайт невозможно прокраулить и отрендерить. Уровень 5 тоже поднимают выше: полевые наблюдения фиксируют, что несогласованность бренда наносит больше ущерба именно там, где показываются AI Overviews.
StatCounter, Similarweb и Graphite оценивают суммарную долю ChatGPT, Claude и Perplexity в ~2% от всех потребительских поисковых запросов за месяц, тогда как у Google ~75%. Встречное наблюдение: некоторые сайты уже фиксируют, что LLM генерят больше конверсий, чем классический поиск, поэтому бюджет усилий задает именно анализ аудитории, а не общая доля рынка.
— Ответы без опоры на источники лежат вообще за пределами лестницы извлечения. Видимость там сложнее перевести в конкретные действия, чем при оптимизации под RAG, но она сдвигает долгосрочный роадмап.

#AI #RAG #TechnicalSEO

@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
  • ❤ 2
Post #6692 1.15K
Этот тест показал, что правило «5 секунд на рендер» от Google — это миф. На самом деле он ждал рендера страницы больше 30 секунд!!!

Это был отличный кейс и тест от Дэйва Смарта.

В статье он подробно рассказывает, как обсуждал с клиентом миф о том, что Google ждет всего 5 секунд, чтобы отрендерить контент.

Из своего опыта он знал, что времени дается ГОРАЗДО больше.

В итоге он развернул контролируемый эксперимент на сайте TametheBots.

Он создал тестовую страницу, но со встроенными задержками.

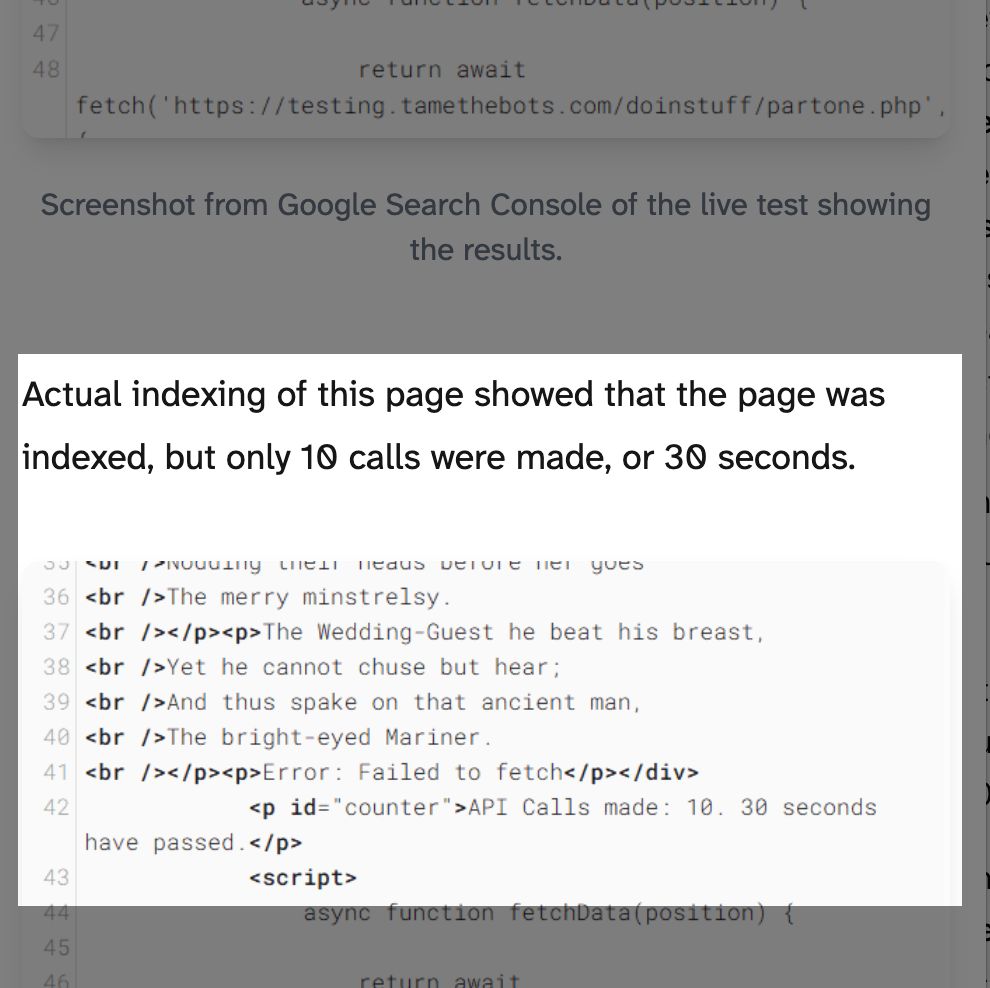
Серверу приходилось ждать 3-6 секунд до ответа, а затем он делал это снова — то есть Google приходилось ждать от 6 до 12 секунд.

Он обнаружил, что Google всё равно смог отрендерить страницу.

По факту лимит, который он нашел в реальном индексе страниц, составил около 30 секунд.

Он увидел доказательства того, что в Search Console это время может быть еще больше.

Так что эксперимент максимально интересный.

Оказывается, Google готов ждать возврата JavaScript-контента довольно долго, делится Крис Лонг.

https://tamethebots.com/blog-n-bits/the-5-second-google-render-limit-myth

#Rendering #TechnicalSEO #JavaScript

@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
  • 👍 3
Post #6691 1.16K
Каноникал на вторую страницу убивает краулинг — алгоритм видит в ней дубль

Пагинация вылезает с пугающей регулярностью на сайтах любого размера (одно агентство назвало ее самой частой ошибкой в техничке клиентских проектов), а урон бьет по обнаружению листингов, ссылочному весу и краулингу.

У урла пагинации ровно одна задача: нести краулируемую ссылку на каждый листинг, чтобы Google мог обнаружить эти страницы и перелить на них PageRank.

Каждый сигнал индексации в цепочке — каноникал, мета-теги robots, наличие в сайтмапе — вытекает из того, стоит ли этот путь краулить.

Этот путь существует только в HTML.

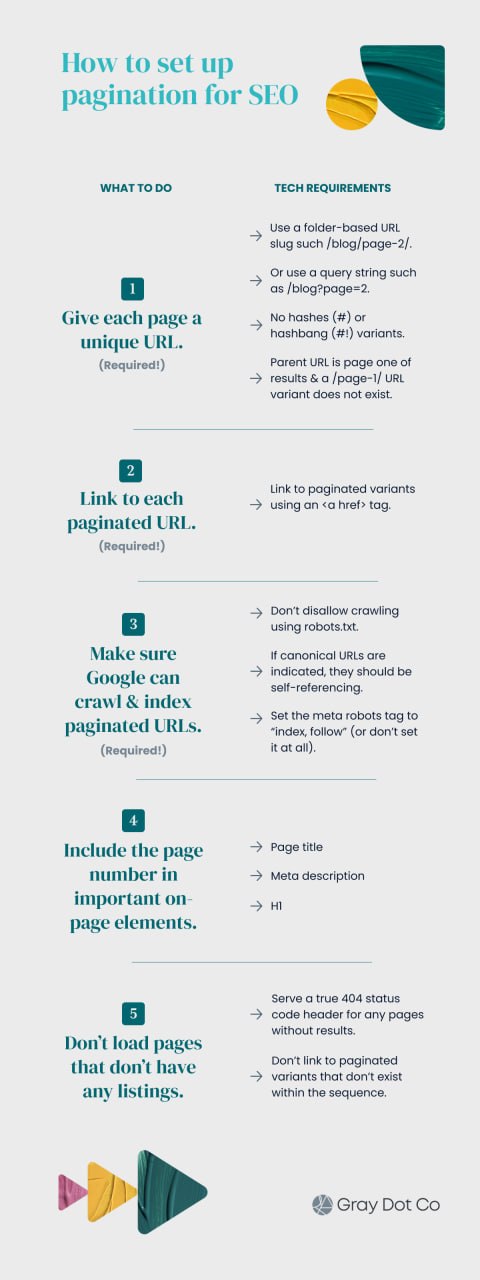
Каждому шагу нужен свой урл, слаг или строка запроса — никаких хешей и hashbang-фрагментов, Google их не поддерживает.

HTML-кнопки — это не ссылки, а гуглобот не умеет скроллить, поэтому дефолтные сборки Load More и Infinite Scroll вообще не прокидывают пути краулинга дальше первой пачки.

Фикс: настоящая ссылка <a href>, стилизованная под кнопку, где JavaScript подгружает результаты на лету.

Google краулит ссылки <a href> как в ответе сервера, так и в отрендеренном HTML, но предварительный рендер страницы вообще не гарантирован — это железобетонный аргумент в пользу того, чтобы отдавать ссылки сразу в серверном ответе.

Дальше правила каноникалов расходятся в противоположные стороны внутри одной цепочки.

Тег каноникала существует для контроля дублей и частичных копий.

Поэтому вариант /page-1/, который невозможно убрать из-за технических ограничений и который повторяет те же листинги, что и родительская страница, должен указывать на родителя (во всех остальных случаях родитель должен быть единственным урлом для первой страницы).

Страница 2 — это валидная, уникальная страница: она отдает каноникал сама на себя, держит мета-теги robots на index, follow и никогда не ставит каноникал наверх.

Страницы без листингов — обратный случай.

Пустышка ?page=43, отдающая код 200 в серии из трех страниц — это soft 404, который заставляет Google краулить мусорные урлы.

Поэтому пустые варианты должны отдавать честный заголовок 404 и лежать без внешних ссылок.

Есть два кейса, которые в любом случае оправдывают закрытие пагинации от индекса.

Пагинация по тегам и категориям блога дублирует тайтлы и дескрипшены на малоценных страницах, тогда как основная лента блога уже дает краулируемый маршрут к тем же постам, так что лишние пути краулинга дают убывающую отдачу.

На сайтах с сотнями тысяч или миллионами урлов краулинговый бюджет форсирует жесткое решение: e-commerce с карточками товаров и страницами отзывов под каждый товар может не вывезти частый краулинг и того, и другого.

Ссылки со страниц товарных листингов побеждают, потому что они находят товары и переливают PageRank, что ценнее, чем краулинг дополнительных отзывов дальше первой страницы.

Если вторая и последующие страницы ранжируются выше родительской (что бывает редко и в основном как легаси-проблема энтерпрайза), это закрывается тремя проверками:

— Стоит ли на родителе каноникал сам на себя, и не перезаписывает ли его JavaScript?
— Бьют ли внешние и внутренние ссылки на страницу 2+ вместо родителя? На конкретные варианты пагинации должны вести ссылки только из их собственной цепочки.
— Прокинут ли номер страницы в тайтл, мета-деск и H1 вариантов пагинации?

Затем вычисти сайтмап.

Если снести оттуда всё, кроме родительского урла, Google быстрее поймет, какая страница в приоритете.

https://thegray.company/blog/pagination-seo-guide

#Pagination #Crawling #TechnicalSEO

@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
  • ❤ 4
Post #6690 1.27K
Zero-click убил только инфосайты под рекламу — это все потери со времен HCU

Пока что ровно одна бизнес-модель была фактически уничтожена интернетом с ИИ-ответами и зеро-клик выдачей: информационные контентники, монетизируемые через рекламу.

Это все потери со времен HCU, что, впрочем, не гарантирует, что они останутся единственными.

Zero-click бьет только по тем операторам, которые продавали клики на информацию.

Ecommerce, SaaS, локальному SEO, лидгену, паразитам, видео, неанглоязычным сайтам и агентствам абсолютно плевать, что AI Overview ответил "что такое ипотека".

Никто не заносит депозит в казино, не бронирует пересадку волос за $4k и не нанимает адвоката по травмам прямо из сниппета.

Коммерческие запросы с высоким интентом все еще кликают — забирай их и игнорируй остальное.

Статус бренда, который цитирует модель, окупается дважды: цитата сейчас, брендовый поиск потом.

А брендовый поиск скармливает поведенческие сигналы обратно в алгоритмы ранжирования.

Это смещает фокус с вылизывания страниц на фабрикацию консенсуса вокруг имени.

Модели Pay-per-call и лидгена вообще игнорируют показы.

Выведи в топ один коммерческий ключ или добейся, чтобы сами контакты процитировали внутри AI Overview, перехватывай звонок, получай оплату за лид.

Заявленная математика автора: 50 звонков в месяц перевешивают 50k просмотров страниц за копейки с рекламы.

Email-базы, комьюнити и подписчики — это та дистрибуция, которую не отзовет ни один алгоритм.

Когда клики пересохнут, уже собранная аудитория останется единственным активом, который никто не сможет деиндексировать.

Клик никогда не был продуктом.

Деньги лежат ниже по воронке интента, а то, что стер ИИ — это низкоинтентный трафик, который и так почти ничего не стоил вне масштабных доиишных схем.

По мере обвала кликов, ценность тех, что выжили, растет исключительно на законах спроса и предложения.

#AIOverviews #SearchIntent #ContentStrategy

@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
  • 💯 2
Post #6689 1.3K
Патенты Google раскрывают ранжирование по шаблонам — одна успешная вариация поднимает шансы всего паттерна

Почему WikiHow забирает топы в тематиках, где у него вообще нет глубины?

Его авторитет привязан к шаблону запросов "как сделать", а не к конкретной нише, а вариации внутри шаблона не требуют тематической релевантности друг другу.

Ширина шаблона работает наравне с глубиной сущностей и атрибутов, и эта связка — самый мощный формат.

Эта механика работает за счет стоимости извлечения: затраты на ранжирование сайта не могут превышать издержки на отказ от его ранжирования, а ранжирование по паттернам структурирует больше источников за меньшие вычислительные ресурсы.

Пол Хаар из Google прямым текстом озвучил внутреннее правило: "Если по запросу плохая выдача, мы не будем его исправлять. Если запрос принадлежит к кластеру, мы исправим кластер. Нам не интересны отдельные серпы, даже если мы знаем, что там мусор".

Патент Automatic Query Pattern Generation (US10467256B2) описывает, как Google генерирует шаблоны запросов и выстраивает индексы вокруг них.

Каждый ранжирующийся запрос, вместе с его историческими данными по кликам и показам из веб-поиска или AI-ответов, повышает шансы на ранжирование остальных вариаций в том же шаблоне.

Сама по себе частотка ничего не решает: перекрытие большего числа атрибутов или вариаций шаблона, чем у конкурентов, не гарантирует рост позиций, потому что Google постоянно тестирует сайты в выдаче на предмет удовлетворенности юзеров, а кор-апдейты часто запускают эти перетасовки.

NavBoost выступает гибридным гейтом, который объединяет клики, тематичность и PageRank.

Структура предложения — это рычаг на уровне документа.

"Финансовая независимость достигается семьями с помощью финансовых консультантов" и "Финансовые консультанты помогают семьям достичь финансовой независимости" констатируют один и тот же факт, но несут разные скоры релевантности, потому что позиция субъекта в триплете изменилась.

Термин с наибольшим весом в целевых запросах должен стоять в слоте субъекта.

На масштабе шаблона из 3 000 вариаций разница в одном предложении умножается на 3 000.

Проект генератора QR-кодов получил более 1 миллиона дополнительных кликов за три месяца — и этот буст приписали именно таким микросемантическим сдвигам, наряду с техническими фиксами и переездом CMS.

Решения по количеству страниц работают по той же паттерн-логике.

По принципу Query Deserves a Page новая страница заводится только тогда, когда поисковый спрос пробивает порог, а сам запрос несет другую сущность или другой паттерн с низкой семантической схожестью с существующими страницами.

Разные предикаты в вариациях шаблона сигнализируют о необходимости отдельной страницы; совпадающие предикаты при разных сущностях — тоже повод для создания отдельной страницы.

Шаблоны запросов работают в паре с шаблонами ответов.

Патент Generating Query Answers описывает, как движок ищет шаблонные аннотации ответов, чтобы классифицировать страницу как полезную — это позволяет ему быстрее отсекать мусорные источники.

Главный вопрос: какой именно визуальный или текстовый шаблон Google ищет в конкретной нише.

Ограничителем выступает аналитика.

GSC теряет почти 40% данных о кликах и показах на уровне запросов из-за k-анонимизации, поэтому экспорт в BigQuery становится базовым минимумом на масштабе шаблонов.

Фиксируй первый и последний показ по каждому урлу, чтобы помечать кандидатов на реанимацию, и своди краулинг с кликами, чтобы отловить квоту, которая сжигается на служебных урлах без какого-либо выхлопа.

https://searchengineland.com/query-templates-topical-authority-484676

#Patents #TopicalAuthority #SearchIntent

@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
  • ❤ 1
Post #6688 1.03K
Пиксельный алгоритм игнорирует метаданные — визуальный поиск делится на две независимые ветки

Метаданные не участвуют в пиксельной ветке обработки.

Эмбеддинги, распознанные объекты и извлеченный через OCR текст — это всё, что активирует снимок с камеры; альты, подписи и микроразметка на этом этапе не читаются.

Текстовая ветка — это вторая половина (альт-текст, подписи, микроразметка, фиды, окружающий текст).

Именно на нее опираются извлечение и индексация, и именно она превращает картинку в карточку товара с ценой.

Эти две ветки ломаются независимо друг от друга, поэтому если закрыть одну и проигнорировать вторую, ты получишь ровно половину возможной видимости.

Идеальный альт на темной, перегруженной фотке не пройдет алгоритм камеры.

Студийный снимок с пустым атрибутом alt и без микроразметки Product вылезет просто как картинка, а не как товар, который можно купить.

Какую ветку активирует покупатель, заранее неизвестно, поэтому закрывать нужно обе.

Это недорого: они редко конфликтуют и часто опираются на одну и ту же базовую работу.

Одно пересечение стоит отработать: текст на пикселях — это текст, который читает машина.

OCR сидит внутри пиксельной ветки, поэтому фотографии упаковки прокидывают слова прямо через маршрут камеры.

Старый аргумент в пользу оптимизации картинок строился на лени: легкие победы, потому что никто этим не заморачивался.

Этот аргумент протух.

Внедрение микроразметки в e-commerce стало массовым, бейджи товаров в выдаче по картинкам — уже норма, а не экзотика, да и сами ставки изменились.

Если захват через Lens выводит шесть конкурентов, а не тебя, ты не теряешь позиции — тебя выкидывают из выбора еще до того, как загрузится страница.

Агентный чекаут, который считывает продуктовый фид, не увидит фотографию без нужных полей.

Вопрос сместился с потенциального трафика на базовый минимум.

Сверху наложились объемы.

В октябре 2024 года Google зафиксировал почти 20 млрд визуальных поисков через Lens в месяц.

Из них 20% — коммерческие, которые сопоставляются с Shopping Graph объемом более 45 млрд товарных листингов (на I/O 2023 цифра была 12 млрд в месяц).

На I/O в мае 2025 озвучили рост на 65% год к году и более 100 млрд визуальных поисков с начала года.

Amazon отчитался о росте на 70% год к году в октябре 2024 и выкатил Amazon Lens Live в сентябре 2025.

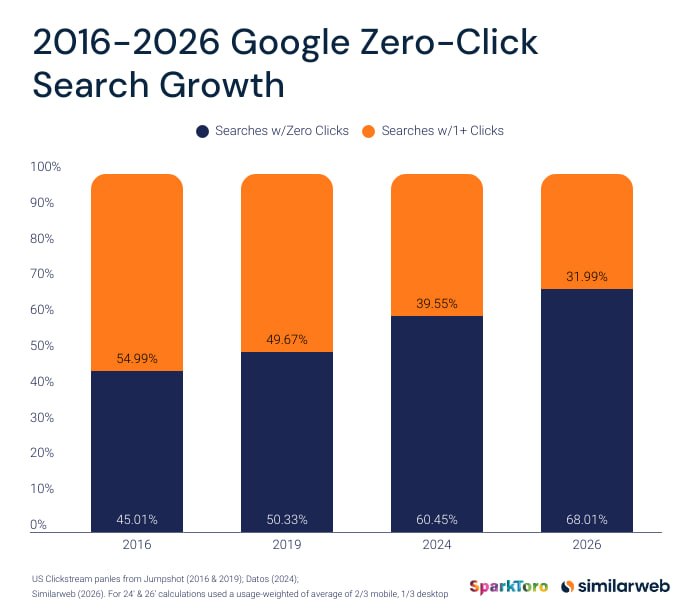
На этом фоне SparkToro и Datos оценивают долю нулевых поисков в США на уровне 68% в 2026 году (против 58.5% в 2024): теперь до открытого веба добираются примерно 276 из 1000 поисков, тогда как два года назад их было 374.

В календаре висят два дедлайна.

Минимум 500 x 500 для Merchant Center становится обязательным в январе 2027, а типы микроразметки планомерно выводятся из оборота с 2023 года — таблицы спецификаций нужно сверять с актуальной документацией, прежде чем выкатывать что-то на объемах.

https://www.advancedwebranking.com/seo/images-and-visual-search-guide

#VisualSearch #Images #Ecommerce

@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
  • ❤ 1
  • 👀 1
Post #6687 970
Слитый бинарник Geostore раскрывает 72 сигнала ранжирования Карт — и 15 скрытых весов

72 значения лежат в RankSignalProto.Signal, 25 из них явно помечены как устаревшие.

Данные вытащили из свежего бинарника, несущего непубличный скоуп Geostore.

Перечисление не содержит reservedrange, так что для этого скоупа оно полное.

Из 3 585 значений, которые сверили с архивом утечки 2024 года, 3 471 там отсутствуют — включая 70 из 72 сигналов ранжирования.

У системы есть имя — Oyster Rank, а семейство 3100–3504 держит сигналы, которые напрямую бьют по SEO-специалистам и бизнесу:

— Веб-присутствие и авторитет: SIGNALWIKIPEDIAARTICLES, SIGNALGOOGLEAUTHORITYPAGEPAGERANKCONFIDENCE, плюс SIGNALWEBSCORE на отметке 1007
— Спрос: SIGNALGOOGLEWEBQUERYVOL
— Взаимодействие с листингом: SIGNALGOOGLEREVIEWS, SIGNALGOOGLELISTINGIMPRESSIONS, SIGNALGOOGLEINFOWINDOWVIEWS
— Действия в реальном мире: SIGNALGOOGLEDIRECTIONREQUESTS, SIGNALGOOGLEHOMEPAGECLICKS
— Коммерческая структура: SIGNALGOOGLECHAINSTORES
— Физическое окружение: SIGNALPLACEINSIGHTSAPPROACHABILITY, SIGNALPLACEINSIGHTSTOTALROADSEGMENTUSAGE

Сырые SIGNALGOOGLEAUTHORITYPAGEPAGERANK и SIGNALGOOGLEWEBPAGEREFERENCEDOMAINS устарели, зато поле уверенности PageRank выжило.

Но устаревшее значение — это не текущий фактор ранжирования, а лишь след того, что существовало раньше.

Коэффициентов в этом скоупе нет.

Из RankDetailsProto — структуры, чья собственная документация гласит, что она несет сигналы и их веса — вырезали 15 тегов.

FeatureProto потерял 25 полей, TrustSignalsProto — четыре.

Дескрипторы, скомпилированные для клиента, содержат только поля из скоупа этого клиента, и поле, которое его покидает, оставляет за собой номерной тег.

До сих пор неизвестны: коэффициенты, функции нормализации, пороги, трансформации, калибровка по рынкам, взаимодействие сигналов и версии моделей.

Оба сигнала Navboost висят в географическом словаре как устаревшие.

Исследование выдвигает гипотезу, а не финальный вывод: какая бы поведенческая механика ни была сейчас активна, она больше не носит это имя и спрятана за границей скоупа того же семейства, что и HIP (High-value Intellectual Property) — примерно 0.1% от google3, наглухо закрытых в основном вокруг антиспама.

Цикл замыкают две словарные ловушки.

MIXERPLACERANK — это значение 18 в 35-значном RankDetailsProto.SignalMixerType.

Это режим комбинирования сигналов в зависимости от типа сущности, а не фактор ранжирования.

Да и Oyster Rank — это важность сущности, а не ранжирование гео-запроса.

Поиск/Места затем накидывают понимание запроса, семантическое соответствие, генерацию кандидатов и переранжирование перед тем, как выкатить топ-20.

Связующее звено между сайтом и локацией — это MID Графа Знаний, а не Place ID, и документы веб-индекса несут encodedMid.

RepositoryWebrefDetailedEntityScores.docScore задокументирован как "относительный сигнал ранжирования между разными документами для одной сущности", где normalizedTopicality суммируется до 1 по всем сущностям на странице.

Geostore никогда не хранит идентификаторы страниц; он получает обратно агрегированные оценки Web.

Страница магазина конкурирует за то, чтобы стать эталонным документом для сущности, а не просто за ключ.

https://think.resoneo.com/google-map-dissected/

#Maps #LocalSEO #PageRank

@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Post #6686 1.09K
Смена краулинговых директив генерирует каннибализацию — каноникал и мета-теги robots нейтрализуют просадку

Каннибализация масштабируется и бьет по выручке.

Причина не всегда кроется в новом контенте.

Изменение инструкций для поисковиков (что краулить, что индексировать, а что игнорировать) генерирует проблему на страницах, которые существовали до этого.

Карточки товаров, у которых появились варианты с криво настроенными каноникалами, заставляют новые урлы конкурировать с оригиналом.

Обновление плагина, которое открывает теги, поисковые запросы по сайту или страницы категорий в robots.txt, либо изменение директивы meta robots делает то же самое.

Поиск начинается в GSC: отчет об эффективности, полный отчет, фильтр по главному ключу или фразе, клик по фразе, чтобы вывести каждый урл, который по ней ранжируется.

Само по себе наличие нескольких урлов — это норма.

Верный маркер — это два или более урлов, которые делят трафик примерно поровну за один и тот же период.

Либо ситуация, когда каждая конкурирующая страница болтается на 3–5 страницах выдачи Google, тогда как раньше один урл сидел в топ-10, а сам обвал совпадает с датой публикации конкурирующих страниц.

Повтори это для нескольких ВЧ-запросов.

Одно исключение весит больше остальных: дополняющие страницы — это не каннибализация.

Гайд и конверсионная страница могут забирать один и тот же ключ на разных этапах воронки, и Google считывает, какая страница какую цель закрывает.

Одна из рабочих схем аудита прогоняет проверку отдельно для карточек товаров, категорий, статей в блоге и для всего сайта целиком, если есть несколько версий (языки, опт против розницы) — сравнение данных по всему сайту и по одному типу страниц быстрее локализует причину.

На объемах запусти краулинг через Screaming Frog, Sitebulb, Botify или Deepcrawl, вытащи тайтлы и H1, отсортируй на дубли и частичные совпадения, а затем проверь, просел ли трафик на оригиналах в момент запуска похожих страниц.

Третий подход ограничен по времени.

Поскольку Google выпилил параметр на 100 результатов, затраты на съем позиций могут взлететь в космос, либо тулзы перестанут отдавать точную сотку — но пока Semrush, Ahrefs и Authority Labs всё еще работают.

Ищи фразы, которые застряли в диапазоне от 20-х до нижних 50-х позиций, и считай количество урлов, которые показываются по каждой.

Semrush показывает страницы, которые ранжировались примерно за последний год, Authority Labs выводит каждый урл с его позицией по ключу.

Несколько страниц, которые ранжируются одновременно, но ни одна не заходит в топ-10, или постоянно меняющийся ранжирующийся урл, означают, что поисковики запутались и не понимают, какая страница официальная.

Точные шаги для исправления:

— Массово разверни мета-теги robots на серии страниц, чтобы не пускать в индекс конкретные папки, дубли и параметры
— Настрой каноникалы, которые декларируют официальную версию там, где есть варианты и дубли
— Перепиши перелинковку так, чтобы интент анкора совпадал с посадочной: "apples" в коммерческом контексте бьет на конверсионную страницу, а в информационном (откуда они берутся) — на статью
— Внедри пул тем, который контентщики согласовывают с SEO перед написанием — чтобы давать дополняющий угол, а не просто рубить статьи

https://www.searchenginejournal.com/ask-an-seo-how-do-i-identify-cannibalization-problems-consolidate-without-loss-of-visibility/553881/

#Cannibalization #TechnicalSEO #IndexCoverage

@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Post #6684 1.35K
За эту неделю ты профукал 10 схем, которые уже дают жирный трафик другим.

Подписчики @MikeBlazerPRO снимают сливки, пока ты ждёшь идеального момента.

Каждый день промедления — это деньги, упущенные безвозвратно.

Вот что ушло тем, кто внутри PRO:

1. Диагностический бэкдор поисковика — как один интерфейсный триггер палит точный момент, когда алгоритм склеил сущности в Графе Знаний без томительного ожидания апдейтов выдачи.

2. Скрытый браузерный инжект для мертвых локаций — как проброс одного параметра в адресную строку Google Maps форсит интерфейс отдать полные права на перенос заблокированной точки.

3. Вечный локальный сигнал вместо спам-прогонов — схема цикличной дистрибуции, которая гарантированно держит ваши данные свежими для нейросетей без классического линкбилдинга.

4. Зачистка выдачи с точностью 99% — как примитивный фильтр из 90-х сжигает килотонны спам-статей на ваших PBN-сетках без единого цента затрат на тяжелые языковые модели Google.

5. 150 000 показов за сутки — как снос одного триггерного маркера в контенте форсит Гугл переоценить ПФ и начать лить трафик.

6. Эксплойт ссылочных анкоров в 2026-м — нетипичный формат бэклинков, который коррелирует с топами сильнее классики и пробивает даже ИИ-выдачу.

7. 50,000 визитов до DMCA-страйка — автоматизированный сетап, который парсит базы регуляторов и регает дорвеи по моментальному отжиму брендового трафика.

8. Один тайтл видео YouTube — один ключ? — как паразитирование на трастовых хабах позволяет одному видео ранжироваться по десятам ВЧ-ключей, которых нет в тайтле.

9. Реверс-инжиниринг локального графа — интерфейсная дыра, которая отдает готовый список ключей для легальной манипуляции отзывами юзеров.

10. Восстановление $19,200 за три недели — пайплаин ИИ-агентов, который без участия человека физически диагностирует деградацию каждой страницы, их фиксит и возращает трафик.
-

Эти эксплойты работают, только пока инженеры антиспама спят.

Проснутся — лавочка мгновенно закроется для всех.

Ты планировал зайти "потом", но "потом" придётся читать чужие кейсы и глазами проважать чужие ламбы.

Действовать нужно на опережение, лучше момента, чем сейчас НЕ-БУДЕТ!

Тасики тикают. Тю-тю
  • ❤ 6
  • 👎 2
  • 👍 1
Older posts →

About this channel

How can I read @mikeblazerx without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Mike Blazer: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Mike Blazer have?
Mike Blazer (@mikeblazerx) has 8.92K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Mike Blazer know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →