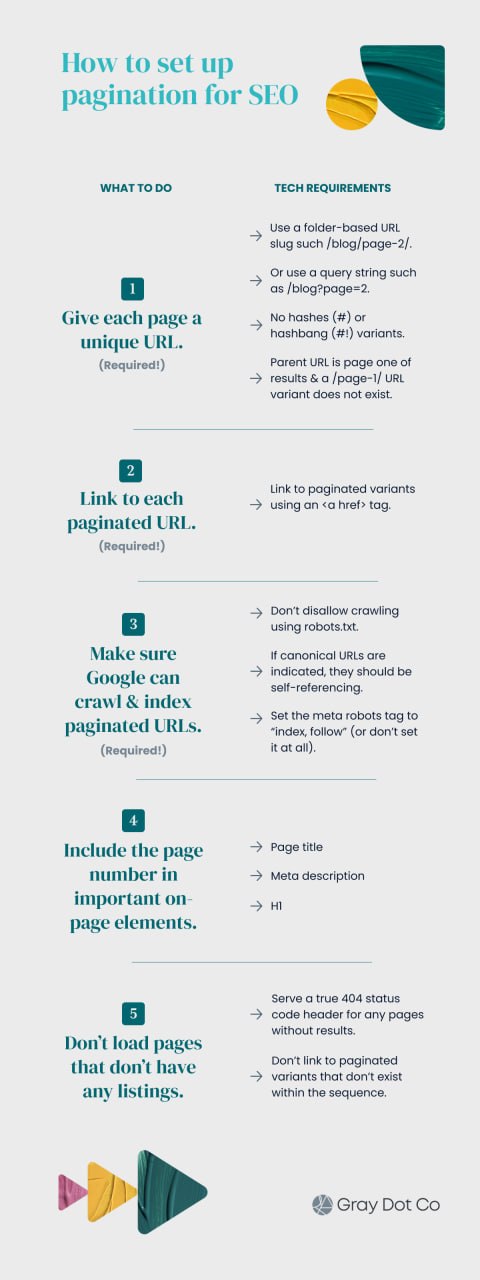
Пагинация вылезает с пугающей регулярностью на сайтах любого размера (одно агентство назвало ее самой частой ошибкой в техничке клиентских проектов), а урон бьет по обнаружению листингов, ссылочному весу и краулингу.
У урла пагинации ровно одна задача: нести краулируемую ссылку на каждый листинг, чтобы Google мог обнаружить эти страницы и перелить на них
PageRank.Каждый сигнал индексации в цепочке — каноникал, мета-теги
robots, наличие в сайтмапе — вытекает из того, стоит ли этот путь краулить.Этот путь существует только в
HTML.Каждому шагу нужен свой урл, слаг или строка запроса — никаких хешей и
hashbang-фрагментов, Google их не поддерживает.HTML-кнопки — это не ссылки, а гуглобот не умеет скроллить, поэтому дефолтные сборки Load More и Infinite Scroll вообще не прокидывают пути краулинга дальше первой пачки.Фикс: настоящая ссылка
<a href>, стилизованная под кнопку, где JavaScript подгружает результаты на лету.Google краулит ссылки
<a href> как в ответе сервера, так и в отрендеренном HTML, но предварительный рендер страницы вообще не гарантирован — это железобетонный аргумент в пользу того, чтобы отдавать ссылки сразу в серверном ответе.Дальше правила каноникалов расходятся в противоположные стороны внутри одной цепочки.
Тег каноникала существует для контроля дублей и частичных копий.
Поэтому вариант
/page-1/, который невозможно убрать из-за технических ограничений и который повторяет те же листинги, что и родительская страница, должен указывать на родителя (во всех остальных случаях родитель должен быть единственным урлом для первой страницы).Страница 2 — это валидная, уникальная страница: она отдает каноникал сама на себя, держит мета-теги
robots на index, follow и никогда не ставит каноникал наверх.Страницы без листингов — обратный случай.
Пустышка
?page=43, отдающая код 200 в серии из трех страниц — это soft 404, который заставляет Google краулить мусорные урлы.Поэтому пустые варианты должны отдавать честный заголовок
404 и лежать без внешних ссылок.Есть два кейса, которые в любом случае оправдывают закрытие пагинации от индекса.
Пагинация по тегам и категориям блога дублирует тайтлы и дескрипшены на малоценных страницах, тогда как основная лента блога уже дает краулируемый маршрут к тем же постам, так что лишние пути краулинга дают убывающую отдачу.
На сайтах с сотнями тысяч или миллионами урлов краулинговый бюджет форсирует жесткое решение:
e-commerce с карточками товаров и страницами отзывов под каждый товар может не вывезти частый краулинг и того, и другого.Ссылки со страниц товарных листингов побеждают, потому что они находят товары и переливают
PageRank, что ценнее, чем краулинг дополнительных отзывов дальше первой страницы.Если вторая и последующие страницы ранжируются выше родительской (что бывает редко и в основном как легаси-проблема энтерпрайза), это закрывается тремя проверками:
— Стоит ли на родителе каноникал сам на себя, и не перезаписывает ли его
JavaScript?— Бьют ли внешние и внутренние ссылки на страницу 2+ вместо родителя? На конкретные варианты пагинации должны вести ссылки только из их собственной цепочки.
— Прокинут ли номер страницы в тайтл, мета-деск и
H1 вариантов пагинации?Затем вычисти сайтмап.
Если снести оттуда всё, кроме родительского урла, Google быстрее поймет, какая страница в приоритете.
https://thegray.company/blog/pagination-seo-guide
#Pagination #Crawling #TechnicalSEO
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO