TGViewer
Channel Public Channel
Сповідь тестувальника

Сповідь тестувальника

@qa_confession

🔹Відверті думки тестувальника.
Автор: Олекса Мащиць.
🔸Підтримати автора або доєднатися до QA КЛУБУ: https://base.monobank.ua/3dHV4RUJM3fVn4
Subscribers
599
Photos
23
Videos
4
Links
25

Showing posts older than #60 · Back to latest

Older Posts 18 shown
Post #59 276
Привіт, мій щоденнику...

Написав коментар до одного допису на DOU, про "ШІ", звісно ж — вайбкодинг та інше створення коду "ШІ"-інструментами. Мабуть, муза якась пролітала поряд, що коментар вийшов дещо художнім. Тому він буде закарбований на скрижалях (здається. муза ще не відпустила) цього щоденнику.

Допис на форумі

Мій коментар:

Ось ще один ракурс.

Якийсь Петро гарно вчився, а потім роками створював... машини, які в апокаліптичному майбутньому забезпечують міста повітрям для дихання.

Якийсь Василь не обов’язково гарно вчився, а потім роками створював вебсайти для інтернет-магазинів (при всій повазі).

Зараз Василь каже Петрові, що ось є новий інструмент, який пише за тебе код, і ти, Петре — мусиш використовувати його для створення нових машин для очищення повітря.

На що Петро каже, мовляв — ймовірно, твої сайти, Василю, цей інструмент і може створювати. У будь-якому разі я не заважаю тобі робити це. Але я краще знаю, чи цей інструмент достатньо професійний для моєї роботи. І наразі — ні, не достатньо. Можливо, в майбутньому. Але не зараз.

Але Василя ображає така відповідь і він починає звинувачувати Петра у різному та писати статті про те, що новий інструмент може замінити Петра вже зараз, а Петро — непотрібний динозавр, який дарма їсть свій хліб.

«Water is for toilets — drink Brawndo! It’s got electrolytes!» (з фільму «Ідіократія»). У фільмі всі вірили в те, що цей напій краще за воду, а отже краще й для поливу сільськогосподарських рослин, що призвело до втрати 100% врожаю. Але як проста вода може бути кращою за чудовий напій? З електролітами ж!

Повірте, Петро дуже адекватний і розуміє, що коли інструмент справді стане кращим за нього, довго цього приховати не вдасться, навіть якщо намагатися. Петро перекваліфікується, але визнає нову правду.

Але поки Петро каже, що інструмент не пасує для його роботи, чому всі (крім колег Петра) намагаються переконати його у зворотному? Бо «містить електроліти!»?
  • ❤ 11
  • 👍 4
Post #58 320
Привіт, мій щоденнику...

Зізнаюся, коли з'явився цей канал, я не думав, що в ньому буде так багато записів про "ШІ". Але все закрутилося, навалилося.... Наче крім "ШІ" всіх зараз майже нічого не турбує.

Втім, наче й сторінка щоденника про тест кейси та чек листи "зайшла" тим, хто "підглядає" тут. Й навіть про ютуб канали.

Насправді, ще періодично в голові крутяться деякі теми з пайтон, типу "тернарний оператор у пайтон та чому він насправді не є тернарним оператором". Або "як нас надурили з поліморфізмом в ООП".

Хоча зрозуміло, що від "ШІ" ми нікуди не подінемося, а відповідно — від рефлексії на сторінках цього щоденника також.
  • ❤ 11
  • 👍 6
Post #57 364
Привіт, мій щоденнику...

Ще не так давно як був переконаний, що є попит на поради що до українського контенту, але зараз розумію, що ні. Бо контенту навалом і єдина причина, чому хтось роками повторює, що його немає — він не шукає.

А значить, немає справжньої зацікавленості. А значить, поради не змінять ситуацію.

Проте, я досі можу ділитися чимось без оцієї мішури — відчуття потреби у моїх порадах. Та й взагалі, це лише допис у щоденнику, чи не так?

І раптом хтось прочитає цю сторінку щоденника, то ось:

Канал "УТ-2" з низкою різних форматів, серед яких найбільш технічним є mvc. Ведучі різнобарвні, інколи навіть трохи "бісять", але контент відмінний. Інші формати менш технічні, але часто унікально цінні з просто чудовими гостями.
https://www.youtube.com/@yt-2

Канал "Шо по коду?" напроти — не пропонує нічого не технічного, що легко читається з його назви. Це подкаст з інженерами, які по справжньому люблять свою справу і копирсаються в цікавих (але часто дуже технічних) аспектах технологій, що може бути цікаво навіть якщо слухач не знайомий з ними усіма.
https://www.youtube.com/@shopokodu

На мою думку, це приклади українського технічного та навколо-технічного контенту найвищої якості. Це означає, що в цьому випадку "закордонні аналоги" не мають жодної переваги перед ними. Це реально топ.

А чи вважати цей допис, що починається з "Привіт, мій щоденнику..." порадою? А у кого я тоді питаю?..
  • 👍 21
  • 😁 3
  • ❤ 1
Post #56 330
Привіт, мій щоденнику...

Дуже популярною помилкою у навчанні тестування, а потім і у роботі є не розуміння різниці між суттю та формою. Яскравий приклад тут — чек лист. Його лаконічна форма не є його суттю, хоча й майже завжди є формою чек листа.

Якщо ми просто скоротили тест кейс до одного пункту чи рядка у таблиці, наш тест кейс не перестав бути тест кейсом, не перетворився на чек лист. Чому? Бо ми змінили форму, але не суть.

У статті на DOU розглядається це питання, але традиційно — з зазначеною помилкою.

Я залишив розгорнутий коментар до цієї статті.

Головне:

- чек лист не описує перевірку та з нього не випливає очікуваного результату, бо пункт чек листа описує групу перевірок, конкретний список яких та відповідні очікувані результати залишаються на розсуд досвідченого тестувальника.

- тест кейс же є буквально тестовим випадком, доволі конкретним, за яким стоять кроки (навіть якщо вони не описані детально) та очікуваний результат (навіть якщо він не формалізований письмово).

Тобто, "Перевірити автентифікацію" є пунктом чек листа, а "Перевірити, що валідні логін та пароль дозволяють увійти" є тест кейсом. Останній може виглядати навіть як "Перевірити валідні логін+пароль" — форма схожа на чек лист, але суть залишилося як у тест кейса.

В цьому сенсі наявність описаних кроків є також формою тест кейса, але не його суттю. І нехай нікого не бентежить, що у чек листа кроків взагалі ніколи не буває. Тут не працює логіка "якщо у чек листа не буває кроків, то їх відсутність завжди вказує на чек лист". Ні.

Просто існують тест кейси різного рівня деталізації.

Чому тут не дихотомія (або-або) з кроками? Бо протиставлення тест кейсів та чек листів — штучне, і саме воно заважає правильно сприймати ці дві сутності. Викиньте дихотомію, не протиставляйте їх, й вам стане простіше.
  • 👍 16
  • ❤ 3
Post #55 351
Привіт, мій щоденнику...

Світ IT змінюється не лише через активне використання мовних моделей, хоча вони, здається, впливають на все.

Вчора NVIDIA релізнули DLSS 4.5 (вже доступно) та 6х Frame Generation (тут лише анонс, реліз навесні).

До чого це я? Ось яка схема вимальовується. ШІ-компанії масово скуповують пам'ять, що впливає на роздрібний ринок. Якісна сучасна оперативна пам'ять вже зросла в ціні у три рази. Туди ж тягнуться сучасні ssd. Це спричиняє й дорожчання відеокарт, а що відчутніше — то павзу у випуску нових серій. Висока ймовірність, що у 2026 році їх просто не буде.

І ось тепер повертаємося до нових релізів софта від NVDIA. Річ у тому, що DLSS 4.5 та FG 6x обіцяють доволі відчутне покращення якості та продуктивності на вже наявному залізі, хоча й не для всіх серій. Тобто, ринок тепер виглядає трохи інакше. Типу — нащо вам нова модель відеокарти, якщо вчорашня "стара" після оновлення працює як ймовірна "нова"? Або у моделях: навіщо вам нові Ti та Super версії, якщо ми вже наявні моделі покращуємо безплатно?

А що до професійного використання, то це оновлення торкається не тільки ігор, але й роботи з локальними ШІ: стосується як генерації зображень, відео та 3D, так і роботи з малими мовними моделями тощо.

Останнє особливе цікаво, бо неприємно спостерігати, як користувацький ринок потерпає від дефіциту чипів через ШІ, але ця "плюшка" — наче "Ось, дивіться — ми поділимося з вами частиною того, що відібрали та вклали у розвиток ШІ".

Поки це лише моє враження, не бачив у NVIDIA прямих натяків та це. Але враження склалося.
  • 👍 4
Post #54 420
Привіт, мій щоденнику...

Ось тест на адекватність згенерованого «ШІ» коду. Він полягає у питанні: «Чи дозволили б ви, що хоча б частину ПЗ, що керує вашим серцевим стимулятором, написав би "ШІ"?». Чи готові ми віддати створення такого коду «ШІ», чи вважатимемо надійнішим код та алгоритм, який первинно виник в голові людини та далі пройшов всі етапи перевірки якості, які також керовані людиною? З відповідальністю, що цілком лежить на людях, що були залучені у процес?

Цей тест не має на меті переконати, що ми повинні негайно припинити генерувати код за допомогою «ШІ». Він пропонує тверезий погляд на якість коду та всього програмного забезпечення.

Варто сказати, що це призведе нас до підходу, який ми вже використовуємо в роботі. Адже ми постійно йдемо на компроміси перед релізом та допускаємо певну кількість ймовірних багів. Ми оцінюємо ризики й вони увесь час різні в різні періоди життя продукту. Різні для різних продуктів.

Отже, я не пропоную нічого нового. Це гарний підхід, який довів свою ефективність. Це коли ми давали частину роботи фахівцям одного рівня, а іншу частину — фахівцям іншого. Тобто йдеться про правильний процес розробки. А отже, при використанні «ШІ» нам варто так само оцінити ризики та не боятися прийти до того, що певну роботу ми ніяк не можемо віддати йому. Принаймні на даний час.

А питання про код для серцевого стимулятора допоможе тверезо дивитися на якість та знаходити правильний баланс у використання «ШІ»-інструментів.

Пригадаємо часи, коли розробники з Індії масово закидували нас своїм кодом. Його було багато, частина з нього працювала добре, але велика частина — ні. Вони брали кількістю, не якістю. А ще низькою ціною. Нічого не нагадує? Адже ми й раніше просто повертали поганий код до колеги з Індії й він переписував його ще і ще, поки код не проходив рев'ю. А тепер нічого не нагадує?

Звісно, таке порівняння доволі грубе і не претендує на наукову суворість. Але воно непогано підкреслює певні принципи взаємодії з генераторами коду.
  • 👍 8
Post #53 486
Ідеальний текст (цитата) та історія для різдвяного допису в цьому каналі.

У грудні 1989 року я шукав «хобі»-проект з програмування, який би зайняв мене протягом тижня навколо Різдва. Мій офіс (...) був закритий, але у мене був домашній комп'ютер і більше нічого.

Я вирішив написати інтерпретатор для нової скриптової мови, про яку я останнім часом думав: нащадок ABC, який би сподобався хакерам Unix/C.

Я вибрав Python як робочу назву для проекту, перебуваючи в дещо нешанобливому настрої (і будучи великим шанувальником «Летючого цирку Монті Пайтона»).


Гвідо ван Россум
  • ❤ 15
Post #52 553
Привіт, мій щоденнику...

Подумав про життєздатність тези "Тепер фахівці мають перевіряти за ШІ, а не робити самі". Це напрям, в якому рухають "ШІ" компанії, що розробляють мовні моделі, а отже варто подумати, як ми будемо працювати у майбутньому.

Першим в приціл потрапляють тестові артефакти, насамперед такі, як чек листи та тест кейси. А якщо казати про автоматизацію, то майже увесь код.

Нам кажуть, що ми більше не маємо робити це власноруч, а лише перевіряти, наскільки коректно зробила цю роботу модель.

Поки залишу без уваги чек лист, який для мене серйозніший документ, ніж тест кейси, бо сильно залежить від експертизи як його творця, так і його виконавця. Це не спрощена версія тест кейсів, не те що ми робимо, коли не маємо часу на повноцінні тест-кейси. Залишимо в стороні зараз.

Повертаємося до тези про те, що "ШІ" робить, а ми перевіряємо. Розкриємо механіку процесу. Якщо казати про час "прямо зараз", то йдеться про те, що в галузі повно досвідчених фахівців, які мають достатню експертизу для такої перевірки. Гаразд, припустимо, ми спробуємо працювати в такому стилі.

А інші? Що до новачків у галузі, які мають замінити нас? Вони не мають такої експертизи, отже не можуть й перевірити роботу мовних моделей.

І тут ми підходимо до ядра — освіти та навчання. Який тренд на разі в освіті, особливо у "епоху ШІ"? Як казав класик: "Забули? Я вам напам'ятаю!".

Тренд наступний. Навіщо вчитися "по старому", особливо коли йдеться про "рутину"? А рутиною є створення тестової документації та коду для автоматизації. Коло замкнулося. Адже це саме те, що нам пропонується більше не робити, як фахівцям. А молоді фахівці більше не хочуть цьому вчитися. Вони хочуть одразу генерувати таку роботу моделями. Вони довіряють моделям. А який у них вибір, якщо дві такі важкі тези давлять?

Випишу окремо
1. Багато роботи є "рутиною" та люди мають припинити робити її та віддати "ШІ"
2. "Старий стиль" освіти та навчання поганий, бо багато чого тепер робить "ШІ" (який, на думку, наприклад, Сема Альмана, вже перевершив інтелектом доктора наук)

То що виходить? Знову звернуся до класика: "Не кожен може у завтрашній день сматрєть".

Друзі, запропонована нам схема не є життєздатною, вона зламана. Чи існують інші схеми, до яких особисто я ставлюсь позитивніше? Так, я маю кілька (адже критика не дорівнює заперечення). Але подібних схем я (майже) не бачу в інфопросторі, особливо від засновників ШІ-компаній.

Зараз я бачу, що досвідчені фахівці використовують "ШІ"-інструменти зовсім не так, як новачки. Тобто, це розділення вже відбувається. І всі, всі фахівці погодяться зі мною, що саме їх експертиза, їх освіта дозволяє їм "витягувати" з "ШІ" те, що вони витягують та помічати важливі помилки й знаходити кращі підходи до використання "ШІ" в роботі.

Без "старомодних" людських знань ви не зможете професійно користуватися "ШІ" ані зараз, ані у майбутньому.
  • 👍 13
  • ❤ 4
  • 🔥 1
Post #51 374
Привіт, мій щоденнику...

Залишилося непомітною думка Александра Ембірікоса, який очолює розробку Codex (агент для програмування від OpenAI). Ця думка є доволі небезпечною та заходить у царину тестування, принаймні первинного тестування коду, як мінімум.

Пан Ембірікос вирішив подивитися на проблему колаборації людини та ШІ-агентів радикально та звинуватив у гальмуванні продуктивності... людину. Мовляв, людина заповільно або друкує на клавіатурі, або перевіряє код — все це дуже повільно та не дає ШІ-агентам працювати на всю міць.

Який вихід пропоную Абрикос? Тобто, Ембірікос (це ж жарт у щоденнику та його ніхто не побачить, адже так?).

Він каже, що треба звільнити людей від необхідності писати підказки та перевіряти роботу "ШІ".

Ще раз: людина не має перевіряти роботу "ШІ" за думкою розробника агента для написання коду.

А хто має перевіряти? Відомо хто — інший ШІ-агент. І тут у мене почало витягуватися обличчя. Тобто, ми ж таким чином визнаємо, що агенти для генерації коду потребують перевірки цього коду. Розуміємо, що ітерація за ітерацією таких агентів не розв'язує глобально цю проблему, як ми не намагаємося.

Ми визнаємо, що генерація гарного та комплексного коду важко дається агентам.

Чому якийсь інший агент має побачити недоліки у такому коді, якщо агенту-творцю це не під силу? Чому не поєднати їх в один "правильний" агент?

Висловлювання тих, хто зараз керує розробкою "ЩІ"-штук стають чим далі, тим більш не логічними. Не всі, звісно. Але відсоток дивних думок збільшується.

І перманентно для мене стоїть одне питання, на яке нікому не цікаво відповідати. Чому ми так гарячкувато та хворобливо-несамовито бажаємо створити штучну людину, по суті, та відібрати у живих людей роботу? Мені дійсно цікаво, що думають про це люди, бо в статтях та інтерв'ю про це ані слова.
  • 👍 15
  • ❤ 2
Post #48 562
Привіт, мій щоденнику...

Як там наша славетна увага до деталей?

Дивлюсь я відео одного пана про "ШІ", звісно ж. І бачу графік, що демонструє перевагу нової моделі Opus 4.5 від Антропік. Й помічаю у лівому нижньому кутку графіка цікавий символ, до якого я придивився. Бачу, що вертикальна шкала починається лише з 70%, а отже частину графіку від нас приховали.

Це графік з офіційної новини Антропік, якщо що, я перевірив.

При чому цікаво, що пан на відео каже, цитую "він вирвався на 10-15 відсотків від своїх конкурентів", хоча це не так ані по цифрах, ані візуально. По цифрах — значно менше, візуально — значно більше.

Ну, прикинув "на око", ну ось таке в нього око. Яка різниця, правда? Олекса нудний, чіпляється до несуттєвого.

Але ж це і створює у більшості людей хибне уявлення про реальність, в нашому випадку про моделі для програмування.

Я створив власні графіки, при чому вони обидва використовують ті ж дані, вони реальні. Але я також "погрався" з вертикальною шкалою, щоб наочно показати, як буде змінюватися візуальне сприйняття ОДНАКОВИХ цифр залежно від представлення.

Графік 1 показує реальні показники та візуальну різницю між моделями, бо починається від 0%, отже ви бачите всю "вагу" метрики.

Графік 2 драматизує візуалізацію зі звіту Антропік, бо починається від 74%, що робить найнижчий показник зовсім крихітним, а закінчується на 81%, що робить найвищий показник таким, що височить над іншими.

То як у нас з увагою до деталей? Річ у тім, що вона є дуже некомфортною для повсякденного життя, бо ми не можемо жити з постійним відчуттям недовіри до інформації, що оточує нас. Далі ми переносимо таку звичку й у професійне життя і все менше аналізуємо, все більше віддаємося емоціям та довіряємо тим, кому просто хочемо довіряти.

Це вбиває у фахівці інженера.

То що там показники? Ну, різниця між двома лідерами становить 3%.
  • 👍 18
  • 👏 2
Post #47 561
Привіт, мій щоденнику...

Тут Coca Cola випустила своє щорічне відео і воно повністю згенероване ШІ. Але є нюанс.

Над проєктом відео довжиною рівно у 1 хвилину працювало 100 людей, серед яких 5 спеціяльно запрошених ШІ-фахівців, які згенерували промптами 70 тисяч(!) відео кліпів, з яких зібрали фінальний результат.

Чи сподобалося відео людям? Під офіційним відео на ютуб зараз 5.7 тисяч вподобайок та 78 тисяч не-вподобайок.

Це цікава ситуація і хочеться проговорити її вголос. Мета не у тому, за що зо я топлю — не за результат. Це "спорт" експериментів, де 100 людей та 70 тисяч згенерованих відео чомусь мають виглядати як рекорд та підкреслювати сучасність компанії. Але схоже, це має зворотний ефект.

Думаю, що не помилюся, якщо припущу, що це відео коштує значно дорожче за попередні із "традиційним" підходом.

Видається, мені варто змиритися з тим, що багато хто хоче використовувати "ШІ" просто тому, що це "ШІ", через певне неконтрольоване та неусвідомлене бажання. Приблизно так само, як і створення людиноподібних роботів, які нічого не роблять, але мають дуже схожу ходу (як останній китайський робот) — абсолютно не функціонально, але ми просто дуже хочемо створити штучну людину, ось і все. Від цього дещо моторошно.

Варто задуматися, чи є сенс наводити раціональні аргументи для тих, хто керується не раціональними мотивами.
  • 💯 13
  • ❤ 5
Post #46 572
Я оберігаю цей канал від реклами, навіть самореклами, бо такий у нього формат. Проте було б дивним не пригадати, що завтра стартую свій курс "Програмування та WEB для QA". Він цілком вписується в концепцію того, про що я пишу тут. Ґрунтовне розуміння важливих для айтівця речей тощо.

Завтра вже будемо стартувати.
QA Україна ED Програмування та Web для QA Курс з Програмування та Web для QA
  • ❤ 8
  • 🔥 4
Post #45 744
Привіт, мій щоденнику...

Не так давно писав про покращення ChatGPT у роботі зі зображеннями, коли він навчився перемальовувати частинами, залишаючи інші місця повністю незмінними. Це впливало й на швидкість. Такі зміни робилися у кілька секунд.

Скільки минуло часу, 2-3 тижні?

Ось останній апдейт.
Все повернулося назад. Виправити одну літеру тягне за собою помилки в інших. Навіть коли зміна потрібна лише в одній літері, навіть якщо прямо це вказувати — змінюються форми та деталі тих частин, яких зміни не торкаються.

Все той самий пакет Plus. Та сама модель. І ось ще "вчора" я думав, що навчився малювати так, як мені треба, а сьогодні все це перестало працювати.

І я маю що сказати на аргумент "Це ти не вмієш, це ти не знаєш". Гаразд, а яким був сигнал, що зміни відбулися? Новий реліз? Ні. Як це відстежувати? І де шукати інформацію про подібні зміни?

Ніде, бо таких джерел немає. Ми лише здогадуємося про ймовірності. Ще раз. Здогадуємося. Ймовірності.

В цьому одна з базових проблем мовних моделей: їх роботу неможливо осягнути, при чому проблема не вирішиться навіть якщо заглиблюватися в тонкощі про токени, температуру, структуровані запити та промпт інжиніринг.

Кожен, хто регулярно користується ChatGPT розуміє, про що йдеться. Він просто інколи змінюється. Коли це станеться, що тому причиною та як довго буде тривати нова поведінка — завжди невідомо.

І ось ця невизначеність робить його дуже поганим робочим інструментом для тестувальника.

Однак, він все ще корисний. Але мені здається, кожен буде знаходити щось дуже своє у тому, яку користь даватиме мовна модель. І я скажу вам — ця різноманітність, вона через те, що мізки у всіх різні, і що саме у симбіозі мозок+LLM можуть бути цікаві результати.

Головна теза: в жодному разі не довіряти чатботу!

Якщо вам вдасться знайти до нього підхід крізь призму отакої недовіри. то саме тут і лежить користь у його використанні.
  • 👍 15
  • ❤ 4
Post #44 577
Привіт, мій щоденнику...

Скажу відверто, що останньою краплею для того, щоб я повністю перейшов у публічне поле та самостійну справу стала велика війна московії проти України.

Але це для вступу, йдеться не про мене. Я намагаюся дивитися дещо зі сторони на те, що відбувається в українській спільноті тестувальників. Я її частина.

Я бачу, що зараз чи не найбільша активність, принаймні з боку публічних лідерів та організаторів. Я пам'ятаю, як раніше ми відвідували професійні конференції, що робили росіяни. На одній такій я був у Києві у давніх 2010-х. Руколь, Баранцев, оце все. Бачите, досі пам'ятаю.

А наші що? Нічого (майже) не було.

Але не тепер. Тепер часто виникає питання "А що обрати?". Ініціативи виникають як "знизу" (попре бренд "QA Україна" я зараховую себе в цю ж категорію), так і "зверху", від таких монстрів бізнесу, як DOU.

Авдиторія? Як на мене, тут зростає пасивність. Люди бажають максимально приховати свою присутність, а будь-який публічний прояв у багатьох викликає паніку. Це не звинувачення, але констатація реальності. Важко звинувачувати у чомусь людей, які живуть під щоденними вибухами ракет та дронів.

Така активність зовсім не допомагає тим, хто організовує щось для спільноти. Тим більше вони заслуговують на повагу. Адже зі слабким зворотним зв'язком це стає схоже просто на віру. Ти не знаєш реакції, лише сподіваєшся. І робиш.

Не знаю, скільки це триватиме. Але бажаю усім колегам розвитку і навіть того, щоб ми почали бачити один в одному конкурентів. Це означатиме реальне життя та еволюцію спільноти. Скажу також, що не йдеться про ворожнечу, але про вдячність. Крок колеги вперед спонукає й тебе не сидіти склавши руки. Тому нам потрібна ця конкуренція, щоб вижити, жити та вдосконалюватися.

Зверніть увагу на те, що зараз відбувається у спільноті. І підтримайте тих, хто викликає у вас симпатію. Вони того варті.
  • 👍 14
  • ❤ 8
Post #43 411
Привіт, мій щоденнику...

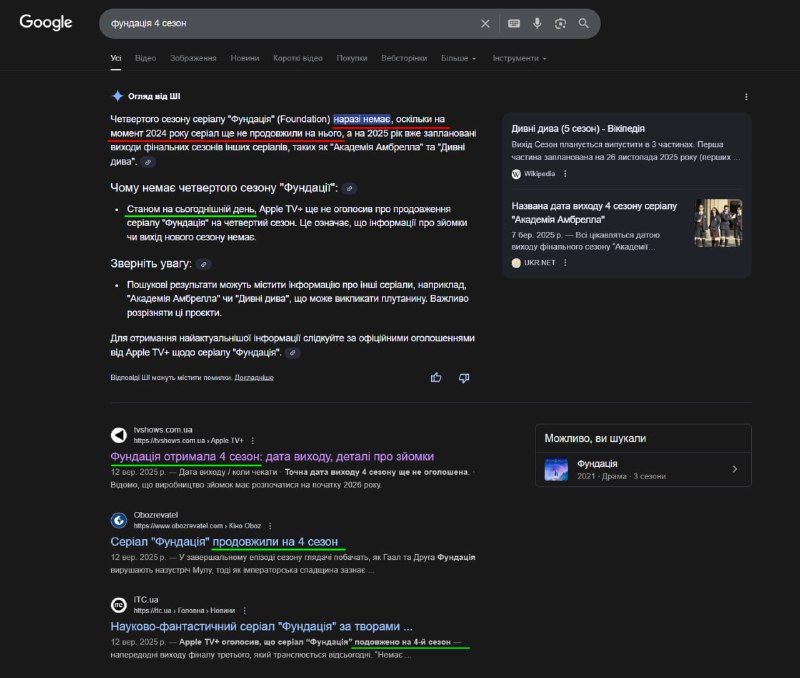
Нещодавно десь писав про те, що вбудований Gemini у пошук Google виглядає доволі корисною функціональністю. А тому я не можу не зафіксувати й мінусів.

О, ви скажете — так собі диво, адже недоліки є всюди, тільки забажай та знайдеш. І я погоджуся. Тому акцент ставлю не на факті наявності недоліків, а на їх природі та наслідках.

На зображенні мій пошуковий запит і те, що я отримав у відповідь. Робимо висновки:
- чатбот «прикручений» не інтегровано, він користується дампом даних, які завжди десь у минулому.
Це не таємниця, просто запитайте у свого чатбота, чи користується він таким дампом та за яку він дату.

- навіть якщо контекст дуже поширений, а інформація вже загальновідома, чатбот не застрахований від помилок.Але у нашому випадку причиною є попередній пункт.

- більшість користувачів сприймають вбудований чатбот як пошук, але він нічого не шукає, як це робить Google, це гарно видно на скриншоті. Але Google чи OpenAI не поспішають з правильним позиціюванням, часто замовчуючи механізми роботи.

Головне та неприємне для мене — ми не можемо бути впевнені навіть у простих речах, коли йдеться про генеративні мовні моделі. Якщо ж ви скажете, що треба перевіряти відповідь, то я відповім: і навіщо тоді людям користуватися цим? Тобто, якщо я маю перевірити відповідь про 4 сезон серіалу, то нащо мені взагалі дивитися на відповідь Gemini?

Отже ми не можемо перевіряти 100% відповідей чатботів, бо це зробить їх використання у багатьох випадках непотрібним.

П.С. Бонусом розкажу ще одну історію. Коли Gemini сказав мені: «У моделі А гучність більша за модель Б» і далі в цьому ж тексті зробив висновок, що «У моделі Б гучність більша за модель А». Йшлося також про дуже поширену в інтернеті інформацію, віком декілька років. Але щось пішло не так.

Ще раз: мова не про помилки, як такі. Йдеться про помилки в елементарних речах! Тепер уявіть, як це може впливати на комплексні теми та вужчу специфіку.
  • 👍 8
  • ❤ 3
Post #42 438
Привіт, мій щоденнику...

Нова функціональність у YouTube, яка перекладає відео різними мовами та додає відповідні звукові доріжки. Кожен раз, коли я бачу розмови про це — це захват. Мовляв, ця технологія все змінить, можна не вчити мови, можна дивитися будь-що.

Але якщо поставитися до цього як справжні тестувальники?

Річ у тім, що мовлення це сильно більше, ніж текст.
Річ у тім, що мови не перекладаються слово у слово, бо це не так працює. Отже, гарний переклад це доволі складна задача, хіба що йдеться про елементарні конструкції.

Отже, ми маємо спробувати зрозуміти, чи переклад, скажімо. на англійську справді настільки гарно звучить для англомовних людей, щоб вони спокійно та із задоволенням дивилися б такі відео? І тут на нас очікують сюрприз.

Інтонація, голос, коректність перекладу та наголосу — це складно і все це робить нова фіча вкрай погано.

Мій свіжий тест тут — це переклад з англійської на українську. Це жах жахливий. На відео два чоловіки, але голос змінився 4-5 разів, включно з жіночим. Змінювалася швидкість голосу. Помилки у наголосі. Все це робить сприйняття хоча б мінімально серйозної інформації вкрай важким. Я б сказав, настільки, що можна вважати це нереальним.

І тут можна багато рефлексувати й про інші фічі, адже це типова людська помилка (і тестувальники не є виключенням), коли ми не можемо подивитися на речі очима інших. Це не лише щось психологічне, а потрібно ще й бути доволі різнобічно обізнаним про світ, щоб мати таку навичку. А різнобічна обізнаність у сучасному світі маргіналізується.
  • 👍 13
  • 💯 1
Post #40 452
Тут MIT та Microsoft зробили дослідження та кажуть, що краще не використовувати JSON для промптів до мовних моделей.

Цікаво тепер ретроспективно дивиться на нещодавну кучу дописів про JSON з шаблонами, що розліталися як гарячі млинці.

Отже, краще для запитів до мовних моделей пасує XML.

При чому, інформацію саме про markdown формат можна побачити в самій документації CharGPT.

Але ось де заковика. Хотіли ж не вчити того всього, писати людською мовою, отримувати результат, як профі. А тут тобі: JSON, XML, документація…

Отакої!

П.С. Напевно, варто додати, що я натякаю на те, що краще все ж навчитися нормально айтішці, а не покладатися на мовні моделі як заміну навчанню (бо типу нащо вчитися, якщо «ШІ» і так зробить все за тебе)
  • 👍 11
Post #39 429
Привіт, мій щоденнику...

Нещодавно був приємно здивований тим, що ChatGPT навчився вносити зміни у згенерованому зображенні, змінюючи лише потрібні області та не чіпаючи решти. Звісно ж, це ще й швидко.

Таке вибіркове редагування було раніше недоступно для «ШІ», з приводу цього купа мемів створили, як зображення змінюється з кожною редакцією і людина божеволіє від того, скільки змін відбувається попри те, що вона їх зовсім не хоче.

А ще він навчився не помилятися у тексті на зображеннях. Наче. Наче я бачив це на власні очі.

Але не сталося, як гадалося.

Як тільки я спробував задачі складніше, чатбот повернувся до старої пісеньки.

Я спробував зафіксувати жорстку схему. Спочатку створив об'єкти та їх різні види, зафіксував їх з чатботом, дав назви. Намалював чітку схему розташування. Дав опис зображення: послідовно, враховуючи раніше зафіксовані об'єкти та схему.

Одним словом... комплексні зображення = старі проблеми. Навіть помилки у текстах. При чому виправити ці помилки важко. Кажу: треба не «ик», а «як», і він виправляє на «ік». І змінює об'єкти. І схему.

Повернулося все: маленька зміна тягне за собою купу інших.

Звісно ж, я створив окремий проєкт для цієї вузької задачі.

Ось звідки у мене береться критика чатботів про їх нестабільність та непередбачуваність. Я розумію, що багато людей при першому контакті загоряються захватом неофіта і поспішають вихваляти "ШІ". Однак отакий перший дотик це лише вітрина, адже прості речі не є показовими та не пасують для серйозної професійної роботи, де поведінка стає вже зовсім іншою.

Так, тут можна йти далі і працювати гібридно. Генерувати частинами, збирати власноруч десь у редакторі. Чому б ні? Але ж так ніхто не хоче, бо магія зникає — треба щоб запит написав і результат отримав.

П.С. Ось що робить критик масового захвату "ШІ". Постійно тестує його можливості. Саме критики найбільше зацікавлені у тому, щоб об'єкт критики працював якомога краще, адже вони випробовують його в слабких місцях, а не вибірково показують тільки кращі. Звісно, йдеться про аргументовану критику, а не емоційний хейт.
  • 👍 11
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →