TGViewer
Channel Public Channel
Marat @ Predictable.Team

Marat @ Predictable.Team

@predictableteam

Привет! Я Марат, Agile Coach в финтехе на 50 команд в ядре банка.
В этом канале пишу про процессную культуру и метрики в айти и не только, фасилитацию, бизнес, изменения и системный подход.
Если вы в Уфе, приходите ко мне в ufaitcoworking.ru :)
Subscribers
408
Photos
131
Videos
8
Links
110
Recent Posts 16 shown
Post #205 241
Плохие новости к пятнице: учёные, кажется, реабилитировали митинги.

🔥 А вы "горите" от обилия созвонов на работе?


Пока вчера пытался вылезти из под двухнедельного завала работой, посмотрел на календарь следующей недели и стало плохо - просто от предвкушения предстоящих митингов.

Мои коллеги практически на любой работе мучаются от количества митингов. Мемы про "коллеги, давайте устроим короткий созвон на 3 часа" вы тоже, наверняка, видели. Я всю жизнь работаю на удаленке, казалось бы уже толерантность должна быть повышенная ко встречам, но также мучаюсь.

📚 Решил коротко задать вопрос perplexity - есть ли какие-то исследования, которые подтверждают что лучше общаться текстом (и вдумчиво дать контекст), или все же (как минимум у меня в менеджменте) - лучше все голосом (есть ведь невербальное поведение, которое тоже надо считывать + намного быстрее вопросики решаются). И вот, пока мы тут с вами страдаем, вышло прикольное исследование, которое говорит что "не все так однозначно".

👩‍🔬 Чуваки посмотрели на данные более 9 000 работников в Норвегии и обнаружили, что время на встречах оказалось самым сильным предиктором роста зарплаты среди изученных рабочих активностей - сильнее сфокусированной работы, обучения и почты. Даже метафору придумали - назвали митинги «брокколи работы»: обычно не любишь, но полезно.

Это, конечно, корреляция. Наверное, можно поэкспериментировать: ставить ежедневные синки по несколько часов и ждать, пока придет повышенная зарплата (или 1:1 с начальством (главное, не 1:1 с начальством и HR)). Судя по исследованию, работает не магическая сила забитого outlook/google calendar, а доступ к контексту, более опытным коллегам и знаниям, которые плохо путешествуют по таск-трекеру.

Такие дела. Теперь вместо того, чтобы написать коллеге вопрос, с контекстом, обдуманно, - наверное буду тупо ставить встречу.
  • 🔥 5
  • 😁 1
  • 😱 1
Post #200 355
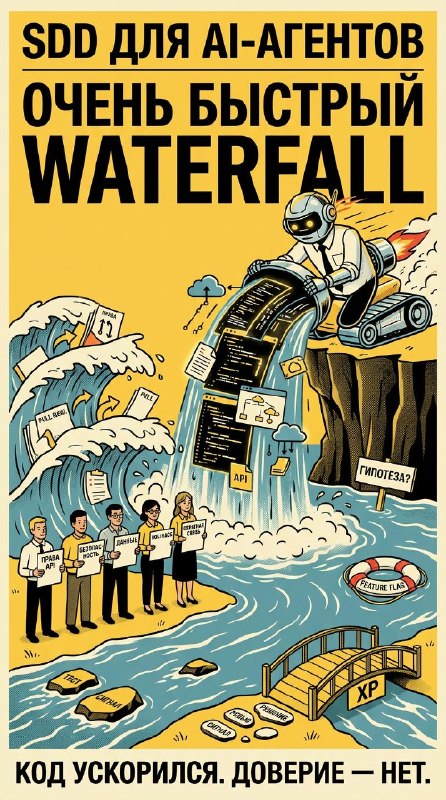
🤦 Spec-Driven Development (SDD): хотели как лучше, а получили молниеносный Waterfall

Ситуация: команда нашла подробную документацию API для compliance. За спринт собрала удобный адаптер с помощью кодинг-агентов - хоба, и им уже заинтересовались коллеги!

А в следующем спринте выяснилось, что API — внутренний инструмент с доступом к сырым данным. Другим командам пользоваться им нельзя. Сервис и два спринта разработки пришлось списать.

📰 Это один из кейсов, которые мы насобирали в Райфе в новой статье про SDD для AI-агентов. Агент быстро превращает спецификацию в код, тесты и инфраструктуру. Но очень часто мы и сами до конца не понимаем всю специфику данных, безопасности или реальной потребности пользователя. Чем выше скорость генерации, тем дороже ошибка в выбранном направлении.

В статье -> о том, как использовать SDD для ближайшего проверяемого шага: зафиксировать критическое предположение, способ проверки, границы задачи и того, кто принимает решение.

И как в типовых задачах спецификация становится накопленным знанием команды: контрактами, примерами и шаблонами тестов.

👉 Полный разбор на Хабре
  • ❤ 8
Post #199 420
☕️ Пятничный кофе — хорошая метрика активности: чашка показывает, что ты проснулся. Про сделанную работу она ничего не говорит.

🪙 С токенами в AI похожая история. Дашборд показывает, что инструментом пользуются. Всё.

Дальше виден сдвиг в работе: PR растут — очередь часто переезжает в ревью. Агент экономит время — и добавляет проверку, интеграции, поддержку. Смена модели превращается в маленький релиз с феерверками тестом, наблюдением и владельцем решения.

В новом Human Loop Weekly — почему расход токенов показывает температуру, а результат стоит искать в пути задачи до пользователя.

https://maratkee.com/ru/thehumanloop/2026-08-24-ai-management-digest/
  • ❤ 1
  • 💯 1
Post #198 261
Когда AI-native превращается в план сократить людей

Кейс Meta (признана экстремистской организацией и запрещена в РФ) из спецрепортажа Reuters — хорошая проверка разговоров про AI-native и маленькие команды.

По данным Reuters, в январе Meta запустила Project OT (Organisational Transformation). Компания обсуждала более компактные команды и больше работы, которую берут на себя AI-инструменты и агенты. В наиболее радикальных сценариях размер некоторых команд мог сократиться до 60%. Реорганизацию планировали провести двумя волнами — в мае и ноябре.

20 мая Meta сократила 10% сотрудников. Ноябрьскую волну затем отменили. Reuters не удалось установить, почему именно Цукерберг изменил курс.

Внутренние данные рисовали сложную картину. Изменения кода на внутренних платформах выросли на 220% год к году. Изменения, которые дошли до пользователя, — на 36%. Число крупных технических инцидентов и инцидентов безопасности, по этим данным, выросло на 40%, а время на их устранение — на 70%.

Кода можно писать больше и быстрее. Дальше остаются ревью, тестовые среды, безопасность, релиз, эксплуатация и проверка эффекта у пользователя. Если эти части системы не выдерживают темп, работа скапливается в следующей очереди или качество компрометируется.

Это ровно то, о чём я недавно писал про tiny teams. Маленькая команда жизнеспособна там, где вокруг неё уже есть платформа, автоматические проверки, понятные решения и быстрый доступ к нужной экспертизе.

AI-native — это устройство всей системы работы. Штатное расписание из трёх человек само по себе им не становится.

Полный кейс Reuters
  • 🔥 5
  • ❤ 2
  • 💯 1
Post #197 527
⚡️Сегодня у нас с вами холиварная тема!

Микрокоманды из трёх человек с AI-агентами способны заменить обычную продуктовую команду — и значит нам столько больше не нужно?


🤝 Такой вывод, если сильно не вчитываться в кейсы, можно сделать об ускорении разработки: меньшим составом удаётся выпускать тот же объём работы.

👉 Я разобрал этот тезис в новой статье на Хабре.

Картина сложнее. Публичных исследований, которые показывали бы преимущество микро-команды, вооруженной AI над обычными кросс-функциональными командами в широком масштабе, пока нет. Но уже понятно, от чего зависит жизнеспособность команды из двух-трёх человек.

Важны сложность системы, распределение знаний, цена ошибки и поддержка вокруг команды.

У истории «три человека сделали продукт» часто есть продолжение за кадром: CI/CD, платформа, автоматические проверки, инфраструктура, а также специалисты по безопасности, данным и праву. Всё это кто-то создавал и поддерживает.

📰В статье — данные CircleCI, границы публичных кейсов и диагностика для руководителя: подойдёт ли микрокоманда вашей задаче.

- Короткая версия на Хабре
- Полная версия на maratkee.com — с детальным разбором и двумя стресс-тестами: что остановится, если один человек исчезнет на месяц, и где возникнет очередь, если AI удвоит поток изменений.
  • ❤ 2
  • 🔥 1
Post #196 264
🔎 Интересное чтиво:

У коллеги из вышел отличный пост на Хабре — про «прыжок веры» команды в агентскую разработку. Они над этим полгода работали и вот готовы поделиться :)

Если вам интересно как команда в условиях стресса агентизируется, что работает а что нет, почему мини-команды оказались удобнее чем старый формат - 2 фиче тимы на 16 человек.

Как 16 человек без расширения штата и героизма перестроили процессы, попробовали AI-инструменты в деле, разделились на микроюниты и собрали свой workflow для работы людей и агентов.

Честный кейс: с провалами, хакатоном, рефакторингом и неочевидными организационными выводами.


👍 Читайте на Хабре
  • ❤ 5
Post #195 268
➿ Human Loop Weekly #2 — AI ускоряет отдельные этапы работы. А вот задача все равно висит в очередях между этапами

AI помог открыть pull request в понедельник. А к какому дню недели оно доехало в итоге до пользователя?


Этим вопросом мы задаемся как сквозной темой в рассылке на этой неделе. Смотрим на то, как ограничение часто проявляется после написания кода: в ревью, тестовой среде, решении о риске, релизном окне или проверке результата у пользователя.

🔖 Во втором выпуске разбираю:

- как восстановить маршрут 10 недавно завершённых задач;
- где отличить очередь мощности от ожидания решения и контекста;
- почему зелёная проверка подтверждает конкретный риск, а не качество изменения целиком;
- как связать активность с AI с временем прохождения задачи, возвратами и клиентским результатом.

Кому лень идти на сайт — вот источники сразу:

📊 DORA: как измерять ценность генеративного AI — J-кривая внедрения, стоимость обучения и «налог на проверку»: AI генерирует больше кода, команде требуется больше времени, чтобы его понять и подтвердить.

🏭 Lean Enterprise Institute: 12 потерь в разработке продукта — ожидание данных, решений, ревью и свободной мощности; передачи контекста и переделка как источники потерь.

💰 ROI разработки с AI — как связывать AI-инвестиции с потоком работы, качеством и финансовым эффектом.

🔍 Google Cloud: кто проверяет код, написанный AI — практический сигнал: рост объёма изменений переносит нагрузку в ревью и интеграцию.

👉 Полный выпуск
  • 🔥 4
Post #194 317
Я подписан на кучу рассылок по AI, продукту, менеджменту и инженерным командам. Каждую неделю разгребаю поток и собираю из него то, что реально влияет на решения — данные, исследования, кейсы - с разбивкой на то, это подтвержденная инфа или пока какой-то хайп. Недавно, об этом узнали коллеги и попросили поделиться. Пришлось оформить в полноценную рассылку, которая будет выходить раз в неделю!

👉 Human Loop Weekly #1

В выпуске:
- 84% разработчиков используют AI. Доверяют результату — 29%
- Скрытые расходы $310–750/мес на инженера поверх зарплаты
- Команды из 8 человек → AI Pod из 2–4 сеньоров с агентами
- AI усиливает то, что уже есть (DORA 2025)
- Monte Carlo для портфеля из 50+ команд

Кому лень идти на сайт — вот источники straight to the point:

📊 Stack Overflow Developer Survey (отчет 2025 и тренды 2026 в сравнении) — adoption vs trust, фрустрации с AI-кодом
🐙 Jellyfish: State of Engineering Management 2026 — 80% сообщают о росте, лишь 10% получают реальную поддержку
🔧 LeadDev: «10x AI productivity? Try 10%» — реальный ROI от AI в инженерке не больше 10%, вместо обещанных 10x.
🧪 METR: рандомизированное исследование — разработчики на самом деле делали работу на 20% медленнее. Почему старому исследованию 2025 не нужно верить, но и в 2026 не все так очевидно.

Подписаться на еженедельные выпуски → @predictableteam
А если чего-то не хватает - пишите в комментах! Мы с кодексом обязательно разберем комментарии и проапгрейдим скилл :)
  • ❤ 5
  • 👍 4
  • 🔥 2
Post #193 296
Я за последние полгода привык к паттерну: один AI-агент пишет код (codex, gpt-5.5). Второй проверяет (z.ai glm-5.2). На схеме выглядит как зрелый инженерный процесс. В цифрах иногда оказывается, что второй агент ломает решение, которое уже проходило тесты.

📚 В свежем arXiv-препринте про cross-model code review исследователи взяли 116 сложных и средних задач LiveCodeBench и сравнили шесть режимов: Claude отдельно, Codex отдельно, самопроверка каждой модели и проверка другой моделью.

Агент-ревьюер видел условие и черновик решения, запускать тесты не мог. То есть это статическая проверка перед CI.

👆Оказалось: второй AI в цепочке сам по себе качества не гарантирует.

Цифры здесь — это сколько задач из 116 прошли тесты.

- Claude Opus 4.7 один: 91,4%
- Codex GPT-5.5 один: 71,6%

👍 Когда Codex писал первый черновик решения, ревью помогало:

- Codex → Claude review: 89,7%
Было 71,6%, стало 89,7%. Это +18,1 п.п. к одиночному Codex.

- Codex → Codex self-review: 84,5%
Было 71,6%, стало 84,5%.

👍 Когда Claude писал первый черновик, ревью не помогало:

- Claude → Codex review: 82,8%
Было 91,4%, стало 82,8%. Это -8,6 п.п. к одиночному Claude.

- Claude → Claude self-review: 91,4%
Было 91,4%, осталось 91,4%.


📈 Читая эти результаты, хочется пошутить что теперь и агентам нужен оргчарт. Кто кому ставит approve: Claude Codex’у или Codex Claude’у - влияет на качество.

• Хороший проверяющий агент помогает там, где решение почти готово: поправить крайний случай, убрать лишнее, заметить ошибку.
• Слабый проверяющий агент делает классическую менеджерскую ошибку: приходит в работающий процесс, всё “оптимизирует” — и после него всё ломается.

🔭 Пора проектировать роли агентов в разработке с агентами (простите за за тавтологию)

Теперь пора учитывать - кто делает первый черновик? Кто проверяет? Есть ли тесты? Может ли проверяющий запускать код? Где человек принимает финальное решение (ну это итак очевидно)? Сколько рабочих решений второй агент улучшил — и сколько сломал?

❕Тут важно понимать, что на LiveCodeBench, где это все проверялось - задачи спортивного программирования; там нет живого репозитория, старого кода, CI, кривых-тестов, песочницы для запуска....

➕ Но, как мне кажется, паттерн все равно полезный.

Если в команде появляется связка «агент пишет → агент проверяет», кроме скорости смотрите еще и на поломки, которые принёс проверяющий агент. Иначе можно очень быстро построить красивый процесс, который уверенно ухудшает результат.
  • 👍 2
  • 🤣 1
Post #192 305

Forwarded from Marat Kiniabulatov

📼 Запись митапа: 6 причин, почему IT-команды сопротивляются AI — и что с ними делать

🧑‍🏫 Провели митап для руководителей инженерных команд, технических руководителей, delivery-ладам, управляющим изменениями, руководителям AI-трансформации.

👆 Главный вывод

После доклада вы сможете отличить сопротивление людей от слабого места в системе работы и выбрать один проверяемый шаг для своей команды — не список из 30 действий, а одну конкретную зону, одну рабочую сессию и одну договорённость на следующий спринт.

📺Смотреть на Youtube
📺Смотреть на VK

📌 Материалы:
• 👀 Презентация
• 📑 большая статья про сопротивление
• 💊 интерактивная диагностика с техниками работы с сопротивлением
  • ❤ 4
  • 👍 1
  • 🍌 1
Post #191 260
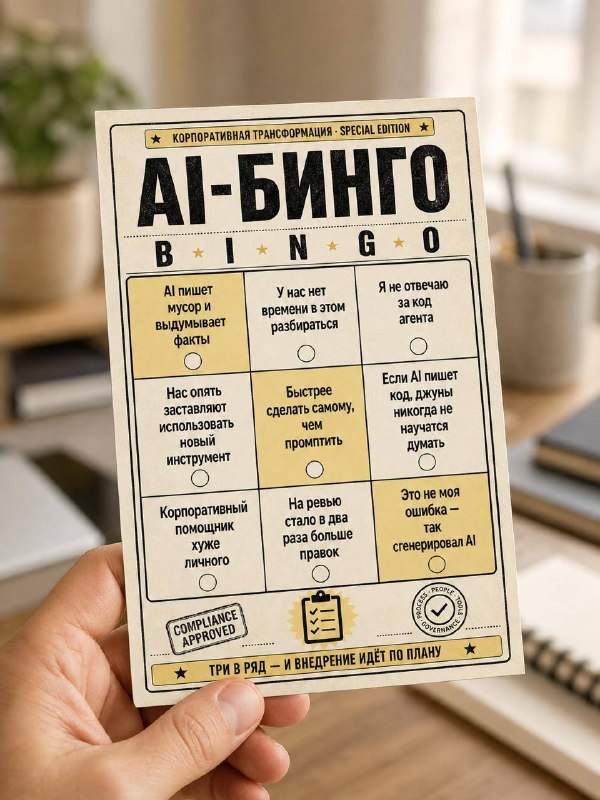
Marat Kiniabulatov ❎❎❎ Сможете собрать бинго? :) Уже завтра в 21.00 Уфы (19.00 Москвы) состоится митап "6 причин сопротивления AI в командах и о чем они говорят". 👉 Регистрация по ссылке. На почту вам придет zoom-ссылка.
🚨 Начинаем через пять минут в zoom по ссылке!
Post #190 281

Forwarded from Marat Kiniabulatov

❎❎❎ Сможете собрать бинго? :)

Уже завтра в 21.00 Уфы (19.00 Москвы) состоится митап "6 причин сопротивления AI в командах и о чем они говорят".

👉 Регистрация по ссылке. На почту вам придет zoom-ссылка.
  • ❤ 3
Post #189 298

Forwarded from JiraMetrics.pro

Это самый большой апдейт за всю историю JiraMetrics.Pro. Проще сказать, что не изменилось.

Изменилось практически всё. Кроме главного — расчётов. Цифрам можно доверять так же, как и раньше.

Первое, что бросится в глаза, — новый дизайн. Интерфейс стал спокойнее и понятнее: важное в данных видно сразу, без вглядывания. Отчёты и дашборды собраны в один список слева — привычные вкладки сверху больше не съедают место, и вся высота экрана досталась графикам. А для тех, кто работает с метриками вечером, появилась тёмная тема 🌒

Дальше — дашборды, и это, пожалуй, самое приятное. Теперь на одной доске их можно завести несколько: например, один для утреннего взгляда "всё ли в порядке", другой — подробный, для ретро или ревью. Виджеты гибкие — меняйте размер, показывайте отчёт целиком, отчёт с ключевыми цифрами или только цифры. Один раз собрал под себя — и дальше просто открываешь и читаешь.

Ключевые цифры, кстати, теперь не нужно выуживать из графиков: у отчётов появилась панель с основными значениями. Открыли — и сразу видно, где вы сейчас.

К девяти отчётам добавился десятый — WIP Run Chart, чтобы следить, как ведёт себя незавершённая работа во времени.

И для коллег, которым английский интерфейс был барьером: плагин теперь полностью говорит на трёх языках — английском, русском и испанском, с переключателем. Только названия метрик (Lead Time, Throughput, WIP) намеренно остались английскими — чтобы термины совпадали с книгами и статьями, и не приходилось гадать.

Много разных технических улучшений, это не так важно, главное что всё стало работать и загружаться быстрее 🚀

Обновление уже у вас — просто откройте свою доску.
Пишите в комментариях, что понравилось и чего не хватает. Этот релиз вырос из ваших сообщений — следующий будет собираться так же.
  • 👍 2
Post #188 259
Самый классный плагин для подсчета метрик потока команд в Jira обновился! И я не могу не пропиарить этот апдейт, так как постоянно им пользуюсь на работе и в консультациях.

Если вы хотите понять, стала ли команда делать больше, быстрее, сколько времени отъедают простои между этапами, какие задачи уже протухли - Jira Metrics Pro это то, что надо. + там в базовой бесплатной версии море нужного функционала.
Google Jira Metrics Plugin - Analytics & Insights - Chrome Web Store A lightweight analytics plugin that helps you track and analyze your team's performance metrics directly from Jira boards.
  • ❤ 1
Post #186 245

Forwarded from Marat Kiniabulatov

🗓 23 июля в 21:00 Уфы (19.00 Мск) Agile Ufa проводит онлайн-митап : «6 причин, почему команды сопротивляются внедрению AI в работу».

Поговорим о том, почему сопротивление AI в командах — это не всегда «люди не хотят нового» и не всегда лечится еще одним обучением.

👉 Часто за сопротивлением стоит что-то конкретнее:

• непонятно, какую рабочую цель улучшает AI
• страшно потерять роль, статус или автономию
• нет безопасного первого опыта на своей задаче
• официальный инструмент хуже обходных вариантов
• неясно, кто отвечает за результат
• локальное ускорение создает очередь в ревью, безопасности или релизе;

🗺️ Разберем это через Карту сопротивления AI: как увидеть настоящую причину, отделить конструктивную критику от саботажа и выбрать первый рабочий ход для команды.

🤝️️️️ В основе митапа — материал «Почему команды сопротивляются AI — и что с этим делать».

🗳 Регистрация по ссылке

Все изменения и анонсы в группе Agile Ufa и канале Predictable Team.
  • ✍ 3
Post #185 211
👋🏼 Всем привет :)

🎬 Делаем стрим про то, как работать с сопротивлением команд при внедрении ИИ - вместе с сообществом Agile Ufa на следующей неделе.

Приходите!
Older posts →

About this channel

How can I read @predictableteam without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Marat @ Predictable.Team: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Marat @ Predictable.Team have?
Marat @ Predictable.Team (@predictableteam) has 408 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Marat @ Predictable.Team know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →