
13 лет в рекламе
@podorozhnik_ppc
Автор t.me/ppc_bigbrain/865
Меню t.me/ppc_bigbrain/1191
Чат t.me/+IAE-w7o7tZtjOTNi
Подписка
t.me/ppc_bigbrain/1496
t.me/ppc_bigbrain/1497
Отзывы
t.me/ppc_bigbrain/1004
t.me/ppc_bigbrain/1249
Комбайн
t.me/ppc_bigbrain/1582
Post #1690
1.78K




(3/4) Вы теряете 20–50% трафика по самым частотным ключам в Директе.
Предыдущие части:
— Часть 1.
— Часть 2.
Зафиксируем ещё один важный термин.
💓 Скрин 1 — отличие ТОЛЬКО в словоформах и порядке слов, но слова в строке — те же.
Словоформы с учётом стоп-слов — в предыдущем посте на последнем скрине в самом последнем столбце.
Для консолидации ("схлопывания" в одну строчку) статистики всех неявных дублей с другими словоформами и порядком слов автоматически по каждой лемме со стоп-словами комбайн вычисляет одну самую частотную словоформу с учётом стоп-слов.
Делается это в несколько сортировок показателей и вертикальных сопоставлений по массиву лемм фраз с предлогами и без, чтобы найти:
1️⃣ Самую частотную форму маски без предлогов — столбец
2️⃣ Самую частотную форму каждой леммы с предлогами — столбец
Чтобы не искажать данные статистики в сторону первой словоформы с учётом стоп-слов, вычисляем в Power BI по всему датасету столбец, в котором по каждой лемме без учёта стоп-слов и порядка слов выводим не просто подсчёт числа уникальных словоформ (от 1 до 10 и более), а всего два значения:
💓 Скрин 2 — подсчёт форм с группировкой до двух значений:
Здесь уже виден масштаб проблемы — если в РК Яндекс Директа собрать неправильные словоформы с учётом стоп-слов, которые являются не самыми частотными вариациями написания каждой маски фразы, можно лишиться 53% трафика и 58% конверсий.
Этот столбец применяем:
— Как критерий фильтрации в слайсере (интерактивном фильтре).
— Как критерий группировки в сводной таблице.
💓 Скрин 3 — вся целевая семантика без фильтров. Просто для сравнения.
💓 Скрин 4 — фильтруем значение
Получаем, что в среднем по всей семантике у масок фраз (лемм без стоп-слов и порядка слов) с двумя и более словоформами на вторую и более словоформы с учётом стоп-слов пришлось 27% охвата.
Будем сравнивать эту цифру с отдельными отфильтрованными сегментами на следующих скриншотах.
Доля охвата второй и более словоформы с учётом стоп-слов по отдельным сегментам:
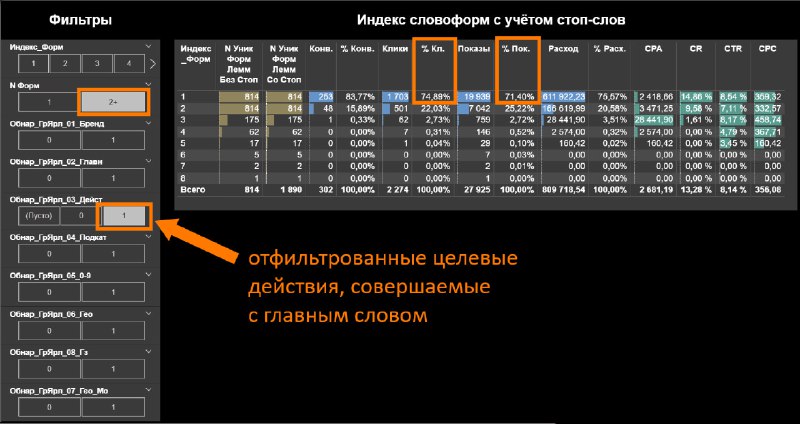
💓 С главными словами (скрин 5) — 29% охвата (субъект, над которым совершается действие — "мусор, отходы, утиль").
💓 С действиями (скрин 6) — 29% охвата (в этой b2b нише вывоза мусора это слова "вывоз, вывезти, утилизировать, утилизация" и прочие синонимы).
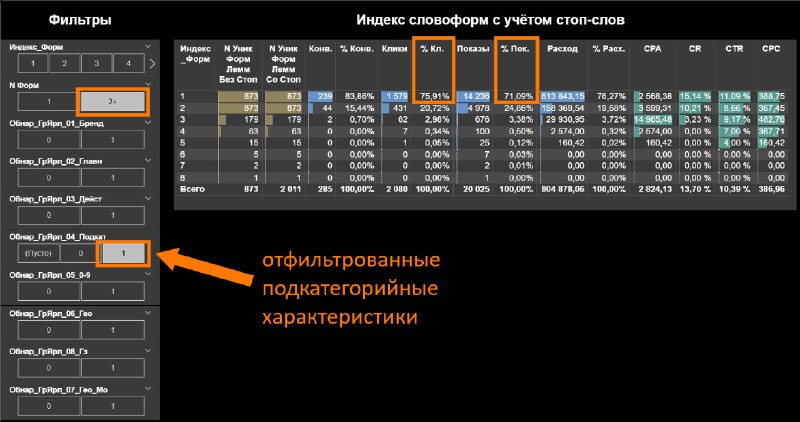
💓 С подкатегориями (скрин 7) — 29% охвата (разные качественные характеристики).
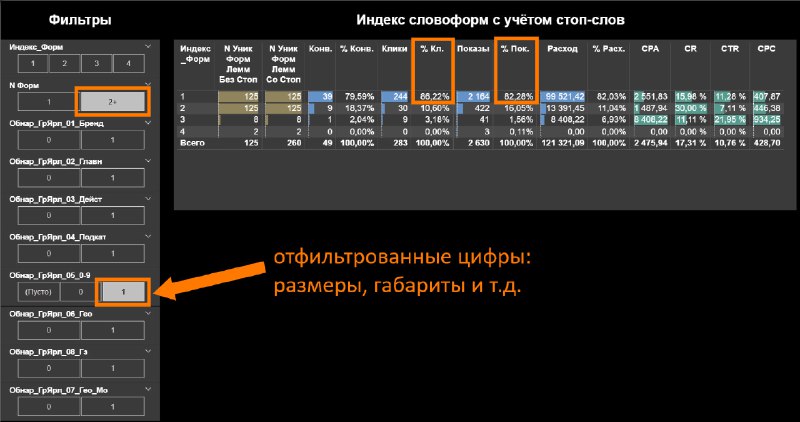
💓 С цифрами (скрин 8) — 18% охвата (масса, размеры и т.д.).
💓 С топонимами (скрин 9) — 29% охвата.
💓 С горячими добавками (скрин 10) — 24% охвата.
💓 С брендом — 0,14% охвата.
✅ Решение:
В [квадратные] [скобки] в РК брать из каждой маски фразы более одной частотных словоформ с учётом стоп-слов:
⚡️ Топ-2 — это уже 98–99% целевого охвата в среднем по семантике.
⚡️ Топ-3 — 99–100% охвата.
В первом посте на скрине в самых частотных фразах ниши прекрасный пример. У второй по частотности формы от 20–30% до 40–55% охвата маски фразы.
⬇️ В следующем посте — скриншоты с итогами и ответы на вопросы.
via @ppc_bigbrain
Предыдущие части:
— Часть 1.
— Часть 2.
Зафиксируем ещё один важный термин.
Словоформы с учётом стоп-слов — фразы, отличающиеся разными стоп-словами или их отсутствием, а не просто другими склонениями и порядком одних и тех же слов в строке.
💓 Скрин 1 — отличие ТОЛЬКО в словоформах и порядке слов, но слова в строке — те же.
Словоформы с учётом стоп-слов — в предыдущем посте на последнем скрине в самом последнем столбце.
Для консолидации ("схлопывания" в одну строчку) статистики всех неявных дублей с другими словоформами и порядком слов автоматически по каждой лемме со стоп-словами комбайн вычисляет одну самую частотную словоформу с учётом стоп-слов.
Делается это в несколько сортировок показателей и вертикальных сопоставлений по массиву лемм фраз с предлогами и без, чтобы найти:
1️⃣ Самую частотную форму маски без предлогов — столбец
"ВЧ_Формы_Лемм_БезСтоп".2️⃣ Самую частотную форму каждой леммы с предлогами — столбец
"ВЧ_Формы_Лемм_СоСтоп".Чтобы не искажать данные статистики в сторону первой словоформы с учётом стоп-слов, вычисляем в Power BI по всему датасету столбец, в котором по каждой лемме без учёта стоп-слов и порядка слов выводим не просто подсчёт числа уникальных словоформ (от 1 до 10 и более), а всего два значения:
«1» — если у леммы без стоп-слов только одна словоформа с учётом стоп-слов.«2+» — если словоформ с учётом стоп-слов две и более.💓 Скрин 2 — подсчёт форм с группировкой до двух значений:
«1» или «2+» — для юзабилити отчёта, так удобнее переключаться в 1 клик для фильтрации лемм, у которых словоформ более одной.Здесь уже виден масштаб проблемы — если в РК Яндекс Директа собрать неправильные словоформы с учётом стоп-слов, которые являются не самыми частотными вариациями написания каждой маски фразы, можно лишиться 53% трафика и 58% конверсий.
Этот столбец применяем:
— Как критерий фильтрации в слайсере (интерактивном фильтре).
— Как критерий группировки в сводной таблице.
💓 Скрин 3 — вся целевая семантика без фильтров. Просто для сравнения.
💓 Скрин 4 — фильтруем значение
«2+» в столбце "N Форм".Получаем, что в среднем по всей семантике у масок фраз (лемм без стоп-слов и порядка слов) с двумя и более словоформами на вторую и более словоформы с учётом стоп-слов пришлось 27% охвата.
Будем сравнивать эту цифру с отдельными отфильтрованными сегментами на следующих скриншотах.
Доля охвата второй и более словоформы с учётом стоп-слов по отдельным сегментам:
💓 С главными словами (скрин 5) — 29% охвата (субъект, над которым совершается действие — "мусор, отходы, утиль").
💓 С действиями (скрин 6) — 29% охвата (в этой b2b нише вывоза мусора это слова "вывоз, вывезти, утилизировать, утилизация" и прочие синонимы).
💓 С подкатегориями (скрин 7) — 29% охвата (разные качественные характеристики).
💓 С цифрами (скрин 8) — 18% охвата (масса, размеры и т.д.).
💓 С топонимами (скрин 9) — 29% охвата.
💓 С горячими добавками (скрин 10) — 24% охвата.
💓 С брендом — 0,14% охвата.
Важно:
Проблема не в 29% охвата по каждому сегменту, а в том, что у конкретных масок фраз распределение охвата по словоформам со стоп-словами иногда 50/50, а иногда и вовсе 99/1.
То есть взяли только одну или не самую частотную форму с учётом стоп-слов — и порезали по отдельным маскам фраз вплоть до 99% охвата.
✅ Решение:
В [квадратные] [скобки] в РК брать из каждой маски фразы более одной частотных словоформ с учётом стоп-слов:
⚡️ Топ-2 — это уже 98–99% целевого охвата в среднем по семантике.
⚡️ Топ-3 — 99–100% охвата.
В первом посте на скрине в самых частотных фразах ниши прекрасный пример. У второй по частотности формы от 20–30% до 40–55% охвата маски фразы.
⬇️ В следующем посте — скриншоты с итогами и ответы на вопросы.
via @ppc_bigbrain


