




Предыдущие части:
— Часть 1.
— Часть 2.
— Часть 3.
Вопрос из чата:
А как это доказать, что есть потеря трафика?
Оцифровать самые частотные словоформы поисковых запросов и сравнить с ключами. То, что не попало в систематическую ошибку выжившего по всему аккаунту — это именно то, что потеряно.
То есть:
1️⃣ Взять фразы со стоп-словами (например, "купить окна В москве").
2️⃣ Удалить из них все стоп-слова, лемматизировать, развернуть слова в строке от А до Я.
3️⃣ Получить леммы фраз без стоп-слов ("купить москва окно"), которые нужно найти в леммах поисковых запросов, тоже развернутых от А до Я в строке.
4️⃣ Если такие поисковые запросы без стоп-слов найдены — проверить, по каким ключевым фразам они показывались, есть ли там стоп-слова, какие и в каком месте фразы.
5️⃣ Если не найдены — вы получили ответ на вопрос, как доказать потерю трафика.
Если в ключах каждое слово в [квадратных] [скобках], то независимо от того, закреплено ли стоп-слово в квадратных скобках, его не будет в поисковом запросе. Это уже потеря трафика априори.
Вопрос из чата:
В чем разница между всеми словоформами и [одним] [ключом] без стоп-слов?
Разница в том, что:
1️⃣ Я тяну разные ключи из группы в разные статические заголовки комбинаторного объявления.
2️⃣ Я тяну их #шаблоном# в один или несколько заголовков, при этом если из фразы удалить предлоги, получится нечитабельная херня, за которую ещё и по голове от клиента получишь.
3️⃣ Нецелевых стоп-слов во много раз больше, чем целевых. Обычно их соотношение от 10 к 1 вплоть до 20 к 1, т.е. целевых стоп-слов в 10–20 раз меньше, чем нецелевых. Поэтому идея выгребать все существующие запросы — заведомо провал.
4️⃣ Есть бесчисленное количество кейсов, когда только с определённым предлогом фраза является целевой, обычно это явление наблюдается в категориях и подкатегориях. Прекрасные примеры — предлоги "для", "без", "с", которые полностью могут поменять суть фразы.
5️⃣ Смена сути фразы требует другой URL. Вы не посадите трафик с разных поисковых запросов с разными стоп-словами, меняющими смысл запроса, на разные урлы на сайте, используя один ключевик
[тумба] [раковина], из которого удалены все стоп-слова.Есть множество вариаций запросов с этими двумя словами, перечислю по памяти только некоторые из них:
тумба с раковиной
тумба без раковины
тумба под раковину
раковина с тумбой
раковина без тумбы
раковина под тумбу
раковина на тумбе
тумба и раковина
Можете проверить — они все частотные. В действительности этих вариаций ещё больше.
Попробуйте посадить эти поисковые запросы по ключу
[тумба] [раковина] на разные урлы в разных разделах сайта.Использование [одного] [ключевика] без стоп-слов якобы для выгребания всех возможных вариантов стоп-слов — лишь ленивая полумера и работа на похер.
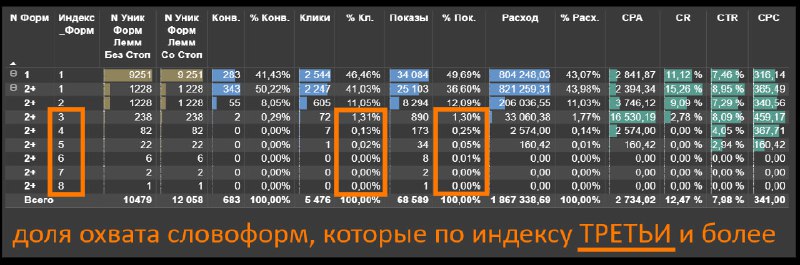
На скринах выше — данные о том, сколько в среднем может приходиться охвата на словоформы с учётом стоп-слов с первым, вторым, третьим и более индексами по убыванию охвата.
Пищу для размышлений я вам дал.
Сколько словоформ фраз с учётом стоп-слов использовать в [квадратных] [скобках] — решать вам.
————
У меня в комбайне вся эта обработка автоматизирована и в Power BI, и в Excel, результаты грузятся в модель данных и выводятся в готовые сводные таблицы и фильтры.
Для изучения любой семантики таблицу с индексами и количеством словоформ можно отфильтровать:
1️⃣ Любыми стандартными атрибутами из рекламного кабинета, в т.ч. любой группировкой дат.
2️⃣ Любым из ~200 автосоздаваемых столбцов:
— Сегментами целевой семантики.
— Их обнаружением (наличием в строке).
— Их извлечением (точными значениями в строке).
— Подсчётом слов в них (насколько фразы "широкие").
— Очищенными урлами без параметров и utm-меток.
— Частями урлов, обрезанными до нужного уровня вложенности.
Всё ближе курс по оптимизации и автоматизации аналитики контекстной рекламы, состоящий из двух слов:
Обнови запрос.
Объём данных, набор и названия полей, исходный язык и количество языков значения не имеют.
via @ppc_bigbrain