TGViewer
Channel Public Channel
PPC для сверхразумов | Александр Хитро

PPC для сверхразумов | Александр Хитро

@ppc_bigbrain

13 лет в рекламе
@podorozhnik_ppc
Автор t.me/ppc_bigbrain/865
Меню t.me/ppc_bigbrain/1191
Чат t.me/+IAE-w7o7tZtjOTNi
Подписка
t.me/ppc_bigbrain/1496
t.me/ppc_bigbrain/1497
Отзывы
t.me/ppc_bigbrain/1004
t.me/ppc_bigbrain/1249
Комбайн
t.me/ppc_bigbrain/1582
Subscribers
3.88K
Photos
1.2K
Videos
49
Links
582
Recent Posts 15 shown
Post #1739 1.88K
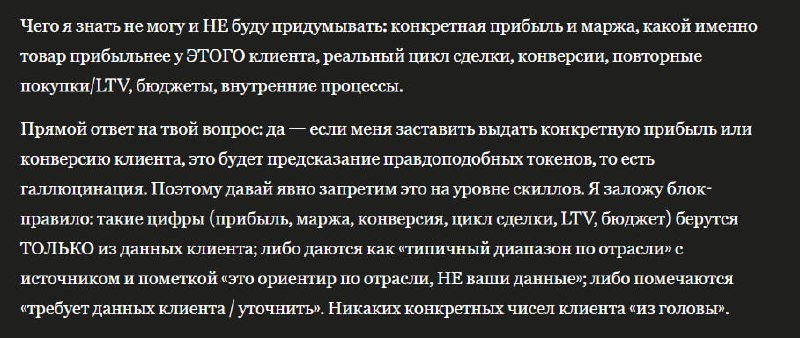
эмэйзинг нейродрисня

когда пытаешься вправить нейтронке мозги из задницы в процессор, создав ей пачку скиллов с сотней руководств по тому, как думать, а она всё ещё тупорылая шопездец

via @ppc_bigbrain
Post #1738 2.04K
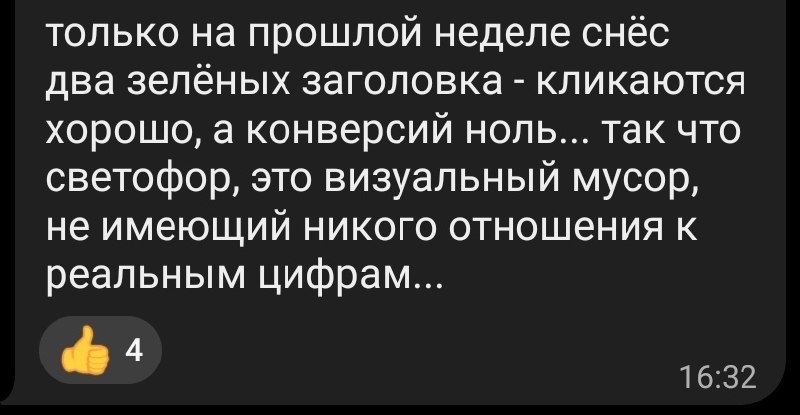
ну и чё теперь делать? а ведь был шанс

via @ppc_bigbrain
Post #1737 2.29K
маркетологи, как вам портрет платежеспособной аудитории? сохраняем или осуждаем?

via @ppc_bigbrain
Post #1736 1.92K
Что вы попробовали в своей карьере из любых родов деятельности один раз и сразу поняли, что это не для вас?

Начну с себя.

Меня за 13 лет в контекстной рекламе хватило на один раз в жизни:

- На настройку 1 смарт кампании в Google Ads.
- На настройку 1 мастера кампаний в Яндекс Директе.
- На 1 разговор с менеджером Гугла об аудите моего аккаунта Google Ads.
- На 1 разговор с менеджером Яндекса об аудите моего аккаунта Директа.

Расскажите о своём незабываемом опыте, рот которого вы шатали.

via @ppc_bigbrain
Post #1735 1.57K
шта? абисните плес, я прост с деревни

шёл 8к26 век, впнологи щщщетали цену клика калкурентов через время появления ремаркетинга

песдос

есус, дай им мозгов

пишите в элэс, пащщетаю в калбайне цену клика ваших кончкурентов через разницу в градусах между вашим углом стояния раком при настройке МК и восьмым козырем бубной в четверг

via @ppc_bigbrain
Post #1734 1.93K
«а мы агентство, которое скликивает рекламу по заказу яндекса»

кулстори от того, кто умеет делать хорошо и кому нет причин не доверять

via @ppc_bigbrain
Post #1730 2.19K
когда бог директа раздавал хромосомы, но не хватило на целую индустрию

via @ppc_bigbrain
Post #1729 2.22K
я как бы ни на что не намекаю, но люди интересуются

via @ppc_bigbrain
Post #1728 2.98K
изучайте портреты ца, говорили они

фильтруйте интенты запросов, говорили они

сегментируйте семантику, говорили они

пишите релевантные заголовки, говорили они

via @ppc_bigbrain
Post #1727 3.06K
автоматизация, которую мы заслужили

via @ppc_bigbrain
Post #1726 2.37K
Меня жизнь к такому не готовила.

Как реагировать на то, что легенда веб-аналитики, на книгах и статьях которого выучилось всё русскоязычное сообщество интернет-маркетинга, советует меня своим ученикам?

Для этого существует какая-то специальная медалька в списке карьерных ачивок? А в форме подорожника есть?

via @ppc_bigbrain
Post #1725 1.62K
Что изучать для BI-разработки и работы с данными.

Предыдущие посты серии:

1. Документация по промптам.
2. Выбор нейронок.
3. Подготовка к разработке.
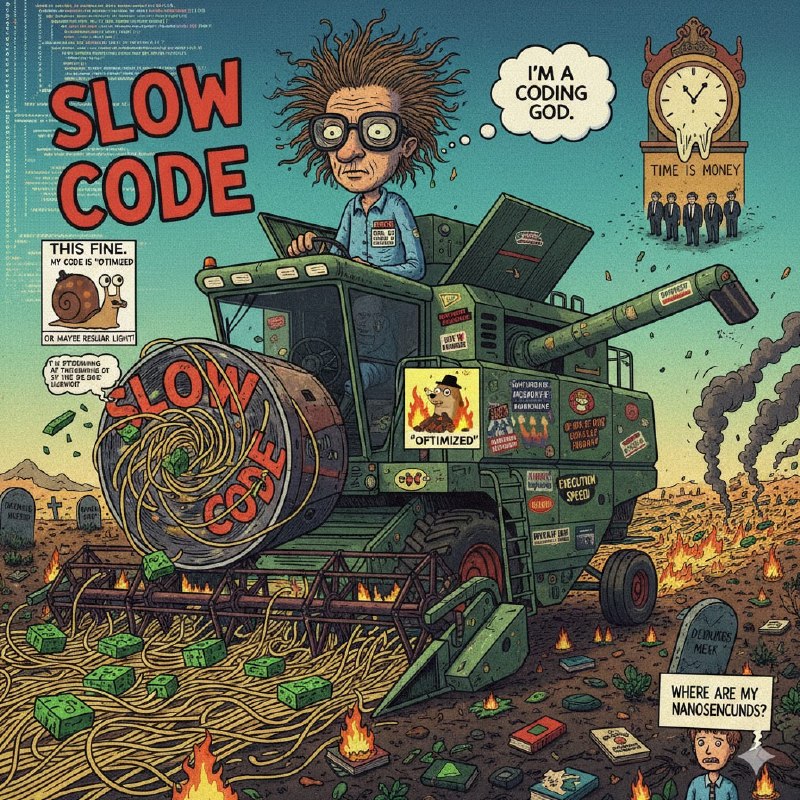
4. Оптимизация кода.
5. Если код не "летает".
6. Минимизируем вычисления.
7. Фатальный пример вычислений.
8. Порядок обработки данных.
9. Смерть производительности. Часть 1.
10. Смерть производительности. Часть 2.
11. Плохие и хорошие примеры.
12. Когда в PQ сортировать данные.
13. Параметризация переменными.
14. Что учесть перед созданием кода


Что развивать и изучать для обработки данных?

✅ Образное мышление:

— Как пример из других кейсов применить к моим данным.
— Какие операции выполнить с разными столбцами.
— Если нужных полей в этом датасете нет, а в другом — есть, как их можно объединить.
— Какие проблемы можно обнаружить, имея в датасете нужные столбцы.
— Как их создать.
— Как данные из кастомных столбцов применить в дашбордах как критерии:
а) Группировки.
б) Сегментации.
в) Фильтрации.
— Какие куски кода параметризировать, чтобы применять его на других проектах.
— Как реализовать гибкость и управляемость обработкой данных, чтобы не хардкодить пользовательские значения текстом в коде, а обращаться к динамическим спискам:
а) Умным таблицам.
б) Именованным диапазонам.
в) Папкам с файлами.
— Какие проблемы и задачи универсальны для всех проектов.
— Как подготовить общие (глобальные) библиотеки данных, которыми можно пользоваться в любом проекте.
— Какие проблемы и задачи являются частными для каждого проекта.
— Как подготовить локальные библиотеки данных, которые в каждом проекте будут свои.
— Как заранее предусмотреть конфликты значений в локальных и глобальных библиотеках, т.е. реализовать поэтапную проверку условий.

✅ Получение данных:

— Откуда и что получать.
— Какие поля.
— В каких группировках.
— С какой детализацией.
— С какими фильтрами.
— За какой период.
— Каков объём данных.
— Не "ляжет" ли получение данных из-за их объёма.

✅ Если это вручную заполняемые данные (CRM, Google Sheets):

— В каком виде данные находятся в источнике.
— Плоская ли это таблица (в столбцах — названия полей, в строках — значения).
— Какие манипуляции с данными нужно произвести для их преобразования в плоскую таблицу.
— Кем заполняются данные.
— Какие поля нужно автоматически валидировать (проверять, исправлять, изменять).
— Какие нужно обрабатывать частные случаи.
— Как это автоматизировать.

✅ Хранение данных:

— Каков объём исторических данных.
— Частота их обновления.
— Интенсивность их обновления, т.е. насколько много новых данных появляется ежедневно.

✅ Среду разработки:

— Возможности интерфейса.
— Возможности и ограничения языка.
— Синтаксис.
— Библиотеки.
— Типы объектов.
— Кастомные функции.
— Архитектуру.
— Исправление ошибок.

✅ Создание модели данных:

— Нормализация модели данных.
— Как не раздувать модель данных.
— Как обработанные данные собрать в нужные столбцы и таблицы для удобных и полезных дашбордов.
— Как позаботиться о масштабируемости модели данных.

✅ Вычисляемые поля:

— Как вычислить ту или иную сущность в модели данных.
— Почему вычисления метрик лучше делать в модели данных, а не на этапе ETL-процесса перед загрузкой в модель.

✅ Визуализацию данных:

— Бесконечный простор нажатия галочек, которые пока сам все не понажимаешь и не используешь, не поймешь, что они делают, и не запомнишь, где они находятся.

✅ Фильтры:

— Что нужно иметь в источнике данных или вычислить в коде, чтобы это отобразить удобно и понятно.
— Локальная фильтрация листа.
— Сквозная фильтрация всего отчёта.

✅ Параметры в дашбордах:

— Как визуальные элементы дашборда (фильтры, значения, поля в таблице) сделать автоматически пересчитываемыми, чтобы не городить много вкладок, отличающихся одним полем или метрикой.
— Как параметризировать часто используемые элементы.
— Как уместить всё самое важное на один холст отчёта.
— Как выбирать необходимые визуализации в 1 клик.

Вот для чего создавался комбайн:
— ч.1
— ч.2

Чтобы не суецыднуться от ежедневных инсультов при работе с любым проектом на любом языке.


via @ppc_bigbrain
Post #1724 1.29K
Что учесть перед созданием кода

Предыдущие посты серии:

1. Документация по промптам.
2. Выбор нейронок.
3. Подготовка к разработке.
4. Оптимизация кода.
5. Если код не "летает".
6. Минимизируем вычисления.
7. Фатальный пример вычислений.
8. Порядок обработки данных.
9. Смерть производительности. Часть 1.
10. Смерть производительности. Часть 2.
11. Плохие и хорошие примеры.
12. Когда в PQ сортировать данные.
13. Параметризация переменными.


Что обязательно нужно учесть перед созданием кода:

⚫️ В какие типы объектов преобразовать те или иные данные для ускорения их обработки.

⚫️ Нужна ли сортировка и на каком этапе:
        😶 По каким атрибутам: текстовым, числовым.
        😶 В каком порядке.
        😶 Как получить списки этих полей динамически.

⚫️ На каком этапе получать список уникальных значений:
         😶 Удалением дублей в таблице и по каким столбцам: Table.Distinct.
         😶 Получением списка и удаления дублей в нём:
List.Distinct(Table1[Column1])
         😶 Группировкой таблицы и по каким столбцам: Table.Group.
         😶 Как сгруппировать остальные столбцы:
                  🥷 С текстом: List.Sort, List.Distinct, Text.Combine.
                  🥷 С числами: List.Max, List.Sum, List.Min.
         😶 Что вы собираетесь делать с этими данными дальше.

⚫️ На каком этапе значения null заменить на 0. Потому что нейронка не знает, что вы текущий кусок кода через 10 этапов преобразований будете группировать с суммированием, а суммирование значений null вернёт ошибку.

⚫️ На каком этапе преобразований и в каком столбце указать какой тип данных.
        😶 Если в столбце с числовыми значениями будет ошибочно указан текстовый тип данных, агрегатные функции List.Max, List.Sum, List.Min вернут ошибку.
        😶 При сцепке (конкатенации) двух столбцов, в одном из которых тип данных — текст, а в другом — целое число, эта операция вернёт ошибку. Сцеплять можно только текст с текстом.
        😶 Оборачивание столбца с числами в функцию Text.From преобразует их в текст для последующих текстовых преобразований.

⚫️ Какие функции не использовать, т.к. они очень дорогостоящие, чем их заменить, чтобы они выполнялись мгновенно.

⚫️ Использовать аналоги векторной обработки (всего столбца сразу как единого массива), а не каждой строки по отдельности.

⚫️ Как отфильтровать исходный массив, чтобы вхолостую не применять тяжёлые операции преобразований к строкам, в которых даже нет искомых данных.
        😶 По каким условиям фильтровать.
        😶 Как получить этот список условий динамически.

⚫️ Как не перегрузить модель данных нормализацией и "снежинкой", чтобы визуальный слой быстро обновлялся и легко пересчитывался в "звёздочке".

Что изучать для BI-разработки и работы с данными — в следующем посте.

via @ppc_bigbrain
Post #1723 1.13K
Параметризация кода переменными под разные проекты.

Предыдущие посты серии:

1. Документация по промптам.
2. Выбор нейронок.
3. Подготовка к разработке.
4. Оптимизация кода.
5. Если код не "летает".
6. Минимизируем вычисления.
7. Фатальный пример вычислений.
8. Порядок обработки данных.
9. Смерть производительности. Часть 1.
10. Смерть производительности. Часть 2.
11. Плохие и хорошие примеры.
12. Когда в PQ сортировать данные.


✅ Примеры функций для получения динамических списков — в предыдущих постах:
— Раз.
— Два.

✅ При фильтрации по списку условий во избежание хардкода {"X", "Y", "Z"} фильтруемых значений, вам придётся придумать логику получения этого списка динамически:

⚫️ Если это статический список (одинаковый для всех итераций обновления данных), можно, например, получить их с листа Excel из умной таблицы или именованного диапазона, и при последующих обновлениях запроса он всегда будет неизменным.

⚫️ Если это динамический список (в каждом проекте свои значения, список и количество которых постоянно меняется):

😶 Либо вам придётся самим придумывать логику их получения динамически.

😶 Либо попросите нейронку вам подсказать, как получить их динамически, возможно, из этого что-то толковое и получится.

⚫️ Любой список разнородных значений указать в столбик и рядом в разных столбцах разметить нужные характеристики всех значений как критерии и порядок группировки, сортировки и фильтрации.

⚫️ Все эти критерии передать в код через весь пайплайн обработки данных как динамические списки.

————

Ничего конкретного показывать и рассказывать не буду, ибо на этом основана вся суть комбайна, в котором я всё это просто охерел придумывать, как всё это реализовать, и как из этого сделать универсальный инструмент под все существующие сценарии работы ппсшника в любых рекламных системах на любых языках.

Полезно разбираться в языке, на котором вы вайбкодите, чтобы явно указывать нейронке, что нужно сделать в той или иной ситуации.

Иногда нейронки генерят производительный код, но инструкции должны быть с явным указанием требований к оптимизации, а иногда даже на платных тарифах даже с подробными промптами и явным указанием, что делать, городят полнейшую дичь.

Вайбкодинг без знания даже основ языка, на котором вы что-то генерите — ещё большее усложнение себе жизни.

О чём подумать перед созданием кода — в следующем посте.

via @ppc_bigbrain
Post #1722 1.1K
Когда сортировать данные можно и нельзя.

Предыдущие посты серии:

1. Документация по промптам.
2. Выбор нейронок.
3. Подготовка к разработке.
4. Оптимизация кода.
5. Если код не "летает".
6. Минимизируем вычисления.
7. Фатальный пример вычислений.
8. Порядок обработки данных.
9. Смерть производительности. Часть 1.
10. Смерть производительности. Часть 2.
11. Плохие и хорошие примеры.


Выносим сортировку из ETL-процесса в Power Query на уровень отчета в следующих случаях:

1️⃣ Для визуального представления.

Если сортировка нужна только для того, чтобы видеть таблицу красиво (по алфавиту, по убыванию цены). Excel и Power BI сортируют данные в визуальных элементах (графиках, матрицах) мгновенно, используя оптимизированные движки, не нагружая процесс обновления данных.

2️⃣ Для интерактивности.

Если хотим иметь возможность менять порядок сортировки (кликом по заголовку столбца). Жесткая сортировка в Power Query лишает отчет гибкости.

3️⃣ При использовании Top-N фильтров в Power BI.

Движок VertiPaq (DAX) вычисляет "Топ-10" в визуализациях быстрее, чем Power Query готовит пред-отсортированную таблицу.

————

Оставляем сортировку в Power Query только если она влияет на логику расчетов:

1️⃣ Для вычисления индекса строки (Index Column).
2️⃣ Для расчета нарастающего итога (Running Total).
3️⃣ Для функций заполнения (Fill Down, Fill Up). В этих случаях обязательно используем Table.Buffer после сортировки.

Во всех остальных случаях сортировка в Power Query — ошибка и излишняя нагрузка.

————

⚫️ Не сортируем, если можем агрегировать.

Всегда проверяем, можно ли получить результат через Max, Min, Sum или Group. Это золотой стандарт оптимизации.

⚫️ Ранняя фильтрация.

Никогда не сортируем данные до фильтрации. Сначала используем Table.SelectRows, чтобы отсечь все лишнее, и уменьшить количество строк. Сортировка 1000 строк в 100 раз быстрее, чем сортировка 100.000 строк (спасибо, кэп).

⚫️ Используем буферизацию с умом.

Если отсортировали таблицу для сложного расчета и многократного обращения к результатам, берём этот шаг в Table.Buffer. Иначе Power Query может выполнять сортировку заново для каждой последующей строки вычислений.

⚫️ Разделяем данные и представление.

Если сортировка нужна только для презентации, делаем её в модели данных или элементах визуализации данных, а не в ETL.

⚫️ Query Folding — приоритет (но не поддерживается при работе с локальными файлами на ПК, а только с базой данных).

Table.Sort при работе с SQL часто прерывает Query Folding — свертывание запросов. Если сортировка неизбежна и данные не лежат на ПК, выполняем её на стороне сервера, а не в памяти Power BI.

Итого:

➕ Нужно Макс/Мин значение? Используем List.Max, List.Min (вместо Sort+First).
➕ Нужен Топ-N? Используем List.MaxN (вместо Sort+FirstN).
➕ Нужен уникальный список? Используем List.Distinct (вместо Sort+RemoveDuplicates).
➕ Нужно найти соответствие? Используем Table.Join (вместо SelectRows внутри AddColumn).
➕ Нужна красота в отчете? Сортируем в Excel/Power BI, а не в Power Query.


✅ Хороший код Power Query:

— Выполняется за секунды или минуты, а не часы.
— Работает за время O(n) или O(n+m).
— Масштабируется с тысяч до миллионов строк.

❌ Плохой код Power Query:

— Сортирует "на всякий случай".
— Сортирует в циклах.
— Сортирует ради отображения.
— Отдаёт ошибку нехватки памяти.

Для использования самых быстрых альтернатив сортировки, спрашиваем у нейросети:

Как по каждому значению столбца X получить значение из столбца Y, которое соответствует наибольшему значению метрики Z, но:

— Не используя при этом сортировок.

— Используя функцию, которая сразу возьмёт максимальное значение.


В каждом промпте про оптимизацию скорости кода обязательно явно указываем на минимизацию количества вычислений из «Big O» нотации:

1. Используй операции с вычислительной сложностью: O(1), O(log n), O(n), O(n + m), но как можно меньшее из них.

2. Не используй операции вычислительной сложностью: O(n log n), O(n × m), O(n²), O(nᵏ), O(2ⁿ), O(n!).


В следующем посте — о параметризации кода переменными для его использования в разных проектах.

via @ppc_bigbrain
Older posts →

About this channel

How can I read @ppc_bigbrain without a Telegram account?
TGViewer shows the public web preview Telegram publishes for PPC для сверхразумов | Александр Хитро: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does PPC для сверхразумов | Александр Хитро have?
PPC для сверхразумов | Александр Хитро (@ppc_bigbrain) has 3.88K subscribers on Telegram, refreshed roughly every 30 minutes.
Does PPC для сверхразумов | Александр Хитро know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →