



Продолжение части 1.
Начнём с используемой далее терминологии:
❓ Стоп-слова — служебные части речи: предлоги, союзы, частицы, местоимения, артикли (в иностранных языках).
❓ Лемма — начальная словарная форма слова.
❓ Лемма фразы — фраза, в которой все слова приведены к леммам.
❓ Лемма фразы без учёта стоп-слов — лемма фразы, из которой удалены все стоп-слова.
❓ Лемма фразы без учёта порядка слов — лемма фразы, в которой слова в строке отсортированы в едином порядке по всему массиву — применяется для обнаружения неявных дублей, отличающихся словоформами и порядком слов.
❓ Маска фразы — лемма фразы без учёта стоп-слов и порядка слов — лемма фразы, в которой удалены все стоп-слова и слова отсортированы в строке в едином порядке по всему массиву — применяется для обнаружения неявных дублей, отличающихся словоформами, порядком слов, а также наличием или отсутствием стоп-слов.
Если вы когда-либо в Кейколлекторе или Директ Коммандере удаляли неявные дубли фраз, в которых стоп-слова не закреплены операторами соответствия "!", "+" или [ ] — это и есть удаление дублей масок — лемм фраз без учёта стоп-слов и порядка слов.
Слова в строке можно отсортировать тремя способами:
1️⃣ По алфавиту — проще и быстрее, но это невозможно читать в дальнейшей работе.
2️⃣ По убыванию показателей — т.е. чем частотнее слово, тем оно левее в строке, это уже чуть более универсально, налево сдвигаются более важные в лексике ниши слова, но всё-равно слова в строке находятся в хаотическом порядке, никакой упорядоченности, результаты такой сортировки невозможно читать при дальнейшей работе.
3️⃣ По показателям и по смыслу — визуально воспринимать проще всего, используя многоуровневую сортировку с классификацией слов:
🥷 По охвату групп ярлыков.
🥷 Внутри групп ярлыков — по охвату смысловых ярлыков слов.
🥷 Внутри смысловых ярлыков — по охвату синонимичных замен.
🥷 Внутри замен — по охвату лемм слов.
Получаем сортировку слов в строке по смыслу и приоритету в нише. Она используется лишь как промежуточный шаг, чуть более удобный для восприятия.
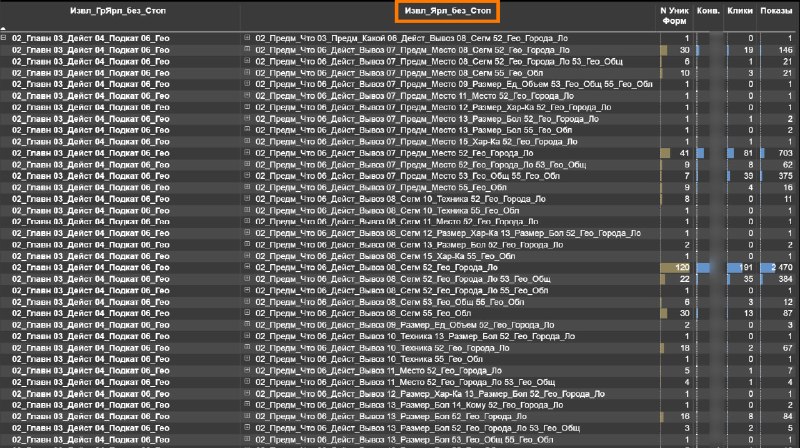
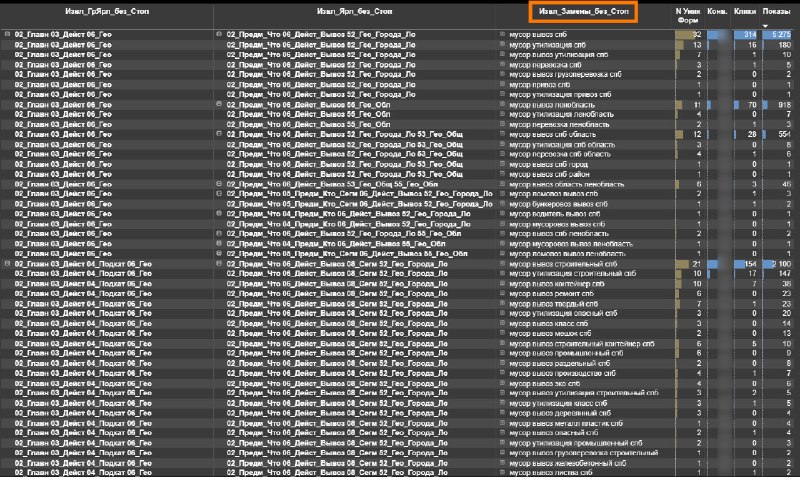
Специально отсортировал таблицу на скринах 1 и 2 не по показателям, а по алфавиту — для наглядности, почему такая смысловая группировка и сортировка слов в строке удобнее и легче для чтения.
✅ Скрин 1 — группы ярлыков (без стоп-слов) — независимо от порядка слов в исходной фразе, группы ярлыков расположены в строке всегда в одном и том же порядке. Для простоты понимания этой концепции выделил одинаковые группы ярлыков в столбце одинаковыми цветами.
✅ Скрин 2 — смысловые ярлыки (без стоп-слов) — аналогичный порядок в строке, что и выше.
✅ Скрин 3 — синонимичные замены (без стоп-слов) — аналогичный порядок в строке, что и выше.
✅ Скрин 4 — маски фраз (т.е. леммы БЕЗ стоп-слов и порядка слов).
✅ Скрин 5 — самая частотная словоформа каждой маски фразы БЕЗ учёта стоп-слов.
✅ Скрин 6 — самая частотная словоформа каждой леммы СО стоп-словами. Это группировка до единого самого частотного варианта всех написаний каждой фразы:
— С любым порядком слов.
— С наличием или отсутствием стоп-слов.
— С любыми словоформами каждого слова.
Наличие стоп-слов в ключах в широком соответствии на охват не влияет, но использование в [квадратных] [скобках] неправильно выбранной не самой частотной словоформы с учетом стоп-слов может сильно урезать трафик.
Даже при сортировке фраз по показателям и отборе самой частотной формы с предлогами можно лишиться до 30–55% охвата.
А что если не глядя взять в РК не самую частотную словоформу?
На последнем скрине есть словоформы с индексом 2 и более, у которых 1% охвата маски фразы.
✅ Решение проблемы:
Брать в [скобки] в РК не одну самую частотную словоформу с предлогом или без (на последнем скрине — столбец
"ВЧ_Формы_БезСтоп"), а все частотные словоформы с предлогами (столбец "ВЧ_Формы_СоСтоп").Далее рассмотрим, насколько всё плохо:
1️⃣ В масках фраз, у которых две и более словоформ с учётом стоп-слов.
2️⃣ В отдельных кластерах семантики.
⬇️ Читать продолжение.
via @ppc_bigbrain