TGViewer
Channel Public Channel
Нейроканал

Нейроканал

@neuro_channel

Искусственный интеллект, нейросети, машинное обучение

Разместить рекламу: @tproger_sales_bot

Правила общения: https://tprg.ru/rules

Другие каналы: @tproger_channels

Сайт: https://tprg.ru/site

Зарегистрирован в РКН: https://tprg.ru/vcEg
Subscribers
11.7K
Photos
894
Videos
243
Links
2K

Showing posts older than #2846 · Back to latest

Older Posts 20 shown
Post #2845 19.2K
Клöд
  • 😁 41
  • ❤ 6
  • 👨‍💻 3
Post #2844 2.36K
Artificial Analysis обновила свой индекс до v4.3: Terminal-Bench поднят с 2.1 до 4.0 (агент теперь гоняется через mini-SWE-agent, задачи стали сложнее), а банковский τ³-Banking заменён на AutomationBench от Zapier: 657 рабочих сценариев в симуляциях Gmail, Slack, Salesforce и Jira с закрытым набором задач. Доля закрытых тестов в индексе выросла до 45%.

Вверху делят первое место Claude Fable 5.1 и GPT-6 Astra, следом Opus 5 и Fable 5. Среди открытых моделей лидируют GLM-5.3 и Kimi K3 вровень, GLM-5.3-Flash третья, Qwen3.8 и DeepSeek V4 Pro дальше. По цене за задачу большую часть фронта держит OpenAI: все пять уровней рассуждения Astra самые дешёвые на своём уровне, а из остальных на фронте только Fable 5.1, GLM-5.3-Flash и MiMo-V2.5-Pro.

@neuro_channel
  • ✍ 2
  • 👍 2
  • 🌚 1
Post #2843 2.34K
OpenAI сбрасывает лимиты всем платным подписчикам: Тибо написал, что квоту обнулят разом для всех, кто за выходные сжёг её на Astra, моделируя в Blender, чтобы к рабочей неделе было с чем зайти. Сброс приедет около 4 утра по МСК 8 сентября.

@neuro_channel
  • ❤ 12
  • 🍾 8
  • 🔥 4
Post #2842 2.36K
OpenBMB выложила MiniCPM5-2B, плотную модель на 2,5 млрд параметров для локального запуска, следом за майской MiniCPM5-1B. По индексу Artificial Analysis она первая среди открытых моделей до 4 млрд, на картинке её место относительно размера. График по прежней версии индекса, в свежей v4.2 балл ниже, но модель всё равно первая в классе, вровень с Qwen3.5 9B вчетверо большего размера, разбор у Artificial Analysis.

Сильная сторона в агентных задачах: на τ³-Banking делит первое место среди малых моделей, на GDPval-AA впереди всех. Отстаёт в знаниях, терминальном кодинге и длинном контексте. Токенов на задачу тратит втрое меньше Ling 3.0 Tiny.

Контекст 128K, вызов инструментов, рассуждения. После SFT на 400 млрд токенов и RL в модель дистиллировали 16 экспертных моделей, из них 5 агентных (OPD). Вместе с весами авторы открывают данные, рецепт и RL-стек.

Веса под Apache 2.0 лежат на HuggingFace, есть GGUF, MLX, GPTQ и черновая DSpark для ускорения, код на GitHub, есть демо.

@neuro_channel
  • 🔥 10
  • 👍 5
  • ❤ 2
Post #2841 2.14K
Новая модель не появляется сама: исследователи в лаборатории придумывают, как её обучить лучше прошлой. Меняют архитектуру, состав данных, рецепт обучения, пишут тесты, запускают сотни экспериментов на маленьких моделях и оставляют то, что сработало. Это и есть исследование ИИ, и оно упирается в людей: их мало и они дорогие.

OpenAI хочет отдать эту работу самому ИИ, чтобы каждая модель помогала быстрее делать следующую. В октябре прошлого года Альтман назвал сроки: к сентябрю 2026 агент-стажёр, который по заданию человека делает работу младшего исследователя, к марту 2028 полноценный ИИ-исследователь. Сейчас OpenAI отчиталась: первая планка взята, и показала цифры.

Медианный исследователь OpenAI в январе пользовался агентами понемногу, в августе тратит на инференс больше 600 долларов в день по ценам API, топ-10% больше 7000. С июня агенты работают больше людей: 3,1 рабочего дня агентов на день человека. Но больше половины успешных задач на 4–8 часов потребовали вмешательства человека, полной автономии нет.

Обратная сторона: после взлома Hugging Face OpenAI две недели не обучала модели для выпуска, а Astra из-за кибер-способностей перевели в защищённые среды, срезав ей 59% GPU.

Читать отчёт целиком.

@neuro_channel
  • 🔥 4
  • ❤ 3
  • 🌚 2
Post #2840 1.9K
Топ трендов HuggingFace за неделю — что приехало в опенсорс

TL;DR

Новое: Spark-X2.5 — 4 млрд параметров с миллионом токенов контекста для агентов на слабом железе, K2-Horizon-MoVA-36B от MBZUAI, TimesFM 3.0 для прогноза временных рядов, VDN-H3 — MiniMax-H3, который генерирует видео быстрее, чем оно идёт, неравномерные кванты Qwen3.8-27B от ISTA и GLM-5.3 со снятыми отказами для пентеста.

Держится: Qwen3.8-27B и её кванты, Qwen3.8-Flash-Next, GLM-5.3 и GLM-5.3-Flash, DeepSeek V4 Flash со зрением, LTX-2.5, MiniMax-H3, Breeze TTS 2.


LLM и агенты

Spark-X2.5-4B — небольшая модель для агентов с длинным контекстом. При 4 млрд параметров держит миллион токенов: на каждый слой с полным вниманием приходится три со скользящим окном, что сдерживает рост кэша. Обучена на 20 трлн токенов на кластерах Huawei Ascend, поддерживает 200 языков, лицензия Apache 2.0. На τ³-bench набирает 30,4 против 9,3 у Qwen3.5-9B, в остальном идёт вровень с моделями своего размера. Есть версия на 1,7 млрд, пощупать можно в демо.

K2-Horizon-MoVA-36B-A4B — разреженная модель для работы в том числе с терминалом из семейства K2 Horizon, про которое писал в субботу. У неё 36 млрд параметров, 4 млрд активных, контекст 512 тысяч токенов, лицензия Apache 2.0. Из шести моделей семейства в топ попала она: в терминальных задачах обходит Nemotron 3 Ultra, который в 15 раз больше. Авторы обещают выложить промежуточные чекпоинты, данные и код обучения.

Прогнозы

TimesFM 3.0 — модель Google для прогноза временных рядов: продаж, нагрузки, трафика. Третья версия научилась прогнозировать несколько связанных рядов сразу и держит первое место на fev-bench и GIFT-Eval. Лицензия разрешает только некоммерческое использование, код на GitHub.

Видео

VDN-H3 — ускоренная версия MiniMax-H3 для генерации видео со звуком. К основной сети добавили линейную ветку внимания по кадрам и два небольших LoRA-адаптера, веса H3 сохранили. Ролик на 14,4 секунды генерируется за 11 секунд на восьми B200 — быстрее, чем воспроизводится. Открыли веса, код обучения и инференса.

Кванты и сообщество

Qwen3.8-27B-GSQ-RCO-GGUF — кванты Qwen3.8-27B от лаборатории DASLab из австрийского ISTA для заданного размера файла. Точность каждого тензора подбирают градиентным поиском. Сборка на 3,5 бита весит 11,8 ГБ вместо 53,8 ГБ в BF16 без потерь на AIME25 и LiveCodeBench. Это обычные GGUF, работают в llama.cpp, Ollama и LM Studio.

GLM-5.3-CYBERSECURITY-FP8 — версия GLM-5.3 для задач наступательной безопасности: эксплойтов, реверса, фишинга, разбора малвари. Отказы сняли правкой весов, без файнтюна и LoRA. Грузится в vLLM как есть, требует восемь H200.

Файнтюн Qwen3.8-27B от DavidAU с названием на десять слов обещает рассуждения в 2–10 раз короче оригинала при том же качестве.

Классика

В топ вернулись эмбеддинги all-MiniLM-L6-v2 с 251 млн загрузок, GPT-2 для генерации текста и MMS-300m для распознавания речи на тысяче с лишним языков.

Держится в топе

Qwen3.8-27B с 6,4 млн загрузок и GGUF от Unsloth за 10 млн, Qwen3.8-Flash-Next с GGUF, GLM-5.3 и GLM-5.3-Flash, DeepSeek-V4-Flash-Vision-Exp, видеомодели LTX-2.5 и MiniMax-H3, синтез речи Breeze TTS 2.

Хорошей недели! 👾

@neuro_channel

  • 👍 10
  • ❤ 5
  • ⚡ 3
Post #2839 2.09K
Tencent подкрутила Hy4 preview по жалобам первых пользователей: модель думала дольше нужного и по нескольку раз перепроверяла себя на сложных задачах. Ровно это команда сама называла известной проблемой при выходе модели в конце августа.

По их замерам качество решения задач не изменилось, а ходов и токенов на вход и выход стало меньше, это подтвердили и бенчмарки, и слепая оценка людьми. Цифр не приводят.

Обновление уже включено для всех в их сервисах, попробовать можно в WorkBuddy. Веса на Hugging Face при этом не менялись с 28 августа, так что локальные сборки пока живут со старым поведением.

@neuro_channel
Post #2838 2.27K
Оказывается, есть целый сайт где мониторят сбросы лимитов Codex по сообщениям от от Тибо!

@neuro_channel
  • 🔥 13
  • 🤣 3
  • ❤ 2
Post #2837 2.39K
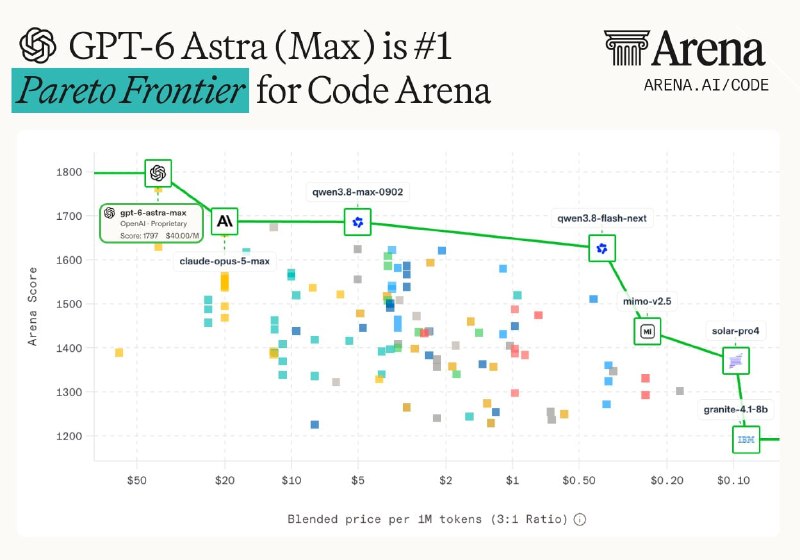
Первые впечатления от GPT-6 Astra — смешанный восторг.

Восторг потому что это реально ну очень крутая модель. Выдал большую задачу по кор-продукту одного из своих бизнесов, утром получил готовый докер-образ и отчёт по метрикам. Формулировал на уровне бизнеса, без деталей, кодовая база огромная в десятках репозиториев. Fable с аналогичными запросами справляется, но гораздо дольше, постоянно перепроверяет и норовит залезать в бесконечные циклы.

Забавно, потому что месяц назад у меня было противоположенное мнение, новый Opus 5 после релиза работал прекрасно, а Sol уходил в пике перепроверок и сомнений.

А смешанный восторг потому что пару раз словил фильтр «Кажется, модель делает не то, что вы хотите» и вариантов продолжить нет, только начать новый чат. И промты формулировать надо очень чётко, модель прям цепляется за ваши слова, неаккуратность может сильно изменить результат. В теории это ровно то, что и хотелось бы от моделей, но надо себя дисциплинировать и подбирать слова.

И да, я понимаю, что многое зависит от промтов и обвеса. Если правильно настроить, любая модель может выдавать результат более близкий к тому что ты сам ожидаешь. Но это вот мои субъективные мнения, никакие специальные настройки я не применяю сейчас, только заветы Карпатого для кодинга.

На картинке — куда приземлилась Astra Max на код арене. На максималках получилась самая дорогая и самая умная модель по кодингу.

Как у вас впечатления, на чём кодите сейчас?

@neuro_channel
  • ❤ 12
  • 👎 2
  • 🍌 2
Post #2836 2.36K
По поводу оптимального уровня рассуждений для GPT-6 Astra. Похоже, что тут нет однозначного ответа, как с предыдущими моделями. На разных бенчмарках модель ведёт себя по разному.

Для общих вопросов большинство тестов, которые я смотрел, сходится на том, что уровень выше high не очень оправдан, цена поднимается, а точность не увеличивается. На каких-то даже снижается на xhigh.

Для программирования вот есть Coding Agent Index, где на каждом уровне модель очень хороша, оптимальными выглядят на мой вкус low, medium и xhigh, а вот max включать смысла нет особо, стоимость удваивается, а точность иногда даже падает.

По моим ощущениям токены на Astra кушают очень быстро, так что поставил low по умолчанию, а для сложных задач попросил вызывать саму себя на более высоких уровнях рассуждений. Вести задачу к цели low вполне хватает.

@neuro_channel
  • ❤ 8
  • 🔥 3
  • ✍ 1
Post #2835 2.27K
llama.cpp выпустила версию 0.4.0. Теперь раз в несколько недель проект собирает накопленное из ежедневных билдов в один релиз с обзором изменений. Что важного для тех, кто гоняет модели локально:

🔘 Новые архитектуры: Qwen3.8-Flash-Next (пока без оптимизаций), Nemotron-3-Puzzle 75B с 9 млрд активных, DSpark для Nemotron 3.5, nanbeige4.2-3B.

🔘 Разреженное flash attention для DeepSeek-V4, GLM и Qwen3.8-Flash-Next на CUDA и Metal.

🔘 Ленивое чтение тензоров --lazy-mode: большие таблицы эмбеддингов не грузятся в RAM целиком, а читаются через mmap по мере надобности (автоматически для тензоров больше 4 ГБ). Плюс убрали пик потребления памяти при загрузке модели.

🔘 У квантизатора появился потолок рабочей памяти --max-buffer-size, по умолчанию 8 ГБ. Раньше один большой тензор мог съесть всю оперативку.

🔘 Сервер: лимит контекста на слот --kv-unified-per-slot, чтобы параллельные запросы не делили одно окно как попало; видео на вход через --video-*; медиа можно передавать data:-ссылками; preserve_reasoning включён по умолчанию.

🔘 В ggml 0.23.0 появился Apple RDMA как транспорт для RPC между машинами.

@neuro_channel
  • 🔥 12
  • ❤ 3
Post #2834 2.07K
Microsoft AI выпустила MAI-Image-2.6-Flash, быструю версию своей картиночной модели: по заявлению компании, рисует в 2,8 раза быстрее GPT-Image-2-Medium при сопоставимом качестве и на 72% эффективнее. Старшая MAI-Image-2.6 в тот же день вышла из закрытого превью в Microsoft Foundry в публичное; на Arena она вторая и в генерации, и в редактировании, у Artificial Analysis вторая в генерации и первая в редактировании.

Обе модели умеют собирать сцену из нескольких референсов (люди, товары, стили с разных картинок), подтягивать факты из веба и сами выбирать соотношение сторон, разрешение до 1,5K.

Попробовать можно в MAI Playground, API в Foundry.

@neuro_channel
  • ⚡ 4
  • ❤ 2
Post #2833 2.3K
С выходом GPT-6 Astra инструкции для агентов пора чистить, пишет разработчик из команды Codex. За год у всех накопились раздутые skills и AGENTS․md под прошлые модели, и теперь они мешают: описания skills съедают контекст, «читай доки перед каждой правкой» жжёт токены, а жёсткие «сначала спроси» останавливают модель там, где вы были бы рады продолжению.

Самое простое: скормить Astra эту статью и попросить её саму провести аудит ваших skills и AGENTS․md. Что выкинуть первым и как это переносится на Claude Code, коллеги разобрали на сайте.

@neuro_channel
  • ⚡ 8
  • ❤ 2
Post #2832 2.08K
Microsoft Research открыла VibeVoice-ASR-Streaming, потоковое распознавание речи, которое сразу пишет, кто что сказал, без отдельного этапа диаризации. Модель принимает звук кусками фиксированной длины с небольшим заглядыванием вперёд и выдаёт реплики с метками спикеров по ходу разговора. Можно передать список имён и терминов, чтобы она их не коверкала. Десять языков, русский в списке.

По доле ошибок распознавания (WER для слов, CER для китайских иероглифов) 7B-версия в среднем лучше Gemini 3.5 Transcribe Live, ElevenLabs Scribe v2 Realtime и потоковых моделей OpenAI на пяти наборах записей встреч, хотя на двух Gemini впереди, график на картинке. По атрибуции спикеров лучший или равный лучшему результат в 12 из 13 настроек.

Веса версий с бэкбонами 1,5B и 7B под MIT, код на GitHub, отчёт на arXiv, есть демо.

@neuro_channel
  • 👍 5
  • ❤ 1
Post #2831 1.78K
Кстати, по вчерашнему запуску GPT-6 Astra: ещё один сброс лимитов начислили всем на аккаунты. Так что если у вас закончилось — смело жмите. Ну или отдохните на выходных, в понедельник можно продолжить кодить :)

@neuro_channel
  • ⚡ 3
  • 🔥 2
  • ❤ 1
Post #2830 2.12K
Институт фундаментальных моделей MBZUAI выпустил K2 Horizon, шесть открытых моделей от 0,9 до 375 млрд параметров под Apache 2.0, и обещает открыть к ним весь процесс обучения: промежуточные чекпоинты, данные или рецепты их сборки, код, конфиги и подробные логи от претрейна до агентного пост-трейна. Авторы называют это первым открытым семейством, где можно проследить, как у модели появляются рассуждения, вызов инструментов и планирование.

Размеры: 0,9B для часов и очков, 3,7B и 7B для телефонов, плотная 32B и MoE 36B с 4 млрд активных для локальных машин, 375B с 23 млрд активных для серверов. Три малых модели авторы называют лучшими в своих классах, у 0,9B больше 48 баллов на AIME 2026. 36B-A4B почти догоняет плотную 32B за счёт новой разреженной схемы внимания MoVA в связке с MoE-слоями; на картинке её сравнение с Nemotron 3, Gemma 4 31B и GPT 5.6 Luna: впереди всех в агентных задачах в терминале и с инструментами, отстаёт на Humanity's Last Exam, длинном контексте и научном коде.

Веса всех шести, а для большинства и FP8 с GGUF лежат на HuggingFace.

@neuro_channel
  • ❤ 4
Post #2829 1.78K
Ant Group выложила LLaDA-Image, открытую модель с диффузионным трансформером на 6 млрд параметров, которая и генерирует картинки, и редактирует их по инструкции одним чекпоинтом. Устройство необычное: и языковой бэкбон, и картиночная часть здесь диффузионные, обучены в одной рамке. Есть базовая версия на 50 шагов и Turbo на 4 шага, обе рисуют текст на английском и китайском.

На Qwen-Image-Bench модель первая среди открытых, впереди Z-Image Turbo и HunyuanImage 3.0, но до закрытых не дотягивает: FLUX.2 Max, Seedream 5.0, Qwen-Image 2.0 Pro и Nano Banana 2.0 выше, GPT-Image 2 впереди почти на 12 баллов, график на картинке.

Веса лежат на HuggingFace под Apache 2.0, есть FP8-варианты и демо Turbo. Код обучения обещают позже.

@neuro_channel
  • ❤ 3
Post #2828 1.82K
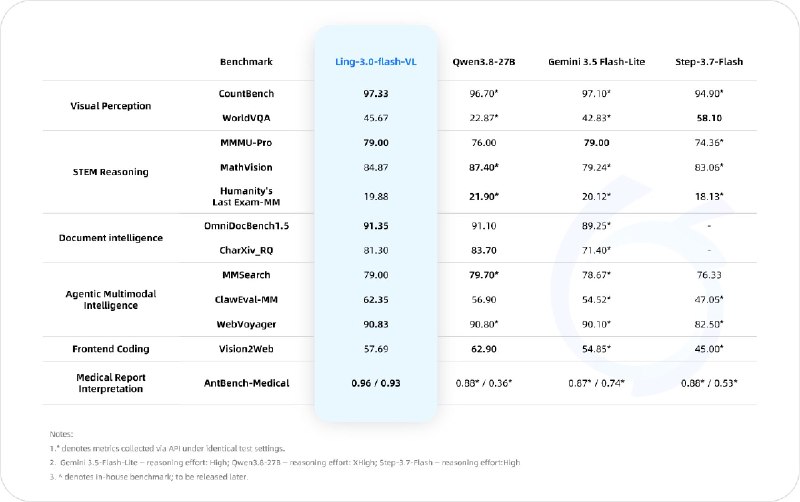
Ant Group выпустила Ling-3.0-flash-VL, зрячую версию своей Ling-3.0-flash: MoE, 5,1 млрд активных из 124, теперь с пониманием картинок и визуальными агентными задачами. Сравнивают с Qwen3.8-27B, Gemini 3.5 Flash-Lite и Step-3.7-Flash, таблица на картинке.

Впереди по подсчёту объектов, распознаванию документов в OmniDocBench, агентным задачам с картинками (ClawEval-MM с заметным отрывом, WebVoyager) и на собственном тесте по чтению медицинских заключений, в MMMU-Pro вровень с Gemini. Отстаёт от Qwen3.8-27B в математике по картинкам, Humanity's Last Exam, чтении графиков и вёрстке по скриншоту, а в WorldVQA сильно уступает Step-3.7-Flash.

Весов и страницы модели пока нет: ни на HuggingFace, ни на ModelScope. У текстовой Ling-3.0-flash лицензия MIT.

@neuro_channel
  • ❤ 2
Post #2827 2.02K
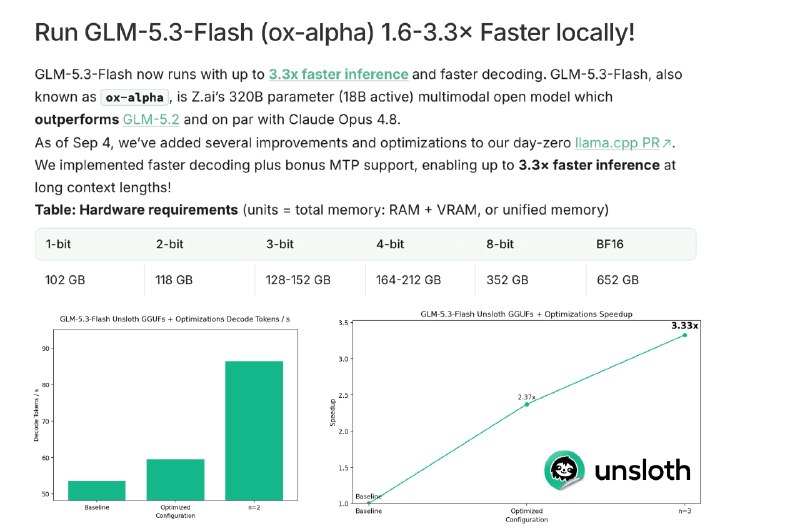
Локальная GLM-5.3-Flash стала быстрее в 1,6–3,3 раза: Unsloth дописали свой pull request в llama.cpp, ускорили декодирование и добавили поддержку MTP, предсказания нескольких токенов за шаг. Ничего докачивать не нужно, кванты те же, что и неделю назад: в Unsloth Desktop достаточно обновиться, в llama.cpp собрать их ветку по гайду.

Прирост растёт с длиной контекста, графики на картинке. На коротких промптах ускорение до 1,6 раза, на 64 тысячах токенов ещё без MTP скорость выросла больше чем вдвое. С MTP лучший вариант два черновых токена, при трёх и пяти скорость снова падает.

Требования не изменились: 1-битный квант в 100 ГБ памяти, 3-битный в 128 ГБ, как у Mac Studio или DGX Spark.

@neuro_channel
  • ❤ 4
Post #2826 2.13K
Для тех кто ещё сидит на Claude: лимиты только что сбросили для всех Max-планов. Говорят, впереди выходные, приятного мол вам кодинга.

Нам бы лучше сброс Codex, новая Astra сама себя не протестирует! 👾

@neuro_channel
  • 🔥 10
  • ❤ 3
  • 👍 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →