TGViewer
Channel Public Channel
Нейроканал

Нейроканал

@neuro_channel

Искусственный интеллект, нейросети, машинное обучение

Разместить рекламу: @tproger_sales_bot

Правила общения: https://tprg.ru/rules

Другие каналы: @tproger_channels

Сайт: https://tprg.ru/site

Зарегистрирован в РКН: https://tprg.ru/vcEg
Subscribers
11.7K
Photos
894
Videos
243
Links
2K
Recent Posts 20 shown
Post #2907 737
Tencent выложила WeVisDoc, модели на 2 и 4 млрд параметров, которые превращают снимок страницы в Markdown: текст, таблицы в HTML, формулы в LaTeX. Веса под Apache 2.0, в основе дообученные Qwen3-VL-Instruct.

Вместе с моделью команда опубликовала бенчмарк PureDocBench, где эталон берут прямо из исходного HTML/CSS страницы: при аудите OmniDocBench 1.5 авторы насчитали 2580 подтверждённых ошибок разметки на 21 353 проверенных блока. Одну и ту же страницу показывают в трёх видах с одинаковым правильным ответом: чистый рендер, десять сценариев цифровой порчи и четыре способа съёмки, вплоть до распечатки, снятой на телефон.

На чистом OmniDocBench первое место у PaddleOCR-VL 1.6 с 96,33 балла, а на порченых страницах у неё 66,98. У WeVisDoc-4B 95,38 и 75,54: в идеальных условиях уступает, в реальных выигрывает.

Русского в обучении нет, только китайский, английский и смешанные страницы. Я взял страницу из Википедии, добавил наклон, блик и шум под съёмку с рук и прогнал через модель: формулы вышли целыми, вплоть до erf и производящей функции моментов, в сплошном тексте местами опечатки вроде «с ником в центре» вместо «с пиком», а карточку со сводкой параметров модель отдала простым текстом вместо таблицы. Страница на RTX 3080 заняла две минуты, веса в bf16 занимают 9,4 ГБ видеопамяти.

@neuro_channel
  • ❤ 3
  • 👍 2
  • 🔥 1
Post #2906 1.3K
StepFun выпустила Step 5 Preview, и Artificial Analysis уже её замерили: 44 балла в индексе интеллекта. Столько же у Kimi K3 с её 2,8 трлн параметров, на балл больше у GLM-5.3 и Qwen3.8 Max, а GPT-5.6 Terra и DeepSeek V4.1 Flash позади с 42 и 40.

Модель при этом сравнительно небольшая: MoE, 27 млрд активных из 600, контекст 1M, на вход берёт текст и картинки, отвечает со скоростью около 100 токенов в секунду. Цена $1 за миллион токенов на входе и $2,7 на выходе, кеш со скидкой 95%. Рассуждает она многословно: на прогон индекса ушло 160 млн выходных токенов при медиане 90 млн, так что часть экономии съедается.

Четвёртую версию StepFun пропустила, прошлой была открытая Step-3.7-Flash. Весов Step 5 нет, модель работает только через API самой StepFun.

@neuro_channel
  • 👍 3
  • 🔥 2
Post #2905 1.4K
На следующей неделе ожидается сразу несколько крупных релизов. Расскажу про самые интересные.

Kimi в китайской соцсети выложил длинную строку цифр без единого слова. Это знаки числа пи, которые идут после 3,1, так что Moonshot, похоже, готовит K3.1.

Grok 4.7 Маск обещал к 12 сентября, потом написал, что модели надо «ещё несколько дней повариться», и заранее оценил её как «примерно Opus 5.0, не 5.1». 17 сентября grok-4.7 заметили в квотах Google Cloud. Обычно модель появляется там за несколько часов до релиза, но прошло уже два дня. Дальше у Маска в планах Grok 4.8 на 2,5 трлн параметров, 4.9 уровня Astra и Fable и Grok 5, его кандидат в AGI.

Альтман перенёс на следующую неделю главный релиз, которого ждали в четверг, по слухам это GPT-6 Sol, младшая и более дешёвая версия Astra. А 29 сентября у OpenAI DevDay, и к нему обещана ещё пачка запусков.

Во вторник в Ханчжоу открывается Apsara, ежегодная конференция Alibaba, она идёт 22–24 сентября. Qwen3.8-Flash-Next уже работает на экспериментальной архитектуре Qwen4-Exp, и в SGLang под неё с конца августа набралось больше двадцати пул-реквестов и багов.

От Z․ai ждут GLM-5.5. Аналитики JPMorgan в июне обещали её к августу, но тогда вышла GLM-5.3, и теперь слух ходит с сентябрьским окном и 3 трлн параметров. Компания молчит, но 13 сентября привлекла в Гонконге $5 млрд и около 60% направит на следующее поколение GLM.

Gemini 4 по прогнозам выходит в ноябре–декабре, но с 17 сентября на Арене под вывеской gemini-3.8-flash попадается модель, которая рисует SVG и 3D-сцены не на уровне Flash. Тестировщики считают её чекпойнтом Gemini 4 Pro с кодовым именем argon, так что релиз может быть и раньше.

Из более далёкого: у Google во внутреннем тестировании всплыл DeepThink V3 Mathematica для математики, у Anthropic в августе засветились идентификаторы claude-marshmallow и claude-melon, а DeepSeek, по словам давнего наблюдателя за компанией, держит модель на 3 трлн параметров до расширения кластеров.

Похоже, скоро снова будет жарко, ждём-ждём 👾

@neuro_channel
  • ❤ 11
  • 👍 9
Post #2904 1.63K
Qwen выложила Qwen3.8-Omni-Flash: на вход текст, картинки, звук и видео, контекст 1M токенов. Час звука на входе подешевел больше чем на 98% относительно прошлой Qwen3.5-Omni-Plus, час звука с видео на 93%. По аудио модель обходит Gemini 3.8 Flash, по связке звука с видео идёт вровень.

Интереснее всего, как она смотрит длинное видео. Раньше запись прогонялась от начала до конца, даже если ответ лежит в паре минут. Теперь агент сам решает, какие куски посмотреть и послушать, и подбирается к ответу в несколько заходов от грубого к точному. На OmniVideoBench точность выросла с 63,4 до 67,8, а расход токенов упал со 145 736 до 79 117.

Весов нет, модель живёт только в API. Зато открыли Qwen-MM-Plugins, набор, который добавляет звук и видео в готовые агентные харнессы, и Qwen-Live Harness под реалтайм-версию, он ставится командой npm install -g qwen-live-harness. Попробовать можно на платформе Qwen.

@neuro_channel
  • ❤ 4
  • ✍ 3
  • 🎉 3
Post #2903 1.79K
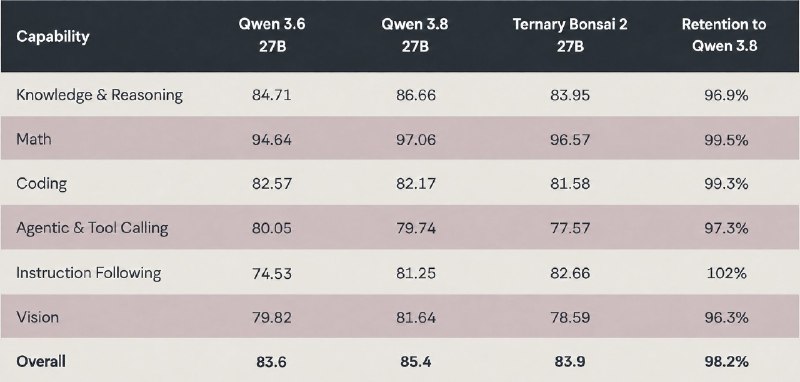
PrismML выпустила Ternary Bonsai 2 27B: тернарное сжатие теперь сделано поверх Qwen3.8 27B. Размер тот же, 5,9 ГБ против примерно 54 ГБ у полновесной модели, а качество подросло. По тестам самой PrismML сохраняется 98,2% от оригинала, у первой версии два месяца назад было 95%.

Математика и код почти вровень с исходной Qwen3.8, в следовании инструкциям сжатая версия даже чуть выше. Сильнее всего проседают зрение и общие знания, но и там потеря в пределах 4%. Контекст 262K, картинки на входе и вызов инструментов на месте.

Веса лежат на HuggingFace под Apache 2.0 в GGUF и MLX. Обычный llama.cpp эти файлы не запустит, нужен форк PrismML с их ядрами. На RTX 4090 авторы получили около 90 токенов в секунду, на MacBook с M5 Pro 28.

@neuro_channel
  • ❤ 12
  • 🔥 8
Post #2902 1.73K
Стелс-модель Union Alpha раскрылась: это Pareto 26.9 от компании The Unbiased Company. Вчера я писал, что это похоже не на модель, а на агрегатор с маршрутизацией, так и вышло. Никакого обучения не было: внутри несколько моделей, открытых и фронтирных, работают над одной задачей, обвязка проверяет результат и зовёт модель посильнее, если задача сложная. На вопросе, как пожарить яичницу, отвечает та, что дешевле.

Стелс-запуск делали вместе с OpenRouter, OpenCode и Cloudflare, чтобы посмотреть на живых пользователях перед публичным релизом 26.10 в следующем месяце. В среду спрос дошёл до миллиардов токенов в минуту, полетели те самые Error error, на которые я жаловался. AWS за ночь утроил мощности, и этого всё равно не хватило.

Сейчас включают платный доступ: $2,5 за миллион входных токенов, $0,25 за кэшированные и $7,5 за выходные. У Astra $10 и $50. По своим замерам Pareto вровень с Astra на DeepSWE (74), отстаёт на Terminal-Bench (51 против 58), HLE (49 против 54) и ArXivMath (88 против 91). Промпты и ответы не хранят, на OpenRouter модель теперь зовётся unbiased/pareto.

@neuro_channel
  • 👍 4
  • ❤ 3
  • 😁 2
Post #2901 1.71K
Ещё были слухи, что сегодня GPT-6 Sol выложат, якобы она и быстрая и недорогая и умная почти как Astra. И сотрудники OpenAI всячески тизерили, что скоро большой релиз, мол ждите.

Но потому передумали и написали, что откладывается до следующей недели.

Была статья о том, как GLM помогает делать GLM, мне кажется скучновато.

В Claude объединили код, дизайн и всё-всё в один инструмент, подают как большую новость, но по мне как это просто логично, но не особо критично, и так было понятно где что делать, вопрос в лимитах скорее и способности адекватно понимать указания человека.

Будет что-то ещё стоящее — буду писать, пока так к этому часу.

@neuro_channel
  • ❤ 10
  • ✍ 4
  • 👀 4
Post #2900 1.66K
Стелс-модель Union Alpha скорее всего не модель, а агрегатор, который передаёт запросы в модели попроще и собирает ответ. Возможно из нескольких вариантов, а может просто выбирает самую подходящую модель каждый раз.

Это не точно, но исследователи, которые пытаются понять что это нам такое подсунули сходятся на таких мыслях.

У этой модели есть свой акк в Х, можно читать что они там делают.

На мой вкус модель хорошая, решила для меня несколько задач не хуже Astra, но часто упирается в рейт-лимит, а иногда начинает тупить. Это очень похоже как раз на неконсистентный выбор маршрута к конечным моделям.

@neuro_channel
  • 👍 3
Post #2899 1.63K
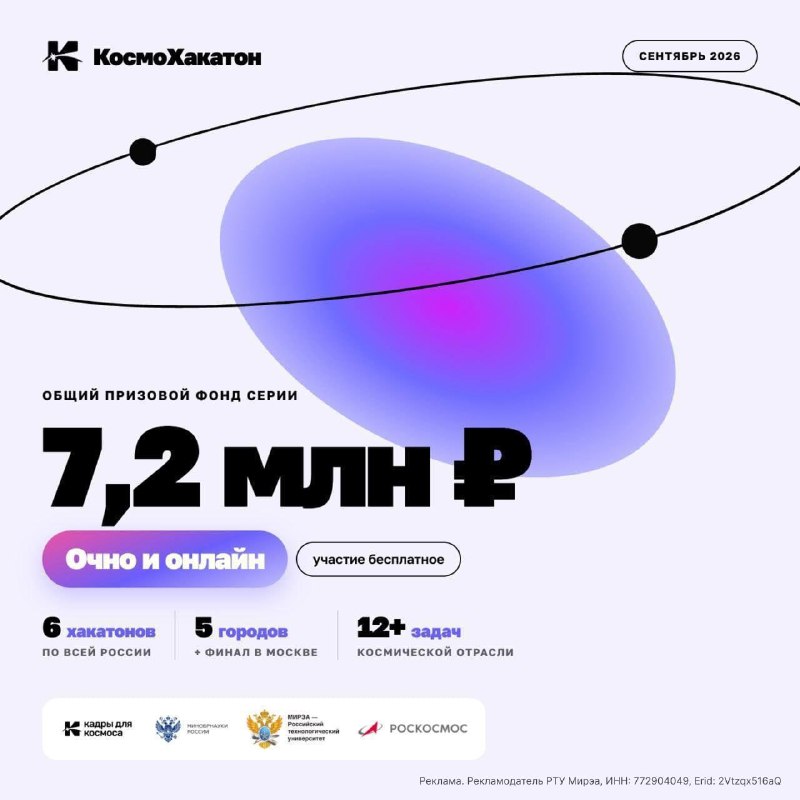
Космический хакатон. Санкт-Петербург, Красноярск или онлайн из любой точки страны.

Старт 18 сентября.

Для разных городов разные задачи, а за выходные участники должны представить рабочие решения.

Санкт-Петербург. К 2035 году над Землёй должен работать топливный узел, у которого заправляются корабли, и откуда он будет получать топливо — с Земли, с Луны или из резерва — пока не решил никто. Команде предстоит собрать схему поставок, посчитать резервы и решить, во что вкладываться сразу. Призовой фонд 1,2 млн ₽.

Красноярск. Спутник видит горящий лес раньше любого наземного поста, но вместе с пожаром ловит нагретые крыши, факелы на месторождениях и блики на воде. Команде предстоит научить сервис отличать настоящий очаг от шума, обвести гарь и выдать площадь в гектарах. Призовой фонд 600 тыс. ₽.

Лучшие забирают приз на площадке и билет в финал в Москве, 25–27 сентября, где разыграют ещё 2,4 млн рублей.

Команда 3–5 человек, недостающих можно найти на платформе.

Регистрация по ссылкекосмохакатон.рф

Реклама. Рекламодатель РТУ Мирэа, ИНН: 772904049, Erid: 2Vtzqx516aQ
  • ❤ 2
Post #2898 1.55K
Ling-3.0-flash-VL, про которую писал полторы недели назад ещё без весов, теперь лежит на HuggingFace под MIT. MoE, 5,5 активных из 124, на вход текст, картинки и видео, контекст 256K. На OpenRouter есть бесплатный вариант, платный стоит $0,06 за миллион входных токенов и $0,18 за выходные.

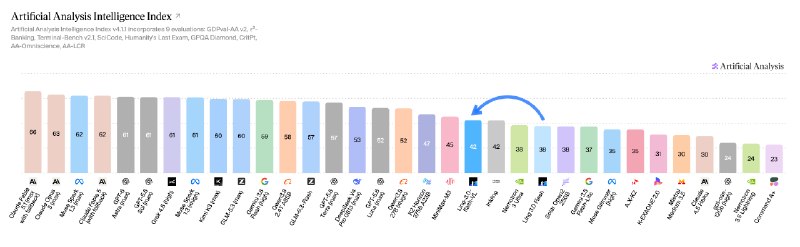
Внутри 42 слоя, где KDA и Gated MLA чередуются 5 к 1, плюс VideoRoPE, который кодирует и положение в кадре, и порядок во времени, отсюда поиск событий в длинном видео. На Artificial Analysis Intelligence Index модель набрала 42 против 38 у текстовой Ling-3.0-flash, то есть добавление зрения подняло и общий индекс.

Локально запускается через SGLang, готовый docker-образ и рецепты в карточке; на полные 256K контекста нужны четыре карты класса H200.

@neuro_channel
  • 🔥 5
Post #2897 1.56K
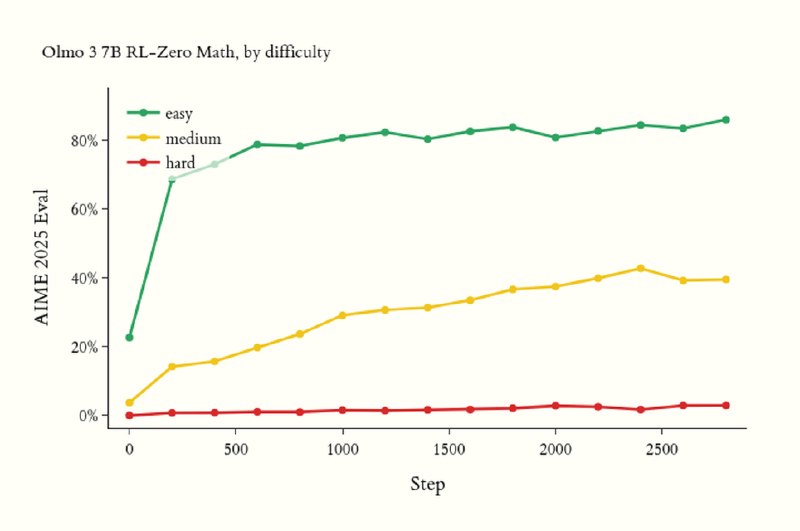
RL-дообучение улучшает модель пропорционально тому, что она уже умеет: лёгкие задачи становятся легче, трудные почти не сдвигаются. Автор Olmo 3.1 RL-Zero Math разбирает это на AIME. Если разбить 30 задач на три корзины по стартовому pass@1 (0%, 3,8% и 22,7%), почти весь рост средней метрики даёт переход лёгких задач из «иногда решаю» в «в основном решаю». Та же картина на code RL у Deepcoder и на агентном RL у DeepSWE.

Причина не только в том, что на трудную задачу не выпадает ни одного верного ответа и градиента нет. Большой k, по 32 сэмпла на промпт, чаще ловит редкое решение трудной задачи, но ещё чаще ловит редкую ошибку на лёгкой, и батч забивается лёгкими задачами. В эксперименте на GSM8k маленький k=4 после 200 шагов обгоняет k=32.

Предложенный метод Never Give Up: сэмплировать по 4, задачу с нулём верных ответов с вероятностью 0,9 отправлять на новый круг, а решённую 4 из 4 отфильтровывать сразу. На GSM8k это обходит GRPO с любым фиксированным k, сильнее всего на трудной корзине. Статья на arXiv и код в посте.

@neuro_channel
  • 👍 4
Post #2896 1.76K
Mozilla выпустила отчёт State of Open Source AI: лучшая открытая модель отстаёт от закрытого лидера на три пункта при 60% цены, и разрыв обнуляется каждый цикл релизов. Весной лучшая закрытая модель набирала 60, лучшие открытые 54, а годом раньше лидер открытых имел 22. По оценке Epoch AI, на которую ссылается отчёт, открытые модели отстают от закрытых примерно на четыре месяца.

Семь из десяти моделей в верхушке таблицы отчёта китайские. На OpenRouter китайские модели дают больше 45% недельного трафика, сама платформа пропускает 25 трлн токенов в неделю, и самый большой источник этого трафика открытая модель. Kimi K3 дебютировала первой в Frontend Code Arena LMArena с 1679 Elo, на Terminal-Bench 2.1 набирает 88,3 против 88,8 у Sol, а на FrontierSWE уступает Fable 5: 81,2 против 86,6.

В таблице лицензий у GLM-5.2 и обеих DeepSeek V4 чистый MIT, у Kimi K3 и Qwen3.8-Max свои лицензии с обязательной атрибуцией. До прода открытые модели доходят на 12 пунктов реже закрытых, и причина, по опросу Mozilla и SlashData, в тулинге, а не в способностях.

@neuro_channel
  • ❤ 7
  • 🔥 1
Post #2895 1.88K
Swift-Qwen3.8-27B от UkisAI это та же Qwen3.8-27B, только думает вдвое короче. LoRA-адаптер срезает медианную длину рассуждений на 58% при потере меньше 1% качества, на практике это ускорение в 1,95 раза. На LiveCodeBench v6 результат даже вырос с 76,8 до 81,6 при экономии токенов в 24%, а вот AIME 2026 просел с 98,7 до 94,0.

Рецепт такой: авторы нашли токены-маркеры, которые запускают у Qwen переобдумывание, и дообучили модель со штрафом за них. Экономия держится на всех уровнях reasoning_effort, от low до xhigh.

Лицензия своя: бесплатно для любого использования, пока годовая выручка меньше $1 млн, выше нужна корпоративная. GGUF для llama.cpp лежит отдельно, его уже скачали 55 тысяч раз. На видео параллельный прогон задачи из LiveCodeBench: база против Swift.

@neuro_channel
  • ❤ 3
Post #2894 1.67K
Новая эта стелс-моделька умная, но медленная. Вот ещё один бенч с ней приехал. И вы посмотрите за какую цену какие результаты, это новый парето-оптимум будет.

Я успел одну задачку только ей отправить, она такая задумчивая, неспешная, но что-то в этом аристократичное ощущается, делает работу чётко. Пока первое впечатление, может изменится в будущих постах, не верьте наслово :) Но пробовать точно стоит.

@neuro_channel
  • ❤ 5
  • 👍 3
Post #2893 1.72K
На OpenRouter появилась новая стелс-модель Union Alpha: мультимодальная, под исследования, код и агентные сценарии, бесплатная на неделю. Разработчик, как обычно у стелсов, анонимен, промпты и ответы он хранит, но на обучение не берёт.

Контекст 262K, до 131K токенов на ответ, на входе текст и картинки, tool calling и JSON-режим без строгой схемы. Работает через одного провайдера, и он небыстрый: около 23 токенов в секунду и 17 секунд до первого токена. Модель думает скрыто: в моём прогоне лимит в 300 токенов на ответ целиком ушёл на рассуждения, а в ответ попали два слова. На вопрос «кто ты» отвечает «Union Alpha, создатель анонимен».

Из бенчмарков пока только внутренний замер OpenCode на Terminal-Bench v4.0, они выложил его в ответ на вопрос о результатах: около 52% при ожидаемой цене примерно $1,6 за задачу. Это выше Claude Opus 5 (max), GLM-5.3 (max) и GPT-5.6 Sol (max), чуть ниже GPT-6 Astra (high), и по цене на Парето-линии между GLM-5.3-Flash и GPT-6 Astra. В треде гадают на MiniMax M3.1 или Kimi K3.1, самой модели про это не известно. Прошлый стелс Ox Alpha оказался GLM-5.3-Flash от Z․ai, так что через неделю-две узнаем.

Подключается как stealth/union-alpha в любом OpenAI-совместимом клиенте, в OpenCode она уже в списке.

@neuro_channel
  • ❤ 5
  • 🔥 1
Post #2892 1.56K
llama.cpp выпустила 0.4.1, и за ту же неделю обновились почти все движки локального инференса. Что важного для тех, кто гоняет модели у себя:

🔘 llama.cpp 0.4.1: новые архитектуры Maple 20B-A1B (тернарный MoE, пока только CPU), Tencent Hy 4 и Spark2.5. Флаги --mmap, --mlock и --direct-io убрали, вместо них единый --load-mode. Появился --log-jsonl для структурированных логов, --reasoning-preserve включён по умолчанию, у конвертера флаг --fuse-qkv. Починили нормализацию GDN для Qwen, Kimi и GLM и выделение KV-кэша под MTP у DeepSeek и GLM-MoE. DeepSeek V4.1 Flash и GLM-5.3-Flash пока не поддерживаются, PR открыты.

🔘 vLLM 0.29.0: Model Runner V2 стал дефолтом для всех моделей, старый уберут в 0.32. Prefix caching для Mamba даёт 9–25% к времени первого токена, python -m vllm.entrypoints.openai.api_server объявлен устаревшим в пользу vllm serve, all-reduce через FlashInfer включён по умолчанию.

🔘 SGLang 0.5.19: beam search через beam_width, lean attention на AMD до 1,52x по пропускной способности, W4A8 MoE на Hopper даёт DeepSeek-V4-Flash около 12% к выходному throughput.

🔘 Ollama 0.34.1: ollama create из MLX safetensors вышел из экспериментального статуса, а для GGUF теперь нужен тулинг llama.cpp; список моделей /api/tags на больших библиотеках отвечает за 294 мс вместо 3,1 с. В 0.34.0 модели Ollama подключаются к ChatGPT Desktop.

🔘 exllamav3 1.5.0: быстрее prefill и decode у MoE. Qwen3.8-Flash-Next на RTX Pro 6000 прибавила 27% на prefill и 14% на decode, а с выгрузкой 80% весов на CPU через новый pinned arena prefill вырос на 54%.

🔘 halogen-flash-server: движок под одну карту и одну модель, Strix Halo и Qwen3.8-Flash-Next, без слоя переносимости. На промпте в 32K токенов полный ответ за 29 с против 118 с у других сборок под то же железо, 56 tok/s на ходе coding-агента, всё при 85 Вт. С версии 0.7.0 открывает обычный GGUF от llama.cpp.

@neuro_channel
  • ❤ 7
  • 👍 2
  • 🔥 1
Post #2891 1.54K
Claude Code 2.1.273 починил авто-компакт: счётчик контекста считал ходы advisor-инструментов примерно вдвое больше их реального размера, поэтому сжатие срабатывало примерно на половине окна. Если в последние дни контекст схлопывался подозрительно рано, дело было в этом.

Там же две дыры в правах. Bash-команды, которые проверяльщик прав не мог разобрать целиком, проскакивали без запроса при permissions.blockReadsOutsideWorkingDirectories, а сабшелл мог спрятать опасный rm в bypass-режиме. Ещё откатили изменение из 2.1.268: команды вроде time -p make build снова спрашивают разрешение вместо отказа.

Из нового: сессию, запущенную с --remote-control, теперь можно форкнуть из приложения Claude, форк уходит фоновой сессией на твой компьютер. Плюс уведомление, когда MCP-сервер отвалился и переподключение сдалось, и заголовки-подсказки для LLM-шлюзов по CLAUDE_CODE_GATEWAY_HINT_HEADERS=1.

@neuro_channel
  • 👍 3
  • 🤔 1
Post #2890 1.68K
Google выпустила Gemini 3.8 Live и 3.8 Live Extended Thinking, голосовые модели, которые думают и говорят одновременно. Extended Thinking заняла первое место в Speech to Speech Quality Index у Artificial Analysis с 82,6 балла и лучше всех доводит агентные задачи до конца: 68,6% на τ-Voice и 35,1% на банковском τ-Voice-banking от Sierra.

Главное отличие от прошлых Live-моделей в фоновой работе. Вызовы инструментов и API идут параллельно разговору, модель говорит «сейчас проверю» и продолжает беседу, а по ходу длинной задачи проговаривает прогресс. И это прям меняет опыт по сравнению с тем же GPT, попробуйте. Обычная 3.8 Live обрабатывает видеопоток почти в реальном времени и сама переключается между 97 языками посреди разговора.

Обе модели уже доступны в Gemini API и AI Studio, Extended Thinking ещё и в Gemini Live и в Workspace для подписчиков AI Pro и Ultra. На видео Extended Thinking превращает наброски и голосовые правки в React-компоненты.

@neuro_channel
  • ❤ 7
  • 👍 2
Post #2889 1.78K
TypeSafe AI, лаборатория соавтора InstructGPT из OpenAI, выпустила Jev: модель, которая не пишет текст. Она отвечает только на типизированные вопросы: выбрать вариант из списка, поставить оценку по шкале или сказать «да» либо «нет», и к каждому ответу прикладывает вероятности.

В запрос кладёшь произвольный текст (письмо клиента, JSON с состоянием приложения) и словарь вопросов на обычном английском: «какая команда должна этим заняться» с вариантами billing, technical, sales; «насколько клиент раздражён» по трём уровням; «есть ли срочность». Все вопросы модель считает параллельно за один вызов и возвращает technical с вероятностью 0,84 и уверенностью 0,6. Дальше решает твой код: при высокой уверенности маршрутизировать автоматически, при низкой отдать человеку. Промпт «ответь одним словом» и парсер поверх ответа не нужны, ответ вне списка невозможен в принципе по устройству модели.

Ответ приходит за 70–500 мс, миллион входных токенов стоит $0,042, выход бесплатный. По замерам самих TypeSafe это в 40–200 раз быстрее и на два порядка дешевле GPT-6 Astra и Fable 5.1 на таких задачах. Руководитель evals в Every прогнал через Jev 37 своих статей с 21 вопросом про признаки ИИ-текста: 777 вердиктов за 0,7 секунды и четверть цента. В его же тесте на дефекты в тексте Jev нашёл 6 из 7, Fable 5.1 все 7, но в 25 раз медленнее и в 580 раз дороже.

Объяснить выбор или написать ответ клиенту Jev не умеет, для этого рядом нужна обычная LLM. Вариантов в одном выборе до 255. Доступ по листу ожидания, SDK для Python и JS уже лежат на GitHub.

@neuro_channel
  • 🔥 3
  • 👍 2
Post #2888 1.73K
LLM-стройка — канал про то, как работают ИИ-агенты и модели: инференс (префилл, декод, KV-кэш), почему бенчмарки моделей переписывают уже после релиза (как с GPT-6 Astra), как строится память агента при повторных обращениях пользователя и другие темы, связанные с ИИ.

Ещё один фокус канала — персональные данные: обезличивание до инференса, чтобы ФИО и номера не оседали в логах и RAG-индексе. Автор сама делает инструменты под эти задачи: например, ZamenaLab — тул для обезличивания документов в браузере, без сервера. Кстати, если хотите, можете помочь его потестить!

Реклама. Рекламодатель: Грекова Наталья Александровна, ИНН:614103713518, erid: 2W5zFJEZ513
Telegram LLM-стройка Тут про то, что происходит между модель классно отвечает в чате и система работает у клиента. Про качество, трейсинг агентов, промпты, обезличивание данных и тд. Показываю и рассказываю (даже если сломалось) Сотрудничество, воркшопы – @ai_researcherka
Older posts →

About this channel

How can I read @neuro_channel without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Нейроканал: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Нейроканал have?
Нейроканал (@neuro_channel) has 11.7K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Нейроканал know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →