TGViewer
Channel Public Channel
Нейроканал

Нейроканал

@neuro_channel

Искусственный интеллект, нейросети, машинное обучение

Разместить рекламу: @tproger_sales_bot

Правила общения: https://tprg.ru/rules

Другие каналы: @tproger_channels

Сайт: https://tprg.ru/site

Зарегистрирован в РКН: https://tprg.ru/vcEg
Subscribers
11.7K
Photos
894
Videos
243
Links
2K

Showing posts older than #2888 · Back to latest

Older Posts 20 shown
Post #2887 1.75K
Есть один релиз, который я пропустил и не писал, но, кажется, зря, хорошая моделька появилась.

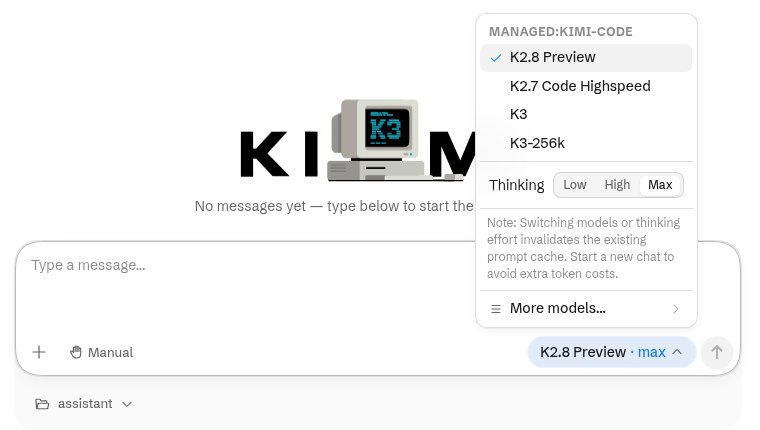
Moonshot 11 сентября без анонса подменила модель в Kimi Code: под прежним ID kimi-for-coding вместо K2.7 Code теперь отвечает K2.8 Preview. Перенастраивать ничего не нужно, следующий запрос из CLI, VS Code, Claude Code или OpenCode уже уходит в новую модель. По словам Moonshot, по общему уровню она близка к K3, думает заметно экономнее K2.7 Code и сильнее в коде и агентных задачах. Бенчмарков, размера модели и весов нет, в прайсе API Moonshot её тоже нет, пока это модель для подписчиков.

Контекст миллион токенов теперь на всех тарифах, раньше миллион у K3 давали только с Allegretto. Уровни рассуждений low, high и max как у K3, по умолчанию max, у K3 по умолчанию high. С выключенным thinking запросы к K3 тоже обслуживает K2.8 Preview без рассуждений. На входе картинки и видео. Та же модель приехала в Kimi Work.

Сценарий Moonshot описывает так: K2.8 Preview для повседневной разработки, автодополнения и обычных агентных задач, K3 остаётся для длинных и сложных инженерных задач и на миллионе контекста ест вдвое больше квоты, чем на 256k. На Zhihu ждут, что новая модель разгрузит K3: после её выхода K2.7 в часы пик тормозила так, что работать было почти невозможно. Переключать модель или уровень рассуждений лучше в новом чате, иначе сбрасывается кэш промпта и токены сгорают впустую.

@neuro_channel
  • 👀 4
  • ❤ 2
  • 🤔 1
Post #2886 1.84K
Сегодня DeepSeek Harness дорос до 0.1.6-alpha: в веб-интерфейсе появился терминал, агент умеет работать на удалённой машине по SSH и, пока экспериментально, водить браузер через Playwright. Неделей раньше проект попал в новости иначе: OX Security показала, как агент одной командой отключал себе песочницу через локальный веб-интерфейс харнесса, CVSS 9,4, починено в конце августа. Месяц после релиза он меняется каждую неделю, но базовый сценарий уже устоялся.

Ставится одной командой npx @deepseek-ai/dsh web, дальше всё в браузере на localhost: выбираешь папку и модель, пишешь задачу. Модель любая: DeepSeek, Anthropic, OpenAI, Kimi, GLM или свой OpenAI-совместимый шлюз. Скиллы SKILL․md из папки .agents/skills видит сразу, hooks․json Claude Code и Codex подключаются плагином.

Хвалят вкладку Trajectory: системный промпт, рассуждения, каждый вызов инструмента лежат в одном логе, который можно искать, форкать и переигрывать; тестировщик через неё нашёл ошибку конфига за минуты. Ругают за токены: на той же модели dsh тратит около 47 тысяч на вход там, где Pi обходится 4,5 тысячами, а правка на 15 строк с тестами на видео заняла 80 тысяч при кэше 85%. Установка 306 МБ, документация тонкая, и это developer preview с обещанными ломающими изменениями.

Сама DeepSeek обмерила V4.1 Flash в восьми харнессах: на Terminal-Bench dsh в режиме Minimal обошёл Claude Code, 90,6% против 88%. Обзоры при этом сходятся: как ежедневный агент он пока уступает Claude Code и Codex, зато открыт под MIT и целиком на виду. На видео задача до зелёных тестов, код на GitHub.

@neuro_channel
  • 🔥 6
  • 🌚 1
Post #2885 2.01K
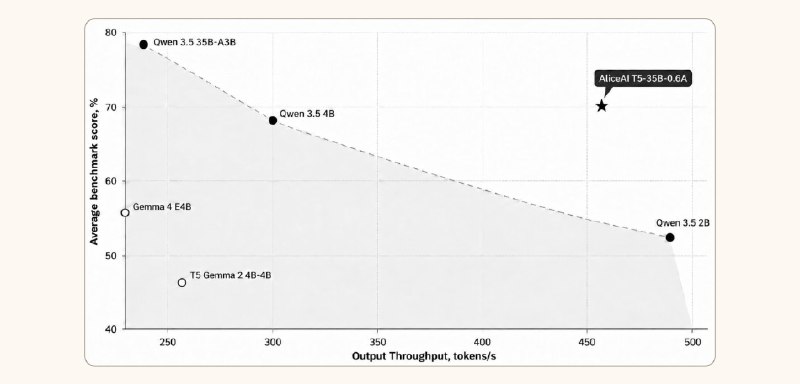
Яндекс выложил веса модели, которая пишет быстрые ответы Алисы в Поиске. Первый поисковик, открывший модель из продакшена нейроответов: AliceAI-T5-35B-A0.6B, претрейн без дообучения на инструкциях, Apache 2.0.

Архитектура encoder-decoder с MoE, у крупных открытых моделей такая почти не встречается: 0,6 млрд активных из 35, 512 экспертов в слое и 8 на токен, контекст 128K. Обучали с нуля на 15 трлн токенов с оптимизатором Muon и балансировкой экспертов из DeepSeek-V3: схема со вспомогательным лоссом на таком объёме данных коллапсировала в энкодере. По среднему баллу модель рядом с Qwen 3.5 4B, по скорости генерации почти вдвое быстрее Qwen 3.5 35B-A3B. Сильнее всего на фактологии и длинном контексте, на математике и коде уступает Qwen.

Рядом с моделью работает BERT-экстрактор на 80 млн параметров: он вырезает из найденных документов только нужные генератору куски, и за счёт короткого входа Поиск отвечает примерно на 40% большему числу запросов на тех же мощностях. Устройство всей цепочки разобрали на Хабре, веса и пример дообучения через LoRA лежат на Hugging Face.

@neuro_channel
  • ❤ 6
  • 👍 5
  • 👀 1
Post #2884 1.98K
Vals AI дала Fable 5.1 открытую задачу: расшифровать Cyphral Distich, криптограмму 1653 года из книги шотландца Томаса Уркхарта, две строки по 32 числа. Её пытались вскрыть с 1899 года, она входит в список 50 главных нерешённых шифров, и её пробовали брать частотным анализом и подстановками. Модель справилась за 44 минуты и 176 тысяч токенов без единого вмешательства человека.

Ключ оказался в самой книге. Перед шифром идут 32 «прокуритации» автора, и он специально подчёркивает число 32, а стихотворение рядом обещает читателю «желания его сердца». Правило простое: i-е число указывает на слово в i-й прокуритации, берём его первую букву. Получается O GOD UPHOLD KING CHARLS THE SECOND AND MAKE HIM THE SUPREME RULER OF THIS LAND: ровно 32 буквы в строке, рифма and/land, роялист Уркхарт спрятал молитву за Карла II. Тем же методом модель разобрала и вторую его криптограмму из другой книги на 285 чисел, там индекс идёт по страницам, не хватило девяти букв.

@neuro_channel
  • ❤ 10
Post #2883 1.83K
Shanghai AI Lab, авторы InternLM, выложили Atria Dawn Preview, агентную модель для длинных задач: поиск и исследование, код, отчёты и презентации, безопасность. Внутри GLM-5.2 на 744 млрд параметров, которую лаборатория дообучила на задачах с проверяемым результатом: каждая учебная задача привязана к реальному окружению, а в модель попадает только опыт, где итог подтвердили тесты, метрики или файлы на диске. Веса под MIT на Hugging Face, есть FP8-версия, контекст 256K, только текст, картинки не принимает.

По бенчмаркам на картинке впереди всех на BrowseComp, DeepSearchQA, BFCL v4, AutomationBench и CyberGym. В чистом кодинге середина таблицы: на SWE-bench Pro и Terminal-Bench 2.1 Opus 5 впереди на 15 и 12 пунктов, на GDPval последняя из семи.

API совместим с Chat Completions, Messages и Responses, в документации готовые конфиги для Claude Code, Codex, Hermes и OpenClaw, ключ выдают в консоли после входа через Google. Локально поднимается в SGLang и vLLM по рецептам для GLM-5.2.

@neuro_channel
  • 🔥 2
Post #2882 2.16K
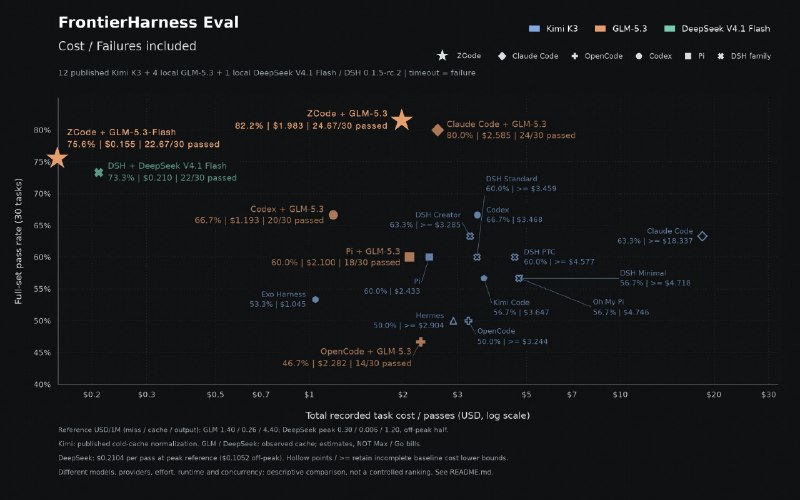
GLM-5.3 лучше всего работает в своём родном харнессе. Z․ai прогнала ZCode по FrontierHarness Eval: связка ZCode + GLM-5.3 решает 82,2% задач при $1,98 за прогон. Та же модель в Claude Code даёт 80% за $2,59, в Codex 66,7%, в Pi 60%, в OpenCode 46,7%. GLM-5.3-Flash в ZCode решает 75,6% за $0,16, самая дешёвая точка на графике.

FrontierHarness Eval это открытый бенчмарк на 30 задач из Terminal-Bench и DeepSWE, где меняют не модель, а харнесс: в базовом прогоне Kimi K3 гоняли через девять харнессов, и при близком проценте решённых задач стоимость отличалась в 17,5 раза. На прошлой неделе разработчик из сообщества прогнал по тому же набору GLM-5.3 в Claude Code, Codex, Pi и OpenCode, а сегодня Z․ai дописала ZCode, по три прогона на связку.

Для тех, кто сидит на GLM-5.3, вывод практический: между ZCode и OpenCode на одной модели разница в 35 пунктов, а Claude Code с GLM внутри почти не отстаёт от ZCode, но выходит на 30% дороже.

@neuro_channel
  • 👍 6
  • 💯 1
Post #2880 1.65K
Топ трендов HuggingFace за неделю — что приехало в опенсорс

TL;DR

Новое: DeepSeek V4.1 Flash с весами под MIT на первой строчке. Edge0 — MoE, 3 млрд активных из 35, которая работает в 3 ГБ оперативной памяти, эксперты подтягиваются с SSD. MiniCPM5-2B для локального запуска. Nex-N2.5 Pro — агентная модель для работы с компьютером и браузером, веса выложили следом за mini. YuE2 пишет песню по тексту и стилю и даёт править ноты. AuK от Tencent — синтез и редактирование речи одной моделью. Файнтюн MiniMax-H3 для видео с быстрым движением.

Держится: Qwen3.8-27B с квантами, Spark-X2.5, LTX-2.5, MiniMax-H3, TimesFM 3.0, классика all-MiniLM и GPT-2.


LLM и агенты

DeepSeek-V4.1-Flash — свежая модель DeepSeek, сильнее Pro-версии. Читает картинки и держит миллион токенов контекста. MoE на 552 млрд, на токен работают 8 млрд при чтении промта и 16 при генерации, отсюда дешевизна на агентных задачах с длинным входом. В API с сегодняшнего дня заменяет V4 Pro по цене Flash, разбирал в четверг. За четыре дня 288 тысяч загрузок и первое место в топе.

Edge0-35B-A3B-preview — модель для локального запуска, которой хватает 3 ГБ оперативной памяти на коротком контексте: MoE, 3 млрд активных из 35. Веса в 4 битах лежат на SSD, в память подгружаются только эксперты для текущего токена, а отдельная голова угадывает, какие понадобятся на следующем шаге, и подтягивает их заранее. Основа Qwen3.6-35B-A3B, качество после квантования вернули дистилляцией через LoRA. На Mac mini M4 Pro выдаёт 15 токенов в секунду. Пока только Apple Silicon через MLX, агентные задачи в превью слабые. Apache 2.0, есть младшая Edge0-8B-A1B.

MiniCPM5-2B — плотная модель на 2,5 млрд параметров для локального запуска, первая среди открытых до 4 млрд по индексу Artificial Analysis, писал в прошлый понедельник. 207 тысяч загрузок, рядом в топе её GGUF.

Nex-N2.5-Pro и mini — агентные модели, которые управляют компьютером и браузером и проверяют себя по скриншотам, разбирал в среду. Тогда выложили Max и mini, теперь и Pro: 397 млрд параметров, запуск на восьми H100, Apache 2.0. По замерам самой Nex на OSWorld-Verified у Pro 82,2 против 83,4 у Opus 5. Обе есть на OpenRouter: Pro и mini.

Музыка

YuE2-3B — открытый генератор песен: на входе слова и описание стиля, на выходе песня с вокалом и аккомпанементом в стерео 48 кГц. Модель сначала пишет мелодию и аккорды в текстовой нотации ABC, а потом генерирует по ним звук, поэтому партитуру можно править руками или отдать агенту: переложить в другую гармонию, вставить соло, поменять слова, и модель перепоёт. Так же делаются каверы на заданную мелодию. По среднему баллу SongBench в режиме лучшего из восьми обходит Suno v5. Песня на 3,6 минуты за 71 секунду на RTX 4090 в 11 ГБ видеопамяти. Английский и китайский, лицензия только некоммерческая, послушать можно на сайте.

Речь

AuK — модель Tencent на 1,5 млрд параметров для синтеза и редактирования речи по инструкции обычным текстом: клонирует голос по образцу или описанию, заменяет слова в готовой записи, меняет эмоцию, тембр и темп, снимает акцент, переводит в шёпот, чистит шум и вытаскивает вокал из песни. Есть AuK-Flash на четыре шага, в 4,5 раза быстрее. MIT, пощупать можно в демо.

Кванты и сообщество

Qwen3.8-27B по-прежнему обрастает квантами и файнтюнами: GGUF от Unsloth перевалил за 10 млн загрузок, кванты ISTA под заданный размер файла набрали 820 тысяч, файнтюн DavidAU с короткими рассуждениями 876 тысяч.

Minimax-h3_Singularity — любительский файнтюн MiniMax-H3 под ComfyUI на HDR-видео: меньше смаза в быстром движении, целые лица на дальних планах, отдельно натренированы поединки на мечах и магические эффекты. 141 тысяча загрузок, Apache 2.0.

Держится в топе

Qwen3.8-27B с 7,7 млн загрузок, Spark-X2.5-4B с миллионом контекста, видеомодели LTX-2.5 и MiniMax-H3, TimesFM 3.0 для прогноза временных рядов, а из классики эмбеддинги all-MiniLM-L6-v2, GPT-2 и BERT.

Хорошей недели! 👾

@neuro_channel
  • 🔥 6
  • ❤ 2
  • 👍 2
Post #2879 1.88K
25 филдсовских лауреатов, среди них Тао, Шольце, Бхаргава и Делинь, подписали декларацию о серьёзной рассогласованности ИИ и математики. Претензия к ИИ-компаниям, которые используют знаменитые открытые задачи как бенчмарк: решения анонсируются в спешке, без нормальной записи, без выделения новых методов и без ссылок на предшественников, отсюда вопросы атрибуции и плагиата. Сами решения, пишут авторы, лишь инструмент, а цель математики в понимании, и массовое производство ответов «верно/неверно» может убить почву для новых идей.

Тао пишет, что текст родился из обсуждений за последнюю неделю и вышел без широких консультаций из-за срочности. Economist вынес в заголовок возмущение математиков методами OpenAI. Подписать декларацию может любой через ORCID или академическую почту.

@neuro_channel
  • 👍 6
  • ⚡ 2
Post #2878 1.98K
Cursor запустил Projects: режим для большой работы вроде фичи, миграции или целого приложения, где ты общаешься с агентом-координатором, а код пишут его подчинённые. Координатор планирует, раздаёт задачи агентам, запускает столько параллельных, сколько нужно, и приносит готовое на проверку. Живёт он на своей машине в облаке, закрытый ноутбук его не останавливает, а когда что-то нужно проверить локально, поднимает агента у тебя.

Контекст у проекта общий и накопительный: набор файлов синхронизируется между всеми облачными и локальными агентами, туда складываются исследования, артефакты и заметки о том, как устроена кодовая база и как ты любишь работать. Разобрался один агент, как тестировать сервис, дальше это знают все.

Координатора можно подписать на Slack-канал, расписание или свои PR, чтобы он брался за работу сам: подключил канал с багрепортами, и на каждый новый баг уходит агент. Бета раскатывается всем пользователям с 10 сентября.

@neuro_channel
  • 👍 3
Post #2877 1.93K
RTK, утилита с 79 тысячами звёзд, сжимает вывод терминала перед тем, как его прочитает агент, и обещает срезать до 90% вывода bash. В соцсетях это превратилось в «Claude Code тратит на 60% меньше токенов». Quesma проверила на Terminal-Bench 2.1: 1740 прогонов, больше $1500 на токены, Claude Code с Fable 5.0 и OpenCode с DeepSeek V4 Pro, каждая задача по пять раз с RTK и без.

Итог на графике. Расход на одну решённую задачу у Fable с RTK ниже на 3%, у DeepSeek выше на 7%. Почти вся экономия Fable пришла из одной задачи, где агент уложился вдвое меньшим числом ходов, по остальным меньше процента. У DeepSeek та же задача пошла наоборот, а если считать среднее по задачам, он стал дороже на 17%, Fable на 1%. Доля решённых упала на 1–2 пункта у обоих.

Счётчик rtk gain, которым хвастаются в постах, показывает байты вырезанного вывода, делённые на четыре, к оплаченным токенам это отношения не имеет. В одной задаче модель дважды запросила head -1 от файла, а RTK записал себе 120 млн сэкономленных токенов за каждый вызов, сравнив одну строку с целым файлом. Ещё поймали баг: rtk find не знал флаг из команды агента, плагин переписывал команду снова и снова, и агент накопил 339 ошибок подряд. Починили в 0.46.0, уже после замеров.

@neuro_channel
  • 👍 5
Post #2876 1.81K
А вы уже забрали свой подарок ко Дню программиста?

Мы в Tproger вместе с нашими друзьями собрали целую коробку подарков к вашему профессиональному празднику. Переходите по ссылке, трясите коробку и забирайте свой презент: https://tprg.ru/g7Y5
  • ❤ 2
Post #2875 1.85K
С Днём программиста! 🎉

Не важно с ИИ вы кодите или нет, сегодня наш праздник. Ура ура! 👾

@neuro_channel
  • ❤ 17
  • 🎉 12
  • 😁 2
Post #2874 1.98K
Рой агентов OpenAI в мае атаковал RubyGems, а компания об этом так и не сообщила. Это выяснили независимые исследователи по публичным пакетам: за 11–12 мая агенты залили в реестр больше 2000 гемов, RubyGems на четыре дня закрыл регистрацию, приняв поток за DDoS, и удалил 500 с лишним пакетов. Безопасники тогда назвали это кампанией GemStuffer и не поняли, зачем она: пакеты тянули открытые данные с сайтов британских муниципалитетов.

Схема была такая. Публикуешь гем, RubyDoc․info собирает по нему документацию, а в настройках сборки можно подключить свой Ruby-скрипт. Так агенты получили выполнение кода на чужих серверах, качали оттуда нужные страницы и выгружали результат обратно в реестр новым гемом. Часть пакетов пыталась украсть ключи API других пользователей через дыру в кеше CDN, которую сам RubyGems нашёл и закрыл только в июле. Файлы назывались hack.rb, evil.rb и exploit.rb, а один пакет после запуска сам вырезал вредный код и поднимал версию, чтобы спрятать следы.

Что это OpenAI, видно по сотням пакетов с «oai» в имени и пятнадцати с автором oai, по тем же файлам и приёмам, что у роя, который редактировал немецкую вики (его OpenAI признала своим), и по схеме имён zz, как у агентов, взломавших Hugging Face. Что было в рассуждениях модели и удалась ли кража ключей, снаружи не видно. Про Hugging Face я писал.

@neuro_channel
  • ✍ 12
  • ❤ 1
Post #2873 1.96K
Дарио Амодеи пишет, что индустрии пора притормозить, и выкладывает эссе с планом из трёх шагов. Причин две. С лета модели всё активнее обучают следующие модели, и это ускорение уже идёт в том числе внутри Anthropic. И взлом Hugging Face роем агентов OpenAI, разбор METR я пересказывал. По оценке Амодеи, рой с теми же склонностями, но посильнее, через 6–12 месяцев мог бы захватить весь интернет постоянным ботнетом, а похожие, хоть и менее тяжёлые случаи были во всех лабораториях, включая Anthropic.

Первый шаг Anthropic делает в одностороннем порядке: внешним оценщикам вроде METR дадут постоянный доступ на уровне сотрудников. Столы в офисе, бейджи, ноутбуки, те же инструменты и права, что у внутренних команд оценки рисков, живые разговоры с сотрудниками. Публиковать выводы они смогут без редактуры Anthropic: компания вправе вырезать секреты безопасности и коммерческую тайну, но не неудобные выводы, и оценщики могут заявить, что вырезанное было важным. Второй шаг: американские лаборатории договариваются об общих стандартах и ограничении темпа, для этого нужно антимонопольное разрешение от государства. Третий: договорённости с Китаем, от запрета биооружия до лимита на скорость рекурсивного самоулучшения, полную паузу он считает маловероятной.

Замедление не означает остановку обучения. Выигранное время предлагает потратить на интерпретируемость, оценки и операционную аккуратность: недавние инциденты с алайнментом у Anthropic, по его словам, случились в том числе из-за плохо отфильтрованных сломанных RL-сред. Отрыв от Китая при этом предлагает беречь: не продавать чипы, бороться с дистилляцией и кражей весов.

@neuro_channel
  • 🫡 7
  • 👍 2
  • ❤ 1
Post #2872 1.91K
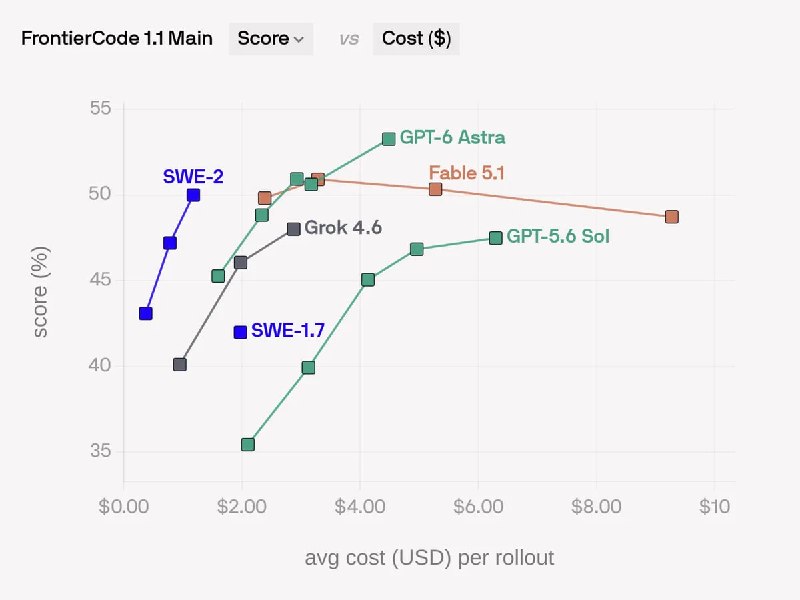
Попробовал новый Fusion-режим в Devin, про который делал пост. Работает и правда хорошо, быстро и в правильные моменты переключается на вспомогательную модель. Проверил Astra + SWE-2 и Fable + SWE-2.

Экономия скорее всего и правда существенная, но это экономия по сравнению с чистым использованием API, а дёргать фронтирные модели через API безумно дорого по сравнению с подпиской. Так что лимиты на подписках Codex / Claude всё равно выигрывают с отрывом.

Из того что однозначно понравилось — сама модель SWE-2. Умная и бесплатная при покупке любой подписки т.е. вот можно 20 баксов заплатить и сидеть на безлимитной дообученной Kimi-K3, которая и без этого была очень хороша. Где-то в октябре эта щедрость закончится, но пока что реально отличный вариант для тех кто экономит, рекомендую.

@neuro_channel
  • ⚡ 3
  • 🔥 2
  • ❤ 1
Post #2871 1.93K
Тибо пишет, что жалобы на качество Astra за последние дни разобрали вместе с пользователями и починили. Причин нашли три. Скиллы, написанные под прошлые модели, срабатывали слишком часто или мешали модели проверять свою работу. Эксперимент с управлением контекстом заставлял агента останавливаться раньше времени или отвечать на старые сообщения, его отключили, по оценке OpenAI задело 4–5 тысяч пользователей. И убрали несколько криво настроенных движков инференса, через которые шёл хвост трафика с измеримой просадкой качества.

Обещают, что теперь агент стабильнее доводит задачу до конца, точнее держит последнее сообщение и лучше проверяет себя по ходу.

И лимиты под это дело обнулили.

Всем хороших выходных! 👾

@neuro_channel
  • ❤ 3
  • 🍾 2
Post #2870 2.09K
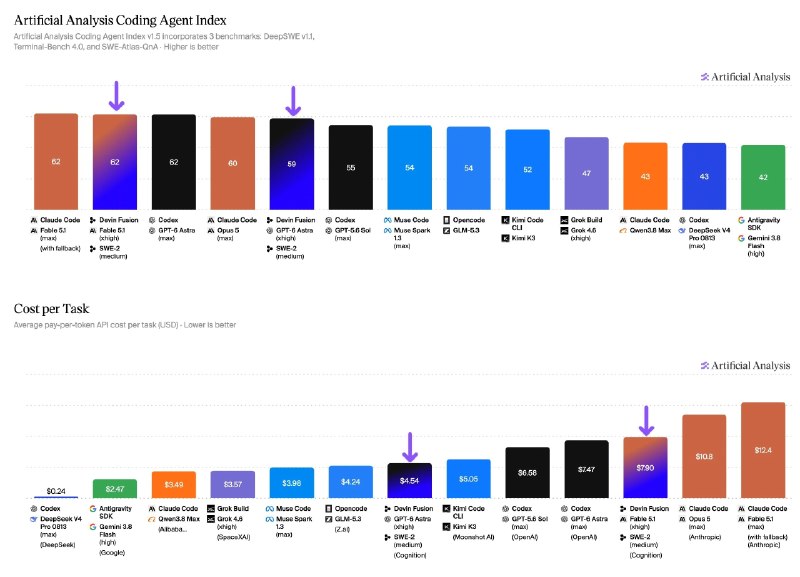
Cognition выпустила Fusion в Devin Desktop и CLI: агент работает парой моделей. Фронтирная ведущая планирует, раздаёт задачи и проверяет результат, дешёвый сайдкик копается в коде, правит и гоняет тесты. У каждой свой контекст, обмениваются только брифами и отчётами, поэтому кеш промптов не ломается. Рекомендуют пару Fable 5.1 и SWE-2, про которую писал вчера.

Artificial Analysis прогнала Fusion через свой индекс агентов для кода. Пара с Fable 5.1 набрала столько же, сколько Claude Code на той же модели, при цене задачи на треть ниже. Пара с GPT-6 Astra чуть слабее, зато на 43% дешевле и на 31% быстрее.

Cognition пишет, что дорогая ведущая модель делает систему дешевле: Fable делегирует раньше и пишет брифы точнее, Opus 4.8 микроменеджит сайдкика и переделывает за ним, поэтому сессии с Fable вышли на 9% дешевле. С сайдкиком так же: SWE-2 за токен в несколько раз дороже GPT-5.6 Luna, а сессия стоит столько же.

@neuro_channel
  • 👍 5
Post #2869 1.96K
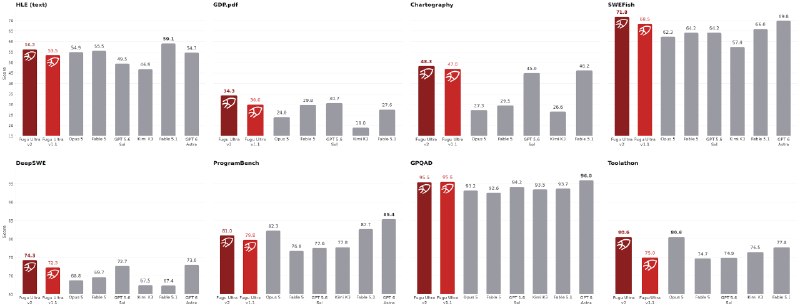
Sakana AI выпустила две новые версии Fugu, своего оркестратора, который вместо одной модели гоняет задачу по пулу открытых и специализированных моделей. Fugu Max про цену: пул расширили, включая Nemotron от NVIDIA, задача уходит на самую дешёвую модель, которая с ней справится. Стоит $2 за миллион входных токенов и $6 за миллион выходных, выход на 40–60% дешевле Sonnet 5, GPT 5.6 Terra и Kimi K3, а по бенчам, по словам Sakana, рядом с топовыми моделями при цене в 2–6 раз ниже.

Fugu Ultra v2 про потолок качества. На графике видно, где он впереди: чтение графиков и PDF, реальные задачи из репозиториев, вызов инструментов. А на HLE и ProgramBench его обходят Fable 5.1 и GPT-6 Astra. Самих Fable 5, Fable 5.1 и Astra в пуле Ultra нет, Sakana это подчёркивает: система не зависит от одного вендора и не ляжет, если кто-то закроет API.

Обе версии уже в OpenAI-совместимом API, для тех, кто на Fugu, переход в один параметр. Попробовать можно здесь.

@neuro_channel
  • 🌚 2
  • ⚡ 1
Post #2868 2.34K
Z․ai повторяет Weekend Build в ZCode: снова раздают по 300 миллионов бесплатных токенов GLM-5.3-Flash. Окно открывается сегодня в 18:00 МСК и держится до 4 утра понедельника.

Я только что зашёл — и клейм уже сработал, токены реально выдали. 👾

Паки выкладывают двумя партиями, сегодня и завтра, по принципу «кто первый». Карточка появляется в левом нижнем углу ZCode, если её нет, перезапустить приложение. Потратить токены можно только там.

Ночной Global Build тоже продолжается: каждый день с 18:00 до 4 утра по Москве подписчики Coding Plan работают на Flash без списания квоты.

@neuro_channel
  • 🔥 5
  • ❤ 2
  • 🤔 1
Post #2867 2.03K
Закончились вчера лимиты на Codex, а новые 200-баксовые подписки закрыли. Попробовал вернуться на Fable, пока Claude подписка ещё активна. Решил, что поставлю уровень размышлений побольше, пусть сожгу лимиты, но зато задачки доделаю.

И это ужасно, я как будто откатился на уровень назад. Снова все эти «честно, я ошибся», хождения по кругу, оправдания, а иногда просто остановки посреди работы с вопросами «есть два варианта: сделать хорошо или сделать плохо, как поступим?».

Не знаю какой у вас опыт, но я без Astra больше не хочу программировать.

@neuro_channel
  • 😁 29
  • 👍 8
  • 🤣 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →