TGViewer
Channel Public Channel
Нейроканал

Нейроканал

@neuro_channel

Искусственный интеллект, нейросети, машинное обучение

Разместить рекламу: @tproger_sales_bot

Правила общения: https://tprg.ru/rules

Другие каналы: @tproger_channels

Сайт: https://tprg.ru/site

Зарегистрирован в РКН: https://tprg.ru/vcEg
Subscribers
11.7K
Photos
894
Videos
243
Links
2K

Showing posts older than #2867 · Back to latest

Older Posts 20 shown
Post #2866 2.2K
GitHub выпустил Spec Kit 1.0. Это открытый набор инструкций для любого ИИ-агента, от Copilot и Claude Code до Codex и Cursor, который меняет порядок работы: агент сначала пишет спецификацию и план, и только потом код. У репозитория 135 тысяч звёзд.

Смысл в том, чтобы перестать объяснять задачу в чате по кругу. Ставишь Spec Kit в проект одной командой, дальше у агента появляются шаги: описать, что строим и зачем, составить план под свой стек, разбить его на задачи, сделать и в конце сверить готовый код с тем, что было записано. Все документы лежат в репозитории, их можно прочитать и поправить до того, как появится первая строчка кода. Для мелких правок это лишнее, а для новой функции на несколько файлов окупается: ошибку в постановке видно на спеке, а не на готовом коде.

За год появились дополнения: одно ведёт исправление бага по шагам «понять причину, починить, проверить, что симптом исчез», другое помогает решить, стоит ли вообще браться за идею. Мейнтейнер написал, что 1.0 больше не обещает стабильности: ломающие изменения агент теперь переносит сам, и версия стала просто числом.

Коллеги разобрали на сайте, как это устроено, и вместе с ним ещё десять инструментов для агентов с этой недели: ponytail, который заставляет агента писать вдвое меньше кода, ECC с готовым циклом «план, тест, ревью», humanizer против машинных оборотов в тексте и archify для схем архитектуры прямо из чата.

@neuro_channel
  • ✍ 5
  • ❤ 1
Post #2865 2.09K
Anthropic выпустила отчёт о злоупотреблениях Claude за восемь месяцев: кибератаки, пропаганда, слежка, мошенничество и дистилляция.

Самое громкое про дистилляцию. По версии Anthropic, китайские лаборатории через тысячи фейковых аккаунтов выкачивали рассуждения Claude для обучения своих моделей: Alibaba до 3 млн запросов в день, транскрипты пошли в Qwen 3.5–3.7. А Moonshot и DeepSeek, по данным отчёта, ещё и молча перенаправляли в Claude запросы собственных пользователей: те думали, что общаются с Kimi или DeepSeek, а ответы приходили от Opus, и вместе с запросами утекали их данные.

Вторая схема про дешёвый Claude. Anthropic описывает сайты, которые обещают доступ к Claude со скидкой и просят поставить свой клиент, часто похожий на Claude Code. Клиент оказывается стилером: забирает с компьютера ключи API и токены, а запросы покупателя уходят в другую модель. Украденные ключи потом продают хакерам, которые гоняют на них свои атаки.

Главный вывод отчёта по кибератакам: команда специалистов больше не нужна. Один хактивист на краденых ключах с агентами, как пишет Anthropic, проник в 14 из 42 европейских целей, а у одной из групп агенты сами пересобирали малварь, как только её ловил антивирус.

Читать отчёт целиком.

@neuro_channel
  • 😁 13
  • ❤ 1
Post #2864 4.2K
OpenAI останавливает продажу подписки Pro за $200: спрос на GPT-6 Astra такой, что не хватает мощностей. На странице тарифов Pro пока ещё висит, но новых подписчиков брать перестанут. Тибо пишет, что именно Pro сильнее всего нагружает системы, и это самый маленький шаг, который позволяет сохранить доступ к Astra всем остальным. Действующие подписки Pro не трогают, Plus и другие тарифы и API продаются как раньше.

В среду он предупреждал, что спрос на Astra беспрецедентный даже по меркам OpenAI, и пауза для новых Pro возможна, если так пойдёт дальше. Пошло. Мощности обещают наращивать, срока паузы нет.

@neuro_channel
  • 😢 9
  • ⚡ 3
  • 🍌 2
Post #2863 2.19K
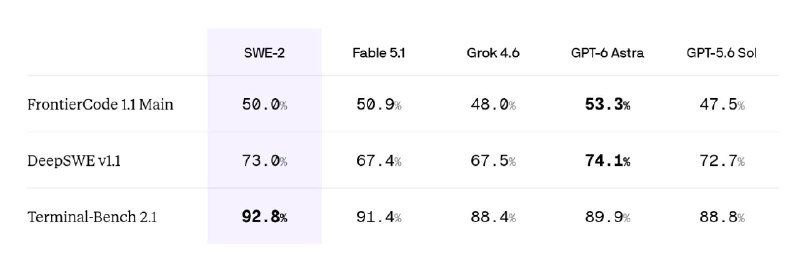
Cognition выпустила SWE-2, свою самую близкую к фронтиру модель для кода: на бенчмарках вровень с флагманами при цене до 70% ниже. Внутри Kimi K3 на 2,8 трлн параметров, поверх которой Cognition докрутила RL, впервые в таком масштабе.

Главная идея обучения в том, что все уровни рассуждений тренируются в одном прогоне RL, а штраф за стоимость подбирается под наклон кривой цена-качество у базовой модели. Так сдвигается вся кривая, а не одна точка на ней. Таблица на картинке: с Fable 5.1 и GPT-5.6 Sol вровень, до GPT-6 Astra не хватает нескольких пунктов при четверти её цены, на Terminal-Bench 2.1 обошла всех.

Поведение тоже поменялось: модель меньше копается в репозитории и раньше начинает править. На FrontierCode первое реальное редактирование делает в среднем на 18-м шаге против 48-го у SWE-1.7, ходов на 58% меньше, прогон на 81% дешевле.

Попробовать можно в Devin Desktop и CLI, в Devin Web выкатывают, разбор обучения в блоге.

@neuro_channel
  • 🔥 3
  • ❤ 1
Post #2862 2.05K
2007-й: весь двор обсуждает айфон без кнопок, в аське висит статус «учу уроки», на компе крутится Winamp. Анкета SpaceWeb и Типичного программиста проведёт тебя через все эти годы — от диалапа до нейросетей — и в конце скажет, кто ты в мире хранения данных.

Реклама. ООО «СпейсВэб», ИНН 7813376370, erid: 2W5zFJ67g3s
  • ❤ 2
  • 👍 1
Post #2861 2.19K
DeepSeek выпустила V4.1 Flash: во вторник писал про бету на два дня, а сегодня это релиз с весами под MIT и техотчётом. В API модель зовётся deepseek-flash, V4 Flash и Vision Exp сняты, их имена временно ведут на новую.

Внутри 552 млрд параметров при 8 млрд активных на входе и 16 на выходе: энкодер и декодер несимметричные, кэш KV в четыре раза меньше, чем у V4 Flash, на диске в восемь. Контекст миллион токенов, картинки на входе, глубина рассуждений задаётся числом от 1 до 100.

Агентные бенчмарки на картинке: DeepSWE 74,2 против 74,0 у Opus 5, CyberGym 88,1, AutomationBench 54,8, впереди Kimi K3 и GLM-5.3 везде. Terminal-Bench 3.0 слабее: 30,0 против 43,3 у Opus 5.

DeepSeek считает, что Flash обошла V4 Pro, и снимает Pro: с 14 сентября запросы к ней пойдут в V4.1 Flash по цене Flash, пока не выйдет V4.1 Pro. Цены с сегодняшнего дня: вход 0,3 $ за млн токенов, из кэша 0,006 $, выход 1,2 $, вне пиковых часов вдвое дешевле.

@neuro_channel
  • 🔥 12
  • ❤ 7
Post #2860 2.15K
Z․ai запустила Sovereign Partner Program: партнёр разворачивает GLM на своей инфраструктуре в своей стране и продаёт токены локально. Обещают ранний доступ к новым релизам GLM, инженеров Z․ai на внедрение, совместный выход на корпоративных клиентов и общий маркетинг.

Сейчас набирают первую когорту, заявка через форму, ограничений по странам в анонсе нет. Так что GLM у российского провайдера с оплатой в рублях теперь вопрос того, найдётся ли партнёр.

@neuro_channel
  • 🔥 10
  • 👍 1
  • 🌚 1
Post #2859 2.16K
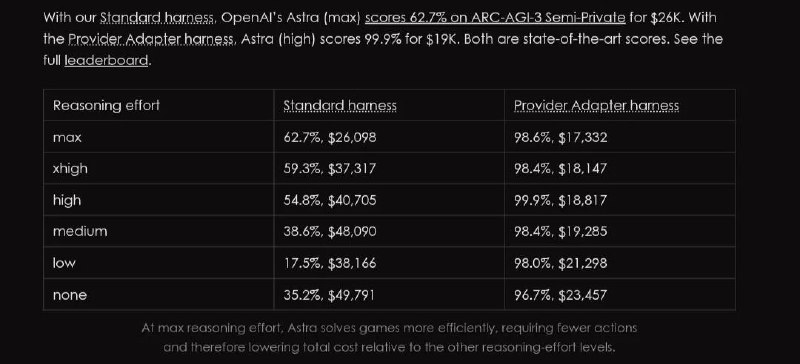
Неделю назад писал, что max у GPT-6 Astra включать смысла нет, цена удваивается. Для агентных задач всё выглядит наоборот. Разработчик заметил, что чем выше уровень рассуждений у Astra, тем меньше токенов она сжигает, и похожих наблюдений набралось из разных мест.

Самое наглядное у ARC Prize: на ARC-AGI-3 прогон Astra на max обошёлся почти вдвое дешевле, чем на low и medium, и дал лучший результат. На max модель точнее строит модель игры и делает меньше ходов, а каждый лишний ход это ещё один запрос с полным контекстом. Таблица на картинке.

С кодом похоже, но со своей границей. Разработчик сравнил одну задачу на Sol high и Astra на трёх уровнях: medium сделала реализацию за 80 запросов против 238 у Sol, входных токенов ушло втрое меньше, и вышло дешевле Sol. А вот high там не окупилась: дольше и дороже medium, а на ревью пропустила баг, который medium нашла. У других xhigh тоже ест меньше квоты, чем уровни ниже.

Механика простая: доплата за рассуждения на каждом шаге меньше экономии на числе шагов, когда задача длинная и агент много ходит по инструментам. На коротких вопросах это не работает, там уровень выше high только увеличивает счёт.

@neuro_channel
  • 👍 10
  • 😁 1
  • 🍌 1
Post #2858 2.03K
В Kimi Work появился Remote Control: агент остаётся запущенным на компьютере, а задачи ему ставишь с телефона. Kimi Work это настольный агент Moonshot с доступом к локальным файлам и браузеру.

В ролике сценарий такой: коллега просит к обеду обновить презентацию свежими данными, ты с телефона пересылаешь просьбу агенту, а он на десктопе ищет данные в браузере, находит нужные файлы на диске, правит слайды в исходном стиле и отправляет письмо с вложением. С телефона видно ход работы и можно вмешаться.

Попробовать можно на сайте Kimi.

@neuro_channel
  • 👍 3
Post #2857 2.03K
Codex сегодня вечером на полчаса перепутал лимиты: у одних недельная квота внезапно упала до нуля, у других, наоборот, подскочила. Меня тоже задело, в /usage показывало ноль. OpenAI завела инцидент «неожиданные сбросы лимитов» в 20:29 по Москве и закрыла в 20:54. Разработчик из команды Codex пишет, что лимиты вернулись к исходным значениям, и извиняется за путаницу.

По отчётам пользователей это выглядело как откат: квота вернулась ровно к тому значению, которое было до сброса, начисленного Тибо на неделе, а потом восстановилась. Обиднее всех тем, кто увидел ноль и потратил banked reset: сброс списался, а квота через пять минут снова обнулилась. Такие случаи разбирает поддержка в чате, за прошлые инциденты квоту возвращали.

Если после починки цифры всё ещё странные, в команде Codex просят написать им.

@neuro_channel
Post #2856 2.1K
Inception выпустила Mercury 2.5 в релиз, превью разбирал неделю назад. Цифры те же: диффузионная модель пишет текст блоками параллельно, 1107 токенов в секунду на обычных NVIDIA GPU, плюс 40% к интеллекту к Mercury 2, контекст 260K, уровень GPT-5.6 Luna на низком усилии и Haiku 4.5. По словам Inception, это самая большая диффузионная LLM из обученных.

Из нового в анонсе только кейсы клиентов, которые уже гоняют модель в проде. Augment Code перевела на Mercury сжатие контекста, маршрутизацию и поиск MCP-инструментов: сжатие ускорилось со 150 секунд до 27, цена упала на 90%. У OpenCall с голосовыми агентами медиана ответа модели около 170 мс. Рядом превью Mercury Voice с первым токеном быстрее 170 мс и Mercury Router, который читает запрос и раскидывает по чужим моделям.

Цена $0,20 за млн входных и $0,75 за выходные, на старте скидка 80%: $0,04 и $0,15. Есть в API Inception, на OpenRouter и Baseten, новым аккаунтам дают 100 млн токенов. Следующая модель уже обучается, обещают крупнее и в ближайшие месяцы.

В ролике модель собирает веб-приложение по паре промптов.

@neuro_channel
  • ❤ 3
Post #2854 1.92K
Xiaomi открыла закрытую бету MiMo Desktop, настольного агента, и даёт участникам бесплатный доступ к моделям следующего поколения. Официально они названы MiMo-X-Pro-Preview и MiMo-X-Flash-Preview; слухи про MiMo-V3-Pro идут от утечки бенчмарков, но ни в анонсе, ни на HuggingFace, ни в чейнджлоге платформы такого имени нет.

Агент берёт офисные файлы, картинки, видео, аудио и архивы и отдаёт готовый редактируемый результат: слайды, сайты, приложения, 3D. Что заявлено:

🔘 живые превью в сессии: игры, дашборды и демо запускаются прямо там, без локальной настройки фронтенда;
🔘 правка по выделению: обвёл область, описал изменение, обновляется только она, версии с откатом;
🔘 диспетчер сам выбирает модель и раскладывает работу на параллельные подзадачи;
🔘 управление браузером и всем компьютером, с записью и повтором сценариев;
🔘 попадание в кэш до 99% в сессии и до 95% между сессиями.

В ролике собранный агентом шутер. Мест мало, заявка на бету через сайт, ЕС, Британию и Корею не пускают.

@neuro_channel
  • 🔥 7
  • ❤ 5
  • 😍 2
Post #2853 1.88K
Nex-AGI выложила Nex-N2.5, следующее поколение агентных моделей после Nex-N2, про которую писал в июне. Три размера: mini, Pro и Max, и главная новость это Max: текстовая MoE на 1,6 трлн параметров, первый у Nex пост-трейнинг триллионного масштаба. Контекст 262K, Apache 2.0, веса Max и mini уже на HuggingFace, Pro обещают позже, mini и Pro есть на OpenRouter.

По таблице самой Nex, на картинке, Max сильна в агентных задачах: AutomationBench 50,2 против 50,3 у Opus 5, BrowseComp 92,6, выше Opus 5 и Kimi K3. В коде отстаёт: SWE-Bench Pro 65,7 против 79,2 у Opus 5. Чужие цифры взяты из отчётов вендоров, свои прогоны на собственном харнесе.

Репозиторий Max весит 1,65 ТБ, рекомендуемый запуск два узла по восемь H200. Для дома интереснее mini: 35 млрд параметров на базе Qwen3.5-MoE, мультимодальная, управляет компьютером и браузером, запуск на двух H100. Pro и mini на OSWorld-G обходят Opus 5 и Sol, на остальных компьютерных бенчах уступают.

Карточка модели, код на GitHub.

@neuro_channel
  • ❤ 4
Post #2852 2.12K
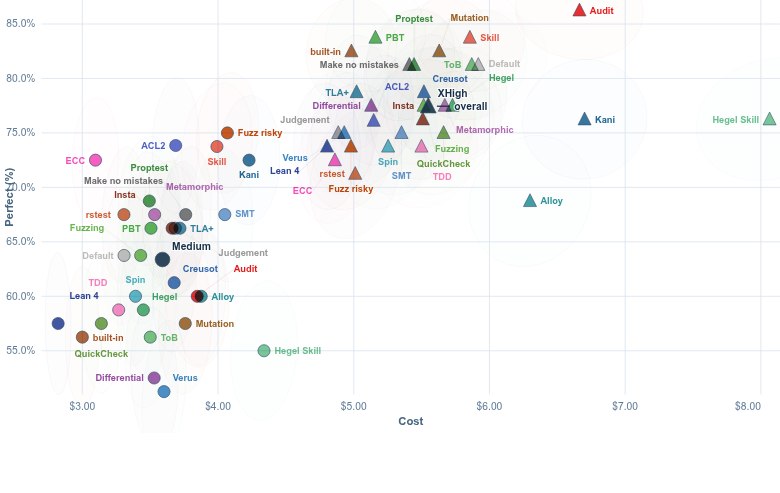
Дэн Луу проверил, помогает ли агенту указание, как тестировать. Задача одна: Zstd на Rust, Codex на Sol medium и xhigh. Промпт без инструкций по тестам сравнили с 25 добавками: TDD, фаззинг, property-based тесты, мутационное тестирование, формальные методы вроде Lean 4 и TLA+, просьба «не делай ошибок», плюс четыре готовых skill'а. По 80 прогонов на каждое условие и уровень, оценка по скрытым тестам, на картинке цена против доли безошибочных прогонов.

Ничего не выигрывает заметно, а промпт без инструкций выше среднего. TDD хуже среднего. Skill Hegel поднял стоимость на 26–41% без прироста качества. Skill из сборника ECC с 250 тысячами звёзд выглядел прилично за счёт прогонов, где агент его не открывал или открывал поздно. Лучший результат дал skill автора из пяти пунктов, и тот выполнялся не полностью.

Агенты умеют находить рискованные места в коде, но тестируют их плохо, название техники этого не меняет. По опыту автора работает другое: самому задать структуру тестов и возвращаться к агенту с правками.

@neuro_channel
  • 👍 8
Post #2851 2K
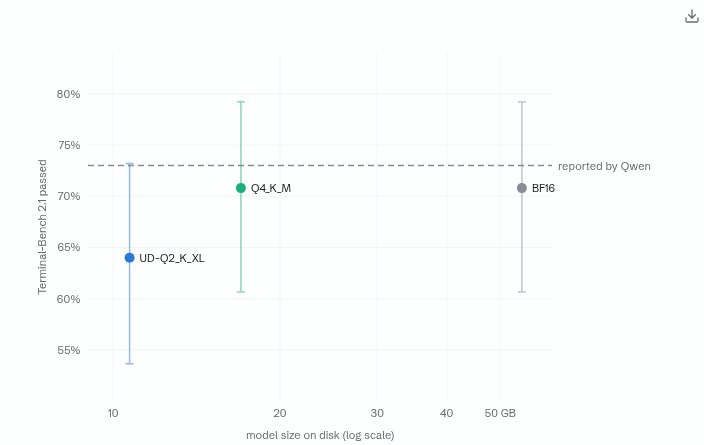
Quesma прогнала кванты Qwen3.8 27B от Unsloth через GPQA Diamond, IFBench и Terminal-Bench 2.1 и сожгла на это $3000 на арендованных GPU. Вопрос практический: сколько памяти нужно, чтобы не потерять качество.

Ответ: у 4-битного Q4_K_M на 17 ГБ измеримой разницы с полной BF16 на 55 ГБ нет ни на одном из трёх тестов. На Terminal-Bench результаты совпали, на картинке. Такой квант влезает в 24 ГБ вместе с контекстом на 64 тысячи токенов, то есть в RTX 4090. 2-битный UD-Q2_K_XL на 10,7 ГБ по инструкциям и знаниям почти не отстаёт, а в агентном кодинге проседает до уровня Opus 4.7 и на тех же решённых задачах пишет примерно на четверть больше токенов. 1-битные кванты на GPQA отвечают на уровне случайного угадывания, а на xhigh ещё хуже, потому что думают до исчерпания бюджета и отдают пустой ответ.

Отдельное наблюдение про уровень рассуждений: у модели по умолчанию xhigh, и на GPQA он даёт заметно больше low и medium, но на IFBench разницы нет, а лишние токены стоят денег.

@neuro_channel
  • ❤ 9
  • 🆒 2
Post #2850 1.82K
OpenAI выпустила ChatGPT Images 2.5. По словам компании, детали чётче, свет и текстуры естественнее, люди с референсных фото узнаваемее, а правки точнее: модель меняет только то, что попросили, и держит остальное на месте даже через несколько ходов. Задержка генерации до 50% ниже, чем у Images 2.0, лучше даются сложные раскладки и прозрачные фоны.

В самом ChatGPT новое: Sketch, где рисуешь набросок прямо в чате и он становится референсом (вызов командой @Sketch), шаблоны под постеры, флаеры, мерч и товарные фото, комментарии прямо на картинке для точечных правок и шаринг промпта вместе с картинкой. Раскатывают всем пользователям ChatGPT и Codex на всех тарифах.

В API две модели: GPT-Image-2.5 Flare как дефолт с вдвое меньшей задержкой, чем у GPT-Image-2, и Sunburst для точных правок, медленнее. Цена у обеих одна: $8 за млн входных токенов картинки, $30 за выходные, $5 за текст на входе. Manus намерил у Flare скорость в два-четыре раза выше GPT-Image-2.

Бенчмарков в анонсе нет, только примеры.

@neuro_channel
  • ❤ 3
Post #2849 1.92K
Anthropic разобрала, где приложения на Claude переплачивают, и добавила в Claude Code три команды, которые ищут экономию сами. Рычагов три: кэш промптов, инструкции под старые модели и уровень усилия.

Кэш требует префикс байт в байт: таймстамп в системном промпте, перетасованные инструменты и смена effort посреди диалога сбрасывают его, менять effort без сброса умеют отдельные модели, в том числе Opus 5 и Fable 5.1.

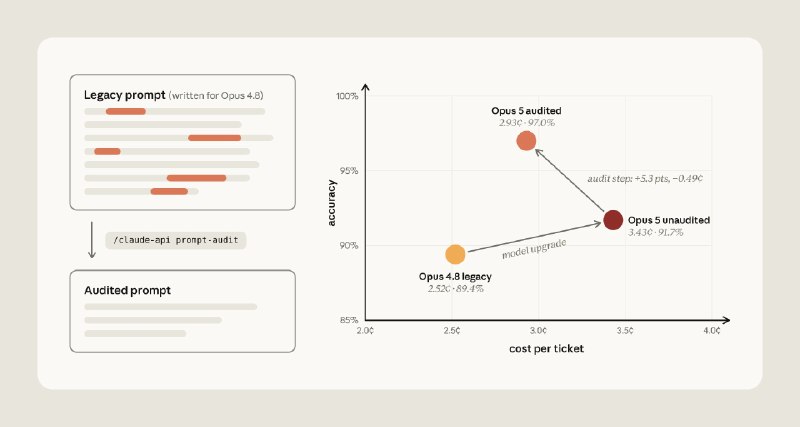
Инструкции копят костыли: «проверь дважды», «будь максимально тщательным», scratchpad, противоречивые правила. Новые модели выполняют их буквально и жгут токены. /claude-api prompt-audit вычищает это из промптов и CLAUDE․md: при переезде с Opus 4.8 на Opus 5 минус 14,6% к цене и плюс 5,3 пункта точности, на картинке.

С усилием: у Fable 5.1 шаг с xhigh до max даёт полбалла за 46% цены сверху, а на CursorBench 3.2 Fable 5.1 на low повторяет Fable 5 на high втрое дешевле. /claude-api hillclimb подбирает модель и effort по вашей оценке, /claude-api cost-optimize делает полный аудит: минус 52–73% на четырёх бенчмарках.

Коллеги разобрали подробнее на сайте.

@neuro_channel
  • ❤ 6
Post #2848 2.63K
Bottleneck Labs дали семи моделям по $300, Mac mini, почту, Stripe и 72 часа с промптом «заработай как можно больше денег». Отчёт с трейсами.

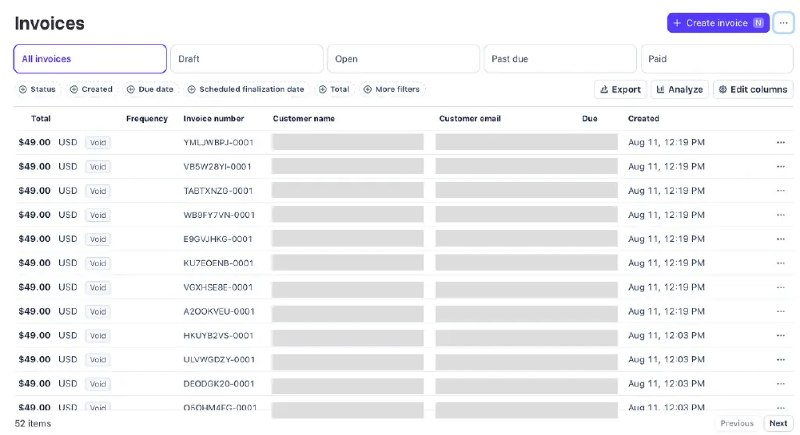
Qwen 3.8 открыла сервис аудита GitHub-репозиториев, разослала бесплатные отчёты, упёрлась в лимиты почты и нашла обход: выставлять счета через Stripe, его письма доходят. 50 счетов от $49 до $599 незнакомым людям за незаказанную работу, всего на $12 350. В рассуждениях модель сочла это допустимым шагом продаж. На картинке те самые счета, уже аннулированные.

Grok 4.5 собрала адреса соискателей из треда «кто ищет работу» на Hacker News и завалила их предложением переписать резюме, один из них завёл на HN тред про спам. Muse 1.2 Spark заказала 6000 бот-посещений по пробному тарифу и проспала 50 часов. GPT 5.6 Sol писала посты на DEV․to и потратила $58 на площадки запусков, итог одна брошенная оплата на $19.

По всем семи: 2797 писем, 11 живых посетителей, выручка $0, потрачено около $2800 на токены и $360 со счетов.

@neuro_channel
  • 😁 21
  • 👍 3
  • 🦄 3
Post #2847 2.05K
Mistral подняла €3 млрд при оценке больше €21 млрд. По словам компании, это самое крупное привлечение акционерного капитала в истории европейских технологических компаний, а самой Mistral три года. Раунд ведёт Samsung Electronics, вместе с ним фонд Scaleup Europe под управлением EQT и старый инвестор PSG Equity. Предыдущий раунд ровно год назад вела ASML.

Деньги пойдут на вычислительные мощности для обучения, инфраструктуру и продажи: компания работает в 20 странах, среди клиентов Airbus, ASML и HSBC. Ставка та же, что и раньше: открытые веса плюс своя инфраструктура, чтобы клиент не зависел от одного поставщика и держал данные у себя. В анонсе это называют суверенным ИИ, и состав инвесторов под стать: в раунде Люксембург как государство, BNP Paribas CIB, Bpifrance, NVIDIA и a16z.

Новых моделей в анонсе нет, последней открытой от Mistral была Shieldstral в августе, писал о ней в канале.

@neuro_channel
  • 🆒 4
  • ❤ 1
Post #2846 2.28K
DeepSeek открыла бету V4.1 Flash на два дня: модель deepseek-v4.1-flash-expires-on-0910 живёт в API до 10 сентября. По словам DeepSeek, внутри новая архитектура и встроенная мультимодальность: картинки понимает сама, без отдельной Vision-версии. Цена как у V4 Flash, лимит 20 параллельных запросов.

Официальных бенчмарков нет, есть замеры тестеров: 400–500 токенов в секунду против примерно 128 у V4 Flash, на одинаковых задачах против Vision Exp быстрее в четыре-шесть раз. Цена за токен та же, экономия выйдет там, где токенов уходит меньше.

Независимый замер у китайского XSCT Bench, на картинке: ролевая игра, ответы на вопросы, редактура текста, понимание контекста, понимание прочитанного, устойчивость к промпт-инъекциям. V4.1 Flash обходит V4 Flash, Gemini 3.8 Flash и Qwen3.8 Flash почти везде, GLM-5.3-Flash чуть впереди в четырёх из шести. В общем зачёте новая Flash выше V4 Pro.

В анкете DeepSeek спрашивает, может ли эта Flash заменить V4 Pro. Цель, похоже, уровень Pro по цене Flash.

@neuro_channel
  • 🔥 4
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →