
Неделю назад писал, что max у GPT-6 Astra включать смысла нет, цена удваивается. Для агентных задач всё выглядит наоборот. Разработчик заметил, что чем выше уровень рассуждений у Astra, тем меньше токенов она сжигает, и похожих наблюдений набралось из разных мест.
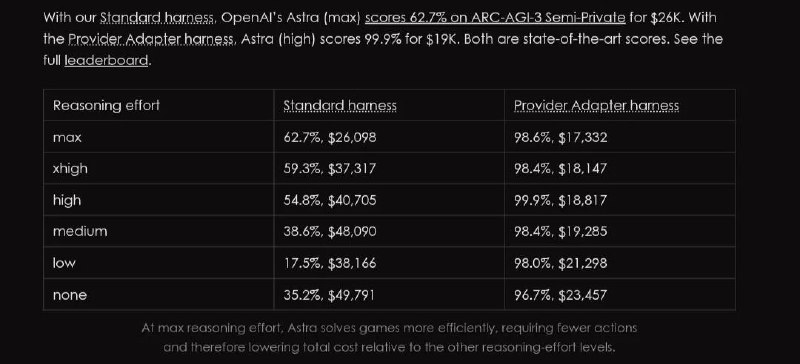
Самое наглядное у ARC Prize: на ARC-AGI-3 прогон Astra на max обошёлся почти вдвое дешевле, чем на low и medium, и дал лучший результат. На max модель точнее строит модель игры и делает меньше ходов, а каждый лишний ход это ещё один запрос с полным контекстом. Таблица на картинке.
С кодом похоже, но со своей границей. Разработчик сравнил одну задачу на Sol high и Astra на трёх уровнях: medium сделала реализацию за 80 запросов против 238 у Sol, входных токенов ушло втрое меньше, и вышло дешевле Sol. А вот high там не окупилась: дольше и дороже medium, а на ревью пропустила баг, который medium нашла. У других xhigh тоже ест меньше квоты, чем уровни ниже.
Механика простая: доплата за рассуждения на каждом шаге меньше экономии на числе шагов, когда задача длинная и агент много ходит по инструментам. На коротких вопросах это не работает, там уровень выше high только увеличивает счёт.
@neuro_channel
Post #2859
2.16K
- 👍 10
- 😁 1
- 🍌 1