
Cognition выпустила SWE-2, свою самую близкую к фронтиру модель для кода: на бенчмарках вровень с флагманами при цене до 70% ниже. Внутри Kimi K3 на 2,8 трлн параметров, поверх которой Cognition докрутила RL, впервые в таком масштабе.
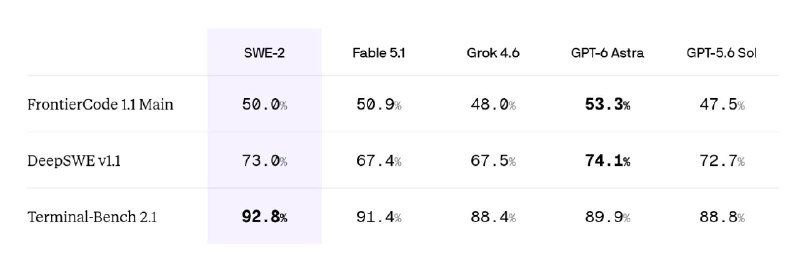
Главная идея обучения в том, что все уровни рассуждений тренируются в одном прогоне RL, а штраф за стоимость подбирается под наклон кривой цена-качество у базовой модели. Так сдвигается вся кривая, а не одна точка на ней. Таблица на картинке: с Fable 5.1 и GPT-5.6 Sol вровень, до GPT-6 Astra не хватает нескольких пунктов при четверти её цены, на Terminal-Bench 2.1 обошла всех.
Поведение тоже поменялось: модель меньше копается в репозитории и раньше начинает править. На FrontierCode первое реальное редактирование делает в среднем на 18-м шаге против 48-го у SWE-1.7, ходов на 58% меньше, прогон на 81% дешевле.
Попробовать можно в Devin Desktop и CLI, в Devin Web выкатывают, разбор обучения в блоге.
@neuro_channel
Post #2863
2.19K
- 🔥 3
- ❤ 1