
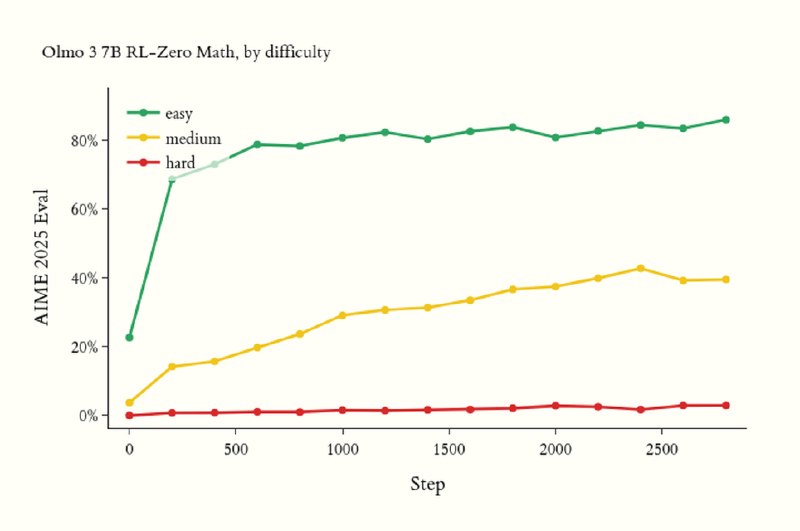
RL-дообучение улучшает модель пропорционально тому, что она уже умеет: лёгкие задачи становятся легче, трудные почти не сдвигаются. Автор Olmo 3.1 RL-Zero Math разбирает это на AIME. Если разбить 30 задач на три корзины по стартовому pass@1 (0%, 3,8% и 22,7%), почти весь рост средней метрики даёт переход лёгких задач из «иногда решаю» в «в основном решаю». Та же картина на code RL у Deepcoder и на агентном RL у DeepSWE.
Причина не только в том, что на трудную задачу не выпадает ни одного верного ответа и градиента нет. Большой k, по 32 сэмпла на промпт, чаще ловит редкое решение трудной задачи, но ещё чаще ловит редкую ошибку на лёгкой, и батч забивается лёгкими задачами. В эксперименте на GSM8k маленький k=4 после 200 шагов обгоняет k=32.
Предложенный метод Never Give Up: сэмплировать по 4, задачу с нулём верных ответов с вероятностью 0,9 отправлять на новый круг, а решённую 4 из 4 отфильтровывать сразу. На GSM8k это обходит GRPO с любым фиксированным k, сильнее всего на трудной корзине. Статья на arXiv и код в посте.
@neuro_channel
Post #2897
1.56K
- 👍 4