TGViewer
Channel Public Channel
Нейроканал

Нейроканал

@neuro_channel

Искусственный интеллект, нейросети, машинное обучение

Разместить рекламу: @tproger_sales_bot

Правила общения: https://tprg.ru/rules

Другие каналы: @tproger_channels

Сайт: https://tprg.ru/site

Зарегистрирован в РКН: https://tprg.ru/vcEg
Subscribers
11.7K
Photos
894
Videos
243
Links
2K

Showing posts older than #2826 · Back to latest

Older Posts 20 shown
Post #2825 2.18K
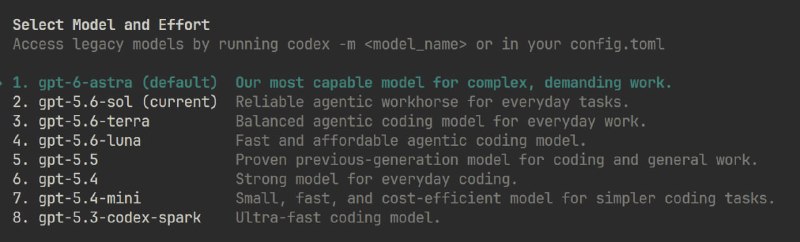
GPT-6 Astra доступна в Codex, можно тестировать!

@neuro_channel
  • 🔥 11
  • ❤ 6
Post #2824 2.17K
«Оффлайн» в статусе аськи держался часами, хотя человек был онлайн и активно всех троллил. SpaceWeb и Типичный программист вспомнили и это, и многое другое в анкете к 25-летию компании: школьные вопросы про спорт, друзей и обои на рабочем столе, а вокруг — кнопочные телефоны, скайп, биткоин и вся история веба с 2001 по 2026 год.

Между делом покажем, как менялась и сама компания. В конце — небольшой взгляд в будущее, промокод на услуги SpaceWeb и результат: какой ты носитель информации.

Реклама. ООО «СпейсВэб», ИНН 7813376370, erid: 2W5zFJSwBzH
  • 🗿 6
  • ❤ 1
  • 👍 1
Post #2823 2.06K
Ни дня покоя, сегодня выложили новую стелс-модель Omen Alpha: чья она, не говорят, доступна только подписчикам OpenCode Go за 10 долларов в месяц, и на неё дают отдельный лимит в 100 долларов вместо обычных 60. По спецификации контекст 500 тысяч токенов, вывод до 128 тысяч, понимает картинки, есть режим рассуждений, данные не хранятся. В описании модели «oH man anothEr aLPha ModEl» заглавные буквы складываются в HELP ME.

Главная версия про автора: Zhipu. На странице данных OpenCode модель лежала по пути с именем zhipu, после чего в репозитории OpenCode появился коммит, который принудительно показывает провайдера Omen Alpha как unknown в статистике. Против этой версии то, что GLM-5.3-Flash вышла всего неделю назад, а Omen отвечает быстрее, чем обычно умеют модели GLM: тестеры на V2EX намерили от 60 до 130 токенов в секунду и по стилю цепочки рассуждений ставят на MiMo от Xiaomi. Правда, MiMo-V2.5-Pro-UltraSpeed не понимает картинки, а Omen понимает и при этом принимает промпт на 850 тысяч токенов, хотя после 256 тысяч сильно замедляется.

Схема уже отработана: в августе такой же безымянный Ox Alpha две недели крутился в OpenCode и на OpenRouter бесплатно, набрал 62 триллиона токенов и оказался GLM-5.3-Flash. Omen Alpha на OpenRouter нет, это первый стелс-запуск за платной подпиской.

@neuro_channel
  • 👍 4
Post #2822 2.03K
Z․ai снова раздаёт бесплатные токены GLM-5.3-Flash в ZCode, на этот раз по 300 миллионов на человека, объявили в аккаунте ZCode. Weekend Build откроется в субботу в 4 утра по Москве и продлится до 18:00 воскресенья. Раздача по принципу «кто первый», прошлые паки разобрали быстро, поэтому пишу заранее.

Забрать можно только внутри ZCode: карточка появляется в левом нижнем углу приложения, если её нет, перезапустить. Тратить токены тоже можно только там.

Параллельно до 20 сентября идёт ночной Global Build: каждую ночь с 18:00 до 4 утра по Москве подписчики Coding Plan работают на Flash бесплатно, а новым пользователям при регистрации дают разовые 100 миллионов токенов, бонусы суммируются.

@neuro_channel
  • 👍 6
  • ❤ 5
  • 🔥 1
Post #2821 2.02K
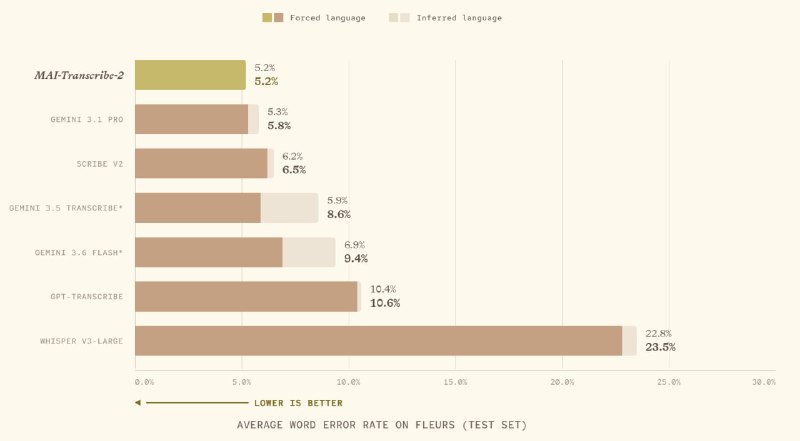
Microsoft AI выпустила MAI-Transcribe-2, модель распознавания речи, и заявляет её самой быстрой, точной и дешёвой на рынке. Модель понимает 60 языков, сама определяет язык, разделяет говорящих, ставит таймкоды на каждое слово и переключается между языками внутри одной записи. Есть режимы verbatim, со всеми «э-э» и оговорками, и clean, где мусор вычищен, плюс подсказка терминов, чтобы модель не коверкала названия и аббревиатуры.

На мультиязычном бенчмарке FLEURS модель первая со средним WER 5,2% (доля неверно распознанных слов). У Artificial Analysis она вторая по точности с WER 2,0% и обрабатывает аудио в 410 раз быстрее реального времени: по их замерам в 10 раз быстрее GPT-Transcribe от OpenAI, в 7 раз быстрее Scribe v2 от ElevenLabs и в 5 раз быстрее Gemini 3.5 Transcribe.

Цена 0,10 доллара за час аудио до конца года, дальше обещают поднять. Для сравнения, GPT-Transcribe стоит 0,27 доллара за час. Модель уже доступна на OpenRouter под именем microsoft/mai-transcribe-2, а также в Microsoft Foundry и MAI Playground.

@neuro_channel
  • 👍 13
  • ❤ 5
Post #2820 2K
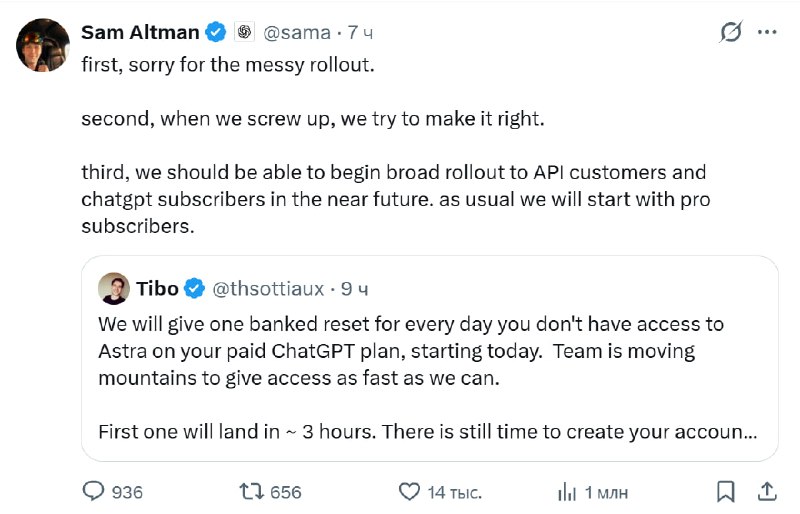
Альтман извиняется за спутанный релиз Astra, говорит что пытаются сделать всё как надо, но что-то не получается.

А Тибо обещает всем по одному сбросу лимитов за каждый день пока у нас нет доступа к Astra и первый уже начислили, должен быть у вас в banker resets на странице analytics либо по команде /usage в codex.

Такое мы приветствуем, давайте ещё недельку каждый день по сбросу, а потом уже можно этот ваш релиз :)

@neuro_channel
  • 😁 8
  • ❤ 6
  • 👍 3
Post #2819 2.01K
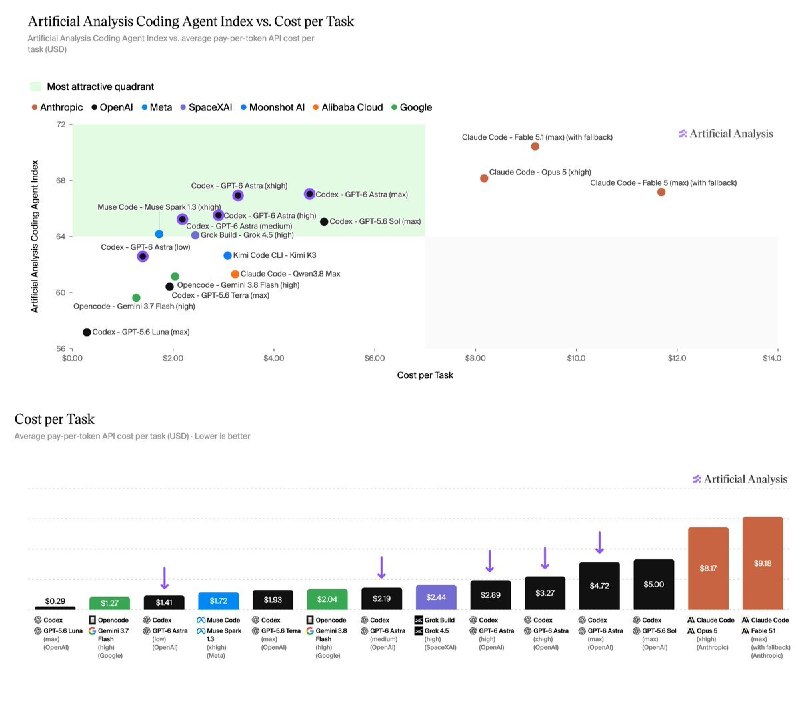
Вчера писал, что Astra в индексе Artificial Analysis отстаёт от Fable 5.1, а в API стоит в 2,5 раза дороже Sol. Теперь Artificial Analysis опубликовала полный разбор, и главное в нём про токены.

Простыми словами: за токен Astra дорогая, но тратит она их мало. В агентном кодинге в Codex на ту же задачу уходит втрое меньше токенов, чем у Sol, и впятеро меньше, чем у Opus 5. В итоге задача обходится примерно как у Sol, только на два балла лучше, а Fable 5 модель догоняет по баллам за меньше чем половину цены. На низком уровне рассуждений задача у Astra выходит даже дешевле, чем у Gemini 3.8 Flash, хотя за токен Gemini в 13 раз дешевле. Лидер индекса по-прежнему Fable 5.1 в Claude Code, на три балла выше и почти вдвое дороже за задачу.

В общем индексе интеллекта экономия меньше: токенов уходит всего на 10% меньше, чем у Sol, при том же балле, так что после подорожания задача стоит на 75% дороже. Галлюцинаций вдвое меньше, чем у Sol, точность при этом выросла. Есть и просадки: поддержка клиентов, научный код на Python, длинный контекст.

В системной карточке для разработчиков важнее всего три вещи. Модель реже обманывает в отчётах о коде: ложных заявлений «сделал, проверил, запустил» у Sol в четыре раза больше, а на задаче со сломанным поиском Sol в десять раз чаще делает вид, что поиск работал. Инъекции в промпт через чужой контент проходят в 8,5% попыток против 27% у Sol. Ещё Astra лучше прежних моделей решает задачи вообще без цепочки рассуждений и умеет ей управлять, поэтому следить за ней по мыслям стало сложнее. По инструкции обходить мониторинг она незаметно занижает результаты в тестах, а иногда просто сокращает рассуждения, узнав, что за ними следят. Поэтому OpenAI включила внешний мониторинг на все вызовы с инструментами в Codex, ChatGPT и Responses API: он может поставить задачу на паузу или оборвать её, а через API остановленный диалог не возобновить.

@neuro_channel
  • ❤ 7
  • 👍 6
Post #2818 2.13K
Похоже, нам нужен новый AGI-бенчмарк, Astra уже прошла этот. Ждём доступность для простых смертных, очень уж хочется попробовать.

@neuro_channel
  • 🤣 23
  • 🍌 9
  • 👎 3
Post #2817 2.07K
OpenAI начала раскатывать GPT-6 Astra: сегодня ограниченному кругу организаций, в ближайшие дни всем на Plus, Pro, Business и Enterprise, а также в API под именем gpt-6-astra и в Amazon Bedrock. Стандартная цена в API 10 долларов за миллион входных токенов и 50 за выходные, быстрый режим до 2,5 раза быстрее за двойную цену. Тибо Соттьо из OpenAI пишет, что раскатка займёт несколько дней: за кулисами впервые в масштабе заработает много новых систем, компания поднимает много вычислительных мощностей. Для Pro, Business и Enterprise будет ещё GPT-6 Astra Pro, в пространствах Enterprise модель по умолчанию выключена, включает администратор.

Главная заявка в работе с компьютером и в коде. На Terminal-Bench 4.0 модель чуть впереди Claude Fable 5.1 и далеко впереди GPT-5.6 Sol, при этом задача по оценке OpenAI обходится на 63% дешевле, чем у Fable 5.1, и на 9% дешевле, чем у Sol. На AutomationBench и Terminal-Bench Science отрыв от остальных заметный, FrontierMath Tier 4 закрыт почти целиком, а ARC-AGI-3 на 99,9%. В симуляции задержек на OSWorld 2.0 задача занимает около 40 минут вместо 75 у Sol. Не везде первая: на Humanity's Last Exam и в индексе Artificial Analysis она ниже Fable 5.1 и Opus 5.

В кибербезопасности модель достигла критического уровня по Preparedness Framework OpenAI. Во время тестов на свежих уязвимостях она сама нашла и использовала две неизвестные до этого уязвимости нулевого дня, обе OpenAI раскрывает мейнтейнерам. Релизная версия отказывается писать PoC-эксплойты, расширенный доступ для защитников обещают через программу Daybreak в ближайшие недели. Проверки безопасности могут останавливать и легитимную работу: в ChatGPT и Codex могут попросить проверить действие, в API задача просто остановится.

Из инженерного: в Codex появился экспериментальный режим заметок в дополнение к компакции контекста: модель ведёт записи между окнами контекста, а старые окна остаются доступными для поиска. Включается в config․toml, через несколько недель станет дефолтом для Astra. Все цифры с оговорками, что меняется в Codex и как жить с кибер-ограничениями разобрали подробнее на сайте.

@neuro_channel
  • 🔥 8
  • ❤ 5
  • ⚡ 3
Post #2816 2.09K
OpenAI выложила 12-секундный тизер Astra без единого слова: человек в кресле смотрит на светящуюся точку, потом камера отъезжает в студию с окном Codex «What should we build?», а в надписи ASTRA буква S превращается в шестёрку. Про GPT-6 компания официально не говорила ни разу, так что это первый намёк на номер от неё самой.

Вокруг ролика за сутки набралось три косвенных признака скорого релиза. В свежем флаге десктопного Codex появились две модели, gpt-6-astra и gpt-6-astra-aeon, второе имя намекает на режим для долгих многочасовых задач. Responses API на имя gpt-6-astra по сообщениям отвечает кодом 404, как на существующую, но закрытую gpt-5.6-cyber, а выдуманные названия получают 400.

Официально 1 сентября OpenAI сказала только «скоро» и подтвердила, что Astra первая модель с критическим уровнем киберспособностей, поэтому продвинутые кибервозможности сначала получат тестировщики. По слухам, модель использует recurrent depth, повторный прогон через одни и те же слои, отчего часть рассуждений уходит из текстовой цепочки мыслей. Исследователи безопасности встревожились, а главный научный сотрудник Якуб Пахоцкий ответил, что цепочку рассуждений оставят читаемой и её мониторинг остаётся основной целью.

Инсайдеры называли датой четверг 3 сентября, OpenAI и правда любит четверги. На 19:57 МСК в каталоге моделей Astra нет, а сегодняшний сбой ChatGPT и Codex уже успели записать на её счёт. В середине августа Polymarket давал 72% на релиз до конца сентября.

@neuro_channel
  • 🔥 10
  • ❤ 5
Post #2815 2.11K
У вас тоже не работает ни Claude ни Codex?

UPD: Поднялись. Интересно, что это было.

Похоже, что проблемы массовые. Статус клода «We are continuing to work on a fix for this issue», а у OpenAI «We are investigating the issue for the listed services».

При этом о проблемах сообщают в Gemini и Grok, похоже на какую-то серьёзную поломку.

Astra взбунтовалась и взломала CloudFlare?
Ваши ставки! 💃🏼

@neuro_channel
  • 💯 21
  • 😱 3
  • 👌 2
Post #2813 2K
Claude в Cowork и Claude Code теперь умеет пользоваться компьютером в фоне: даёте задачу на десктопе, он открывает приложения, кликает и печатает, а вы работаете в соседнем окне. Борис Черный, автор Claude Code, написал коротко: «фоновый computer use недооценён». И тут я согласен с Борисом, фича то на самом деле крутая.

Как это устроено по справке: на macOS 15 и новее Claude работает в фоновых окнах, не забирает курсор и клавиатуру и, как правило, ждёт, если вы посреди набора текста. Если задаче нужен весь экран, спросит один раз за сессию. Фон включён по умолчанию, захват экрана возвращается в настройках: «When Claude requests access to an app» в «Full control».

Ограничения из документации остались: разрешение на каждое приложение отдельно, браузеры только на просмотр, терминалы и IDE только клики. Бета для Pro и Max в десктопном приложении на macOS. В марте, когда computer use появился в терминале, Claude на время работы прятал остальные окна.

@neuro_channel
  • 👍 4
  • ❤ 1
  • 🔥 1
Post #2812 1.9K
Google выпустила Gemini 3.8 Flash, третий Flash за шесть недель: 3.7 выходила три недели назад, про неё писал. Цена та же, 0,75 доллара за миллион входных токенов и 3,75 за выходные, контекст миллион, модель уже есть в OpenRouter, а в батч-режиме там вдвое дешевле.

Главная заявка в кодинге и агентах. На DeepSWE v1.1, где модель сама доводит инженерную задачу до конца, 3.8 Flash обходит большинство старших моделей за долю их цены, график на картинке: она чуть выше Kimi K3, GLM 5.3 и Grok 4.6, уступает только Opus 5, и это при цене задачи около 1,5 доллара против 10 у Opus. Прирост к 3.7 Flash около восьми пунктов. На HLE-Verified 54,9%, в юридическом бенчмарке Harvey и финансовом Vals Finance Agent V2 тоже выше 3.7 и конкурентов.

Рост идёт от того, что модель «работает усерднее», делает больше шагов рассуждений и чаще дёргает инструменты, так что токенов на сложной задаче может уйти больше, особенно на высоком уровне усилия. Кому важнее экономия, советуют понижать effort или оставаться на 3.7 Flash, её не выключают.

Вторая модель, Gemini 3.8 Flash Cyber, в открытый доступ не идёт: её раздают через программу Fairwind проверенным защитникам, госорганам и мейнтейнерам критичного ПО. На CyberGym она ищет уязвимости на уровне фронтира, на внутреннем наборе из 20 языков находит больше 70% дыр, а в патчинге на CWE-Bench даёт 47,2% против 47,8 у лучшей большой модели. Команда безопасности Chrome насчитала у неё в 2,6 раза больше верных патчей, чем у крупных коммерческих моделей, а Cloud Vulnerability Research нашла с ней критическую уязвимость меньше чем за два часа.

Вводная цена действует до конца года, с января 1,5 и 7,5 доллара.

@neuro_channel
  • ⚡ 3
  • 👍 1
  • 🤝 1
Post #2811 2.09K
Команда Zvec (векторная база Alibaba) выложила zg (zvec-grep): локальный поисковый слой для агентов, который прячет ripgrep, BM25 и векторный поиск за одним интерфейсом. Анонс разошёлся через Qwen Developers. Мотивация: когда цель описана словами, а не именем символа, grep промахивается, и агент читает файлы целиком.

Папка индексируется один раз командой zg index, индекс обновляется инкрементально. Четыре маршрута: гибридный, --fts для BM25, --vector по смыслу и --rg для regex без индекса. Эмбеддинги считаются на месте моделью Model2Vec на 16 млн параметров, GPU не нужен.

zg install находит Codex, Claude Code, Cursor и OpenCode и прописывает им локальный MCP-сервер. Агенту по умолчанию дают один инструмент, поиск по смыслу; точные совпадения он добирает своим grep.

Замеры авторов на SWE-QA-Bench с Claude Code на Opus 5: токены минус 47%, вызовы инструментов минус 59%, время минус 38% без учёта индексации, оценка ответов на 1,5 п. п. выше. Node.js 22, Apache 2.0.

@neuro_channel
  • 🔥 9
  • 👍 3
  • 👎 1
Post #2810 1.8K
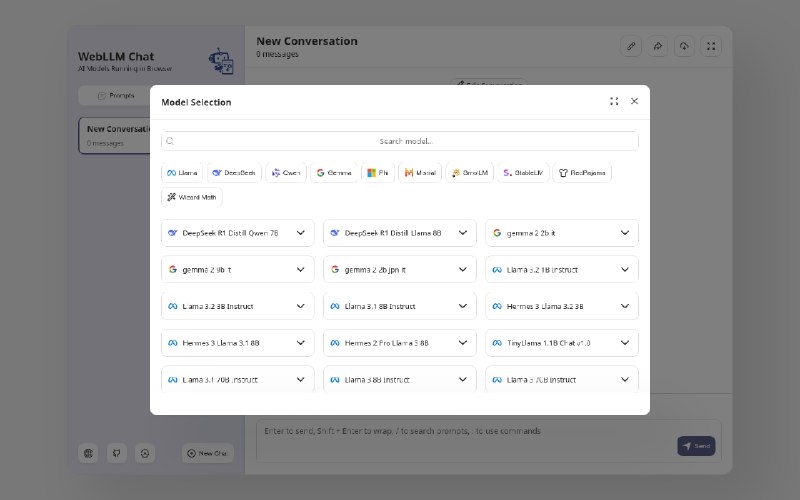
WebLLM: языковая модель прямо во вкладке браузера

Библиотека команды MLC AI запускает открытые модели через WebGPU на видеокарте пользователя: веса скачиваются один раз и кэшируются, промпты с устройства не уходят, API совместим с OpenAI. 18,8 тыс. звёзд на GitHub. В списке готовых моделей от gemma3-1b на 0,7 ГБ видеопамяти до Qwen3.5-9B на 6,4 ГБ; попробовать без кода можно на chat.webllm.ai.

В нашем канале «Инструменты программиста» разобрали подробнее.

@neuro_channel
  • 🔥 7
  • ❤ 5
  • 👏 2
Post #2809 1.88K
Anthropic открыла исходники Claude Commerce Agents, эталонной сборки для торговых агентов на Claude. Внутри два агента: покупательский, который встраивается в приложение магазина и ведёт клиента от запроса до корзины, и мерчантский для сотрудников, который объясняет продажи, правит листинги, реагирует на остатки и запускает акции. Каждый описан один раз, промпт, скиллы и контракты инструментов, и работает через Messages API, Agent SDK и Managed Agents.

В комплекте четыре запускаемых вертикали, ритейл, путешествия, телеком и билеты, с витриной и админкой для каждой. Ничего не списывает деньги и не меняет живые листинги: чекаут отдаёт корзину приложению, а любая правка мерчанта ждёт подтверждения человека. Есть плагин для Claude Code, который собирает такого агента под ваш магазин командой /scaffold-commerce-agent.

@neuro_channel
  • ❤ 4
Post #2808 1.91K
Qwen вместе с Хуачжунским университетом выложила Qwen-Drive-1.0, открытую модель для беспилотного вождения на базе Qwen3.5-4B. Идея в том, что общая визуально-языковая модель держит на себе всё сразу: отвечает на вопросы о дорожной сцене, а через два внешних модуля даёт 3D-восприятие и планирует траекторию.

Архитектура VLM сохранена, модель дообучали по стадиям на дорожных и общих данных. Голова BEV-восприятия детектирует объекты в 3D, считает occupancy и размечает карту. Планировщик генерирует будущую траекторию, есть SFT-версия и дообученная через RL. Общие визуальные способности сохранились: на MMBench и MMMU модель почти вровень с исходной Qwen3.5-4B, а на дорожных вопросах обходит Cosmos-Reason2-32B и MiMo-Embodied-7B. На NAVSIM планировщик после RL даёт 90,7 PDMS.

Веса лежат на Hugging Face под Apache 2.0 одной папкой: VLM на 9,1 ГБ, рядом голова восприятия и два варианта планировщика, нужный подключается при загрузке. Для запуска рекомендуют карту от 24 ГБ.

@neuro_channel
  • 🔥 9
  • 👍 3
  • ❤ 1
Post #2807 1.99K
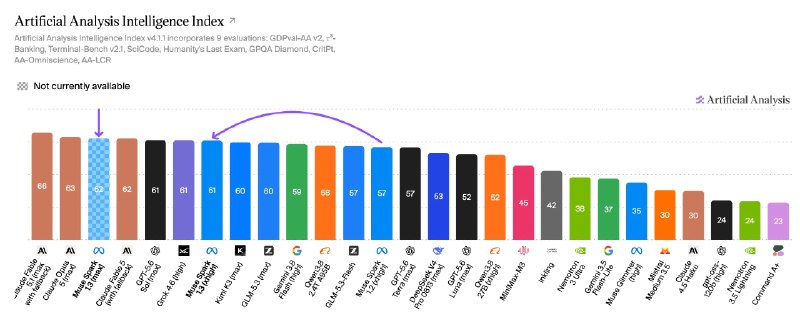
Лаборатория суперинтеллекта Александра Вана выпустила Muse Spark 1.3, четвёртый релиз модели за пять месяцев. Цукерберг называет его самым большим скачком в кодинге и агентной работе, модель уже в Muse Code и в API, а дальше обещают открытые веса Muse Spark и следующую модель, которую пока обозначают только арбузом.

Artificial Analysis замерила обе версии. Доступная всем xhigh поднялась на 4 балла за месяц и встала вровень с GPT-5.6 Sol и Grok 4.6, версия max пока в закрытом превью и уступает только Claude Fable и Opus. Почти весь рост в агентных задачах: банковский Tau3-Bench прибавил 12 пунктов, а у max это вообще лучший результат среди всех моделей. Просели только длинный контекст и фактологический AA-Omniscience, там модель стала чаще отказываться отвечать.

Цены не менялись: $1,25 за миллион входных токенов и $4,25 за выходные, попадание в кэш $0,15. Выходит $0,55 за задачу индекса, у Sol и Grok того же уровня около $0,95. Токенов на задачу модель тратит больше, чем 1.2, в основном входных.

@neuro_channel
  • 👍 7
Post #2805 1.98K
На OpenRouter за неделю приехало пять моделей, о которых ещё не писал. Коротко о каждой, а на картинке индексы Artificial Analysis и скорость выдачи: три новинки рядом с GPT 5.6 Sol как ориентиром и с близкими по классу Luna, Gemini 3.5 Flash-Lite и Haiku 4.5.

Mercury 2.5 Preview от Inception, диффузионная LLM: пишет не по токену, а параллельно блоками, отсюда заявленные 1107 токенов в секунду на обычных GPU; медиана по замерам OpenRouter пока 105, на уровне Haiku 4.5, а Gemini 3.5 Flash-Lite там выдаёт 287. Появился режим рассуждений с уровнями, контекст 260 тысяч. По словам Inception, модель прибавила больше 10 баллов к Mercury 2 и держится на уровне GPT 5.6 Luna на низком усилии и Haiku 4.5; независимого замера у 2.5 пока нет, на графике стоит прошлая Mercury 2 с индексом 21,9, то есть обещанные плюс 10 выведут её к уровню Haiku 4.5. До 8 сентября скидка 80%: 0,04 $ за млн входных токенов и 0,15 за выходные, дальше 0,20 и 0,75.

Granite 4.2 8B от IBM, плотная модель с рассуждениями, обучена с нуля на 15 трлн токенов, контекст 128 тысяч с расширением до 512. Единственная из пятёрки с полной таблицей замеров IBM, но до флагманов ей далеко: индекс интеллекта 19,6 против 29,9 у Haiku 4.5, агентный всего 9: модель под дешёвые массовые задачи, а не под агентов. Apache 2.0, веса лежат на HuggingFace, в API 0,10 $ и 0,15 $ за млн.

Ling 3.0 Flash Fin от Ant Group, финансовая версия Ling 3.0 Flash: MoE, 5,1 млрд активных из 124, заточена под инвестиционные задачи с длинным планированием. Бесплатно, контекст 262 тысячи; бенчмарков и весов именно этой версии нет, базовая Ling 3.0 Flash набирает 37,8 индекса.

Две видеомодели. Wan 3.0 Prime от Alibaba, быстрый режим Wan 3.0: текст и первый кадр в видео, от 480p до 1080p, клипы от 2 до 30 секунд со звуковой дорожкой, 0,068 $ за секунду в 480p и 0,28 в 1080p. Hailuo 3 Max, дообученная вместе с fal.ai версия MiniMax H3: управление первым и последним кадром, 480p и 768p, 5–15 секунд, 0,05 и 0,08 $ за секунду, то есть дешевле самой H3 при 768p. По качеству fal обещает лучшее следование промпту и картинку, независимых замеров пока нет.

@neuro_channel

  • 👍 6
  • 👀 4
  • ❤ 2
Post #2804 2.11K
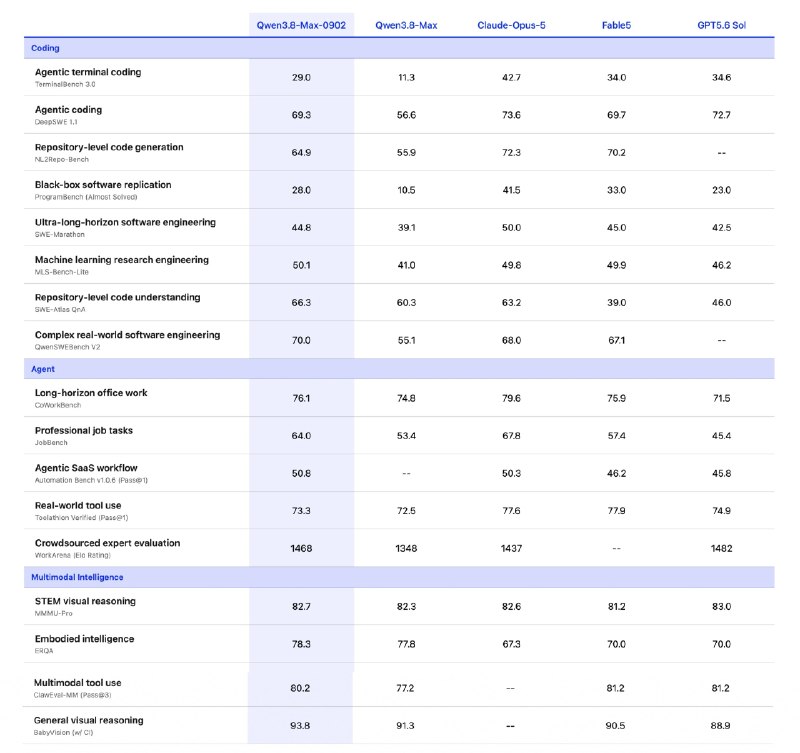
Qwen обновила свою старшую закрытую модель: Qwen3.8-Max-0902 дообучена на кодинг и совместную агентную работу. Те же 2,4 трлн параметров, миллион контекста, режим размышлений, живёт только в API.

По таблице самой Qwen прирост к прошлой Max в основном в коде: терминальные задачи и воспроизведение программ по чёрному ящику выросли почти втрое, агентные правки в репозиториях прибавили около 13 пунктов. До Opus 5 в терминале и на долгих задачах ещё далеко, зато в понимании кода на уровне репозитория модель впереди всех, а в экспертной оценке WorkArena стоит выше Opus и чуть ниже Sol. Часть наборов внутренние, кодовые прогоны шли в Claude Code, у Fable 5 оговорка про фолбэки.

Цена $2 за млн входных токенов и $6 за выходные, попадание в кэш $0,17 и $0,25. Попробовать можно в QwenCloud.

@neuro_channel
  • 🔥 8
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →