npm-библиотека от команды MLC AI: модель скачивается один раз, кэшируется в браузере и считает на видеокарте пользователя через WebGPU. API совместим с OpenAI. 18,8 тыс. звёзд на GitHub, Apache-2.0.
🔘
npm install @mlc-ai/web-llm или импорт с CDN https://esm.run/@mlc-ai/web-llm;🔘
CreateMLCEngine("Llama-3.2-1B-Instruct-q4f32_1-MLC", { initProgressCallback }), дальше engine.chat.completions.create({ messages, stream: true });🔘 Web Worker и Service Worker, чтобы не вешать интерфейс; JSON-режим реализован в WASM-части;
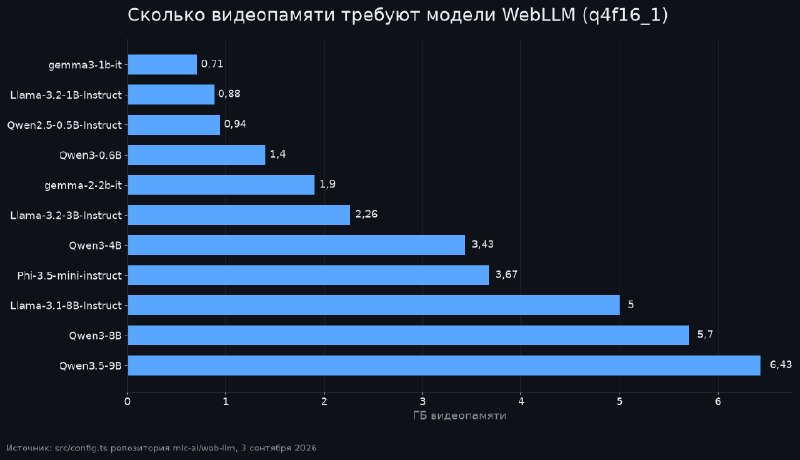
🔘 на графике, сколько видеопамяти просят предсобранные модели: от 0,7 ГБ у gemma3-1b до 6,4 ГБ у Qwen3.5-9B.
Против серверного API: промпты не уходят с устройства и инференс бесплатен, но первый запуск ждёт скачивания весов, а на слабом ноутбуке модель не поместится. Попробовать без кода: chat.webllm.ai. Разбор с кодом, замерами и FAQ на сайте.
@prog_tools