
Локальная GLM-5.3-Flash стала быстрее в 1,6–3,3 раза: Unsloth дописали свой pull request в llama.cpp, ускорили декодирование и добавили поддержку MTP, предсказания нескольких токенов за шаг. Ничего докачивать не нужно, кванты те же, что и неделю назад: в Unsloth Desktop достаточно обновиться, в llama.cpp собрать их ветку по гайду.
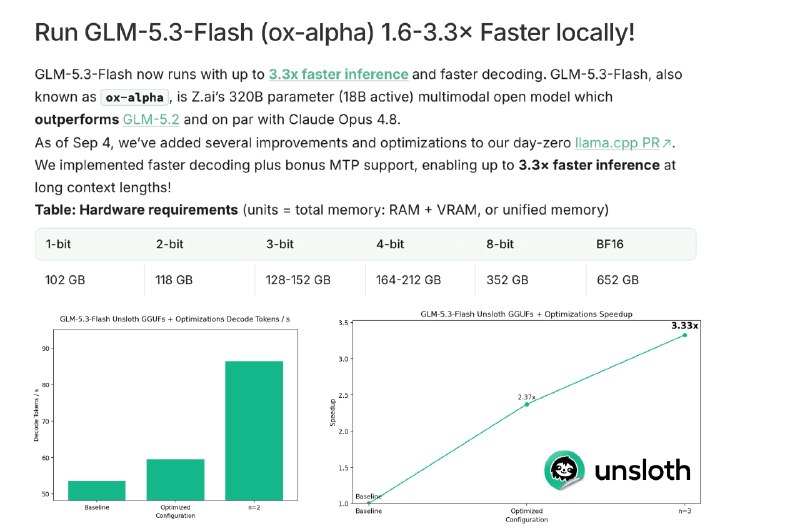
Прирост растёт с длиной контекста, графики на картинке. На коротких промптах ускорение до 1,6 раза, на 64 тысячах токенов ещё без MTP скорость выросла больше чем вдвое. С MTP лучший вариант два черновых токена, при трёх и пяти скорость снова падает.
Требования не изменились: 1-битный квант в 100 ГБ памяти, 3-битный в 128 ГБ, как у Mac Studio или DGX Spark.
@neuro_channel
Post #2827
2.02K
- ❤ 4