TGViewer
Channel Public Channel
Матчасть

Матчасть

@matchast

Высшая математика в бизнесе и жизни
vk.com/mat.chast
botcamp.timepad.ru
www.youtube.com/channel/UCoO8ApMu4QM4KQ8oGRCgOHQ
Чат: t.me/matchast_chat
Subscribers
881
Photos
27
Videos
0
Links
176

Showing posts older than #220 · Back to latest

Older Posts 20 shown
Post #219 772
Post #217 867
Итак, видос с обещанного мастер-класса про большие предобученные языковые модели: https://youtu.be/KRiUvBEwmmU

3:52​ про автора
5:41​ примеры и типы задач NLP
15:00​ логистическая регрессия, мать всех нейросетей
33:28​ проблема переобучения: почему просто больших моделей мало
43:45​ эмбеддинги как простейшая предобученная модель
1:02:00​ контекстные эмбеддинги
1:10:43​ философия transfer learning
1:25:37​ задумка и устройство BERT (и вообще трансформеров)
1:42:16​ насадки на BERT для разных задач
1:52:24​ блокнот с NER на BERT
2:16:28​ GPT - универсальный генератор текста
2:21:13​ блокнот с генерацией из GPT твитов и диалога
2:28:21​ для каких задач нужна генерация текстов
2:29:35​ методы управления генерацией
2:32:55​ полезные ресурсы и ответы на вопросы

Пишите в комментах, на какие ещё темы хотели бы похожего контента!
YouTube Языковые модели для чайников: просто и полезно про BERT и GPT | Вебинар 2021-02-18 Языковые модели для чайников: просто и полезно про BERT и GPT 0:00 что сегодня будет 3:52 про автора 5:41 примеры и типы задач NLP 15:00 логистическая регрессия, мать всех нейросетей 33:28 проблема переобучения: почему просто больших моделей мало 43:45 эмбеддинги…
Post #216 1.59K
Я обещал провести мастер-класс по современным языковым моделям для чайников: что такое BERT и GPT, как ими пользоваться, что полезного из них можно извлечь. На входе нужно будет только знание Python. И наконец-таки я собрался)
Мастер-класс будет в зуме в следующий четверг с 19 примерно до 21:30 по Москве.
Ссылка для регистрации: https://botcamp.timepad.ru/event/1554493/
botcamp.timepad.ru Языковые модели для чайников: просто и полезно про BERT и GPT / События на TimePad.ru Языковые модели для чайников: что такое BERT и GPT, как ими пользоваться, что полезного из них можно извлечь.
Post #215 832
Хочу порекомендовать вам канал Эмели Драль о прикладном машинном обучении: https://t.me/emeliml. Когда-то мы с ней вместе внедряли ML в промышленность в Yandex Data Factory, потом Эмели делала стартап mechanica.ai, а сейчас разрабатывает тулзу evidently для диагностики и мониторинга моделей. А ещё она сделала и проводит самый массовый в России офлайн-курс по анализу данных, DMIA. В общем, Эмели - молодец. И в своём канале пишет про правильные практические вещи - например, почему на ранних стадиях ML-проекта стоит делать демо-стенд своей модели, и как его сделать быстро и дёшево. В общем, подписывайтесь, вам понравится)
Telegram Emeli in ML Emeli Dral on Applied ML. On this channel, I talk about ML applications, projects and answer frequently asked questions. Co-author of the ML course on Coursera: https://bit.ly/35Lh8Cl Evidently AI CTO: https://github.com/evidentlyai/evidently
Post #214 798
Ещё пару лет назад я закодил простенького бота t.me/the_watchman_bot, который ежедневно задаёт разнообразные вопросы для рефлексии и обсуждает их.

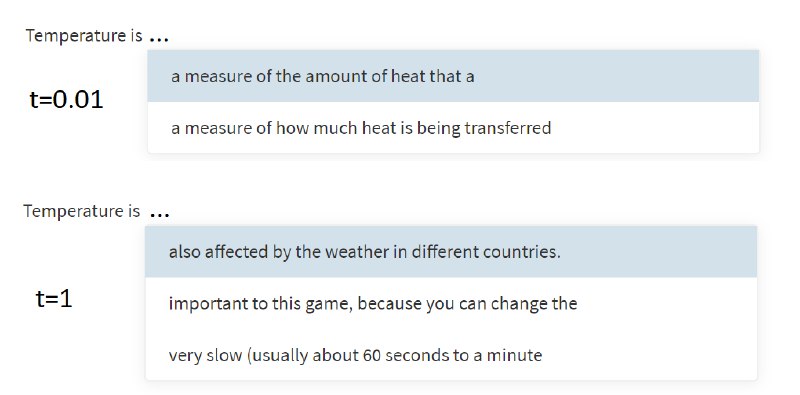
А позавчера я психанул и вставил в него сберовскую модель GPT-3 для генерации ответов, и теперь мне кажется, что бот в какие-то моменты умнее меня 🙈

На самом деле, конечно же, нет. Всё, что умеет делать GPT-3 (и любая другая языковая модель) - это слово за словом дописывать текст так, чтобы он был похож на те тексты, на которых модель обучалась. Но поскольку Сбер скормил в свою модель едва ли не половину Рунета, то и тексты она умеет выдавать местами прикольные и содержательные.

В феврале я собираюсь провести мастер-класс по современным языковым моделям для чайников: что такое BERT и GPT, как ими пользоваться, что полезного из них можно извлечь. На входе нужно будет только знание Python.

Дату семинара я сообщу чуть позже, а пока я очень прошу написать вас в комментах, на какие вопросы, связанные с языковыми моделями, вы хотели бы получить на вебинаре ответ.
Post #213 1.79K
Я, кажется, ещё не рекомендовал вам https://seeing-theory.brown.edu, хотя своим студентам даю его уже не первый год.

Это залипательный сайтик, который объясняет основные идеи теории вероятности и статистики на куче визуальных и интерактивных примеров. Например, там можно посэмплить кучу маленьких выборок из какого-нибудь распределения, для каждой оценить 90% доверительный интервал для среднего, и увидеть, что около 90% из них действительно накрывают настоящее среднее.

Поэтому, если вы любите картинки и хотите вкурить/вспомнить, как теорвер вообще работает, этот сайтик - для вас.
seeing-theory.brown.edu Seeing Theory A visual introduction to probability and statistics.
Post #212 996
TL;DR: мы запускаем новый курс про машинное обучение (и в целом работу с данными) для продактов (а также маркетологов, предпринимателей, и других ребят скорее из бизнеса чем из технологий).

Кто такие "мы":
- платформа Mathshub в лице Айры (главного преподавателя) и Тани;
- школа прикладной математики и информатики МФТИ в лице Никиты;
- ваш покорный слуга.

В чём идея курса: рассказать и показать людям с менеджерскими и продуктовыми ролями про современные технологии анализа данных. Это поможет, во-первых, более качественно управлять любым продуктом за счёт использования простенькой статистики и автоматизации. А во-вторых, курс научит работать с data-intensive и AI-intensive продуктами: ставить корректные задачи технарям, искать нужные данные и готовые компоненты, верхнеуровнево понимать работу моделек и оценивать их качество на достаточно ранней стадии.

Чем будем заниматься по факту: слушать вебинары, решать бизнес-кейсы, и немножко кодить (опыт программирования не обязателен - кода будет мало, и мы его будем очень подробно разбирать). Решать и кодить, скорее всего, будем в небольших группах. Будет интересно и полезно 🙃

Возможно, вы помните, как зародился этот канал: контейнер для курса лекций, призванного проложить мостик между бизнесом и математикой. С того курса прошло 4 года, в бизнесе теперь рулят продакты, а в математике - дата-сатанисты. А наш курс помогает первым результативно и комфортно работать со вторыми.

Подробности и форма для записи:
https://maths-h.com/ru/ml4pms-course-mipt-2020?utm_term=david_post
Лайк, шер, репост.
Post #211 746
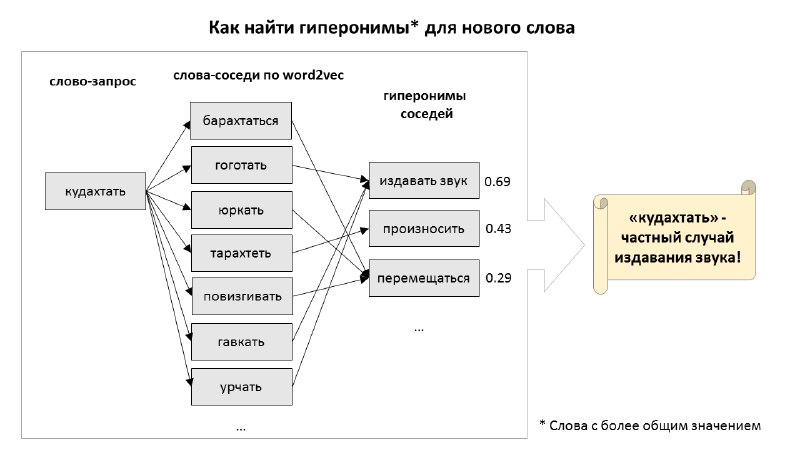
Этой зимой я попробовал влезть в соревнование по компьютерной лингвистике: угадывание гиперонимов для новых слов. Сложные модели у меня как-то не зашли, а вот прокачанный бейзлайн на word2vec и ближайших соседях неожиданно дал лучшее решение на глаголах.

В постике рассказываю, зачем вообще нужны эти гиперонимы, тезаурусы и таксономии, и показываю упрощённый питонячий код для их пополнения.
https://habr.com/ru/post/507228/
Хабр Как предсказать гипероним слова (и зачем). Моё участие в соревновании по пополнению таксономии Как может машина понимать смысл слов и понятий, и вообще, что значит — понимать? Понимаете ли вы, например, что такое спаржа? Если вы скажете мне, что спаржа — э...
Post #210 857
8. Авторы статьи умнички и самостоятельно находят косяки в своём чатботе. Самый неприятный из них - это, кажется, забывчивость, например, когда бот снова и снова задаёт один и тот же вопрос. Другая особенность бота - что он уворачивается от углубления в любой разговор, предлагая сменить тему. Что предлагает тему - это хорошо, но что уклоняется от ответов - не очень. И ещё одно слегка бесящее свойство этого и других ботов - когда у них нет фактического ответа, они не сознаются в этом, а выдумывают его.
9. Авторы статьи справедливо замечают, что качество человеческой оценки бота не определяется его перплексией на тестовых диалогах, ибо и тестовые диалоги могут быть разные, и для одной и той же модели разные алгоритмы декодирования дают разное качество.

Итак, Гугл свой чатботный ход сделал зимой, Фейсбук - весной. Ждём, кто выступит следующий (:
Post #209 1.33K
Недавно Facebook Research опубликовали статью про нового чатбота. Вот их блогпост: https://ai.facebook.com/blog/state-of-the-art-open-source-chatbot/. Если у вас нет времени или большого интереса, почитайте его. Если время и интерес есть, почитайте и их большую статью. Она длинная, но затрагивает много вещей, важных для понимания текущего состояния чатботов и NLP в целом. В частности:

1. Размеры моделей продолжают расти. Фейсбучная модель втрое жирнее, чем гугловская Meena (предыдущая SOTA); в ней уже почти 10 миллиардов параметров. Хотя по качеству этот гигант вроде не сильно лучше, чем втрое меньшая модель.
2. Разработчики сблендили несколько подходов к генерации диалоговых ответов и несколько разных датасетов, сфокусированных на диалоговых навыках. Получилась кракозябра, работающая ожидаемо лучше, чем более узкоспециализированые модельки.
3. Для генерации ответов использовали (А) retrieval-модельку, выбирающую ответ, наиболее подходящий под контекст, из готового набора ответов. (Б) классический seq2seq трансформер, генерирующую ответ слово-за-словом, глядя на контекст и готовый префикс ответа. (В) их гибрид, так же генерирующий ответ слово-за-словом, но но глядя так же на ответ, предложенный retrieval-моделью, или на подтянутый по ключевым словам абзац из Википедии.
4. Файн-тюнили модели на трёх датасетах: ConvAI2 (диалоги, где участники общались с учётом описания приписанного им персонажа), Empathetic Dialogues (где один участник описывал свою ситуацию, а другой эмпатично активно слушал), и Wizard of Wikipedia (где обсуждение строилось вокруг релевантного абзаца из Википедии). Разнообразные задачи - разнообразное и поведение получившегося бота.
5. Разные боты друг с другом сравнивались ассессорами side-by-side. Это не настолько секси, как более явные числовые метрики по отдельно взятому диалогу, зато, возможно, результат получается менее шумным.
6. Если оценивать диалоги бота с ботом, то модель с поиском по готовым ответам работает лучше, чем модель с генерацией ответов пословно. А если оценивать диалоги бота с человеком, то наоборот. Из этого следует как минимум то, что бот общается с ботом как-то существенно иначе, чем человек. И ещё, что retrieval подход сдаёт свои позиции довольно медленно.
7. При генерации ответов дофига важно ограничивать пространство возможных реплик. В частности, не допускать слишком коротких ответов или ответов с повторяющимися словами. В результате применения этих простых фильтров качество растёт прям существенно. В ходе своих экспериментов товарищи из фейсбука применяли разные фильтры, и, возможно, непонятные результаты из предыдущего пункта объясняются именно этим.
Meta A state-of-the-art open source chatbot Today we’re announcing that Facebook AI has built and open-sourced BlenderBot, the largest-ever open-domain chatbot. It outperforms others in terms of engagement and also feels more human, according to human evaluators.
Post #207 619
Хм, случайно как-то так получилось, что мои фантазии сбылись достаточно рано, и число случаев COVID-19, кажется, действительно перестало расти экспоненциально.

Как я увидел, что это произошло?
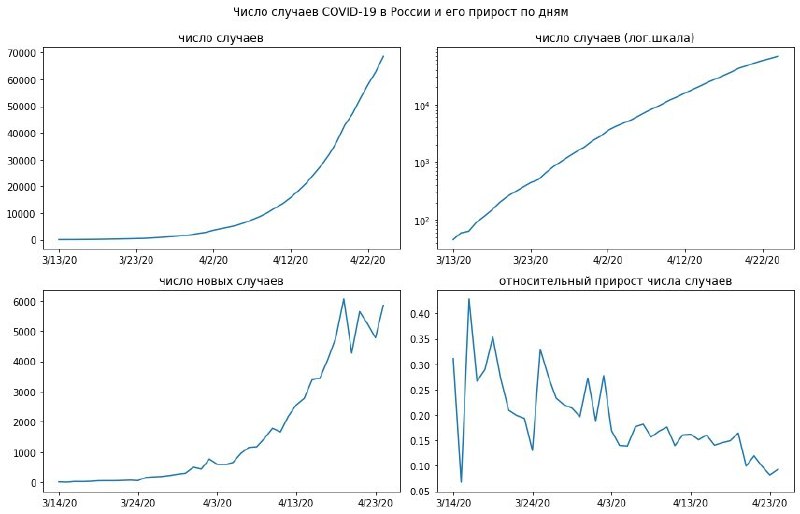
Способ 1, не очень удобный: поглядеть на график числа случаев. Несколько дней назад (где-то с 20 апреля) он начал меня форму: выпуклая кривая потеряла свой изгиб и стала практически прямой. Впрочем, этот эффект хоть и виден, его не очень просто описать формально.

Способ 2: поглядеть на логарифм числа случаев. Пока рост был экспоненциальный, логарифм рос линейно (точнее, как два прямых отрезка, ибо там было две экспоненты с разными темпами). А теперь его кончик начал загибаться вниз. Но это может быть как и переходом к суб-экспоненциальному росту, так и началом более пологой экспоненты.

Способ 3: поглядеть на ежедневный абсолютный прирост числа случаев. Это дискретный аналог производной, а производная экспоненты, как мы помним из анекдотов, тоже экспонента. И до 20 апреля всё так и было: кривая числа новых случаев имела ту же форму, что и кривая числа всех случаев, отличаясь только на множитель. А вот после 20 апреля число новых случаев ПЕРЕСТАЛО РАСТИ. И держится примерно постоянным уже пять дней. То есть похоже, что рост из экспоненциального стал линейным.

Способ 4: поглядеть на график относительного прироста (он же - производная логарифма). Три недели он очень ровно держался в районе 15% в день. А теперь он то ли закрепился на новом уровне около 10% (то есть ещё более пологая экспонента), то ли продолжает падать. Пока не очевидно.

Особенное внимание хочется обратить на третий график. Вот уже несколько дней число новых заболевших в РФ не превышает 6 тысяч. Если оно и не будет превышать, это значит, что мы успешно сплющили кривую. Дальше можно грубо оценить загрузку медицинской системы. Если болезнь длится в среднем, скажем, 20 дней (на самом деле, кажется, меньше), и в день стабильно заболевают по 6К человек, то общее число больных стабилизируется на уровне примерно 20*6К. То есть раза в два больше, чем сейчас. То есть, кажется, вполне терпимо.

А вот как долго мы просидим на этом плато, пока непонятно совершенно.

Для желающих помучить данные самостоятельно - вот ссылка всё на тот же блокнот: https://gist.github.com/avidale/039ad33a5499dfd9dda8ac46505b5292
Post #206 554
Кстати, если вам любопытно, как я построил графики из предыдущего поста, то вот вам блокнот с питончиком (а именно pandas'ом). Можете его поштырить или самостоятельно запустить в колабе)
https://gist.github.com/avidale/039ad33a5499dfd9dda8ac46505b5292
Gist covid-trends.ipynb covid-trends.ipynb. GitHub Gist: instantly share code, notes, and snippets.
Post #205 573
переболевает либо вакцинируется, в Австралии заканчивается трава, люди Земли привыкают пользоваться презервативами.

Вы обратили внимание на необычность последнего примера? Во всех примерах, от рублей до кроликов, экспонента прекращалась, когда самовоспроизводящийся процесс натыкался на потолок по какому-то критическому ресурсу, необходимому для воспроизводства. И только с человеческой демографией всё иначе: ресурсы ещё не закончились, но люди сами начали принимать решение, что им не нужно много детей. И рост замедлятся не из-за внешних ограничений, а по внутренним причинам.

Именно поэтому вопрос "растёт ли число подтверждённых случаев COVID-19 экспоненциально или нет?" - важный. Пока рост экспоненциальный, все мы - кролики, и можем надеяться на остановку эпидемии только после того, как полстраны переболеет. Если экспонента перестанет быть экспонентой раньше - значит, мы научились контролировать распространение вируса.

И вот пока что мы кролики. Относительно хорошая новость в том, что с внедрением карантина (в начале апреля) мы стали более медленными кроликами. Сейчас число кейсов COVID-19 в России растёт по 15% в день и удесятеряется за 16 дней. А в марте росло по 25% в день и удесятерялось за 10, то есть экспонента была более крутой. На графике с логарифмической шкалой этот перелом довольно чётко виден: одна прямая линия сменилась другой, более пологой. Но таки это всё ещё прямая. Если её тупо продлить, то сегодняшние 30 тысяч кейсов через месяц превращаются в 2-3 миллиона, а ещё через месяц переболевает большинство населения и экспонента затухает по естественным причинам.

Но наверное, конечно, не линия тупо продлится, а мы что-нибудь предпримем и перейдём на ещё более пологую экспоненту. Или даже на не-экспоненту вообще, но это пока только фантазии. 
Post #204 534
Я тут давеча предлагал поговорить про вузовскую математику, но сам начну вообще с математики для 9 класса. Ибо есть тема, от которой меня сильно бомбит. Это геометрическая прогрессия.

Почему-то даже очень умные взрослые люди не всегда умеют ею пользоваться. "У нас не будет экспоненциального... развития, вот это 17-18% день ото дня", говорят авторитеты в телеэфире. Хотя вообще-то с точки зрения математики, вот эти процессы - суть одно и то же:
- экспонента;
- геометрическая прогрессия (это та же экспонента, только дискретная);
- рост на один и тот же процент в день;
- рост, при котором удвоение (или удесятерение) происходит за один и тот же промежуток времени.

Так что, друзья, плохая новость в том, что рост на +15% в день - это тоже экспонента. И даже рост на +1% в день - это тоже экспонента, только меееедленная. А даже очень медленные экспоненты спустя время дорастают до космических масштабов. Например, рост на 1% в день - это означает рост в 38 раз за год. В 1427 раз за два года. В 54 тыщи раз за три года. В 2 миллиона за 4 года. Ну, вы поняли.

Ещё раз: рост на один и тот же, даже маленький процент, в день - это экспонента. Да-да, это не парадокс: процент - один и тот же, а рост в итоге - взрывной. "Взрывной" означает, что даже очень пологая экспонента рано или поздно обгонит самую крутую линейную, квадратичную, и вообще любую степенную функцию.

Экспонент в природе очень много, потому что так ведут себя любые штуки, умеющие воспроизводить себя и не встречающие ограничений. Например:
- Каждый год на мой вклад начисляется один и тот же процент от банка. Размер вклада растёт экспоненциально. Если сегодня я вложу 1 лям под 5% годовых, к пенсии это будет 6 лямов.
- Каждая молекула метана, окислившись в горячие пар и углекислый газ, заставляет окислиться ещё условно 10 таких молекул (если вокруг достаточно метана и кислорода). И газ взрывается, сжигая всё вокруг.
- Амёба в питательном бульоне делится надвое каждые полчаса. Пока бульона достаточно много, число амёб будет расти экспоненциально.
- Каждый больной неким вирусом за время болезни заражает в среднем пять новых людей. Или только двух новых людей. Или даже 1.001 новых людей. Число заражений растёт экспоненциально.
- Крольчиха за год рожает пару десятков крольчат. 24 завезённых в Австралию кролика через 10 лет превращаются во многие миллионы.
- Одна пара людей за жизнь рожает в среднем 2.5 детей. Население Земли растёт экспоненциально.

Как понять, что кривая является экспонентой? Проще всего нарисовать её, включив логарифмический масштаб на оси Y. Если в логарифмической шкале мы видим прямую - то в исходной шкале это экспонента. Потому что если десятичный логарифм растёт линейно - это значит, что сама величина удесятеряется вновь и вновь за одно и то же число дней.

Конечно, в реальном мире все экспоненты рано или поздно затухают, превращаясь, например, в логистические кривые. Банк закрывается или меняет условия вклада, метан сгорает, заканчивается питательный бульон, всё население
Post #200 478
Во время карантина в города вернулись дельфины и олени, а в Матчасть, возможно, вернётся регулярный контент 🙃 Но только если вы, подписчики, покажете, что вам это интересно!

Вопрос, про что бы вам больше хотелось читать?
И вопрос со звёздочкой: а кому было бы интересно в качестве весеннего марафона самому/самой пописать текстики для этого сообщества? :)

Отвечать можно в комментах или даже в личных сообщениях 🤗
Post #199 1.94K
Давно я не выкладывал сюда никакой годноты.
А годнота иногда случается)
Вот текстик о своих экспериментах по сжатию словных эмбеддингов fastText.
Ключевые слова: отбор признаков, квантизация, сокращение размерности.
Код и сжатые модельки прилагаются.
https://habr.com/ru/post/489474/
Хабр Как сжать модель fastText в 100 раз Модель fastText — одно из самых эффективных векторных представлений слов для русского языка. Однако её прикладная польза страдает из-за внушительных (несколько г...
Post #197 835
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →