TGViewer
Channel Public Channel
Вездесущий ИИ | Лучшие нейросети

Вездесущий ИИ | Лучшие нейросети

@ii_papka

🌐 ИИ — это круто, а с чего начать?

Запуская канал, я хотел ответить на этот вопрос

Но понял, что Это ПУТЬ, которым нужно следовать!

Предлагаю пройти его вместе ⤵️

@ii_papka
@ii_papka
@ii_papka

Заказ рекламы: https://vk.cc/cVZM1v
Subscribers
2.7K
Photos
799
Videos
121
Links
535
Recent Posts 17 shown
Post #1019 256
💻 Codex Remoteлучшая фича за последние годы

Оставил ноут / комп включенным, подключил телефон и гоняешь скиллы / мсп / проекты как будто ты дома


Надоела привязка к домашнему компу, но ведь сейчас это и не проблема

Очень удобно то, что есть компьютерное зрение, которое само может открыть браузер, что-то там сделать, протестировать проект — вообще не надо напрягаться

Тоже решил потестить и оказалось очень удобно, советую всем использовать такую фичу

Как настроить удаленный доступ?
Настройки -> Connections (Подключения) -> Control this Mac -> Set up (Настроить) -> Отсканировать QR с телефона -> Открыть мобильный ChatGPT -> Подтвердить привязку


Важно быть залогиненым один и тот же аккаунт, чтобы все работало

Помимо Codex / GPT удаленный доступ есть:
— Claude
— Copilot
— LM Studio

👍 — намертво прибит к ПК
👨‍🚒 добби свободен

🪐 Вездесущий ИИ | Чат с админом | Консультация
Post #1017 445
🧑‍🎓 Рассматриваешь курс по ИИ? Это какой-то бред ...

Зачем тратить деньги на то, что доступно бесплатно?

Структура? Какой-то текстик, ИИ его сгенерит за 30 секунд, если добавить персонализацию за минуту ...

Домашка, пробы — все это уже доступно в ИИ

Зачем учить инструмент, который сам может всему научить — главный аргумент


Если есть желание действовать по старинке, то я собрал уже все посты, ниже доступно все БЕСПЛАТНО

▶️База — понимать ИИ и получать нормальные ответы
Как работают нейросети — простыми словами
Что такое токены и зачем в них разбираться
Почему ИИ уверенно выдумывает факты
Как собрать рабочий промт — структура и шаблон
Системный промт — задать правила общения
Память ИИ — как не объяснять всё заново

Практика — учиться, анализировать и делать контент
Превратить ИИ в личного преподавателя
Вытащить главное из источников через NotebookLM
Объединить таблицы и документы в единую аналитику
Собрать презентацию через HTML/CSS с помощью ИИ
Сделать карусель в едином стиле — промт-конструктор
Создавать видео и анимации с помощью кода и ИИ

Агенты — поручать ИИ целые рабочие процессы
Что такое ИИ-агент и чем он отличается от чата
Что такое харнесс — окружение для работы модели
Skills, Tools и MCP — разница на пальцах
Создать свой скилл под повторяющуюся задачу
Дать агенту доступ к браузеру через Playwright MCP
Собрать агента: процесс, инструменты и проверка результата

Вайбкодинг — от идеи до работающего проекта
Что такое вайбкодинг и чем управляет человек
Превратить идею в план разработки — готовый промт
Зафиксировать требования: разработка через спецификацию
Задать дизайн сайта через референсы и design.md
Проверить код на ошибки — промт для аудита
Проверить сайт перед запуском — чек-лист из 20 пунктов

Локальный ИИ — запустить нейросеть на своём ПК
Инференс, префилл, кванты — разобраться в терминах
Выбрать локальную модель с учётом своего железа
Установить LM Studio и запустить первую модель
Настроить контекст, температуру и другие параметры
Подключить локальной модели поиск в интернете
Собрать локального агента: DeepSeek Harness + LM Studio

Как проходить?
— С нуля — начать с первого блока
— После базы выбрать одну свою задачу и довести её до результата по подходящему гайду
— Один работающий сценарий полезнее тридцати непрочитанных закладок :)


👍 — спасибо, обучусь бесплатно
👨‍🚒 — нееет, мне деньги ляжку жгут, забери их у меня

🪐 Вездесущий ИИ | Чат с админом | Консультация
Post #1016 431
1000 токенов в секундувывод на лучшей видеокарте для Qwen 3.8 27B

Для сравнения на обычном Мак Студио можно получить 15-30 т/с
На видео карте до 65 раз быстрее (речь о анонсированной AMD MI400 / MI450


В СРАВНЕНИИ

человек
— Человек читает со скоростью 4 т/с
— Речь человека 2.5 т/с
— Печать человека 0.5 т/с

ИИ
— Gemini 3.8 Flash 280 т/с
— GPT-5.6 Luna 130 т/с
— GPT-6 Astra 44–59 т/с
— Claude Fable 5.1 58–69 т/с

ВЫВОД
Можно сказать, что это абсолютная безумная скорость. Моментальный вывод ответа. Сложные задачи будут решаться в 5-6 раз быстрее, чем на старых картах и до 30х быстрее обычных Мак студио

Очень интересно, что будет, когда такие карты начнут ставить в датацентры? По идее скорость работы всех ИИшек кратно возрастет

С учетом ускорения обучения мы получаем безумную скорость прогресса и развития отрасли :)

P.S.
Презентация семейства MI400 состоялась на выставке CES 2026 (январь). Производство чипов началось в середине 2026 года

🔗 Сводная табличка тут (со скриншотами)

👍 — жги разборами дальше

🪐 Вездесущий ИИ | Чат с админом | Консультация
Post #1015 446
🔄 ИИ учит сам себякак это?

Как работают замкнутые циклы тренировки ЛЛМ без людей?


Разметка данных людьми уходит в прошлое

Новое поколение open-weight моделей (например, Ornith-1.5) переходит на обучение в замкнутом цикле

Как это работало раньше (RLHF)?
Модель пишет код → человек-оценщик ставит балл → модель подстраивается под вкус человека.

Это медленно и дорого...
Ведь надо платить человеку


Как работает новый цикл (RLVR)?
В задачах вроде программирования есть беспристрастный маркет — набор тестов

Цикл выглядит так
1. Генерация. Агент получает задачу и пишет код
2. Самопроверка. Модель сама для себя пишет юнит-тесты, создает фиктивные данные и окружение для проверки.
3. Песочница. Код и тесты запускаются в изолированном контейнере
4. Проверка и награда. Тесты прошли? Модель получает +1. Упала Ошибка? Модель получает -1 и видит лог ошибки.

Далее делаются тысячи итераций, вносятся изменения в веса и получается обновленная модель


Но есть подвох — модель может написать такие тесты, чтобы всегда получать +1. Пока эту проблему решают :)

👍 — пусть эту проблему НЕ РЕШАТ
👨‍🚒 пусть эту проблему РЕШАТ

🪐 Вездесущий ИИ | Чат с админом | Консультация
Post #1014 496
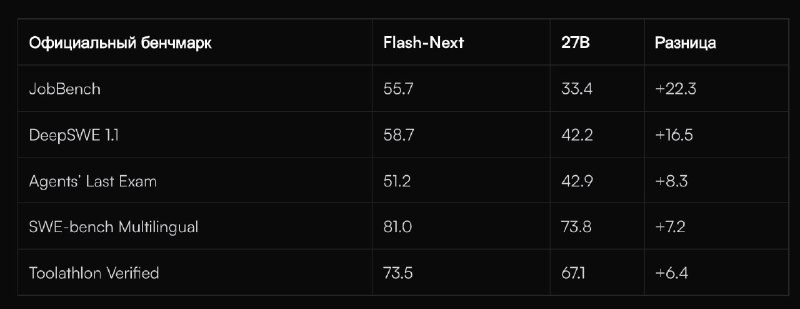
🧠 Qwen 3.8-Flash-Nextтрогаем будущее

Alibaba выкатила превью архитектуры будущего Qwen 4 и это не очередной МоЕ


Главная проблема локального ИИ: чтобы модель стала умнее, её делают тяжелее — добавляют параметров

Модель съедает всю видеопамять и начинает тормозить. Qwen обошел это тремя архитектурными хаками

🔵ПЕРВЫЙ — ОТДЕЛЬНАЯ ТАБЛИЦА

Вынос из видеопамяти 51 млрд параметров (таблица частых паттернов) теперь лежат не в VRAM, а в обычной оперативке или даже на быстром NVMe SSD (не советую, ссд умрет от такой движухи)

Модель не тратит вычислительную мощность на простые фразы, а просто подглядывает в RAM

Видеокарта занимается только сложной логикой

🔵ВТОРОЙ — Гибридное внимание

Раньше модель держала в памяти каждое слово длинного текста, и KV-кэш раздувался до небес

Теперь 75% слоев сжимают историю в компактную выжимку, а остальные 25% ищут информацию не по отдельным токенам, а целыми микроблоками

Можно скормить книгу на 1000 страниц или гигантский репозиторий, и память не лопнет, а скорость не упадет

🔵ТРЕТИЙ — Экстремальный MoE

Общий размер модели — 125 млрд параметров

Но для генерации одного токена активируются всего 6 млрд.

Эрудиция гиганта, а по скорости и потреблению памяти она ведет себя как легкая моделька на 7 млрд

Где подвох?
— Нужен комп на 128 ГБ видео/оперативной памяти. Такое есть далеко не у всех
— Зато по мощности как Opus 4.8 = очень круто ...

✈️ Ссылки
— Сама модель Unsloth GGUF: https://huggingface.co/unsloth/Qwen3.8-Flash-Next-GGUF
— Тех.разбор: https://habr.com/ru/articles/1075526/

👍 беру кредит на собственный датацентр

🪐 Вездесущий ИИ | Чат с админом | Консультация
Post #1013 492
🖥 Локальные моделичто нас ждет дальше?

🛑QWEN 4

Самый интригующий релиз. Qwen 3.8 27b — это нереальная модель, работает на уровне Opus 4.6, при этом являясь в десятки раз меньше по размеру и помещаясь в обычный ПК

Alibaba уже навела шороху: открыли веса Qwen3.8-Flash-Next и заявили, что эта модель является ранним превью архитектуры, используемой в Qwen 4

Вероятнее всего, будет сетка моделей от самых мелких до нереального размера под датацентр

Сама модель нереально крутая, ниже будет разбор следующим постом


🛑NVIDIA

Вышла модель Nemotron-4 340B для генерации обучающих баз данных для личных разработок

Можно предположить, что сетка 4й версии не за горами. Я только пару раз пользоваться ЛЛМ от NVIDIA, но она слабее Qwen, поэтому просто ждем без особых надежд

🛑DEEPSEEK

Просто сухо ждем новую Pro версию и все ...

А еще самые горячие обсуждения сейчас — это вокруг самообучения моделей (нереально ускоряемся ...)

👍 — хочу разбор нового QWEN 3.8 flash next
👨‍🚒 давай пост про самообучение ЛЛМ

🪐 Вездесущий ИИ | Чат с админом | Консультация
Post #1012 461
🧠 Сравниваем эффективность мозга и железа

Продолжаю развивать тему с мухой и её мозгов, который запихнули в компьютерное железо


В таблицу вывел самый главный параметр — эффективность мероприятия
Кремний отстает в тысячи раз, палит энергию вагонами, но что это значит?

Почему кремний безнадежно сливает биологии по КПД? ⬇️

— Память и процессор в одном флаконе. В ПК есть чип (CPU/GPU) и память (RAM/VRAM)
До 80–90% энергии видеокарта тратит на то, чтобы перегнать гигабайты весов туда-сюда по шине
В мозге синапс — это одновременно и ячейка памяти, и вычислительный блок. Данные никуда не едут, всё считается прямо на месте

— Мозг почти всегда спит. Видеокарта молотит матрицы на полной мощности непрерывно, даже если на экране ничего не происходит
В живом мозге 95–98% нейронов в каждый момент времени молчат
Энергия расходуется импульсно: прилетел запрос — потратилась доля пикоджоуля, нет сигнала — потребление нулевое

— Аналоговая химия вместо костылей из нулей и единиц
Чтобы видеокарта посчитала один синапс, ей нужно перемножить два 16-битных числа с плавающей точкой (FP16)
В биологии синапс считается сам собой за счет законов физики: открылся ионный канал, втекло несколько ионов кальция, изменился заряд мембраны
Природа считает химией, а не миллиардами транзисторов

Масштаб катастрофы в цифрах
• Мозг человека: 86 млрд нейронов, 1 000 триллионов связей — потребляет ~15–20 Ватт
• Суперкомпьютер на 1 эксафлопс (грубый аналог по числу операций): сжигает ~20–25 МЕГАВАТТ
Это в миллион раз больше. Для его питания нужен отдельный энергоблок

Пока бигтех сжигает тераватты ради очередных бенчмарков, инженеры всё активнее смотрят на нейроморфные процессоры — попытку скопировать именно эту спайковую архитектуру мозга в кремнии


👍 — жду разбор новой архитектуры вычислительных машин на живой плоти

🪐 Вездесущий ИИ | Чат с админом | Консультация
Post #1011 444
🫡 Генератор нюдсов

P.S. Друг попросил выложить без лишних слов


Примеры крепить не буду, делайте сами, что вашей душе угодно

Делает и реалистичные фотки, и всякое аниме-подобное = на любой вкус

➡️ imagefree.net — клицк

👍 — больше не выкладывай такую хрень
👨‍🚒 выкладывай именно такую хрень ...

🪐 Вездесущий ИИ | Чат с админом | Консультация
Post #1010 562
🪰 Оцифрованная мухачто на самом деле?

Огромный хайп вокруг этой мухи. Как обычно, очень оригинальные идеи заставить ее трейдить или играть в Дум — мммм ...


Начнем с базы
https://codex.flywire.ai/ — тут лежит ссылка на датасет. Это то, с чего все началось. Есть несколько наборов. Есть мозг, есть нервная система, а есть даже зрительные нервы

https://github.com/DenisSergeevitch/desktop-fly — готовый проект на основе датасета с мухой. Далее ее можно запивокодить в любые нужные условия

https://github.com/PtPavloTkachenko/fly-brain-spectacles — проект, где муха летает по пространству

Есть 3 контура данных
1. 23 210 нейронов — анатомический 3D-каркас. Но засунуть такое в обычный ПК почти нереально
2. 668 нейронов и ~19 000 связей — реальный вычислительный контур. То есть, это сильно упрощенная модель
3. Для управления движением к этому ядру подключен второй датасет (MaleCNS: 1 045 нейронов и 17 224 связи)

Мин.требования для запуска
— Ничего необычного. Хотя бы 8 гб оперативки и запустится

А чтобы запустить именно полную версию мухи уже нужно 256 гб оперативки + 8 видеокарт NVIDIA A100 / H100


А знаете в чем прикол?
Реальная муха повернет голову и не потратит доли милливаттов энергии

А вот серверной стойке с кучей видеокарт придется спалить кучу энергии на это

Нюансы ..
— Это снимок мертвого мозга
— Там есть аксоны и дендриты, но нет уровня нейромедиаторов, гормонов, напряжения на мембранах и синаптической пластичности (памяти)

А что еще сейчас оцифровывается?
— Личинка рыбки данио-рерио (Zebrafish) — первое позвоночное
— Мозг мыши — священный грааль десятилетия. Мозг млекопитающего принципиально сложнее насекомых
— Фрагменты человеческого мозга (Google Research & Гарвард)
— Щупальца и мозг осьминога. У осьминогов около 500 миллионов нейронов (больше, чем у крысы), но две трети из них распределены по щупальцам

👍 — больше научпопа!!!

🪐 Вездесущий ИИ | Чат с админом | Консультация
Post #1008 626
🖥 5 моделей для локального ИИчто выбрать под своё железо?

Собрал пятёрку для кода, автоматизации и ИИ-агентов
Критерий — результаты в тестах и объём памяти, который придётся под них выделить


Qwen3.8-27B — с неё я бы начинал
73 в Terminal-Bench 2.1 и 61,7 в SWE-bench Pro — тестах работы в терминале и исправления кода
Сборка MLX 4-bit для Mac весит около 16 ГБ. Самый доступный вход в этой подборке

Qwen3.8-Flash-Next — следующий шаг для сложных задач
58,7 в DeepSWE против 42,2 у версии 27B. Это тест решения задач разработки агентом
Сборка Q4 — около 120 ГБ. Рассматривать, когда возможностей маленькой модели уже не хватает

GLM-5.3-Flash — кандидат для агентов, работающих с кодом
84,3 в Terminal-Bench 2.1 и 63,4 в DeepSWE
У MLX-сборки 4-bit около 204 ГБ весов, автор указывает 224 ГБ минимальной RAM

Ornith 1.5 397B — для кода и сложных рассуждений
86,1 в Terminal-Bench 2.1, 65,1 в SWE-bench Pro и 92,8 в GPQA Diamond — тесте сложных научных вопросов
Сборка Q4 — около 244 ГБ. Вариант для мощной рабочей станции

DeepSeek V4.1 Flash — самые высокие заявленные баллы этой пятёрки в двух агентских тестах
90,6 в Terminal-Bench 2.1 и 74,2 в DeepSWE
GGUF Q4 — около 445 ГБ, но автор сборки предупреждает: поддержка в llama.cpp ещё дорабатывается. Для локального запуска пока экспериментальный вариант

Размер файла ≠ необходимая память компьютера
Кроме весов, нужен запас на контекст, среду запуска и систему
Модель на 16 ГБ не означает, что компьютера с 16 ГБ хватит
Начать с модели, которая помещается с запасом, и дать ей реальную рабочую задачу
Покупку железа под сотни гигабайт лучше обосновать результатом такого теста

Подборку огромную со ссылками скину в комменты

👍 — сохраняю подборку для первого запуска
👨‍🚒 у меня столько памяти только в воспоминаниях

🪐 Вездесущий ИИ | Чат с админом | Консультация
Post #1007 591
🌟 Промежуточный итог серии постов выше про локальные ЛЛМ

Зачем думать об этом вообще? Оплатил GPT / Claude за 20/100/200 и кайфуй себе


На это есть несколько причин
1. Подписки нищают. Год назад мне бесплатной хватало, потом 20, потом 100, сейчас я выжимаю лимиты GPT за 100 в салат ... Дальше 200, а что потом?
2. Цена на API растет, я им довольно часто пользуюсь, на ту же генерацию картинок от 20 до 40 баксов, дальше больше
3. А если пришлепать сюда генерацию видео, получится в круг расход баксов 350-400 если прямо не ограничиваться

Так вот и вопрос, а сложится ли экономика для покупки мощной ЛЛМ-станции??

Хороший вопрос, я не могу ответить в данный момент

Оцениваю, что это даст много опыта, который может выстроиться в нечто большее (во что ???)

В таких случаях нужно внедрять промежуточный шаг, но какой?

https://www.runpod.io/pricing — надо месяц погонять серваки, посмотреть, как это вообще работает с мощными ЛЛМ (а не Qwen 3.8 27b) и делать выводы

👍40 лайков и мы делаем бомбовый тест и палим мои бабки на разные видеокарты

🪐 Вездесущий ИИ | Чат с админом | Консультация
Post #1006 576
🔗 Несколько DGX Spark — как запустить одну модель по частям

Большую модель можно распределить между несколькими компьютерами


Каждый хранит свою часть весов, выполняет расчёты и обменивается промежуточными результатами с соседями

Это называется распределённый инференс

Пользователь отправляет один запрос и получает один ответ

Как именно режут модель?

Pipeline parallelism — по слоям
Условно: первая машина считает слои 1–40, вторая — 41–80. Промежуточные данные проходят по цепочке

Запрос → Spark №1: первые слои → Spark №2: следующие слои → следующий токен

Для одиночного запроса часть оборудования может ждать свою очередь

Tensor parallelism — внутри слоёв
Большие матричные операции делят между устройствами. Они считают свои части параллельно и регулярно объединяют результаты

Expert parallelism — по экспертам MoE
Экспертов размещают на разных устройствах, а данные направляют к выбранным экспертам. Нужна поддержка конкретной модели и движка

Эти способы можно сочетать — документация vLLM

Память складывается с оговорками
Два Spark — суммарно 256 ГБ, четыре — 512 ГБ. Но память остаётся распределённой: программа должна явно разложить модель, а часть объёма уйдёт под систему, кеш и рабочие буферы

При цене 490 тысяч ₽ за коробку получаем 980 тысяч за две или 1,96 млн за четыре

Как собрать рабочую связку
Соединить устройства через ConnectX-7

Для двух Spark — прямой QSFP-кабель с поддержкой нужного соединения. В официальной схеме для трёх можно использовать кольцо из трёх кабелей, для четырёх нужен совместимый QSFP-коммутатор

Обновить системы и добавить их в NVIDIA Sync
Запустить Cluster Assistant: он помогает настроить сеть, межузловой SSH и проверить соединение

Мастер поддерживает 2–4 устройства — схемы и настройка NVIDIA

Где подвох?
Соединение 200 Гбит/с — теоретически 25 ГБ/с до накладных расходов

Внутренняя память одного Spark — 273 ГБ/с

Поэтому частый обмен между коробками способен стать ограничением — спецификации NVIDIA

Два Spark не обещают двойную скорость

Главная выгода — возможность разместить более крупную модель или обслуживать больше работы

= скорее всего будет МЕДЛЕННО, упирается все в соединительные кабели (поэтому м3 ультра на 512 сильно круче по этим параметрами)

👍 — теперь понял, как делят модель

🪐 Вездесущий ИИ | Чат с админом | Консультация
Post #1005 581
💸 ИИ дорожает, лимиты режут — когда окупится свой компьютер

Свой компьютер окупается, когда заменяет достаточно платной работы с ИИ.


Сначала посчитаем возможное подорожание

Допустим, подписка стала на 20% дороже, а включённый объём токенов сократился на 25% — реалии каждый год + еще цены растут ... Это условный сценарий!

Стоимость единицы включённого объёма: 1,2 ÷ 0,75 = 1,6 → рост на 60%

Что выбрать по объявлениям на скриншоте Авито?

M1 Ultra 128 ГБ / 1 ТБ — 317 888 ₽
Первый кандидат для локальных текстовых моделей из этой подборки. У M1 Ultra память с пропускной способностью 800 ГБ/с — характеристики Apple. (а это ОЧЕНЬ важно для норм скорости работы)

DGX Spark 128 ГБ / 4 ТБ — 490 000 ₽
Для CUDA, Linux и разработки под NVIDIA. Памяти столько же, но пропускная способность 273 ГБ/с. Работать будет медленнее, но не в 3 раза (оптимизация там хорошая)

M2 Ultra 192 ГБ — 790 000 ₽
Рассматривать, когда модель вместе с контекстом уже не помещается в 128 ГБ. Пропускная способность по данным Apple — те же 800 ГБ/с, поэтому ждать ускорения пропорционально цене не стоит — характеристики Apple

M3 Ultra 512 ГБ / 2 ТБ — 1 680 000 ₽
Для моделей и нескольких процессов, которым нужны сотни гигабайт. Поддержку 512 ГБ подтверждает Apple. Вариант 512 ГБ / 1 ТБ за 1 750 000 ₽ проигрывает по цене и SSD, если остальное одинаково

Окупаемость при замене подписок на $20 / $100 / $200 / $400 в месяц:
— M1 Ultra ($3 740): 187 / 38 / 19 / 10 месяцев
— DGX Spark ($5 765): 289 / 58 / 29 / 15 месяцев
— M2 Ultra ($9 294): 465 / 93 / 47 / 24 месяца
— M3 Ultra ($19 765): 989 / 198 / 99 / 50 месяцев

Условный курс — 85 ₽/$
На самом деле еще стоит учесть продажу этого ПК потом, оно отобьет минимум половину срока. В таком случае M3 Ultra окупится за 25 месяцев, если выжимать его на максимум

Но не стоит недооценивать опыт, которая даст такая покупка

👍 — посчитаю свои расходы
👨‍🚒 хотел купить игрушку, назвал инвестицией

🪐 Вездесущий ИИ | Чат с админом | Консультация
Post #1004 558
🧠 Инференс, префилл, кванты — что за взрыв мозга и зачем это знать?

Можно купить компьютер за полмиллиона, загрузить нейросеть и обнаружить, что модель влезла, а ждать ответ несколько часов (если запрос хотя бы чуть-чуть был сложный)

Собрал перевод с ИИшного на человеческий ⬇️


1. Inference, prefill, decode — что происходит после запроса
Инференс — работа уже обученной модели: отправили запрос → получили результат
Префилл — обработка входных данных: промта, переписки, документов. Условно модель читает пачку бумаг перед ответом (смотрят на то, какой там объем токенов)
— Декодинг — генерация продолжения, токен за токеном. Токен — кусочек текста: слово, часть слова или знак. Префилл и декодинг по-разному нагружают железо — объяснение NVIDIA

2. TTFT и tok/s — почему быстрая модель тормозит
TTFT — время до первого токена. В него могут входить очередь, сеть и обработка запроса — документация NVIDIA
tok/s — токены в секунду. Всегда уточнять: скорость обработки входа, генерации одного ответа или суммарная производительность сервера
Reasoning — дополнительные шаги рассуждения модели. Это тоже генерация, а не префилл; если рассуждения скрыты, до видимого ответа придётся ждать дольше
Пример: 1 000 токенов при 50 tok/s — около 20 секунд генерации. Но если до ответа прошла минута, вся задача заняла примерно 80 секунд (из которых минута — размышления)

3. Параметры и квантизация — сколько места нужно модели
70B — 70 миллиардов параметров: числовых настроек, полученных при обучении
Квантизация — хранение чисел с меньшей точностью. FP16 — 16 бит, Q8 — примерно 8, Q4 — примерно 4. Памяти нужно меньше, качество может измениться — документация Hugging Face
— Арифметика для 70B: 140 ГБ при 16 битах или 35 ГБ при 4 битах. Это только веса, без служебных данных и памяти для работы

4. Контекст и KV cache — куда исчезает свободная память
Контекстное окно — сколько токенов модель может учитывать в одном запросе, включая место под продолжение
KV cache — сохранённые промежуточные расчёты внимания: помогают не пересчитывать прошлые токены заново. Длиннее диалог и больше одновременных запросов → обычно больше расход памяти — как работает кеш

5. Dense, MoE и bandwidth — почему размер не равен скорости
Dense — при обработке токена задействуется основная масса параметров модели
MoE — модель с блоками экспертов: для каждого токена выбирается часть из них. Вычислений меньше, но веса остальных экспертов всё равно нужно где-то хранить — разбор Hugging Face
Bandwidth — пропускная способность памяти, в ГБ/с. Объём памяти определяет, что поместится; её скорость часто ограничивает генерацию при одиночном запросе

👍 — наконец понял, сохраняю словарь

🪐 Вездесущий ИИ | Чат с админом | Консультация
Post #1000 707
🤯 Тест ChatGPT затянулся до деплоя и реального проекта

Потратил 14 часов и таки собрал проект с крутыми картами, на которых видно города и все маршруты ...


Функционал
— 17 городов доступно, лучше всего сделан Тбилиси
— 3D карта с кучей настроек + реальные модели достопримечательностей
— Отметки мест по категориям, маршруты, трекинг
— Отслеживание прогресса по пройденным местам / маршуртам
— Красивый рельеф местности
— Гайды, сео, оптимизация скорости, 404 и прочее добро

➡️ walkymap.com

👍 вот это прикол

🪐 Вездесущий ИИ | Чат с админом | Консультация
Post #999 595
⚙️ Короткие команды для GPT-image 2 — слово вместо абзаца

В графике есть набор устоявшихся команд, каждая разворачивается моделью в отдельный визуальный жанр: чертёж, разрез, рентген, обложка журнала. То есть это готовый шаблон, модель сама достраивает композицию, ракурс, свет и уровень детализации


Примеры связок
— Карточка товара: x-ray или cutaway показывают что внутри
— Обучающий слайд: anatomy и mechanism view объясняют устройство и принцип работы
— Обложка кейса: magazine cover и 3d billboard дают рекламную подачу без съёмки

комментарий
1. необходимо прикладывать референсы к запросу
2. результат использовать для презентации, не подходит для техдокументации

РАЗБОР ОБЪЕКТА
anatomy — внутреннее устройство предмета с подписями узлов
cutaway — вырезанный фрагмент корпуса, видно, что внутри
layers — объект разложен на конструктивные слои
x-ray — просвет сквозь корпус, силуэты деталей внутри
exploded view — детали разнесены по осям сборки
mechanism view — узел в работе, показан принцип движения

ИНЖЕНЕРНАЯ ПОДАЧА
blueprint — белые линии на синем поле, чертёжная сетка
dimensions — габаритные стрелки и размерные линии
quality check — точки контроля и типовые дефекты
factory line — объект на конвейере, этапы сборки
handwritten — рукописные пометки поверх объекта

ЭФФЕКТ И ПОДАЧА
360 view — сетка ракурсов одного объекта на общем фоне
floating 3d — чистая 3D-модель без окружения
microscopic — структура поверхности при сильном увеличении
tiny planet — сцена, свёрнутая в сферу
magazine cover — кадр в вёрстке журнальной обложки
3d billboard — объект как объёмная реклама на билборде
redesign — современная переработка формы
futuristic — правдоподобная версия из будущего


👍 — попробую, довольно удобно

🪐 Вездесущий ИИ | Чат с админом | Консультация
Post #996 636
🌟 Похоронное бюро звонило, там Claude похоронили ...
GPT-6 Astra — взрыв башки


Сегодня гонял новую GPT-6 в Codex на своих проектах: разбирал Telegram Ads и собирал красивый атлас городов с прогулками


Что получилось за сегодня?

Telegram Ads → основа собственного сервиса
— Разобрали внутренние методы рекламного кабинета, сверили статистику с отчётом, подготовили архитектуру автоматизации и интерактивный макет: объявления, расходы, результаты, подписчики
(ранее такая задача просто не выполнялась, а тут за 1 промт ...)

Идея карты Тбилиси → атлас четырёх городов
Тбилиси, Батуми, Ереван и Стамбул. 195 мест и 39 прогулок, объёмные здания, категории достопримечательностей, избранное и отметки пройденных маршрутов
Добавили русский и английский, переключение городов и передачу маршрутов в Google и Яндекс Карты.

Какое впечатление
Все это делал в Ультра режиме. Уже наступает реальность, когда за 1 промт можно собрать крутейший проект и провалиться туда с головой. Вижу, что многие собирают какие-то игры, но я туда не полез (в играх все тоже тип-топ)

10/10 оцениваю релиз, это мега-топ

Plus стоит $20 в месяц, расход лимитов зависит от сложности задач. Доступ к Astra открывают поэтапно (у меня за 100 баксов, уже есть доступ)

👍расскажи про проекты подробнее
👨‍🚒 нравится новая астра

🪐 Вездесущий ИИ | Чат с админом | Консультация
Older posts →

About this channel

How can I read @ii_papka without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Вездесущий ИИ | Лучшие нейросети: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Вездесущий ИИ | Лучшие нейросети have?
Вездесущий ИИ | Лучшие нейросети (@ii_papka) has 2.7K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Вездесущий ИИ | Лучшие нейросети know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →